

Python网络爬虫实战:使用Requests与BeautifulSoup抓取网页数据

本文详细介绍如何利用Python的Requests库发送HTTP请求获取网页源码,并结合BeautifulSoup解析HTML结构以提取特定标签数据。通过分步示例,演示从环境配置、单页抓取到多页循环爬取的完整流程,帮助开发者快速掌握基础爬虫技术。
前言
Python在数据处理领域表现优异,同时也是构建网络爬虫的理想语言。得益于丰富的第三方库支持,许多复杂功能只需简单调用即可实现。在正式编码前,需确保开发环境已安装必要的依赖包,可通过命令行进行配置。
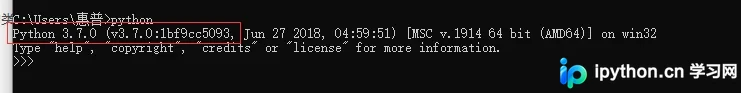
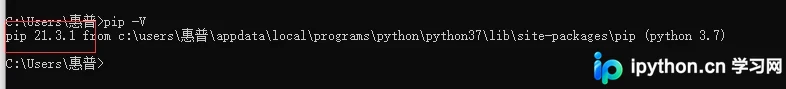
请确认系统中已安装Python解释器及pip包管理工具。若未安装,需先完成相关环境的搭建与配置。
随后,通过pip命令安装核心模块requests,这是后续抓取操作的基础。
pip install requests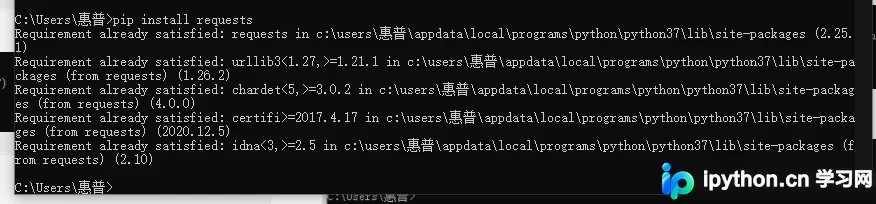
Requests是一个基于Python实现的简洁高效的HTTP库,相比内置的urllib更为易用。它支持发送HTTP/1.1请求,只需指定目标URL并添加查询字符串,即可开始获取网页信息。
1.抓取网页源代码
以某平台为例,我们的目标是提取网页中的公司名称数据,目标链接为:https://www.crrcgo.cc/admin/crr_supplier.html?page=1
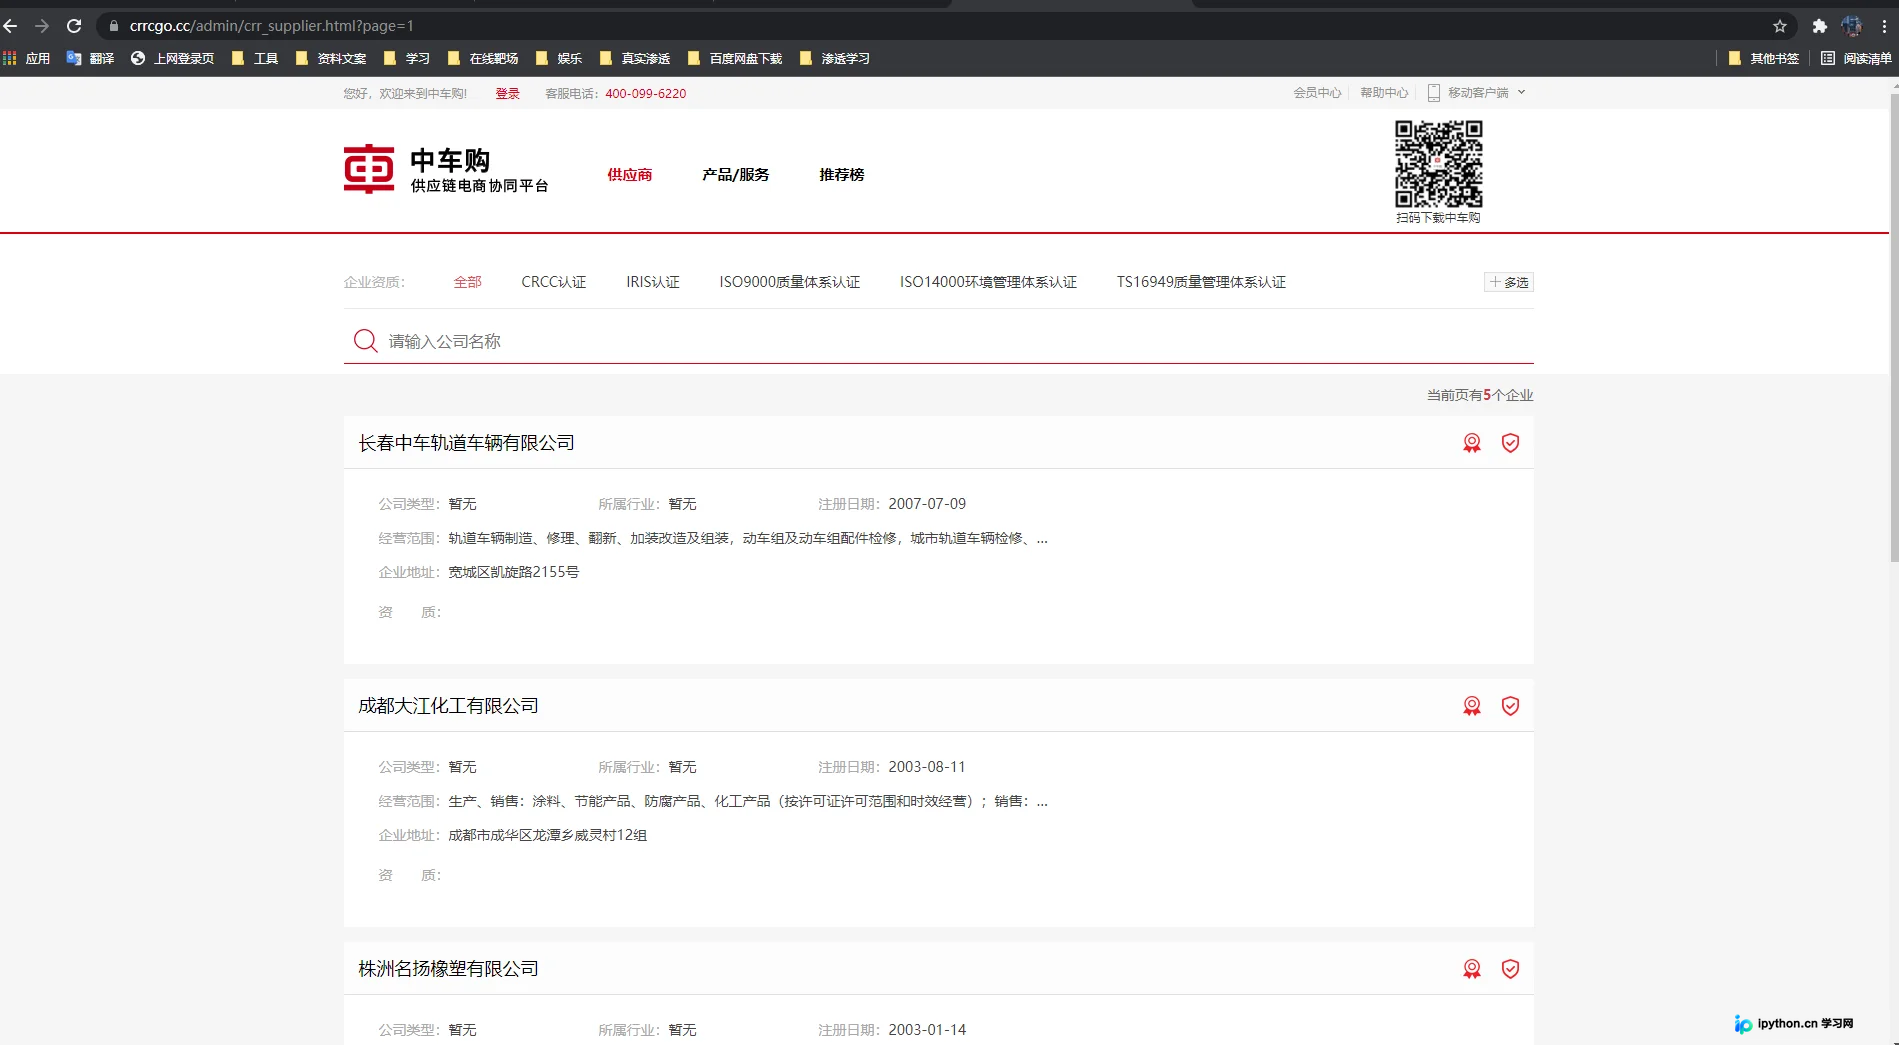
目标网页的源代码结构如下所示:
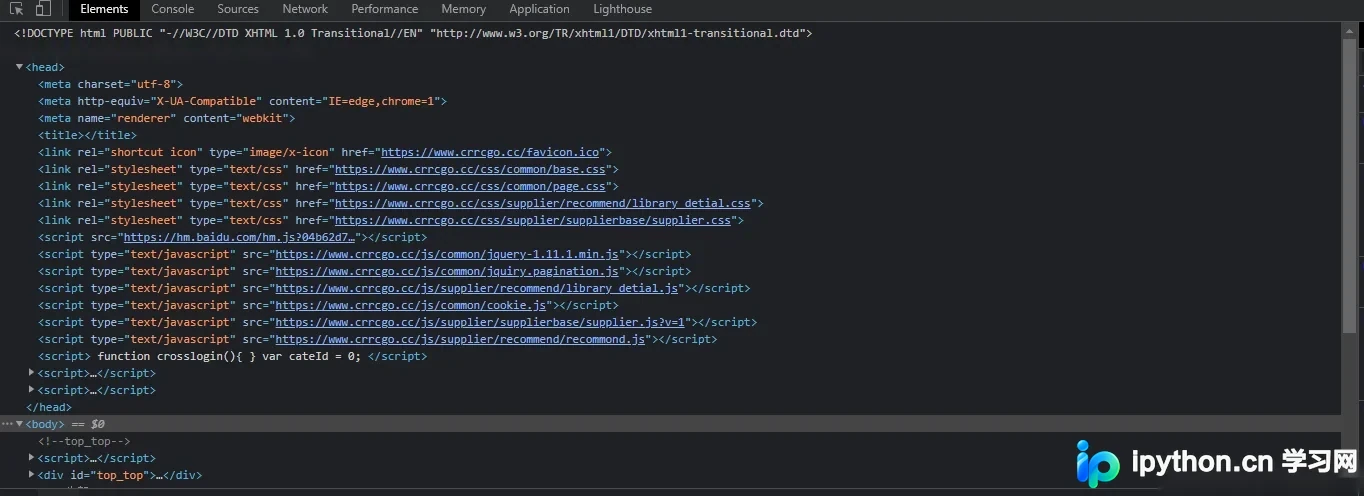
首先明确抓取的基本步骤:
1. 访问目标站点;
2. 获取目标站点的源代码并输出结果。
import requests导入所需的requests功能模块,这是发起网络请求的前提。
page=requests.get('https://www.crrcgo.cc/admin/crr_supplier.html?page=1')该命令通过GET方式获取指定网页的数据。实际上,这等同于浏览器打开网址时获取到的首页页面数据。
print(page.text)将获取到的文本内容(text)通过print函数输出,以便查看原始数据。
import requestspage=requests.get('https://www.crrcgo.cc/admin/crr_supplier.html?page=1')print(page.text)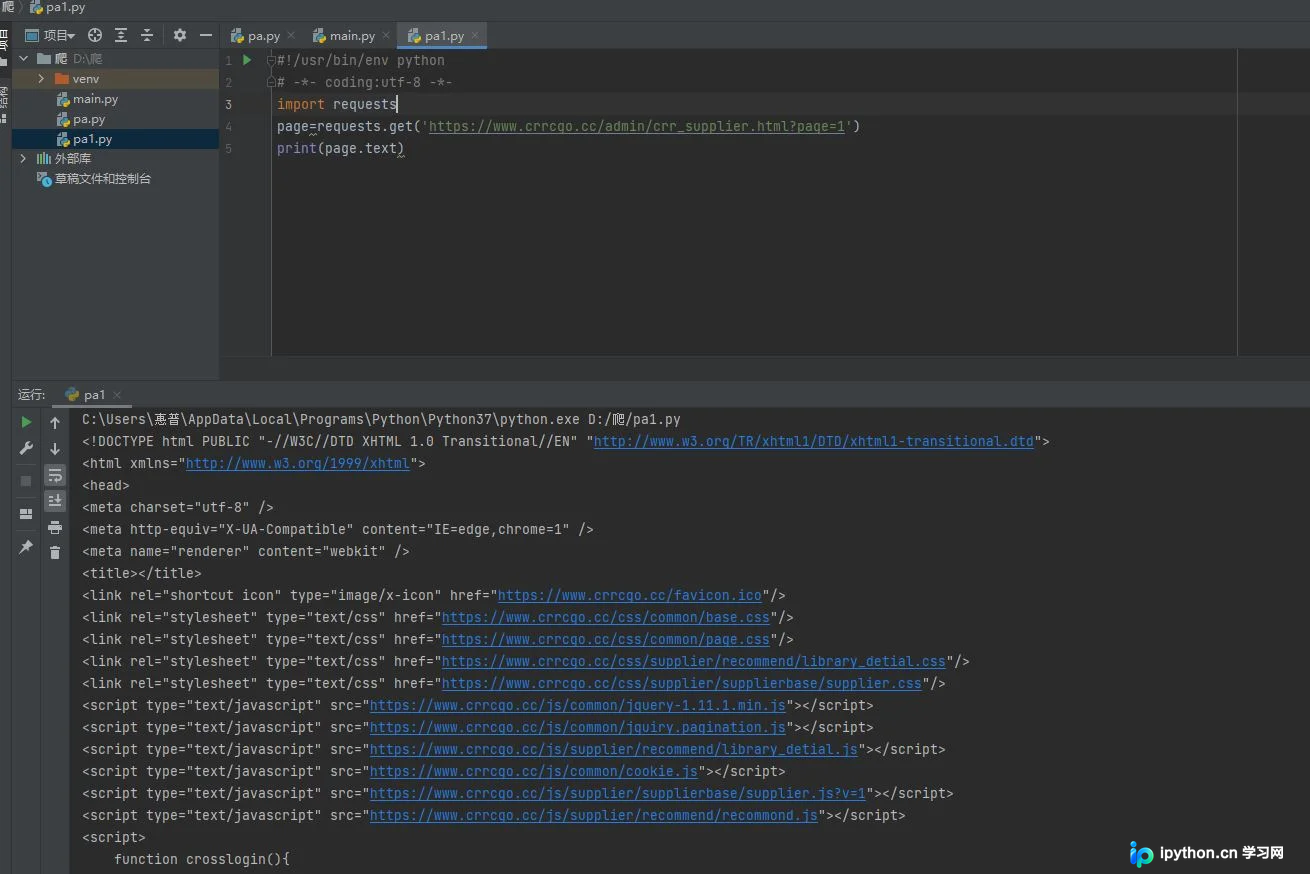
此时已成功爬取到目标网页的源代码。
2.抓取一个网页源代码中的某标签内容
上述步骤获取的代码包含大量尖括号字符,直接阅读并无实际价值。这种包含尖括号的数据即为服务器返回的网页文件,类似于Office的doc或pptx格式,网页通常以HTML格式存在。浏览器负责将这些HTML代码渲染为我们看到的可视页面。
若要从这些字符中提取有价值的数据,必须理解HTML标记元素的含义。
每个标记的文字内容都位于两个尖括号之间,闭合标签以斜杠开头。尖括号内的内容(如img、div)表示标记类型(图片或文本),且标记可包含其他属性(如src)。
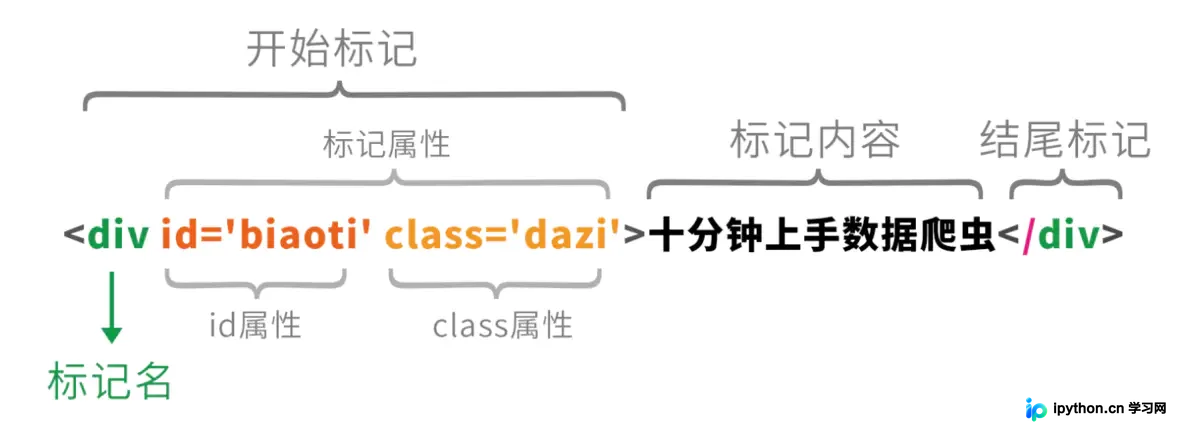
标记内的文字才是我们需要的数据,但通常需要通过id或class属性从众多标记中精准定位目标元素。
在电脑浏览器中打开任意网页,按下F12键即可打开开发者工具的元素查看器(Elements),从而看到构成页面的成百上千个标记元素。
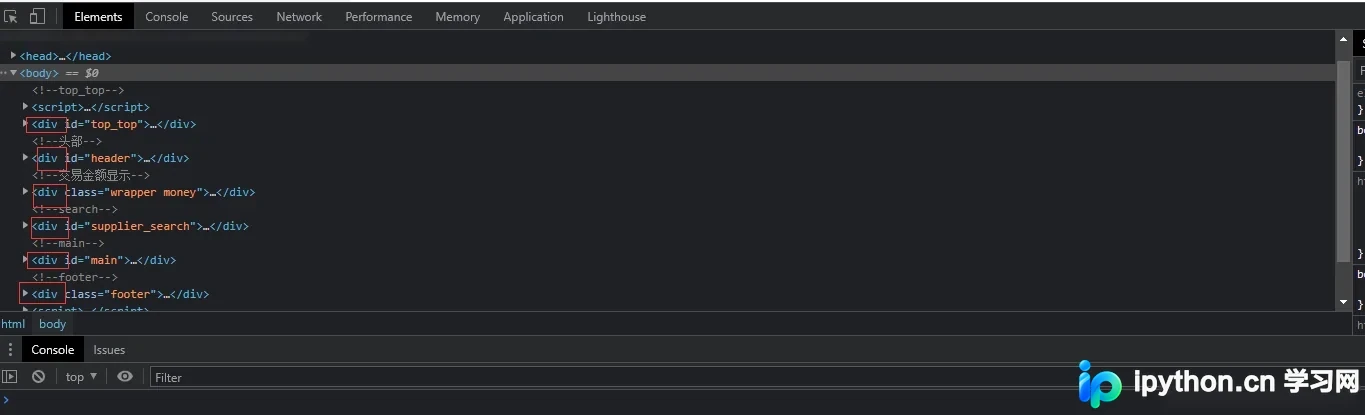
标记元素支持层级嵌套。例如,body嵌套了div元素,其中body为父层(上层)元素,div为子层(下层)元素。
<body>
    <div>十分钟上手数据爬虫</div>
</body>
回到抓取任务,现在仅需提取网页中的公司名称数据,忽略其他无关信息。
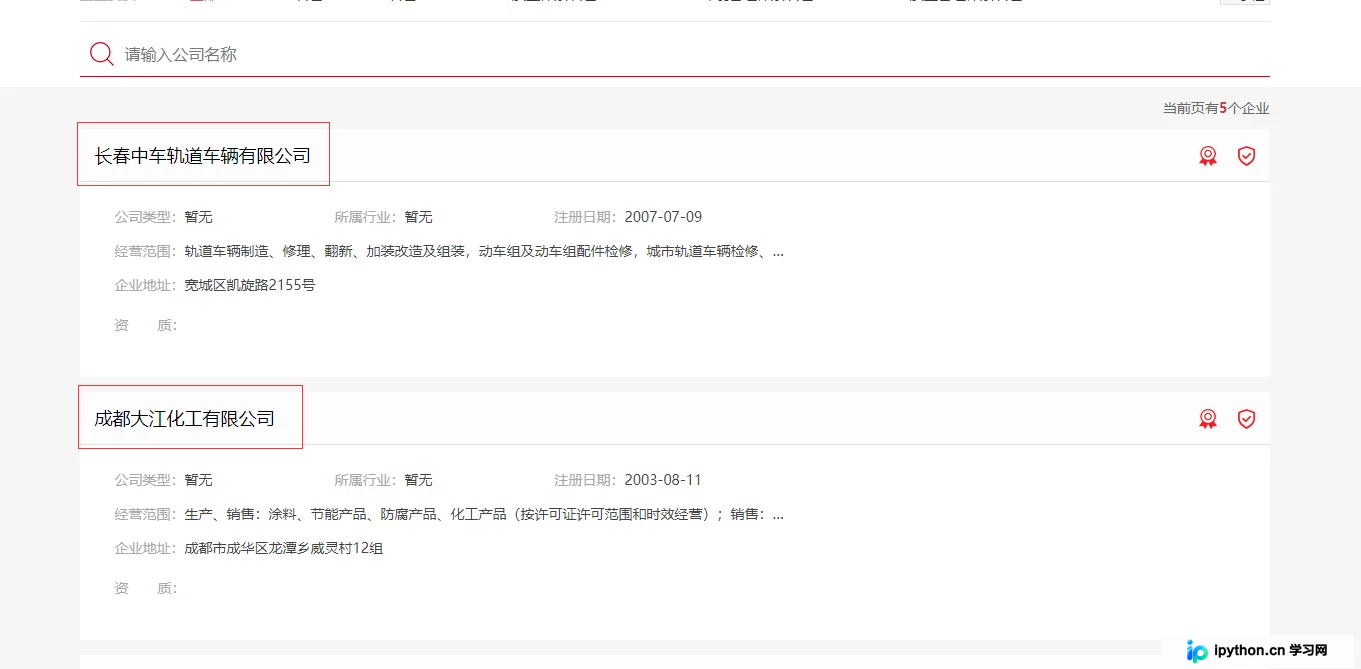
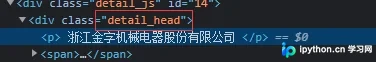
检查网页HTML代码发现,公司名称位于class为detail_head的标签内。
import requests
req=requests.get('https://www.crrcgo.cc/admin/crr_supplier.html?page=1')
前两行代码已在前面解释,用于获取页面原始数据。
from bs4 import BeautifulSoup我们需要使用BeautifulSoup模块将杂乱的HTML数据转换为更易用的格式。语句from bs4 import BeautifulSoup表示从bs4模块中导入BeautifulSoup类,因为bs4包含多个子模块,BeautifulSoup仅为其中之一。
req.encoding = "utf-8"指定获取的网页内容编码格式为utf-8,以确保中文等字符正确显示。
soup = BeautifulSoup(html.text, 'html.parser')该代码使用html解析器分析requests获取的HTML文本内容,soup变量即为解析后的结果对象。
company_item=soup.find_all('div',class_="detail_head")find方法查找单个元素,find_all查找所有匹配元素。此处查找标记名为div且class属性为detail_head的所有元素。
dd = company_item.text.strip()strip()方法用于移除字符串头尾指定的字符(默认为空格或换行符)或字符序列。在此处用于去除提取文本中多余的空白字符。
最终拼接后的完整代码如下:
import requests
from bs4 import BeautifulSoup

req = requests.get(url="https://www.crrcgo.cc/admin/crr_supplier.html?page=1")
req.encoding = "utf-8"
html=req.text
soup = BeautifulSoup(req.text,features="html.parser")
company_item = soup.find("div",class_="detail_head")
dd = company_item.text.strip()
print(dd)
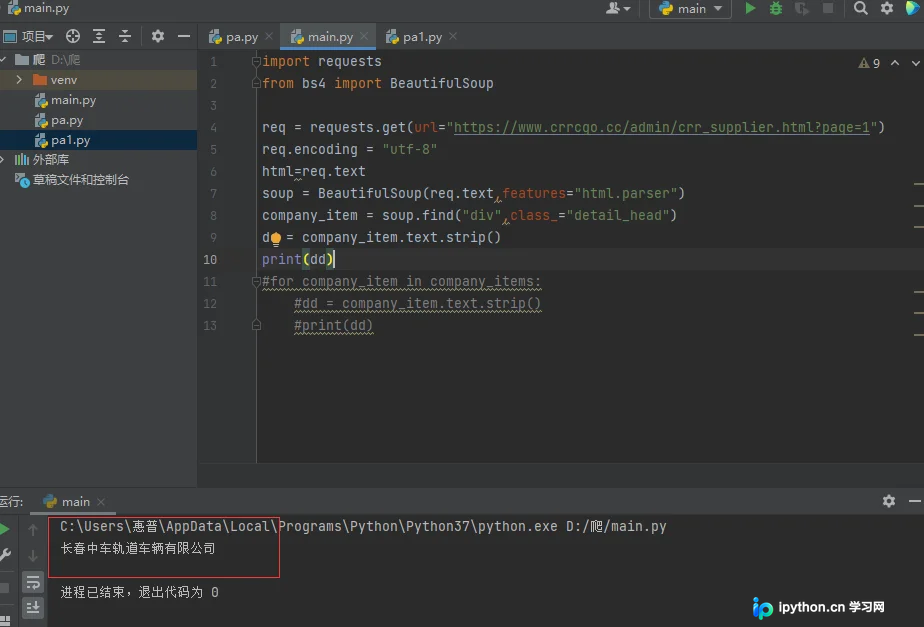
执行结果成功抓取到了网页中我们想要的公司信息,但仅抓取到了一个公司,其余数据并未被提取。
因此,我们需要引入循环结构,以抓取网页中所有的公司名,代码改动不大。
for company_item in company_items:
    dd = company_item.text.strip()
    print(dd)
最终优化后的代码如下:
import requests
from bs4 import BeautifulSoup

req = requests.get(url="https://www.crrcgo.cc/admin/crr_supplier.html?page=1")
req.encoding = "utf-8"
html=req.text
soup = BeautifulSoup(req.text,features="html.parser")
company_items = soup.find_all("div",class_="detail_head")
for company_item in company_items:
    dd = company_item.text.strip()
    print(dd)
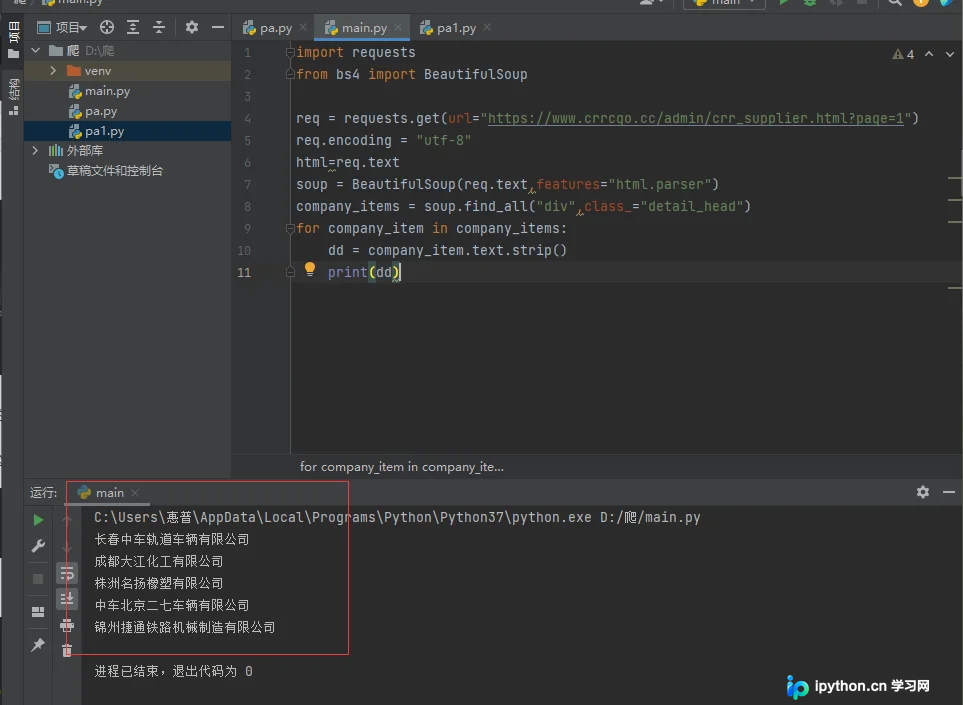
最终运行结果成功查询出该网页中所有的公司名。
3.抓取多个网页子标签的内容
若需抓取多个网页中的公司名,操作很简单:主体代码已写好,只需再次加入循环即可。观察需要抓取的网页链接,发现页面变化仅体现在page参数后的数字上。当然,大型厂商如京东、淘宝的网页结构复杂多变,难以预测,但本例结构较为规律。
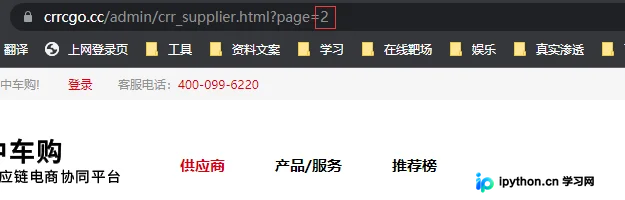
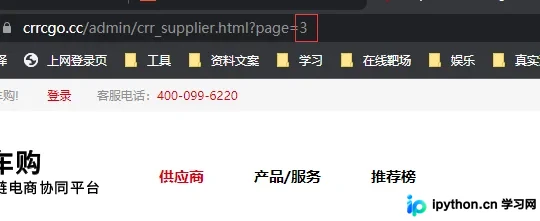
inurl="https://www.crrcgo.cc/admin/crr_supplier.html?page="
for num in range(1,6):
    print("================正在爬虫第"+str(num)+"页数据==================")
编写循环逻辑,仅抓取第1至5页的内容。利用range函数的左闭右开特性,要抓取到第5页,需指定range(1, 6)。
	outurl=inurl+str(num)
    req = requests.get(url=outurl)
将循环变量与URL前缀拼接成完整URL,并获取页面数据。
完整的多页抓取代码如下:
import requests
from bs4 import BeautifulSoup

inurl="https://www.crrcgo.cc/admin/crr_supplier.html?page="
for num in range(1,6):
    print("================正在爬虫第"+str(num)+"页数据==================")
    outurl=inurl+str(num)
    req = requests.get(url=outurl)
    req.encoding = "utf-8"
    html=req.text
    soup = BeautifulSoup(req.text,features="html.parser")
    company_items = soup.find_all("div",class_="detail_head")
    for company_item in company_items:
        dd = company_item.text.strip()
        print(dd)
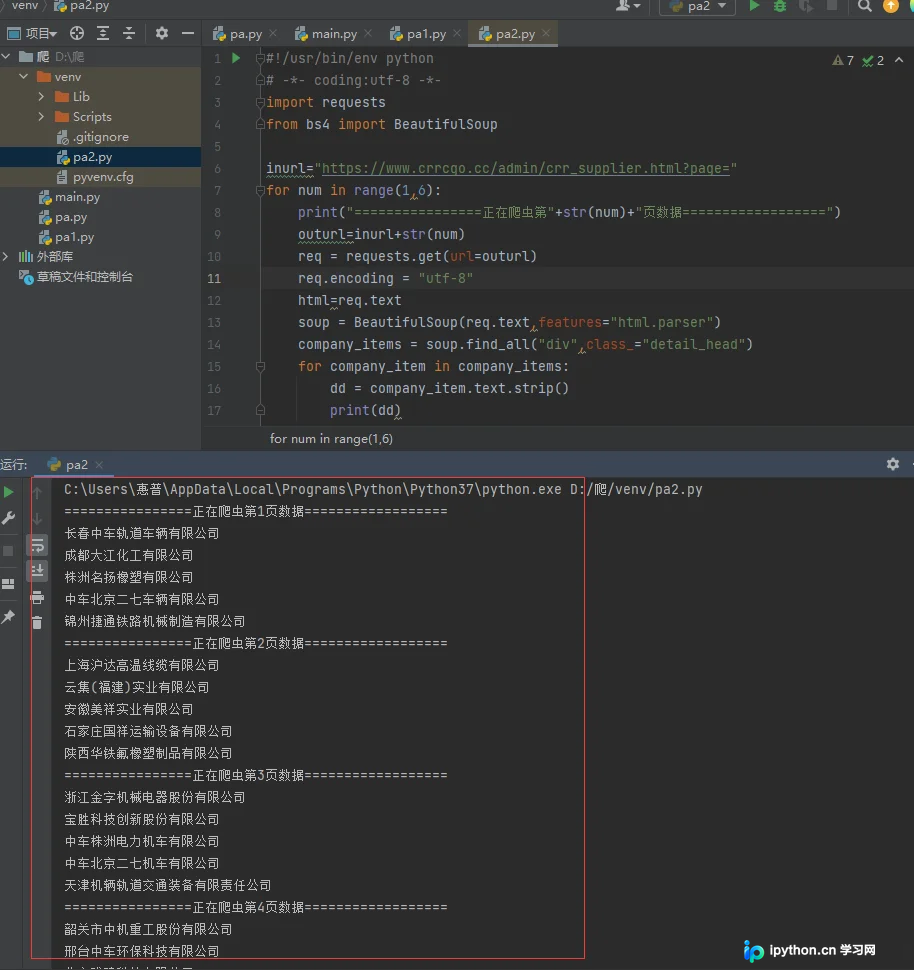
成功抓取到了第1至5页所有公司名(子标签)的内容。
总结
至此,关于Python获取网页指定内容的教程介绍完毕。如需了解更多Python抓取网页相关内容,请搜索本站历史文章或继续浏览后续文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









