

Python列表sort()报错TypeError:混合类型元素怎么排序
详细解析Python 3中列表sort()及sorted()遇到混合类型元素报错TypeError的原因,并提供使用key函数、元组分层、数据清洗等实用排查与排序解决方案。
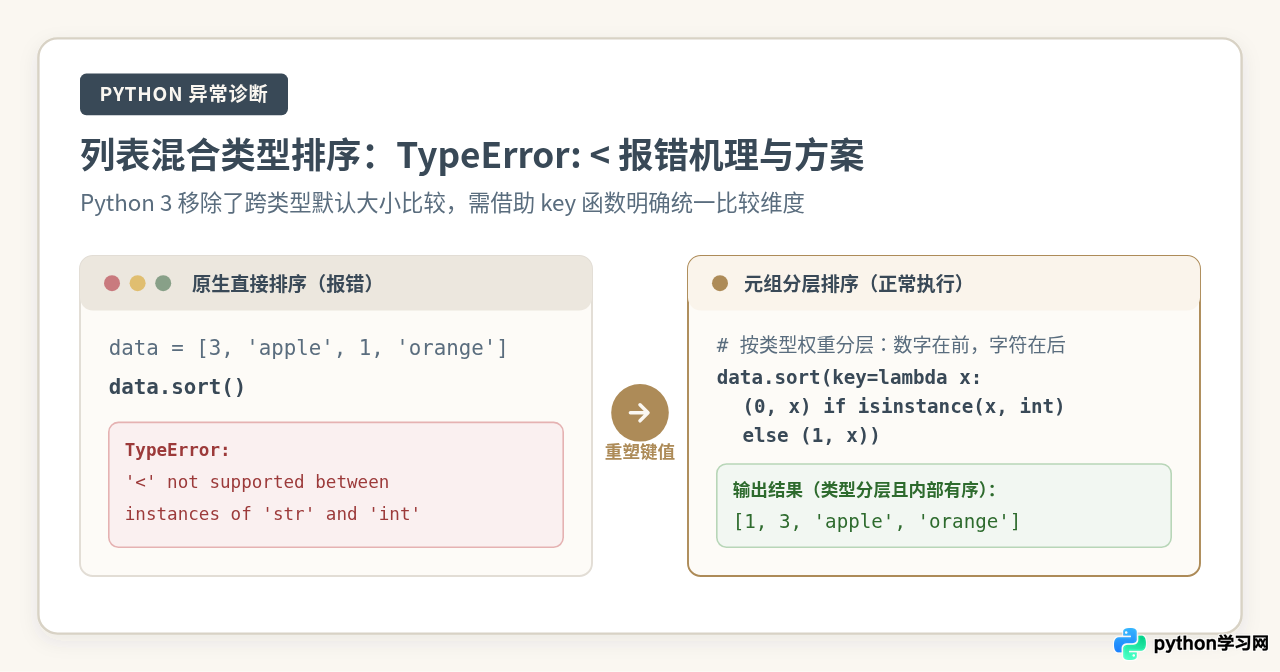
在 Python 3 中直接对包含数字和字符串等混合类型的列表调用 sort() 或 sorted() 时,由于语言移除了跨类型的默认大小比较,程序会立即中断并抛出 TypeError: '<' not supported between instances of 'str' and 'int'。彻底解决这一报错的核心,是利用 key 参数显式定义统一的比较代理逻辑——无论是通过元组按类型分层排序,还是统一转换为字符串,抑或过滤分离独立处理,都能让原本无法直接比对的混合元素具备严谨的比较标准。
一、报错复现与核心诊断
在处理数据抓取、表格解析或无模式(Schemaless)数据接入时,列表内混入不同数据类型是非常普遍的现象。初学者常常下意识调用 data.sort(),随即遭遇程序崩溃。
下面的代码精准复现了这一经典报错场景:
# 环境:Python 3.8+
# 模拟包含整数与字符串的混合列表
raw_data = [42, "apple", 7, "banana", 100, "orange"]

# 直接调用列表的原地排序方法
raw_data.sort()Traceback (most recent call last):
File "<stdin>", line 1, in <module>
TypeError: '<' not supported between instances of 'str' and 'int'
如果列表中混入了 None(例如存在未填充的空字段),或者混入了字典、列表等复合类型,同样会触发完全同类的报错:
- 包含缺失值时:
TypeError: '<' not supported between instances of 'NoneType' and 'int' - 包含浮点与文本时:
TypeError: '<' not supported between instances of 'str' and 'float'
从报错信息可以直接看出,问题不在于 sort() 本身,而在于比较运算符 < 无法在 str 与 int 之间运作。
二、底层机理:为什么 Python 3 严格禁止跨类型比较?
理解这个报错,有助于从根本上掌握 Python 对象模型的设计哲学。在 Python 2 时代,上述代码其实不会报错。早期 Python 允许任意两种不同类型的对象执行 < 比较,其底层规则是按照类型的内部名称进行生硬的字母序排列(例如任何数字都小于字符串,因为 'int' < 'str')。
然而,这种隐式规则在实际生产中滋生了大量难以觉察的幽灵 Bug——程序员常常在不知情的情况下把数字与字符串混排,导致业务逻辑出现荒谬的排列顺序。
因此,Python 3 做出了重大的重大哲学转变:拒绝猜测,推行类型安全(Type Safety)。在底层,排序算法(Timsort)严格依赖对象的魔术方法协议。
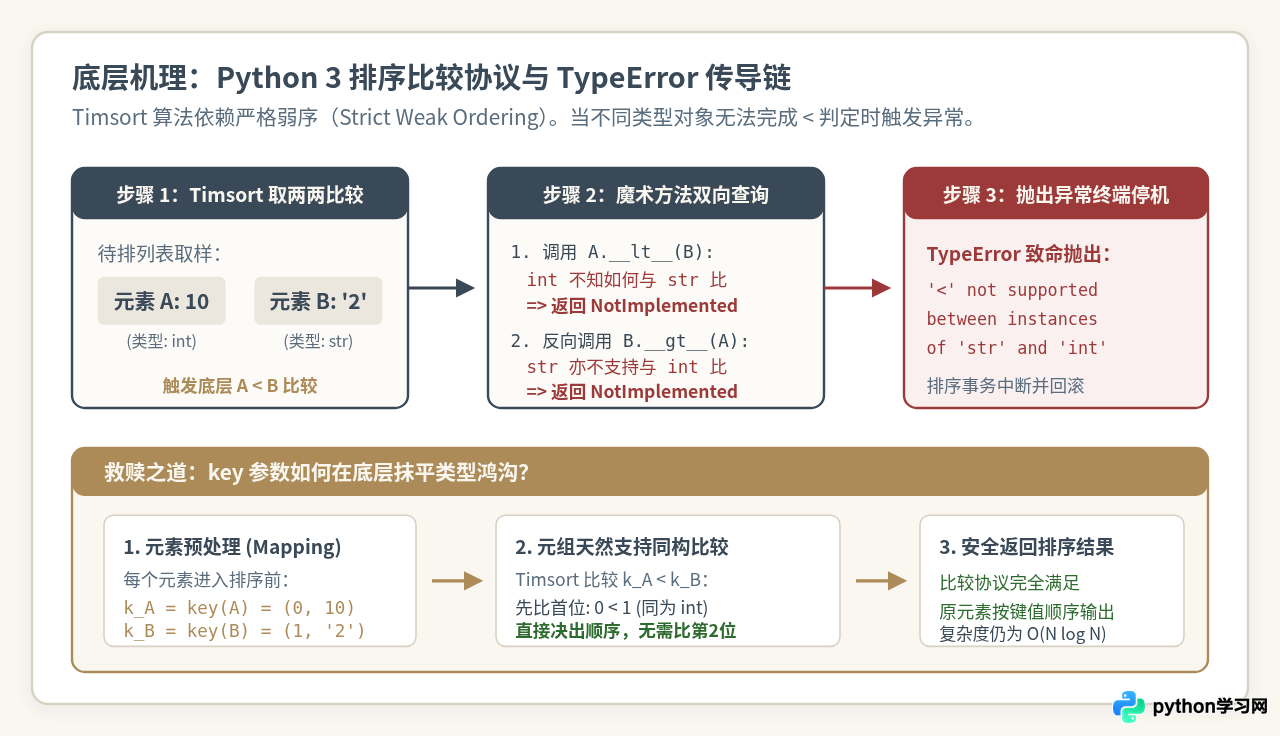
当 Timsort 需要判断元素 A 是否小于 B 时:
- 首先调用
A.__lt__(B)。如果A是整数而B是字符串,整数并不知道如何跟字符串比大小,因此返回系统常量NotImplemented。 - Python 解释器捕获到该信号后,尝试反向对称调用,即调用
B.__gt__(A)。 - 字符串同样无法与整数判定大小,再次返回
NotImplemented。 - 双向魔术方法均告失败,解释器只能中断操作并抛出
TypeError。
而 key 参数之所以能完美破局,是因为它在比较阶段之前执行了一层代理变换(Schwartzian Transform):在 Timsort 开始比较前,先通过 key(item) 为每个元素生成一个可比较的代理键(如数值或同构元组),底层的两两比较全部发生在代理键之间,从而彻底规避了不同类型直接对撞的问题。
三、实操流程:混合类型排序排查与解决四步法
面对报错时,切忌盲目套用代码。遵循清晰的排查流程能够确保排序结果既符合业务预期,又具备防御性。
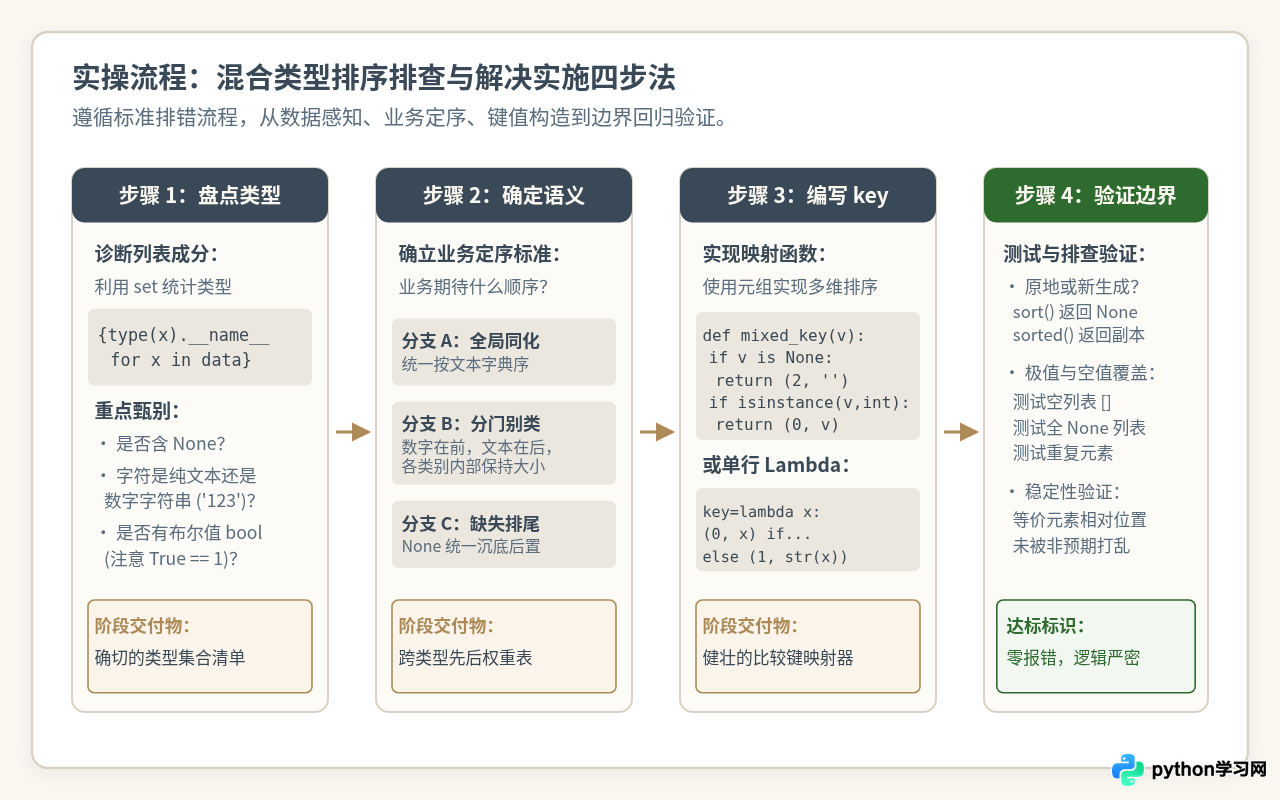
步骤 1:盘点与诊断列表中存在的具体类型
在写排序代码前,首先通过集合推导式快速查看列表中究竟混合了哪些类型:
data = [10, "20", None, 3.14, "apple", -5]

# 快速检视列表中包含的所有具体类型
present_types = {type(item).__name__ for item in data}
print("包含的数据类型:", present_types)
搞清楚元素组成后,重点核实三个细节:是否存在 None(空值)、字符串是否代表数值(如 "20")、以及是否存在布尔值 bool(注意在 Python 中 True == 1,False == 0)。
步骤 2:明确业务定序标准
“混合类型该怎么排”没有唯一的数学标准,必须由业务逻辑定义:
- 同化优先:所有元素仅作字符展示?如果是,统一转换为字符串排序。
- 分组分层优先:数字按数值大小排在前面,字母文本排在中间,无效值
None沉底排在最后。 - 数值解析优先:如果字符串实际是数字(如
"100"),是否需要先当成数字来参与排名?
步骤 3:编写对应的 key 函数
根据步骤 2 选定的规则构造 key。利用 Python 中元组(Tuple)逐元素对比的特性,构造 (优先级层级, 实际比较值) 是最强大的设计范式。
步骤 4:执行排序并做边界回归验证
验证空列表 []、全 None 列表以及包含重复键值的情况,并确认是需要原地修改(list.sort())还是生成新列表(sorted())。
四、核心解决方案与代码实践
方案 1:元组分层法(最通用、生产环境首选)
利用元组 (type_order, value) 作为键值。因为 Python 在比较两个元组时,会从索引 0 开始逐项对比;只要索引 0 的数字不同(例如 0 < 1),就能立刻决定顺序,完全不会触碰索引 1 中不同类型的元素!
data = [42, "banana", 7, "apple", 100, "orange"]

# 定义排序键:数字权重赋予 0,字符串权重赋予 1
# 数字之间比数字大小,字符串之间比字典序
sorted_data = sorted(data, key=lambda x: (0, x) if isinstance(x, (int, float)) else (1, x))

print("元组分层排序结果:", sorted_data)此方法完美兼顾了数值的大小逻辑(7 < 42 < 100)和文本的字典序逻辑('apple' < 'banana' < 'orange'),彼此互不干扰。
方案 2:处理包含 None 的特殊情形
数据处理中最常见的混合是“有效数据”混入 None。如果希望保留原数据排序并将 None 统一放置在末尾,可以使用布尔判定作为元组首元素:
scores = [88, None, 95, 62, None, 74]

# x is None 的布尔结果:有效值返回 False (0),None 返回 True (1)
# 因为 0 < 1,所以所有数值排在前面,None 自动沉底到最后
scores.sort(key=lambda x: (x is None, x))

print("None 沉底排序结果:", scores)(x is None) 均为 False,Python 会继续比较第二项 x(即数字大小);而当两个元素都是 None 时,首项均为 True,Python 虽然会去比较第二项 None < None,但在同一元组比较中,Timsort 发现相等即视为平局,不会触发异常。为保证 100% 稳妥,也可以写成 key=lambda x: (1, 0) if x is None else (0, x)。
方案 3:全局字符串化(适合快速排查与日志输出)
如果不介意数值大小被转换为字典序,最直截了当的方式是传入内置函数 str:
data = [10, "apple", 2, "banana"]

# 原地修改,全部按 str(x) 比较
data.sort(key=str)

print("统一转字符串结果:", data)'1' 小于 '2',因此 '10' 会排在 '2' 前面(如上方输出所示)。因此,若业务要求 2 < 10,绝对不能使用 key=str!
方案 4:支持多类型权重分配的完整函数
对于更复杂的生产场景(例如同时包含整数、浮点、字符串、布尔值及 None),可以编写独立的辅助函数来分发类型权重:
def mixed_sort_key(item):
    # 定义类型优先级权重:数值类=0, 字符串=1, 其他对象=2, None=3
    if item is None:
        return (3, "")
    if isinstance(item, bool):
        # 注意:bool 是 int 的子类,若需单独排布必须优先判断
        return (1, int(item))
    if isinstance(item, (int, float)):
        return (0, item)
    if isinstance(item, str):
        return (2, item)
    return (4, str(item))

complex_list = ["test", None, 3.14, True, 10, "alpha", False, -2]
sorted_complex = sorted(complex_list, key=mixed_sort_key)
print("复杂混合排序结果:", sorted_complex)五、策略横向对比与技术选型
在实际项目落地中,选择哪种方案取决于对性能、代码可维护性以及排序语义的综合权衡。
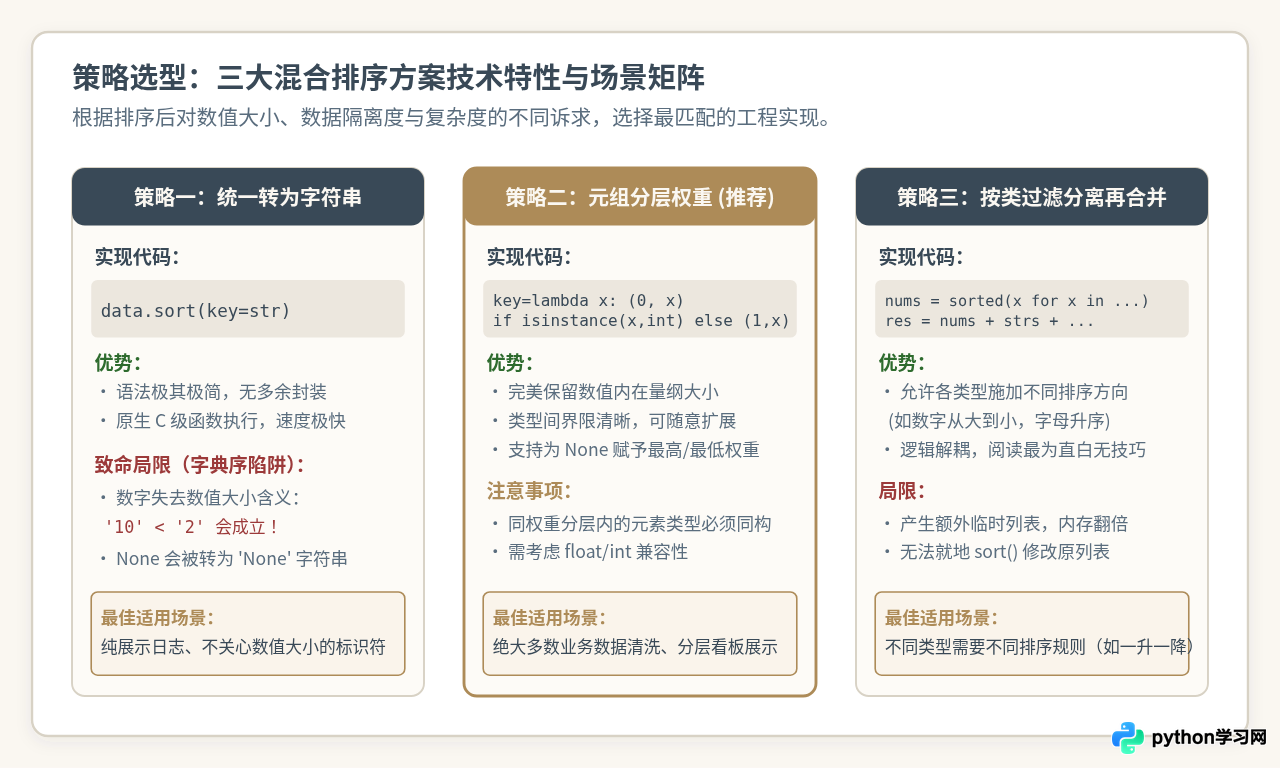
| 解决方案 | 实现复杂度 | 数值逻辑准确度 | 性能开销 | 推荐使用场景 |
|---|---|---|---|---|
| 元组分层法 (Tuple Key) | 中(一行 lambda 或辅助函数) | 高(完全保留真实数值量纲) | 低(key 仅计算一次,无冗余数据复制) | 绝大多数业务数据清洗、管理后台表格呈现 |
| 全局统一转字符串 (key=str) | 极低(直接传参 key=str) |
差(落入字典序陷阱,10 排在 2 前) | 极低(底层 C 级别转化) | 快速排查、仅用于屏幕日志纯文本输出 |
| 分类过滤合并 (Split & Merge) | 中(多行列表推导与拼接) | 极高(各类型可应用独立排序规则) | 中(创建了多个临时列表副本) | 各类类型有截然不同的排序方向(如数值降序、文本升序) |
六、避坑要点与进阶注意事项
1. sort() 与 sorted() 的返回值陷阱
这是刚接触 Python 列表操作时发生率最高的失误之一:
data = [3, "a", 1]
# ❌ 典型错误:误以为 sort() 会返回排好序的列表
result = data.sort(key=lambda x: (0, x) if isinstance(x, int) else (1, x))
print(result)  # 输出: None!原列表 data 被就地修改了
请牢记:list.sort() 是列表专有的原地变异方法,执行后返回值为 None;如果需要链式调用或保留原列表,必须使用内置函数 sorted(data, key=...)。
2. reverse=True 参数对元组键的作用机制
当你在使用元组分层法时加上 reverse=True,Python 会将元组中的所有维度一并倒序:
data = [10, "apple", 5, "banana"]
# 如果加上 reverse=True,权重 1 的字符串会排到 权重 0 的数字前面!
res = sorted(data, key=lambda x: (0, x) if isinstance(x, int) else (1, x), reverse=True)
print(res)  # 输出: ['banana', 'apple', 10, 5]
如果期望“类型顺序不变(数字仍在前),但同类型内部倒序”,应该在元组内部对数值取反(例如 (0, -x)),而不是全局开启 reverse=True。
3. Timsort 算法的稳定性保证
Python 内置的排序算法(Timsort)是稳定排序(Stable Sort)。这意味着如果列表中有两个元素的 key 映射结果完全相同,它们在排序后的相对前后位置严格保持不变。这一特性确保了在使用多级分层排序时,不会引入意外的位置扰动。
七、知识总结与排错检查清单
面对混合类型列表排序报错,只需按照以下全景思维导图与核对项进行逐项排查,即可快速解决问题。
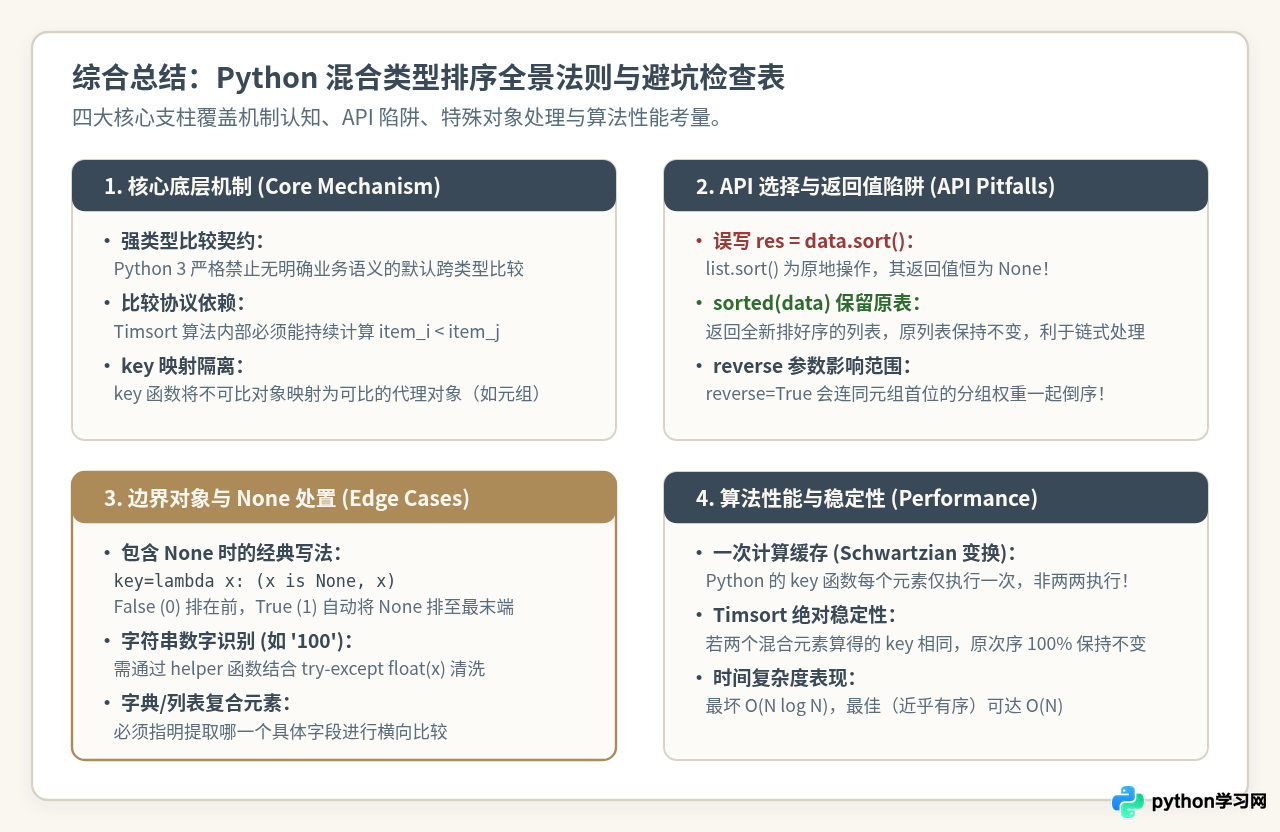
- [ ] 数据源审查:通过
{type(x) for x in data}明确列表中的全部类型。 - [ ] 空值判定:确认列表中是否包含
None,是否已做好(x is None, ...)沉底策略。 - [ ] 语义选择:需要保持数字真实大小还是纯字典序?切忌对数字列表随意使用
key=str。 - [ ] 方法选择:原地更新选择
data.sort(key=...),生成新列表选择sorted(data, key=...)。 - [ ] 边界覆盖:运行单元测试,验证空列表
[]与单元素列表均能正常通过。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









