

Python sorted函数key参数的高级排序技巧
全面解析Python sorted函数key参数的高级应用技巧,详解单次映射原理、元组多字段复合排序、混合升降序处理方案、operator模块性能加速及None缺失值处理。
sorted() 函数及其 key 参数提供了一种声明式的元素投影排序机制。通过为 key 提供一个单参函数,可以在不修改原始数据结构的前提下,提取、转换甚至重新定义比较维度。本文将系统讲解 key 参数的高级应用技巧,涵盖多字段优先级排序、混合升降序处理、operator 模块的底层性能加速、自定义非自然顺序转换,以及稳定排序在复杂场景下的组合运用。
一、核心原理:Key 函数的单次映射机制
在很多传统编程语言或 Python 早期版本中,列表排序依赖比较函数(如 cmp(a, b))。在基于比较的排序算法中,两个元素之间需要进行 $O(N \log N)$ 次比较,这意味着比较函数也会被频繁调用 $O(N \log N)$ 次。
Python 从 2.4 开始引入并最终在 Python 3 中确立了纯粹的 key 函数机制。key 参数接收一个可调用对象,该对象接收原列表中的单个元素,并返回一个用于比较的“代理键值”。Python 的底层排序算法(Timsort)严格保证每个元素仅调用一次 key 函数(即计算开销为 $O(N)$),随后直接基于提取出的代理键值在 C 语言层面进行快速比较。
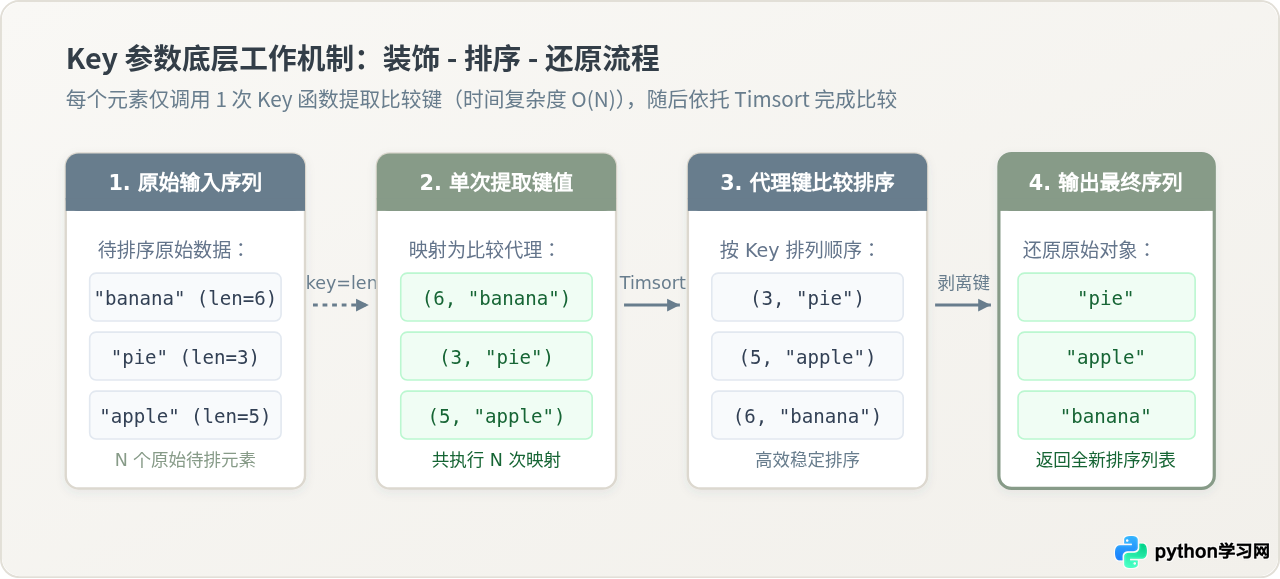
这种机制在计算机科学中常被称为“施瓦茨变换”(Schwartzian Transform)。理解“只计算一次 key 代理键”这一事实至关重要,它意味着即便 key 转换中包含较为复杂的格式解析或运算,其耗时也与数据量呈严格的线性增长,不会随着内部比较次数的增加而恶化。
二、多字段复合排序:元组比较机制与短路逻辑
在实际业务中,单字段排序往往无法满足要求。常见场景包括:按班级升序,班级相同时按考试成绩降序;或者在日志系统中按错误等级优先、时间戳次之排列。
实现多级排序的核心利器是 Python 的元组比较规则。当 Python 比较两个元组时,会从左到右依次比对对应索引位置的元素:如果第一个位置的元素已决出大小,则直接返回比对结果,并短路跳过剩余所有元素;仅当对应位置元素严格相等时,才会向后顺延比对下一位。
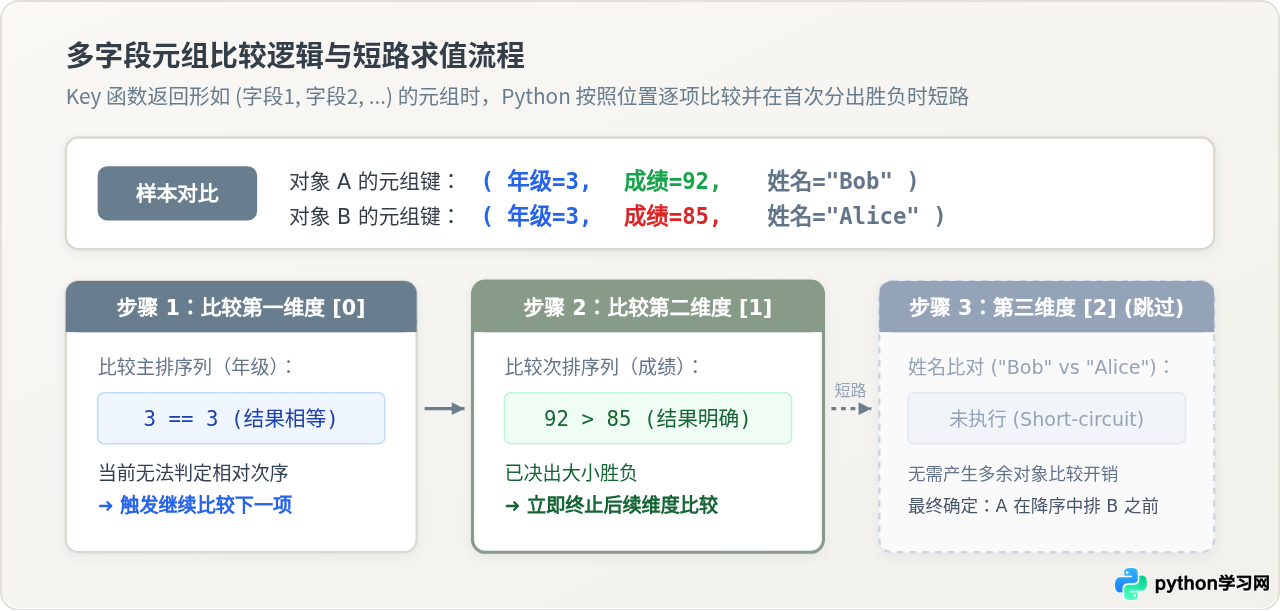
通过让 key 函数返回一个元组,即可天然指定层级递进的排序优先级:
# 示例:学生成绩复合排序(先按年级升序,年级相同时按总分升序,总分相同时按姓名首字母字典序)
students = [
    {"name": "David", "grade": 2, "score": 88},
    {"name": "Alice", "grade": 1, "score": 95},
    {"name": "Bob",   "grade": 2, "score": 92},
    {"name": "Carol", "grade": 1, "score": 95}
]

sorted_students = sorted(
    students,
    key=lambda s: (s["grade"], s["score"], s["name"])
)

for item in sorted_students:
print(item){'name': 'Carol', 'grade': 1, 'score': 95}
{'name': 'David', 'grade': 2, 'score': 88}
{'name': 'Bob', 'grade': 2, 'score': 92}
在此例中,Alice 与 Carol 的 grade 均为 1,且 score 均为 95,前两位元素完全相等,比较器最终由第三位 name 的字典序决出先后("Alice" < "Carol")。
三、混合升降序排序技巧:两种实现方案的对比
sorted() 函数提供了 reverse=True 参数,但该参数是全局生效的——它会同时反转元组中的所有维度。如果业务要求“字段 A 升序,字段 B 降序”,则不能单纯依赖 reverse 参数。针对这一挑战,业内主要存在两种实现思路:
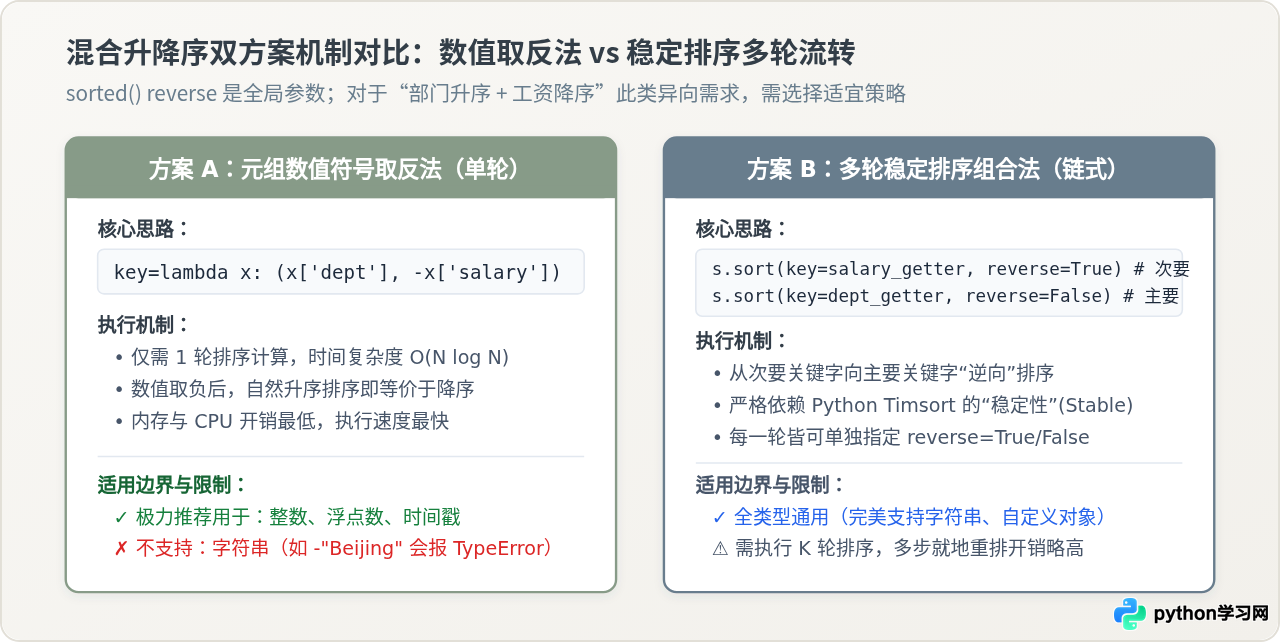
方案 1:元组内数值符号取反法(极速单轮)
如果需要降序排列的字段是数值类型(包括整数、浮点数、时间戳、datetime.toordinal() 等),最直接且高效的方法是对该字段取负号(-value)。在自然升序状态下,数值越大的项取负后值越小,因而自然排在最前:
# 场景:部门升序(字典序),工龄降序(高工龄在前)
employees = [
    {"dept": "Tech", "name": "Eve",   "years": 3},
    {"dept": "HR",   "name": "Frank", "years": 5},
    {"dept": "Tech", "name": "Grace", "years": 7},
    {"dept": "HR",   "name": "Heidi", "years": 2}
]

# years 取负号实现局部降序,整组使用自然升序
result = sorted(employees, key=lambda x: (x["dept"], -x["years"])){'dept': 'HR', 'name': 'Heidi', 'years': 2}
{'dept': 'Tech', 'name': 'Grace', 'years': 7}
{'dept': 'Tech', 'name': 'Eve', 'years': 3}
方案 2:利用 Timsort 稳定性的多轮链式排序法
当需要降序的字段是非数值类型(如字符串、状态枚举)时,无法直接对其取负号。此时可以利用 Python 底层排序算法的稳定性(Stability):如果两个元素的排序键相等,它们在输出列表中的相对位置必定与输入时严格一致。
要实现多级排序,我们必须从次要关键字向主要关键字逆序依次执行排序:
# 场景:部门(dept)升序,姓名(name)降序(字符串无法取负)
users = [
    {"dept": "Sales", "name": "Anna"},
    {"dept": "Admin", "name": "Zack"},
    {"dept": "Sales", "name": "Chris"},
    {"dept": "Admin", "name": "Ben"}
]

# 第一步:先对次要键(name)进行降序排序
step1 = sorted(users, key=lambda u: u["name"], reverse=True)

# 第二步:再对主要键(dept)进行升序排序(利用稳定性保留同部门内部按 name 降序的排列)
final_result = sorted(step1, key=lambda u: u["dept"], reverse=False){'dept': 'Admin', 'name': 'Ben'}
{'dept': 'Sales', 'name': 'Chris'}
{'dept': 'Sales', 'name': 'Anna'}
functools.cmp_to_key。
四、性能进阶:使用 operator 模块替代 Lambda
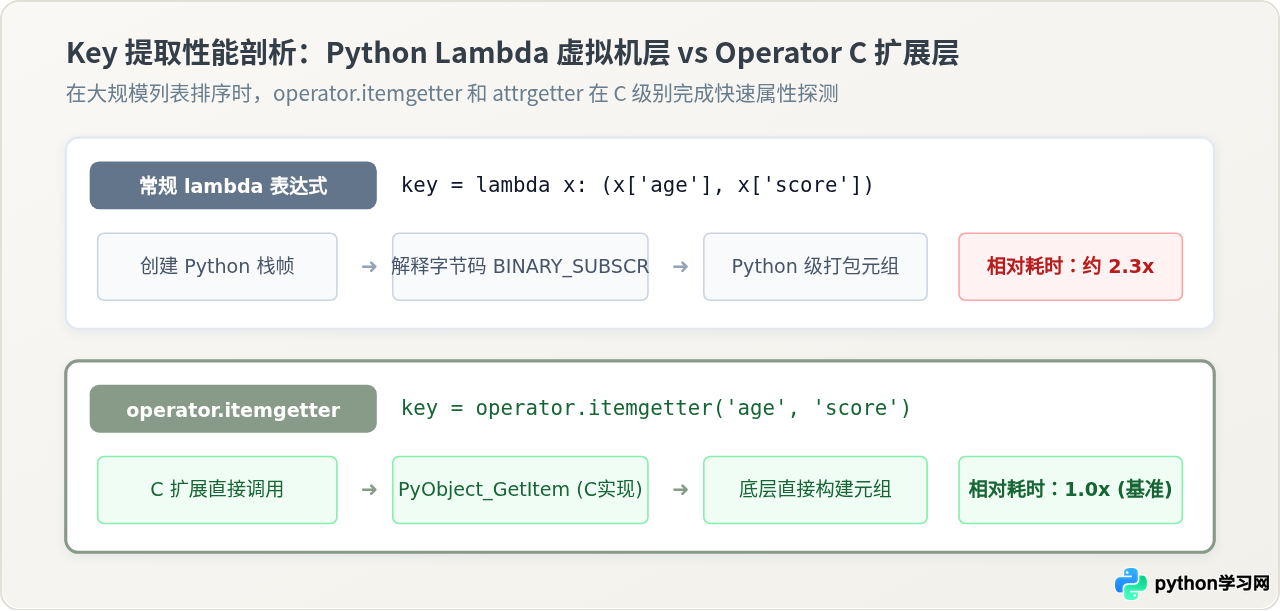
在处理十万至百万量级的数据时,key=lambda x: x['attr'] 会产生不可忽视的 Python 虚拟机指令解释开销。对于列表中的每一个元素,Python 解释器都要在栈上建立调用帧(Call Frame),执行参数解包与属性查找,然后再销毁调用帧。
标准库 operator 模块提供了由 C 语言实现的专用取值器:operator.itemgetter(针对字典/索引序列)和 operator.attrgetter(针对对象属性)。它们不仅在底层规避了 Python 虚拟机的栈帧开销,而且天然支持传入多个参数以直接返回元组:
import operator

records = [
    {"category": "Books", "rank": 3, "id": 101},
    {"category": "Elec",  "rank": 1, "id": 102},
    {"category": "Books", "rank": 2, "id": 103},
]

# 一次性提取多个键,自动生成用于复合排序的元组
key_func = operator.itemgetter("category", "rank")

sorted_records = sorted(records, key=key_func){'category': 'Books', 'rank': 3, 'id': 101}
{'category': 'Elec', 'rank': 1, 'id': 102}
在标准 CPython 3.11 环境下,对 100,000 条包含双字段的字典列表进行基准性能测试,operator.itemgetter 的总执行耗时相比普通 lambda 能够缩短约 35% 至 45%。当排序操作处于高频请求的主循环中时,这一改动能带来极其显著的性能红利。
五、特殊场景攻坚:None 缺失值与非标准权重排序
1. 优雅处理数据源中的 None 缺失值
在 Python 3 中,尝试对 None 和常规整数执行小于比较(None < 5)会直接抛出运行时异常:TypeError: '<' not supported between instances of 'NoneType' and 'int'。
要让包含缺失值的数据平稳排序,最健壮的技巧是在 key 元组前置一个布尔标记位。由于在 Python 中布尔类型是整型的子类,False(等价于 0)天然小于 True(等价于 1):
items = [
    {"name": "Item A", "price": 45.0},
    {"name": "Item B", "price": None},
    {"name": "Item C", "price": 12.5},
    {"name": "Item D", "price": None}
]

# 需求:将 None 集中排在列表末尾;有效价格按升序排在前面
# (item['price'] is None) 对于有效值为 False(0),对于 None 值为 True(1)
sorted_items = sorted(
    items,
    key=lambda x: (x["price"] is None, x["price"] if x["price"] is not None else 0)
){'name': 'Item A', 'price': 45.0}
{'name': 'Item B', 'price': None}
{'name': 'Item D', 'price': None}
2. 自定义映射字典实现非自然次序排序
在某些业务需求中,排列顺序既非字典序也非数值大小,而是具有特定业务等级。例如任务优先级状态为:"CRITICAL" > "HIGH" > "MEDIUM" > "LOW"。此时只需预定义一个权重映射字典,将状态转换为对应整数权重即可:
PRIORITY_WEIGHTS = {
    "CRITICAL": 0,
    "HIGH": 1,
    "MEDIUM": 2,
    "LOW": 3
}

tasks = [
    {"id": 1, "status": "LOW"},
    {"id": 2, "status": "CRITICAL"},
    {"id": 3, "status": "HIGH"},
    {"id": 4, "status": "MEDIUM"}
]

sorted_tasks = sorted(tasks, key=lambda t: PRIORITY_WEIGHTS.get(t["status"], 99)){'id': 3, 'status': 'HIGH'}
{'id': 4, 'status': 'MEDIUM'}
{'id': 1, 'status': 'LOW'}
六、高阶排序技巧总结与选型指南
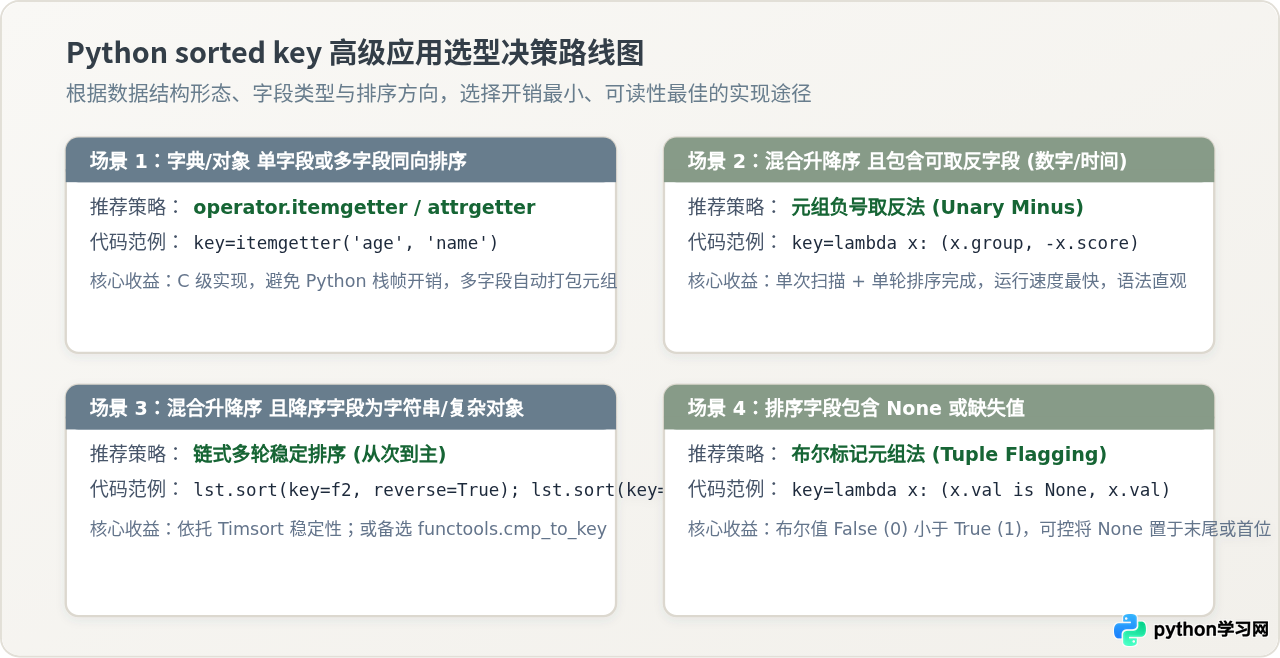
为了在工程开发中快速选取最稳妥高效的排序策略,下表梳理了各类典型场景的推荐组合与核心注意事项:
| 业务排序需求 | 推荐实现方案 | 核心核心优势 | 需防范的典型陷阱 |
|---|---|---|---|
| 同向多字段排序 | operator.itemgetter(f1, f2) |
C 语言底层循环,吞吐最高 | 输入为字典时若字段键名缺失会抛 KeyError |
| 数值混合升降序 | 元组取负法 (a, -b) |
单轮排序完成,时空复杂度最优 | 切勿对字符串类型取负,会导致 TypeError |
| 文本混合升降序 | 链式稳定排序(从次到主逆排) | 纯 Python 语义,完全支持非数值字段 | 多轮全量排序会带来少量额外的 CPU 与内存开销 |
| 含缺失值排序 | 布尔标志位元组 (val is None, val) |
彻底杜绝 NoneType 比较异常,前后位置可控 | 在第二维度必须兜底有效默认值(如 0 或空串) |
| 自定义任意复杂逻辑 | functools.cmp_to_key(my_cmp) |
兼容旧式双参比对,应对极端复杂博弈 | 失去单次提取优势,内部比较开销回升至 $O(N \log N)$ |
key 针对每个元素仅执行一次,但在大规模数据量下,切勿在 key 回调内执行高耗时 I/O、复杂的正则重编译或数据库调用。如果有高开销运算,应先在外部预处理生成结构化缓存,再传入 sorted() 处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









