

Python用pandas读取Excel文件的最简步骤
详细介绍使用Python的pandas库读取Excel文件的最简操作步骤,包含依赖安装、核心代码实现、底层工作机理、实用参数控制及常见排错指南。
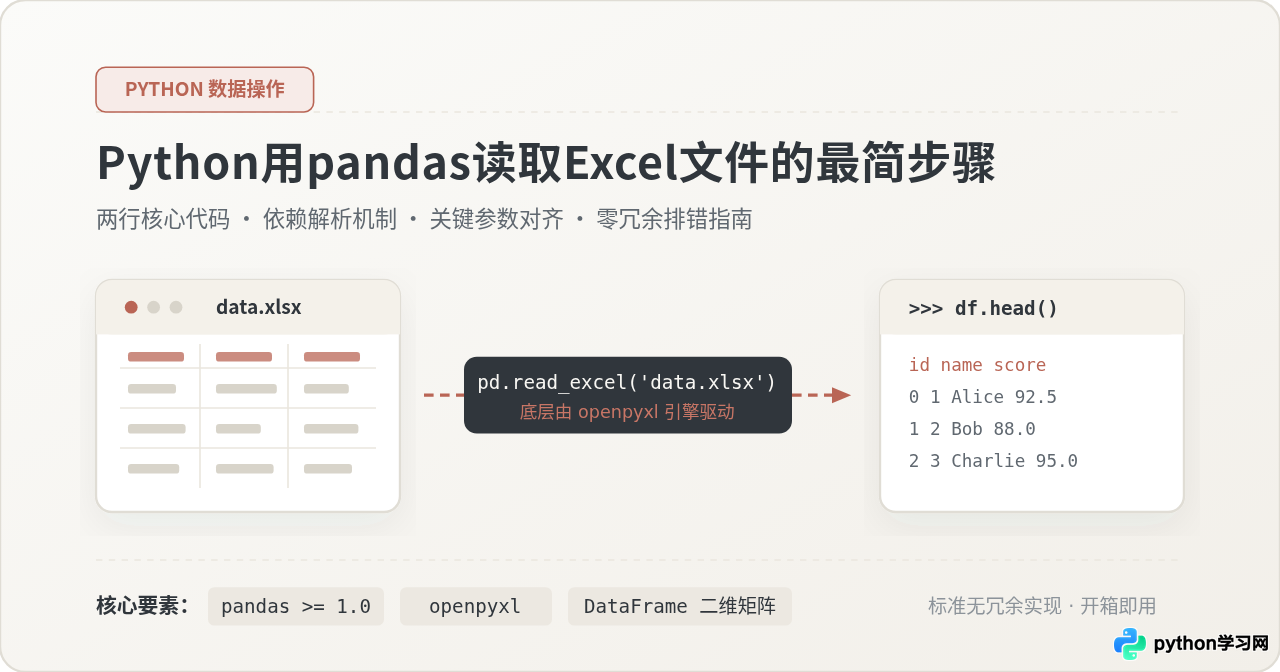
pandas 库读取 Excel 文件最简明的操作路径仅需两步:在终端环境中确保安装了 pandas 和底层解析引擎 openpyxl,随后在 Python 脚本中调用 pd.read_excel('文件名.xlsx'),即可将表格内容载入为二维结构数据(DataFrame)。本文不作泛泛背景铺垫,直接提供清晰可执行的完整代码、关键操作步骤及高频注意事项。
一、前置准备:安装必要的运行依赖
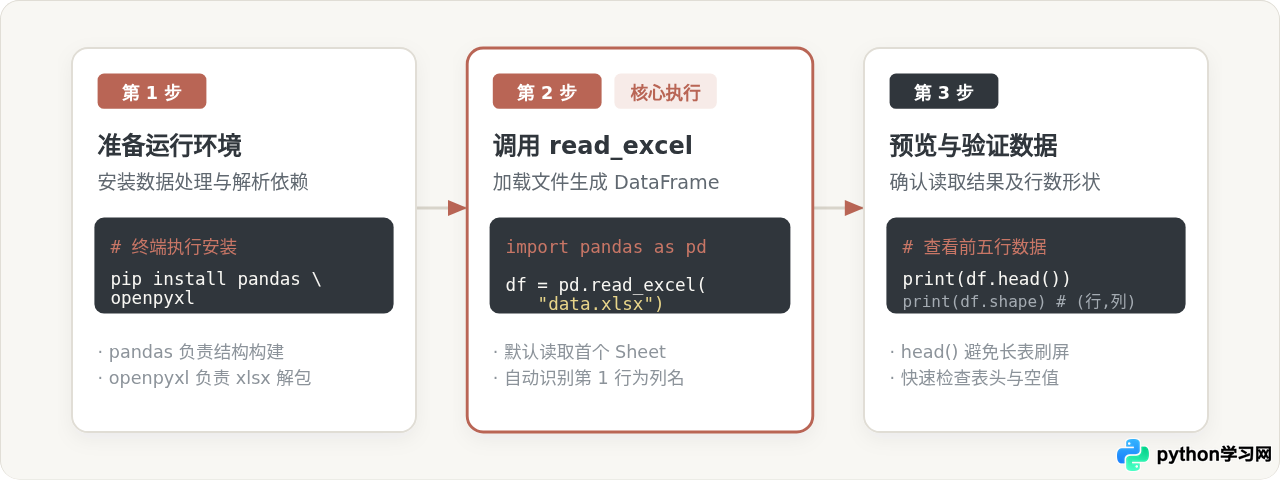
初学者最常产生的一个误解是:既然已经安装了 pandas,理应可以直接处理所有的表格格式。然而在实际执行时,直接读取 .xlsx 文件往往会抛出 ModuleNotFoundError: No module named 'openpyxl'。
这是因为 pandas 本身专注于提供高效的二维数据结构(DataFrame)与向量化计算接口,它并不直接实现 Office Open XML 压缩包的解构逻辑。对于现代标准的 .xlsx 格式,pandas 依赖第三方库 openpyxl 作为引擎来完成二进制解码与单元格解析。因此,完整的运行环境要求两者同时就绪。
打开系统终端(Windows 命令提示符 / PowerShell 或 macOS / Linux 终端),执行以下一行命令安装所需依赖:
# 在终端或命令行中执行安装命令(国内镜像可加速)
pip install pandas openpyxl
安装完成后,可在命令行通过 python -c "import pandas, openpyxl; print('OK')" 进行简短自检。若终端输出 OK 且无报错,即代表基础环境已搭建完毕。
二、核心实现:最简三步读取代码
在确认依赖就绪后,完成文件读取的核心代码仅有三步:导入模块、调用读取函数、输出验证。假设当前脚本同级目录下存在一个名为 data.xlsx 的表格文件。
import pandas as pd

# 1. 核心读取步骤:传入文件路径,载入数据为 DataFrame
df = pd.read_excel("data.xlsx")

# 2. 验证结果:通过 head() 快速查看前 5 行数据与表头结构
print(df.head())

# 3. 检查数据形状(输出格式为:(行数, 列数))
print("数据总形状:", df.shape)
运行上述代码后,pandas 会将 Excel 内部的内容解析为一个二维表格对象。终端中打印出的结果包含行索引(从 0 开始自增)、表头列名以及对应单元格的值。使用 df.head() 的好处在于即使 Excel 拥有数十万行数据,也仅在控制台显示前 5 行,避免终端被冗余数据刷屏。
三、底层机理:pandas与解析引擎的协作
理解 pd.read_excel() 的底层运转原理,有助于在面对不同版本格式与性能要求时做出正确判断。
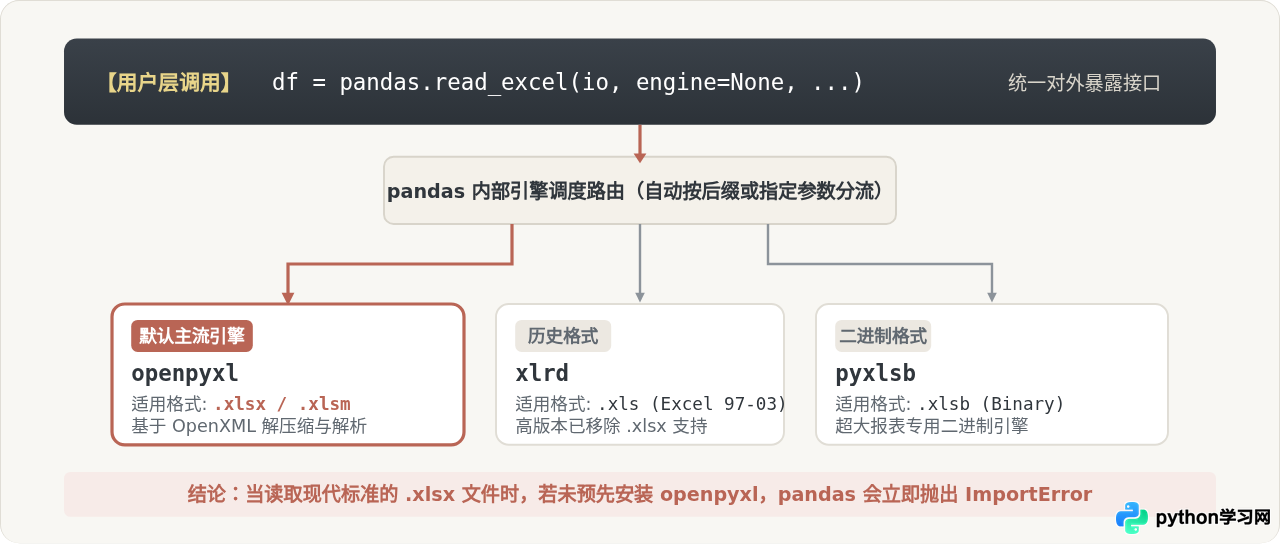
当调用 pd.read_excel("data.xlsx") 时,pandas 内部会根据文件名的后缀名进行自动路由分发:
-
对于
.xlsx与.xlsm文件:默认选用openpyxl引擎。该引擎负责解开 zip 压缩包,遍历其中的 XML 节点并提取单元格类型、数值及文本。 -
对于
.xls(Excel 97-2003 历史二进制格式):默认调用xlrd引擎。需要特别提醒的是,新版本的xlrd(>=2.0)基于安全原因已完全移除了对.xlsx格式的支持,仅能读取老旧的.xls。 -
对于
.xlsb(Excel 二进制大型工作簿):默认或手动指定选用pyxlsb引擎,适合超大规模数据的快速读取。
引擎完成单元格原始数据的提取后,将其统一交还给 pandas 构建内存中的 BlockManager,自动推断每列的数据类型(整数、浮点数、字符串或日期时间),最终封装为读者所操作的 DataFrame。
四、实际场景中必不可少的三项参数调整
在纯净的数据示例中,默认参数即可满足需求;但在实际生产环境中,Excel 表格往往包含多工作表、前置说明或冗余列。此时,最简步骤只需要在 pd.read_excel() 中附加以下三个关键参数之一:
1. 指定工作表:sheet_name
Excel 文件通常包含多个工作表(Sheet)。默认情况下,pandas 仅读取第 1 个工作表(索引为 0)。若需读取特定表,可直接传入表名字符串或数字索引:
# 按名称指定工作表
df = pd.read_excel("data.xlsx", sheet_name="销售数据")

# 按索引指定(0 代表第 1 个表,1 代表第 2 个表)
df = pd.read_excel("data.xlsx", sheet_name=1)

# 若传入 sheet_name=None,将一次性读取全部工作表,返回一个字典(key 为表名,value 为 DataFrame)
all_sheets = pd.read_excel("data.xlsx", sheet_name=None)
2. 跳过顶部说明或修正表头:header
许多业务报表的第一行往往是“XXX统计汇总表”等合并单元格,真实的字段名从第 2 行甚至第 3 行才开始。pandas 默认将第 1 行(索引 0)作为列名,若不调整就会导致列名错乱。
# 设置 header=1,表示以 Excel 的第 2 行作为列索引,自动忽略第 1 行的标题
df = pd.read_excel("data.xlsx", header=1)

# 若文件本身无表头,全部为纯数据行,设置 header=None,pandas 会自动生成 0, 1, 2... 数字列名
df = pd.read_excel("data.xlsx", header=None)
3. 筛选指定列区间:usecols
若工作簿包含几十列,而当前任务仅需其中几列,全量读取会浪费内存并拖慢运行速度。usecols 允许精准提取指定列:
# 按 Excel 列字母范围读取(只读取 A 列到 C 列)
df = pd.read_excel("data.xlsx", usecols="A:C")

# 或直接按真实列名列表读取
df = pd.read_excel("data.xlsx", usecols=["员工编号", "姓名", "部门"])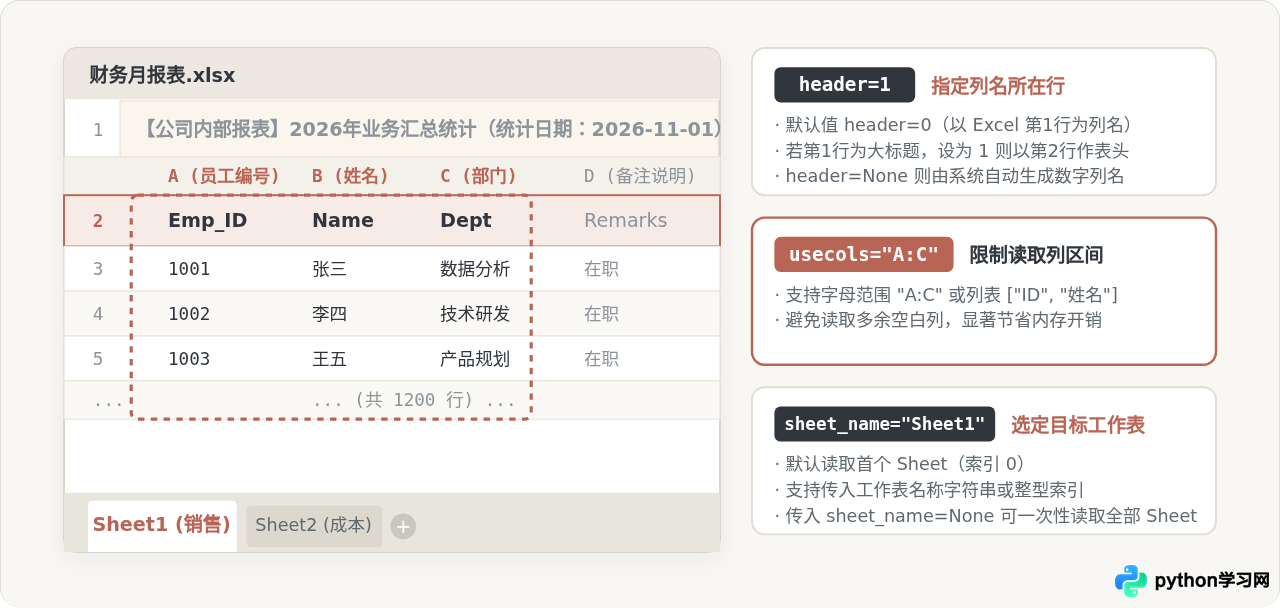
五、高频报错与精准排查清单
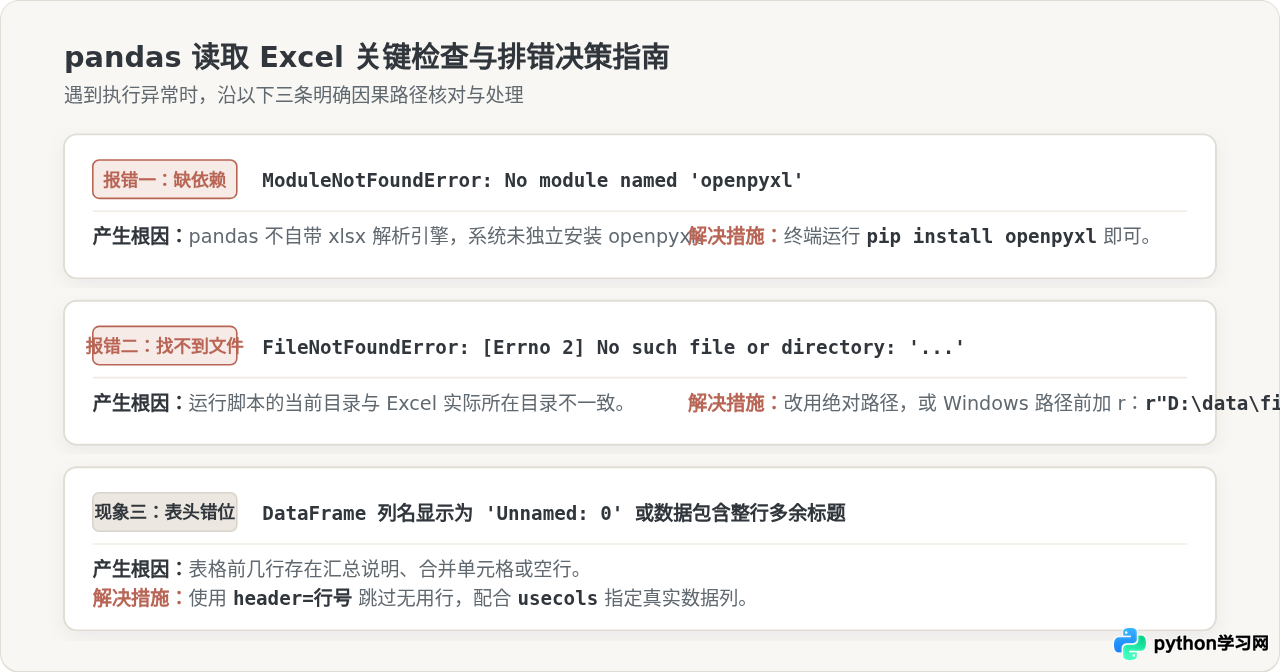
在执行上述极简步骤时,若出现异常中断,绝大多数情况下属于以下三类环境或路径配置问题。对照此清单可在数秒内定位修复:
原因:Python 虚拟环境或全局环境中缺少 openpyxl 库。许多读者在更换了 VS Code 或 PyCharm 解释器后,新环境中没有安装此依赖。
解决方法:确保在当前激活的 Python 环境终端下运行 pip install openpyxl。若在 Jupyter Notebook 中,可直接在代码块内运行 !pip install openpyxl。
原因:运行 Python 的工作目录(os.getcwd())并不在 data.xlsx 存放的文件夹中。
解决方法:
- 改用绝对路径传参,例如
pd.read_excel(r"C:\Users\Username\Documents\data.xlsx");在 Windows 路径前务必加上r前缀,避免反斜杠转义错误。 - 或者在代码开头借助
pathlib动态定位当前脚本文件所在目录:
from pathlib import Path; file_path = Path(__file__).parent / "data.xlsx"
原因:表格存在多行空标题、复杂合并单元格或右侧包含带格式的空列。
解决方法:用 Excel 打开原文件确认真实数据起始行,配置 header=行号 跳过空行;配合 usecols 限制只读取数据有效列。
六、总结
回顾 Python 使用 pandas 读取 Excel 的全流程,其极简本质可以凝练为两句话:
- 环境闭环:
pandas负责承载结构与数据运算,openpyxl负责底层格式解码,两者配合是解析现代.xlsx文件的标准基石。 - 代码闭环:只需
import pandas as pd与df = pd.read_excel('文件名.xlsx')两行核心语句即可将文件转化为 DataFrame。若遇到多表、表头偏移或冗余列,按需选用sheet_name、header和usecols即可精准控制。
掌握这一套最小闭环,即可快速推进后续的数据清洗、统计分析与自动化报表开发。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









