

Python中__init__与__new__的区别是什么
深入解析Python中__new__与__init__的核心区别、生命周期执行顺序、不可变类型继承、单例模式应用及避坑指南。
核心结论:在 Python 的面向对象机制中,__new__ 是构造方法(Constructor),负责在堆内存中开辟空间并返回对象实例;__init__ 是初始化方法(Initializer),负责在实例创建完成后为其配置属性与初始状态。日常开发中 99% 的场景只需重写 __init__;只有当需要继承不可变内置类型、实现单例模式或动态干预实例化过程时,才必须使用 __new__。
一、核心区别:从职责、参数到返回值的根本划分
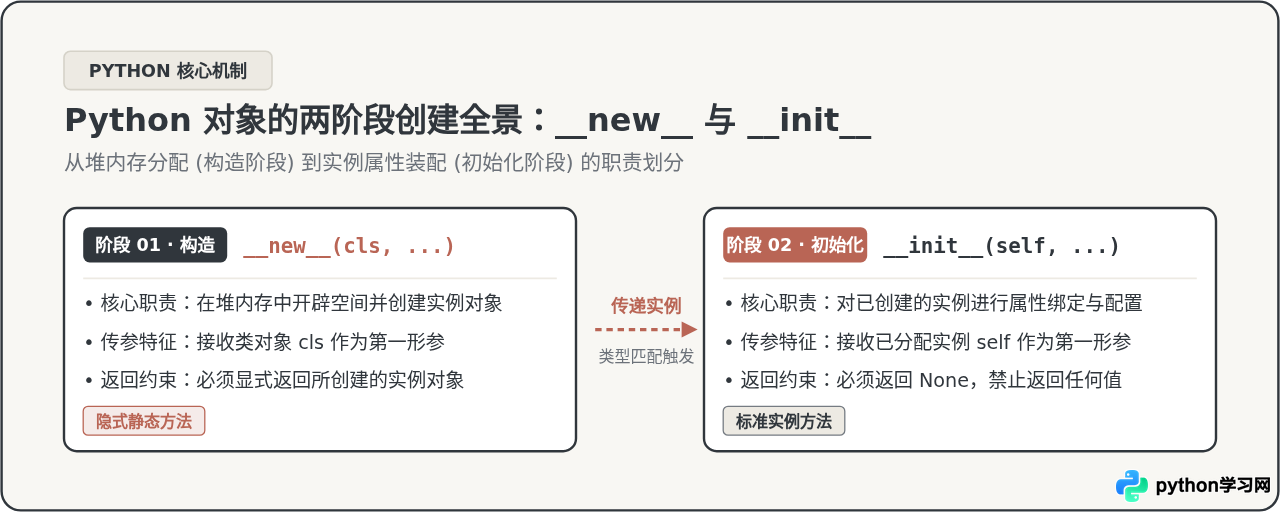
许多初次接触 Python 的开发者习惯性把 __init__ 称作“构造函数”,甚至误以为它是对象生命周期的起点。然而在 Python 内部,对象的创建是一个严格划分的两阶段过程(Two-phase Construction):先由 __new__ 创造实体,再由 __init__ 进行装配。
为了直观掌握两者的本质差异,我们可以从以下四个基本维度进行剖析:
- 方法属性与第一形参:
__new__在底层被作为静态方法处理(无须显式添加@staticmethod装饰器),它的第一个参数是类对象自身,通常命名为cls;而__init__是标准的实例方法,第一个参数是已经被创建出来的实例,通常命名为self。 - 职责定位:
__new__决定了“是否创建对象”以及“返回哪个对象”;__init__则只能面对一个“已存在的对象”,负责往对象的__dict__属性字典中添加业务字段。 - 返回值约束:
__new__必须显式返回一个实例对象(通常通过调用super().__new__(cls)获取);而__init__绝对不能返回任何值(只能返回None),如果尝试让__init__返回非空内容,Python 会直接抛出TypeError: __init__() should return None。 - 触发时序:当执行
obj = MyClass()时,解释器优先调用MyClass.__new__,只有当其返回的对象属于MyClass(或其子类)的实例时,解释器才会自动接着调用该对象的__init__。
二、执行流程:实例化背后的两阶段调用链
当我们写下 p = Person("张三", age=18) 这行日常代码时,Python 解释器底层究竟经历怎样的指令流转?很多人误以为解释器直接跳转到了 __init__,实际上它经历了一个严谨的分支判断机制。
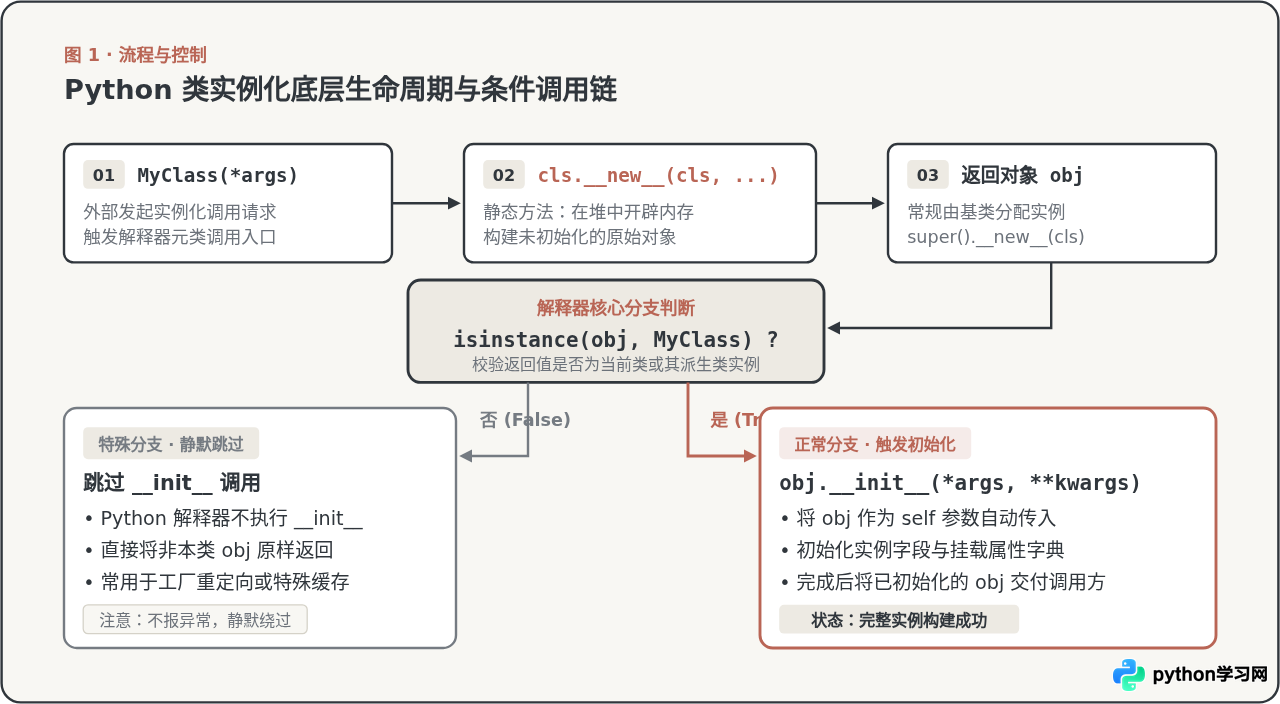
结合图 1 可以清晰看到完整的生命周期调度步骤:
- 入口触发:解释器捕获到类调用表达式
MyClass(*args, **kwargs),由元类(通常是type)的__call__方法接管执行流程。 - 分配内存:元类优先调用
MyClass.__new__(MyClass, *args, **kwargs)。在该方法内部,通常向操作系统申请堆内存并构建未加工的原始实例指针。 - 条件判定:
__new__执行完毕并返回对象引用obj。此时解释器内部执行类型断言:isinstance(obj, MyClass)。 - 分支分流:
- 条件成立(正常流程):解释器随即调用
obj.__init__(*args, **kwargs),并将obj作为首个参数self传递,执行属性赋值。 - 条件不成立(特殊重定向):若
__new__返回了其他类的实例(甚至是基础类型或None),解释器会完全静默跳过__init__的执行,直接将该对象原样交还给调用方。
- 条件成立(正常流程):解释器随即调用
三、运行验证:代码观察与内存状态流转
我们通过一段严谨且可运行的 Python 代码,同时重写 __new__ 和 __init__,打印关键执行节点以及对象的内存地址(id()),亲自见证这个传递过程:
class LifecycleDemo:
    def __new__(cls, *args, **kwargs):
        print(f"[步骤 1] 进入 __new__,接收类对象: {cls}")
        # 调用基类 object.__new__ 在堆上真正申请内存块
        instance = super().__new__(cls)
        print(f"[步骤 2] __new__ 完成内存开辟,实例地址: {hex(id(instance))}")
        print(f"[步骤 2 补充] 此时实例属性字典: {instance.__dict__}")
        return instance

    def __init__(self, name):
        print(f"[步骤 3] 进入 __init__,接收已创建实例: {hex(id(self))}")
        self.name = name
        print(f"[步骤 4] __init__ 属性赋值完成,当前属性字典: {self.__dict__}")

# 发起实例化调用
print("=== 开始创建对象 ===")
obj = LifecycleDemo("Python实战")
print(f"=== 实例化完成,最终外部持有: {hex(id(obj))} ===")
=== 开始创建对象 ===
[步骤 1] 进入 __new__,接收类对象: <class '__main__.LifecycleDemo'>
[步骤 2] __new__ 完成内存开辟,实例地址: 0x7fa89012a4c0
[步骤 2 补充] 此时实例属性字典: {}
[步骤 3] 进入 __init__,接收已创建实例: 0x7fa89012a4c0
[步骤 4] __init__ 属性赋值完成,当前属性字典: {'name': 'Python实战'}
=== 实例化完成,最终外部持有: 0x7fa89012a4c0 ===
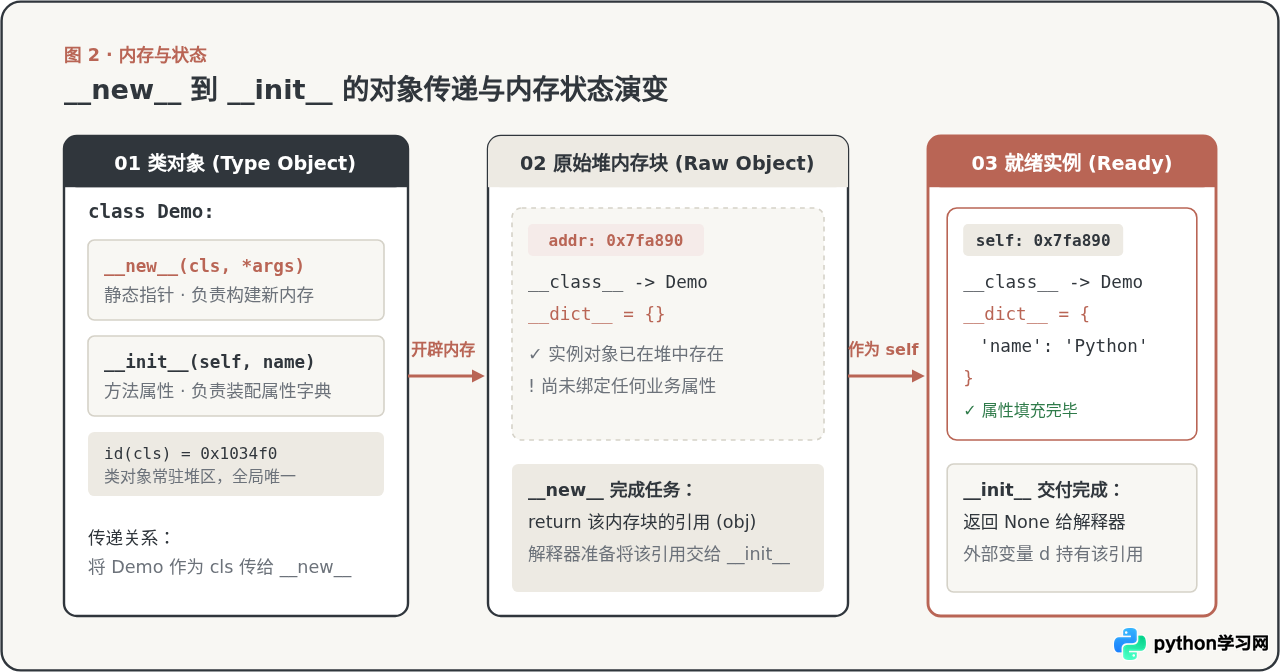
输出结果印证了两个关键事实:首先,[步骤 2] 中实例的内存地址(0x7fa89012a4c0)与 [步骤 3] 中 self 的地址以及最终输出的 obj 地址完全一致;其次,在 __new__ 刚返回时,实例的 __dict__ 是一个纯粹的空字典,直到 __init__ 执行完 self.name = name 后,属性才被真正注入。
四、选型指南:什么时候必须用 __new__?
在日常业务开发中,大部分开发者几乎从不重写 __new__,因为基类 object.__new__ 提供的默认内存分配行为已经能满足 99% 的面向对象建模需求。那么在什么特定场景下,我们必须主动重写 __new__?
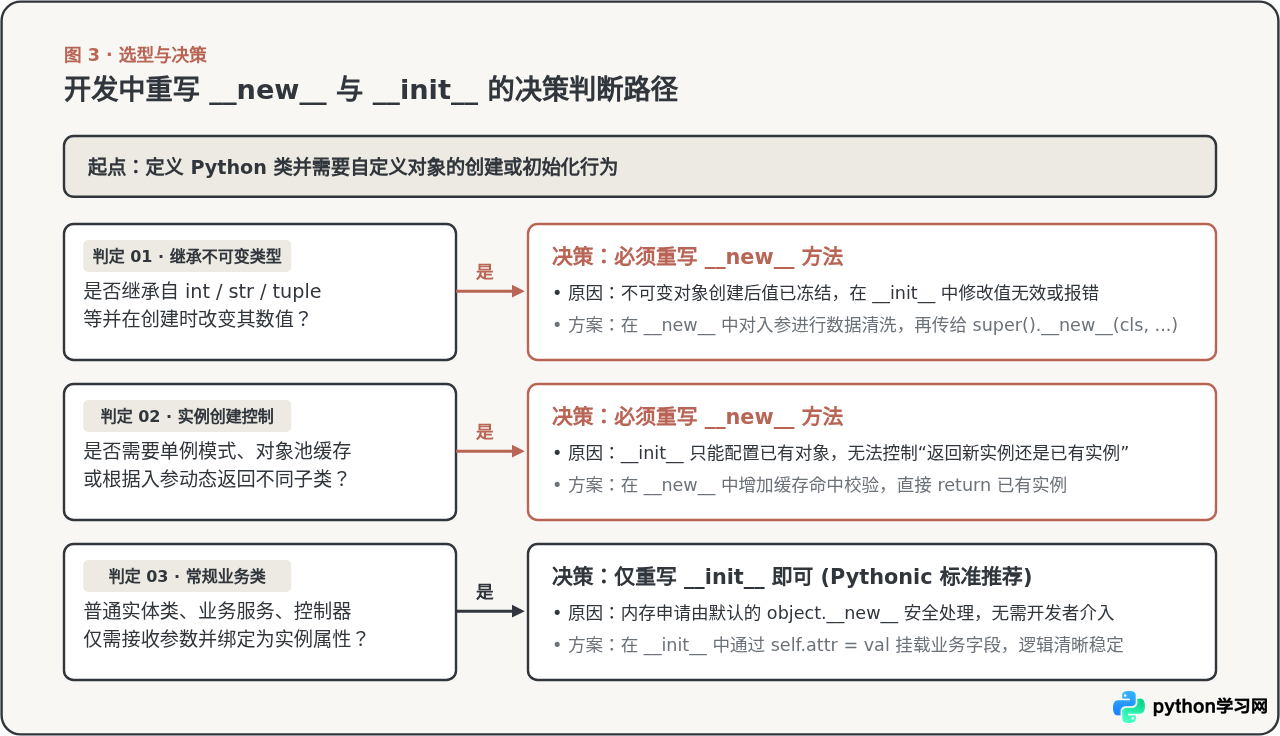
场景 1:继承不可变内置类型(Immutable Types)
不可变类型(例如 int、float、str、tuple、frozenset)的对象一旦在内存中生成,其值就不可更改。如果在子类的 __init__ 中试图去修改这个对象的值,为时已晚。
例如,我们要实现一个只能存放正整数的元组类 PositiveTuple:
class PositiveTuple(tuple):
    # 错误做法尝试:在 __init__ 中处理是完全无效的,因为 tuple 实例已经冻结
    def __new__(cls, iterable):
        # 1. 在实例创建前对数据进行前置过滤
        filtered = (x for x in iterable if isinstance(x, int) and x > 0)
        # 2. 将清洗后的数据交给父类的 __new__ 进行一次性构建
        return super().__new__(cls, filtered)

# 验证运行
pt = PositiveTuple([-5, 10, 0, 25, -8, 30])
print(pt)  # 示例输出: (10, 25, 30)
print(isinstance(pt, tuple))  # 示例输出: True
__new__ 一锤定音的。当代码执行到 __init__ 时,元组对象已经只读冻结,tuple 并没有暴露任何修改自身的接口。必须重写 __new__ 才能干预构建过程。
场景 2:实现单例模式(Singleton Pattern)与对象池缓存
单例模式的核心诉求是“无论外部调用多少次 DatabasePool(),全局都只存在唯一的实例”。__init__ 只能在已经分配好的实例上做初始化,根本无法拦截新内存的分配;而 __new__ 掌控着对象的返回权,能够实现实例复用:
class DatabasePool:
    _instance = None

    def __new__(cls, *args, **kwargs):
        # 若此前未创建过实例,则调用 super 构建;否则直接返回现有实例
        if cls._instance is None:
            cls._instance = super().__new__(cls)
        return cls._instance

    def __init__(self, host="localhost"):
        self.host = host

db1 = DatabasePool("192.168.1.10")
db2 = DatabasePool("192.168.1.20")

print(db1 is db2)  # 示例输出: True (两者指向同一内存地址)
五、常见陷阱与避坑指南
在涉及 __new__ 与 __init__ 的高级定制时,开发者容易踩入以下几个高频陷阱:
1. 单例模式中 __init__ 会被重复执行的隐患
在上面的单例代码中,虽然 db1 和 db2 内存地址相同,但因为 __new__ 返回的是本类实例,Python 每次调用 DatabasePool() 都会触发一次 __init__!这意味着第二次调用传的参数会覆盖掉第一次的属性。
解决方案:在 __init__ 中加入初始化完成标记:
def __init__(self, host="localhost"):
    # 避免单例被重复初始化
    if getattr(self, "_initialized", False):
        return
    self.host = host
    self._initialized = True
2. 调用 object.__new__ 时多传参数引发 TypeError
在 Python 3 中,内置的 object.__new__(cls) 只接受一个参数(即 cls)。如果在自定义类的 __new__ 中顺手把 *args, **kwargs 传给 super().__new__(cls, *args, **kwargs),且类没有定义其他继承基类,就会触发报错:
# 错误写法示例:
def __new__(cls, name, age):
    return super().__new__(cls, name, age)  # TypeError: object.__new__() takes exactly one argument (the type to instantiate)

# 正确做法:
def __new__(cls, name, age):
    return super().__new__(cls)  # 仅传递 cls 即可
3. 重写 __new__ 忘记写 return 导致对象为 None
初学者容易把 __new__ 当作普通方法,写了 super().__new__(cls) 却忘记在末尾 return。由于 Python 函数没有显式 return 时默认返回 None,会导致外部获取到的对象是 None,并且 __init__ 根本不会被调用。
六、全景对比与总结
为了便于速查与系统复习,我们将 __new__ 与 __init__ 的全部技术细节整理为对照矩阵:
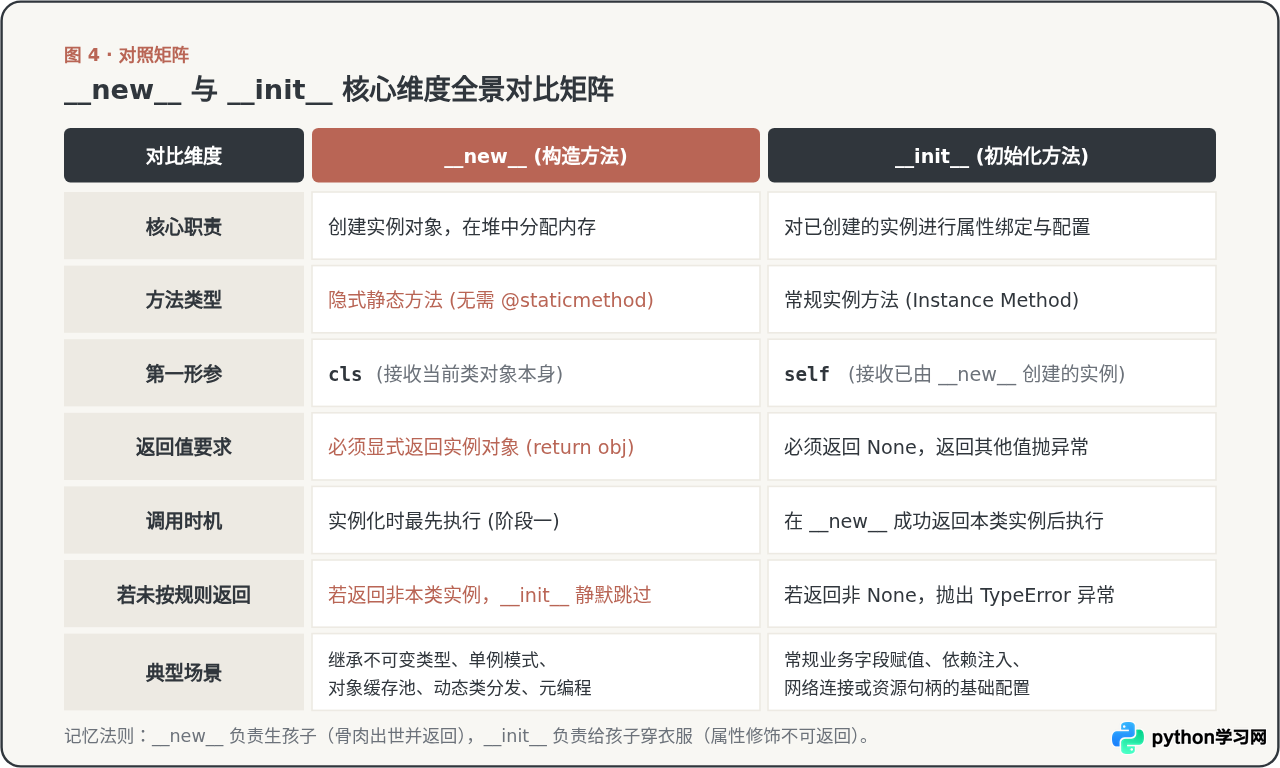
| 技术指标 | __new__(cls, *args, **kwargs) | __init__(self, *args, **kwargs) |
|---|---|---|
| 调用时机 | 两阶段中的第 1 阶段(对象创建前) | 两阶段中的第 2 阶段(对象创建后) |
| 本质角色 | 构造方法 (Constructor) | 初始化方法 (Initializer) |
| 方法类型 | 静态方法 (底层隐式 staticmethod) | 普通实例方法 (Instance Method) |
| 首个形参 | cls:当前类对象本身 |
self:已被创建出的实例引用 |
| 返回值规则 | 必须显式返回实例对象 | 必须返回 None(否则抛 TypeError) |
| 非本类实例后果 | 若返回非本类对象,跳过 __init__ |
不涉及(无权更换实例) |
| 常见应用场景 | 不可变类型继承、单例/缓存池、元编程 | 99% 的普通业务类属性设置与资源装配 |
一句话终极口诀:
__new__ 负责“从无到有生出来”(必须把实例交出来);
__init__ 负责“穿衣打扮配属性”(不可有任何返回值)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









