

Python没有头文件:怎么用import机制替代C/C++引用
深度解析Python在没有C/C++.h头文件的情况下,如何利用import模块导入机制、sys.modules字典缓存、__all__接口白名单及.pyi存根实现声明解耦、防重包含和命名空间隔离。
从 C/C++ 转向 Python 的开发者最常提出的疑问之一是:“没有了 .h 头文件,函数和类的声明该写在哪里?跨文件依赖该如何管理?”在 C/C++ 中,头文件承担了接口声明、类型定义与链接期符号导向的核心任务;而在 Python 中,代码直接定义在 .py 脚本内,并没有独立的声明阶段。Python 依靠运行时的 import 机制、内置字典缓存 sys.modules 以及命名空间映射,不仅完整覆盖了 C/C++ 头文件所提供的功能,还从根本上杜绝了重复文本展开与全局作用域污染。本文将系统拆解这两种引用模型的本质区别,并详解如何用现代 Python 模块机制替代头文件的各种工程场景。
一、底层模型质变:从“预处理文本展开”到“运行时对象执行”
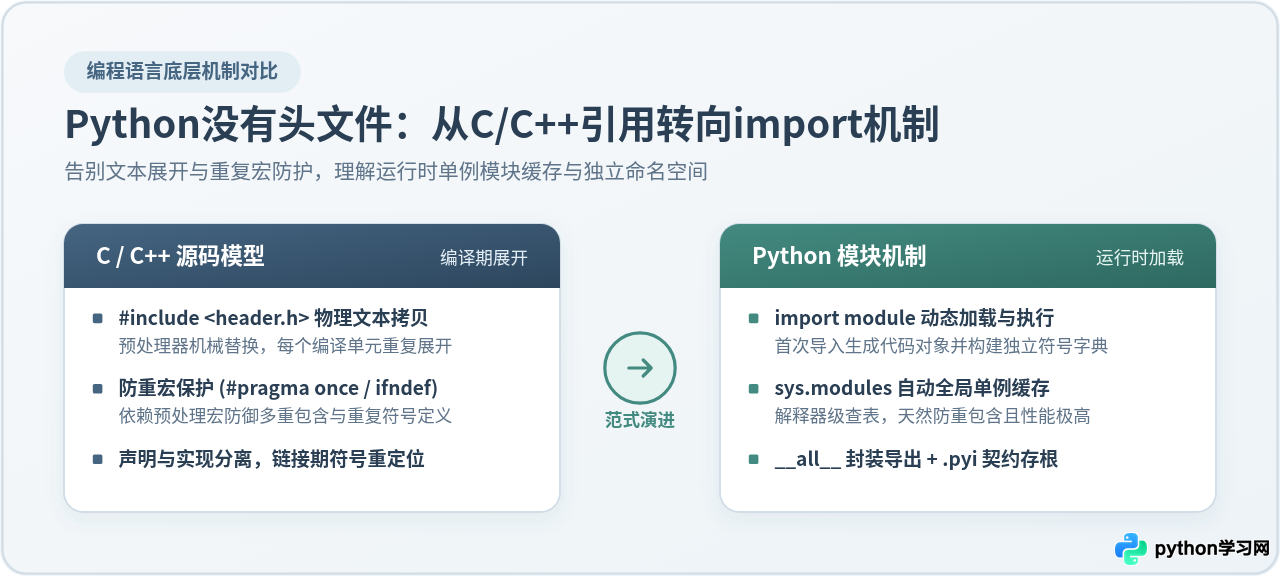
要熟练在 Python 中组织多模块代码,首先必须从心智模型上告别 C/C++ 的头文件思维。两者的本质差异并不只是语法上把 #include 换成了 import,而是整个程序构建体系的彻底重构。
在 C/C++ 中,#include <header.h> 是由预处理器(Preprocessor)在编译之前完成的纯文本替换。预处理器会打开目标头文件,将其源码原封不动地“粘贴”到当前文件的指令位置。这意味着:头文件本身不具备独立的运行时实体,如果在多个 .cpp 文件中都包含了同一个头文件,该头文件的代码会在每个编译单元中被机械展开一次,最终由链接器(Linker)去寻找各个目标文件(.o / .obj)中的函数地址完成拼接。
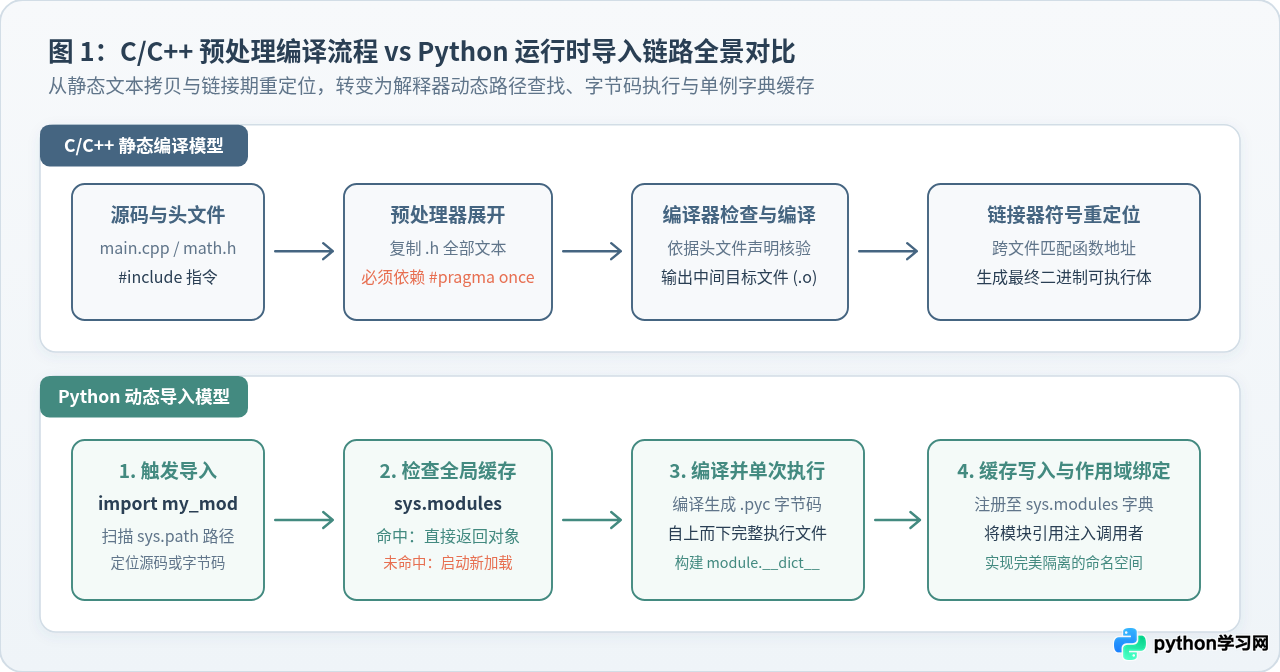
相反,Python 的 import 是一个真正的运行时表达式(Runtime Statement)。当解释器执行到 import my_module 时,它执行的是一套完整的动态搜索与执行流程:
- 路径搜索(Path Lookup):解释器在
sys.path包含的目录列表中寻找名为my_module.py的文件或包目录。 - 编译与初次执行(Execution):如果尚未加载,解释器为该文件创建一个独立的模块对象,并自上而下完整执行文件内的所有全局语句,把执行过程中生成的所有函数、类和变量存入该模块专有的属性字典
module.__dict__。 - 单例缓存注入(Caching):将该模块对象登记到全局唯一的
sys.modules字典中。 - 命名空间符号绑定(Binding):在当前调用方所在的作用域中,创建一个名为
my_module的局部变量,指向刚刚加载的模块对象。
这种机制直接带来了三个关键认知转变:
- 模块是第一类对象(First-Class Object):在 Python 中,每个模块都是内存中的独立单例实例。你可以在运行时动态查询模块的属性、打印其内存地址,甚至动态向模块注入属性。
- 定义即执行:Python 中没有“纯声明”的概念。写下
def add(a, b):并不是在向编译器报备函数签名,而是在执行一条“创建函数对象并赋值给符号 add”的运行时指令。 - 天然的命名空间隔离:C 语言中如果不加
static,头文件中展开的符号很容易产生全局命名冲突;而 Python 默认必须通过module_name.function_name()访问,不会无声污染调用方作用域。
二、C/C++ 头文件典型场景在 Python 中的精确替代方案
在实际工程开发中,C/C++ 头文件主要承担了四个核心职责:防止头文件重复包含、接口与实现分离、控制符号对外可见性,以及跨模块共享全局配置。下面逐一分析 Python 中的标准替代做法。
1. 替代头文件防重宏:内置的 sys.modules 全局单例机制
在 C/C++ 中,如果头文件被间接包含多次,会导致结构体或类型的重复定义,因此必须在每一个头文件开头手写防重保护(Header Guards)或依赖非标准的 #pragma once:
#ifndef MY_TOOLKIT_H
#define MY_TOOLKIT_H

// 接口声明代码...
void init_system();

#endif // MY_TOOLKIT_H
而在 Python 中,开发者完全不需要编写任何防重包含代码。Python 解释器在内部维护了一个名为 sys.modules 的全局字典,记录了所有已成功导入的模块映射。
import sys

# 第一次导入:解释器执行 math 模块初始化逻辑,并存入 sys.modules
import math
print("math 是否已在全局缓存:", "math" in sys.modules)  # 输出: True

# 记录此时 math 对象的内存地址
math_addr_1 = id(math)

# 在其他代码位置或文件中再次导入
import math
math_addr_2 = id(math)

# 两者指向完全相同的同一个模块对象,模块顶层代码绝不会重复执行
print("两次导入是否为同一单例:", math_addr_1 == math_addr_2) # 输出: Truesys.modules 的单例缓存特性,位于 .py 文件顶层的可执行代码(如打印日志、连接数据库、分配全局资源)只会在整个进程生命周期中执行且仅执行一次。后续的任何 import 均是直接从字典中取出已存在的模块对象。
2. 替代声明与实现分离:类型存根(.pyi)与静态类型提示
C/C++ 之所以推崇声明与实现分离,很大程度上是为了两点:一是加速编译(调用者只需要读取包含签名的 .h,不需要看实现),二是作为代码对外契约文档。
在现代 Python(Python 3.7+)中,你同样可以实现严格的“声明与实现物理分离”,官方标准方案为 类型存根文件(Stub Files,扩展名为 .pyi) 与 typing.Protocol。
以高性能数据计算模块为例,我们可以把底层繁重或复杂的实现留在 calculator.py 中,同时在同级目录下提供一个纯声明性质的 calculator.pyi:
# calculator.pyi:纯接口契约声明,不包含具体函数体
from typing import List, Optional

class MatrixProcessor:
    dimension: int
    def __init__(self, dimension: int) -> None: ...
    def compute_determinant(self, matrix: List[List[float]]) -> float: ...
def invert(self, matrix: List[List[float]]) -> Optional[List[List[float]]]: ...# calculator.py:真实业务实现
class MatrixProcessor:
def __init__(self, dimension: int):
self.dimension = dimension
def compute_determinant(self, matrix):
# 具体的高斯消元或底层 C-API 调用
return 1.0
def invert(self, matrix):
# 具体的矩阵求逆算法
return matrix
当其他开发者在 IDE 中调用 MatrixProcessor 时,IDE(如 VS Code、PyCharm)和静态检查工具(如 Mypy、Pyright)会自动优先解析 .pyi 存根,精准提供参数补全与类型诊断,而解释器在运行时依然加载 .py 执行逻辑。这种模式也是标准库和 NumPy 等知名第三方库包装底层 C/C++ 拓展的标准方案。
3. 替代符号可见性控制:模块 __all__ 白名单机制
在 C/C++ 中,头文件中写出来的符号是对外公开的,没有写在头文件里的内部辅助函数(通常使用 static 限制在当前源文件)则是外部不可见的。
Python 没有 private 编译关键字,但通过两个核心惯例实现了完全等价的导出控制:
- 下划线前缀惯例(
_symbol):任何以单个下划线开头的函数、类或变量均被约定为内部私有实现。当外部尝试使用通配符导入时,这些符号会被自动过滤。 __all__显式白名单:在模块顶层定义字符串列表__all__ = ["SymbolA", "SymbolB"]。这相当于向外界明确声明:“本模块对外正式暴露的公共 API 仅限列表中的符号,其余所有符号均属于私有内部实现”。
三、循环引用(Circular Import)的根源与实战化解法
许多刚从 C/C++ 转过来的工程师在编写大型 Python 项目时,最容易遇到的报错就是循环导入:
ImportError: cannot import name 'OrderManager' from partially initialized module 'order_system' (most likely due to a circular import)
在 C/C++ 中,解决两个类相互引用的标准工具是前向声明(Forward Declaration)。例如在 Order.h 中写 class Customer;,只要头文件里只使用指针或引用,编译器就能知道指针大小,从而顺利通过编译,具体调用留到 .cpp 中再引入头文件。
但在 Python 中,当写下 from module_b import ClassB 时,解释器要求立刻在 module_b 的命名空间字典中找到 ClassB 键。如果此时 module_b 也正在反向导入当前模块,它就会遇到尚未执行到定义处的“半初始化模块(partially initialized module)”,从而抛出异常。
解决 Python 循环引用的工程化排查与处理流程如下:
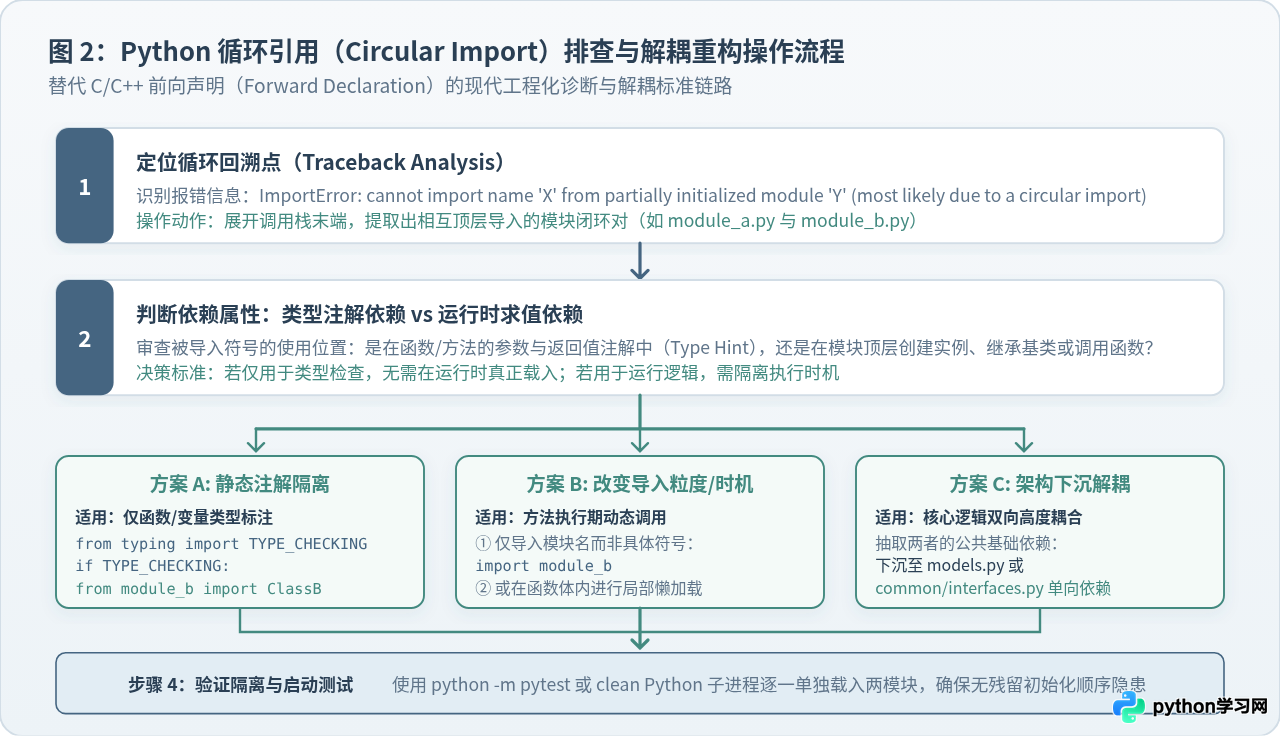
排查与解决循环引用的三种标准范式:
范式一:使用 typing.TYPE_CHECKING 解决类型注解循环(最推荐)
这是对标 C/C++ 前向声明最完美的方案。绝大多数循环导入往往仅发生于类型标注场景(例如订单类需要标注属于哪个客户,客户类需要标注关联的订单列表)。
通过 Python 3.7 引入的 from __future__ import annotations,配合 typing.TYPE_CHECKING 常量,该导入仅在静态类型分析阶段生效,在实际代码运行期间直接被解释器忽略,运行时开销彻底归零:
from __future__ import annotations
from typing import TYPE_CHECKING

# TYPE_CHECKING 在运行时恒为 False,仅在 Mypy/IDE 静态分析时为 True
if TYPE_CHECKING:
    from customer import Customer  # 运行时根本不执行此语句,消除循环依赖

class Order:
    def __init__(self, order_id: str, owner: Customer):
        self.order_id = order_id
        self.owner = owner  # 静态检查器能识别 owner 的类型,运行时毫无阻碍
范式二:改为导入“模块对象”而非“具体符号”
避免使用 from a import func,改用 import a,并在调用处使用 a.func()。
原因:import a 只需要在当前作用域绑定一个模块对象指针;当随后两模块都完成各自的顶层加载后,在实际执行方法时,模块 a 的字典里早已填满了所有符号,因此通过 a.func() 查找符号永远不会报错。
范式三:函数内局部延迟导入(Lazy Import)
如果相互依赖只出现在某个具体的方法或函数调用中,直接将 import 语句移入该函数内部:
class PaymentGateway:
    def process_refund(self, refund_id: str):
        # 延迟到执行具体退款方法时才加载,避开模块初始化期间的死锁
        from audit_logger import write_audit_log
        write_audit_log(refund_id)
四、工程实战:打造类似 C/C++ SDK 的高质量 Python 模块架构
在 C/C++ 开发大型软件库时,标准做法是提供一个 include/ 目录存放对外公开的公共头文件,将真正的实现文件全部藏在 src/ 目录下。在 Python 中,我们同样可以通过包(Package)的结构化组织实现这一设计模式。
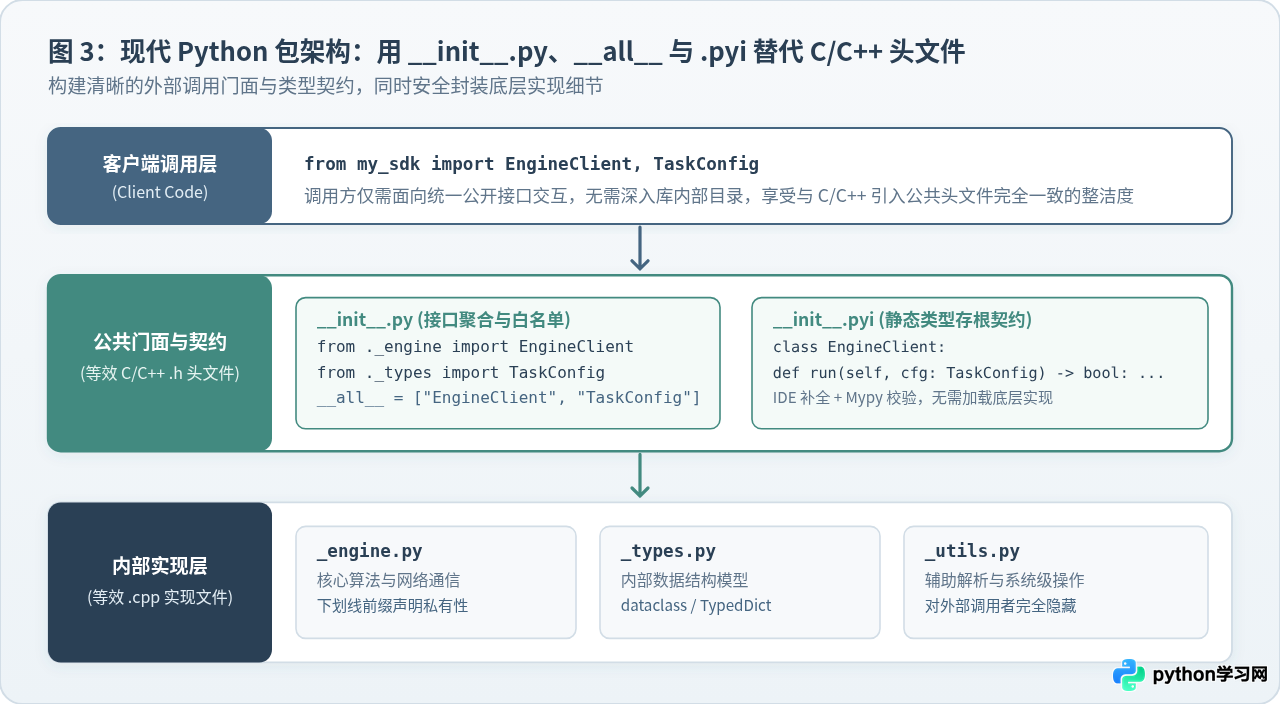
标准目录结构示范
my_sdk/
├── __init__.py         # 统一对外导出的入口门面(等效 public header)
├── __init__.pyi        # 门面类型契约存根
├── py.typed            # 声明本包支持 PEP 561 静态类型检查
├── _core.py            # 内部业务核心逻辑(私有,不对外宣称)
├── _network.py         # 内部网络协议实现(私有)
└── _utils.py           # 内部底层工具(私有)
代码落地示范
在核心实现 _core.py 中编写业务代码:
class EngineClient:
    def __init__(self, endpoint: str):
        self.endpoint = endpoint

    def execute_task(self, task_name: str) -> bool:
        print(f"Executing {task_name} on {self.endpoint}")
        return True

def _internal_secret_helper():
    # 纯内部辅助逻辑
    pass
在入口 __init__.py 中统一收拢并定义导出契约:
# 从内部模块导入需要公开的对象
from ._core import EngineClient

# 显式白名单:明确本 SDK 对外只暴露 EngineClient
# 未被列入 __all__ 的符号将不会出现在文档与 IDE 顶层提示中
__all__ = ["EngineClient"]

__version__ = "1.0.0"
外部使用者在调用时,代码极为纯粹:
from my_sdk import EngineClient

client = EngineClient(endpoint="https://api.internal.local")
client.execute_task("sync_dataset")
使用者不需要知道模块内部被拆分成了 _core.py 还是 _network.py,内部文件未来做重构或拆分也不会破坏调用方的导入语法。这与 C/C++ 库通过一个 #include <mysdk/mysdk.h> 隐藏底层 .cpp 实现的设计思想完全不谋而合。
五、机制全景对照与避坑指南
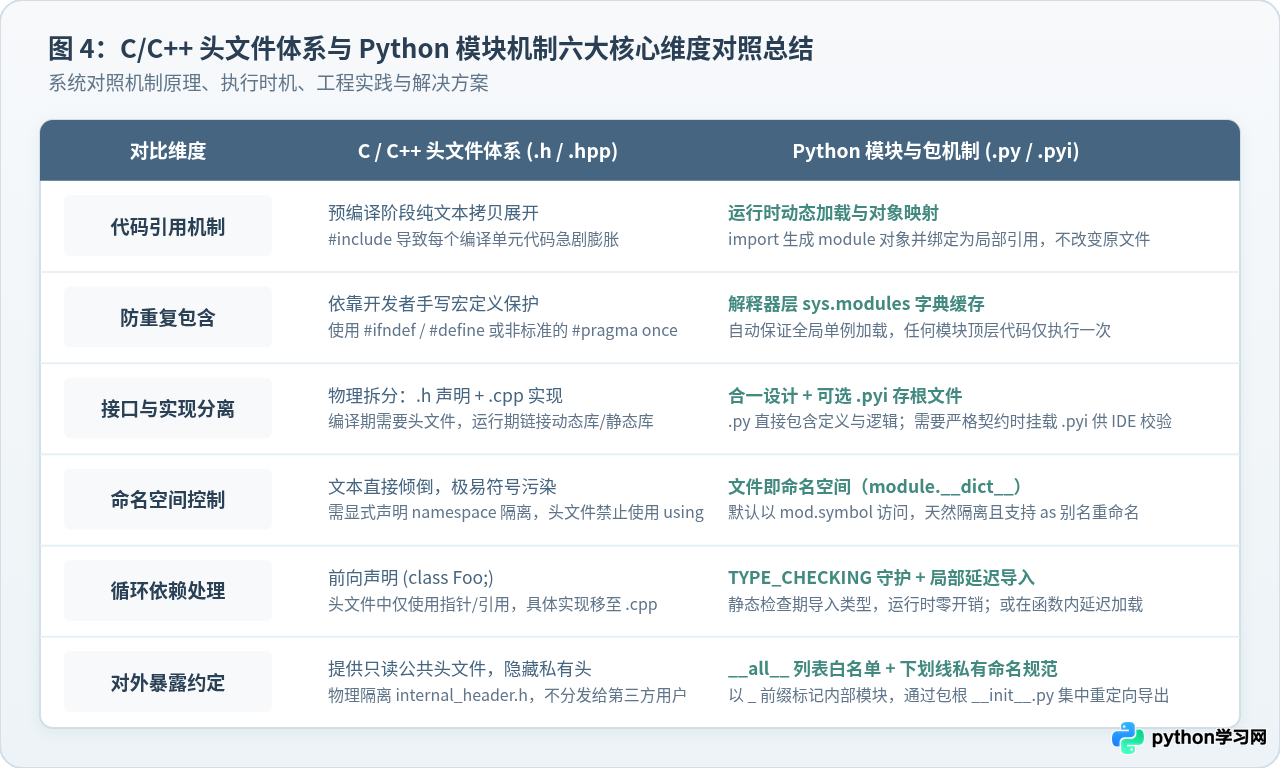
在日常开发与迁移中,开发者需要格外警惕以下三个常见陷阱:
from module import *(通配符导入)using namespace std;,因为这会把上千个符号倾倒进当前文件,导致极难排查的命名冲突。同理,Python 中的 from module import * 会将目标模块中未加下划线的全部符号导入当前作用域,不仅大幅降低静态检查工具的识别精度,还极易无声覆盖本地同名变量。必须坚持精准导入(如 from math import sqrt)或模块命名空间访问(如 import math; math.sqrt())。
import 时都会被解释器同步执行。如果一个模块顶层写了耗时很长的网络请求、重量级数据库建连,或者没有放置在 if __name__ == '__main__': 守卫中的脚本代码,任何其他文件只要 import 它,都会导致主程序被无故卡顿或产生意外副作用。
-I /path/to/include 严格指定头文件搜索根目录。Python 则依据 sys.path(包含执行入口所在目录及环境变量 PYTHONPATH)。在复杂的项目子包中,滥用跨多层的相对导入(如 from ...utils import helper)会导致模块一旦被直接独立运行就会抛出 attempted relative import with no known parent package。始终建议以项目根目录为基准使用绝对导入(Absolute Import),并通过 python -m my_package.submodule 方式启动模块。
六、核心认知转变总结
回顾 C/C++ 与 Python 的设计哲学差异,我们可以得出清晰的替代公式:
- C/C++ 的
#include是“编译前期的文本粘贴”,依赖宏保护防重,靠链接器定位地址; - Python 的
import是“运行期的动态模块求值”,依赖sys.modules实现自动防重,以一等公民的模块对象与字典属性组织作用域; - C/C++ 依靠
.h与.cpp的物理拆分声明契约,而 Python 则以__init__.py统一聚合公共门面,以__all__白名单界定暴露边界,以.pyi存根承接严谨的静态类型校验。
掌握了这套对应关系,开发者无需再为“找不到头文件”感到困惑,不仅能够写出层次清晰、解耦得当的模块化项目,更能彻底避免循环引用等常见陷阱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









