

Python字符串切片取后几位:负索引语法详解
在Python中获取字符串末尾的几个字符,最直接、规范且高效的写法是使用切片语法 s[-n:]。例如,要提取字符串末尾的4个字符,只需执行 s[-4:]。这一简洁语法的核心在于Python原生支持的“负索引机制”以及切片省略终点时的“默认边界规则”。本文将系统解析负索引的工作原理、切片区间的设计逻辑、边界与异常处理,帮助读者彻底掌握这一高频技巧。
一、核心语法与基础推导:正负双向索引体系
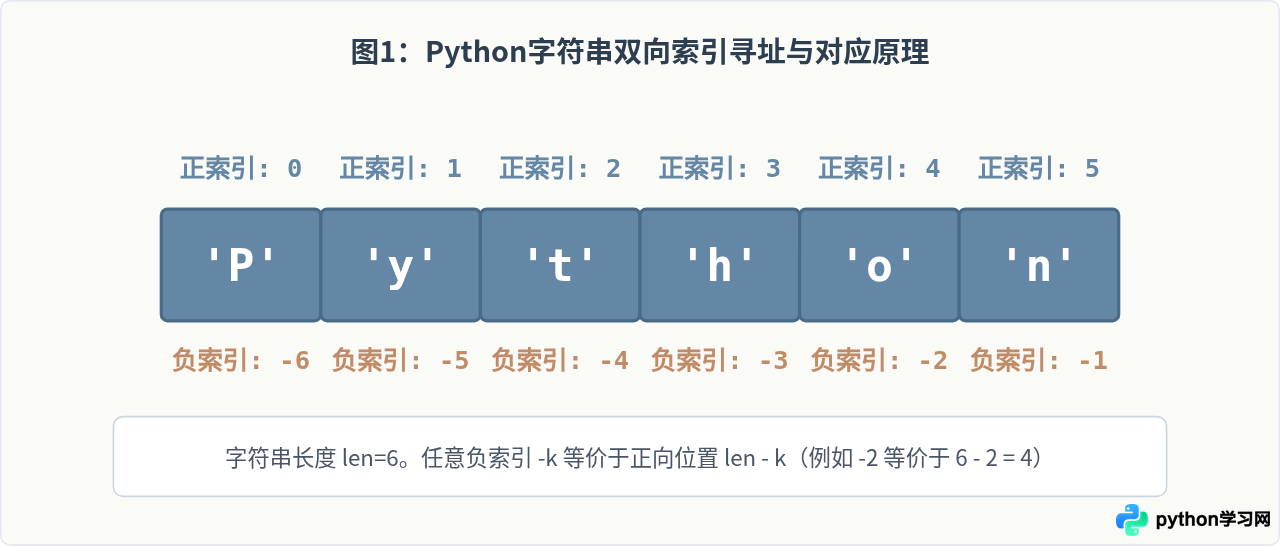
在深入切片语法之前,必须先理解Python序列的索引定位方式。Python为序列中的每一个元素提供了两套并行的索引标号:
- 正向索引(从前向后):起始于
0,逐位递增至len(s) - 1。 - 反向索引(从后向前):末尾最后一个字符标号为
-1,倒数第二位为-2,依此类推,最首位字符的反向标号即为-len(s)。
正负索引之间存在严格的数学等价关系:对于任意合法负索引 -k,它所定位的实际元素位置完全等同于正向索引 len(s) - k。Python解释器在底层解析负索引时,本质上就是将其与序列长度相加来进行绝对地址寻址的。
二、切片基础结构与取后几位的标准写法
Python切片的标准完整语法为:
sequence[start:stop:step]在常规提取连续子串时,步长 step 默认为 1,因此通常简化为 sequence[start:stop]。切片始终遵循左闭右开区间(即 [start, stop))原则:提取结果包含 start 所在位置的字符,但不包含 stop 所在位置的字符。
1. 标准写法:s[-n:]
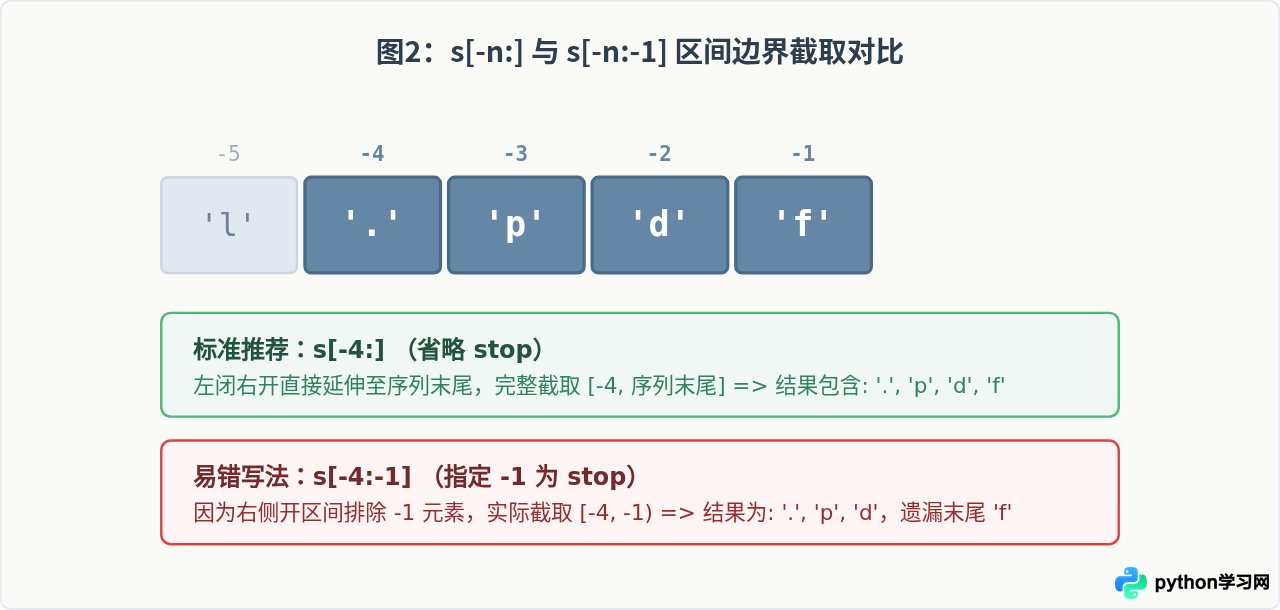
当需要从字符串末尾提取最后 n 个字符时,起始位置应当是倒数第 n 个字符,即 start = -n。而末尾字符是最后一个元素,如果我们在 stop 处填写任何负索引,都会因为左闭右开规则而无法包含最后一个字符(例如填写 -1 会排除掉末尾字符)。
Python设计了省略机制:当省略 stop(即写作 s[-n:])时,切片的终止位置自动延伸到序列的绝对物理末尾,完整包含最后一个字符。
# 示例代码:提取后几位字符
text = "report_2026_final.pdf"

# 提取最后 3 个字符(扩展名)
ext = text[-3:]
print(f"末尾3位: {ext}")
# 示例输出:末尾3位: pdf

# 提取最后 4 个字符(包含点号)
ext_full = text[-4:]
print(f"末尾4位: {ext_full}")
# 示例输出:末尾4位: .pdf
2. 为什么不能写 s[-n:-1]?
初学者容易犯的一个典型错误是写成 s[-n:-1]。根据左闭右开区间规则:
start = -4对应倒数第4个字符。stop = -1对应倒数第1个字符,但根据区间规则,stop本身被排除在外。
因此,text[-4:-1] 实际只截取了倒数第4、倒数第3、倒数第2这三个字符,漏掉了原本期望获取的末尾字符。要包含最后一个字符,必须将冒号右侧留空或省略。
三、实操推导:从负索引到切片截取的执行四步法
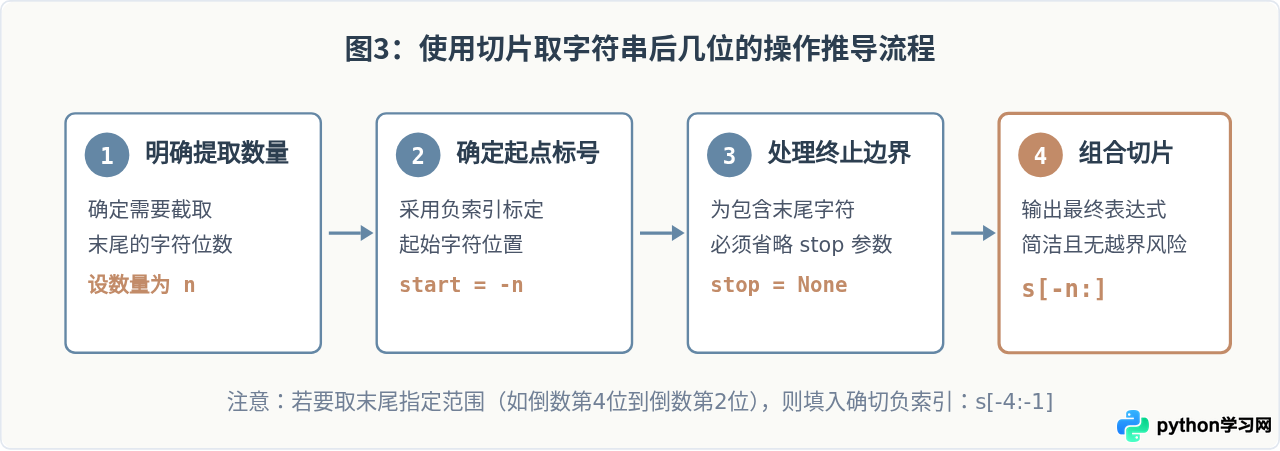
在实际编写业务逻辑或处理字符串解析时,可按照以下推导步骤确定切片代码:
四、进阶特性:越界容错机制与扩展切片
1. 切片的越界安全性(Graceful Bound Handling)
在Python中,直接通过单索引访问元素(如 s[i])时,如果索引超出有效范围,解释器会立即抛出 IndexError: string index out of range。然而,切片操作具有高度的容错性:
- 如果提取的长度
n超过了字符串本身的实际长度(即n > len(s)),切片不会报错,而是自动将起始点截断到字符串开头(索引0),安全地返回原字符串的完整浅拷贝。 - 如果原字符串是空字符串
"",切片s[-n:]同样不会报错,而是安全返回空字符串""。
# 示例代码:越界安全性演示
short_str = "Hi"

# 尝试获取后5位,远超实际长度2
result = short_str[-5:]
print(f"超长切片结果: '{result}' (长度: {len(result)})")
# 示例输出:超长切片结果: 'Hi' (长度: 2)

empty_str = ""
print(f"空串切片结果: '{empty_str[-3:]}'")
# 示例输出:空串切片结果: ''
2. 倒序提取:反向步长 step = -1
如果业务需求不仅需要后几位字符,还要求按从后向前的顺序逆序排列,可以引入第三个参数——负步长 step = -1。
当步长为负数时,切片扫描方向发生反转(从右往左):
token = "ABCDEFGH"

# 提取最后4位并逆序输出
# 倒数第1位开始,向左跨步到倒数第5位(左闭右开排除-5)
reversed_last4 = token[:-5:-1]
print(f"末尾4位倒序: {reversed_last4}")
# 示例输出:末尾4位倒序: HGFE

# 整个字符串翻转的标准写法
full_reversed = token[::-1]
print(f"完整翻转: {full_reversed}")
# 示例输出:完整翻转: HGFEDCBA
五、知识结构总结与场景速查
为了让读者在实际编码中能够快速选型与排查问题,下表与结构图汇总了切片取末尾字符的常见模式及适用场景:
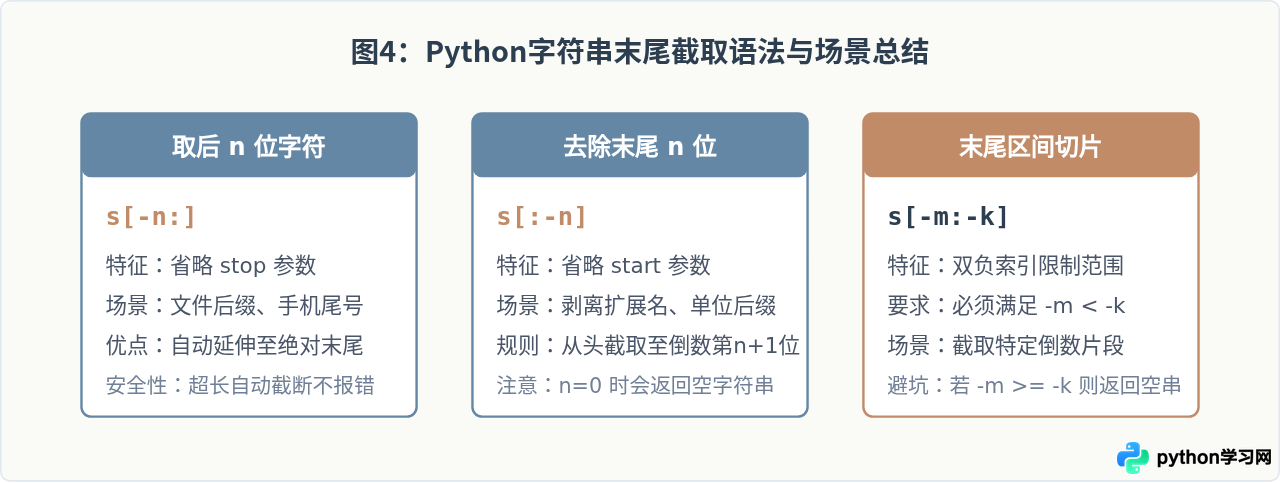
1. 取后几位的黄金公式是 s[-n:],核心在于省略右侧边界以包含序列最后一个元素。
2. 切片天生具备越界容错性,无需在截取前手动对比 len(s) >= n,代码更简洁健壮。
3. 若需要排除末尾字符则写为 s[:-n];切片区间始终严格维持“包含起点、排除终点”的左闭右开准则。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









