

怎么利用Python print的file参数将结果保存到文件
详细讲解如何利用Python print函数的file参数将控制台输出结果保存到文件。包含标准语法步骤、底层数据流原理解析、与f.write的深入对比、flush即时刷新及常见避坑指南。
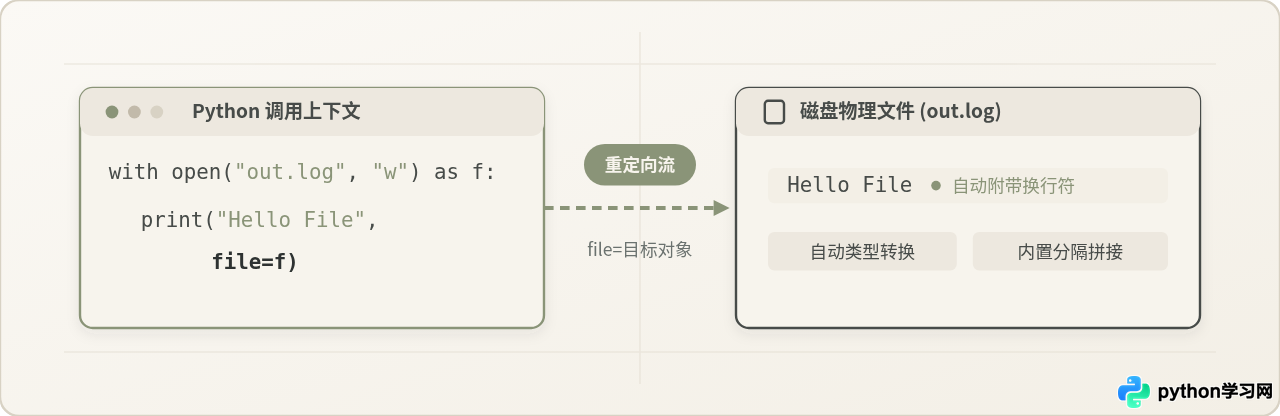
print() 函数默认将文字输出到终端控制台。若想把结果直接存入磁盘文件,最简洁直观的方法就是给它传入 file 参数。只需配合 open() 打开的文件句柄,例如 print("数据结果", file=f),即可自动完成字符串格式化并写入文件,无需手动对非字符对象做类型转换或额外添加换行符。
一、标准操作步骤:三步实现输出持久化
利用 print() 的 file 参数写文件,推荐采用基于 with open(...) 上下文管理器的标准模式。这种写法不仅语法清晰,而且能够确保即使程序遭遇异常退出,文件句柄也会被自动刷新并关闭,有效避免内容因滞留缓冲区而丢失。
1. 覆盖写入模式('w' 模式)
当需要从头创建文件或清空旧数据覆盖写入时,将打开模式设置为 'w'(write)。并且请始终养成显式声明 encoding='utf-8' 的习惯,以杜绝 Windows 与 Linux 等系统由于默认代码页不同造成的乱码问题。
# 示例一:覆盖写入新文件并输出多样化数据
with open("report.txt", mode="w", encoding="utf-8") as f:
    print("===== 任务执行报告 =====", file=f)
    print("执行状态:", "SUCCESS", "耗时:", 12.5, "秒", file=f)
    print("处理指标:", {"total": 1000, "passed": 998}, file=f)
2. 追加写入模式('a' 模式)
如果当前任务是持续记录操作日志、循环产生的数据指标,则应当采用 'a'(append)模式打开文件。新输出的行会被连续追加到文件末尾,保留此前已有内容。
# 示例二:在已有日志末尾追加记录
with open("server_events.log", mode="a", encoding="utf-8") as log_file:
    print("[2026-11-01 10:00:01]", "心跳检测正常", file=log_file)
    print("[2026-11-01 10:01:05]", "接收到同步请求", file=log_file)
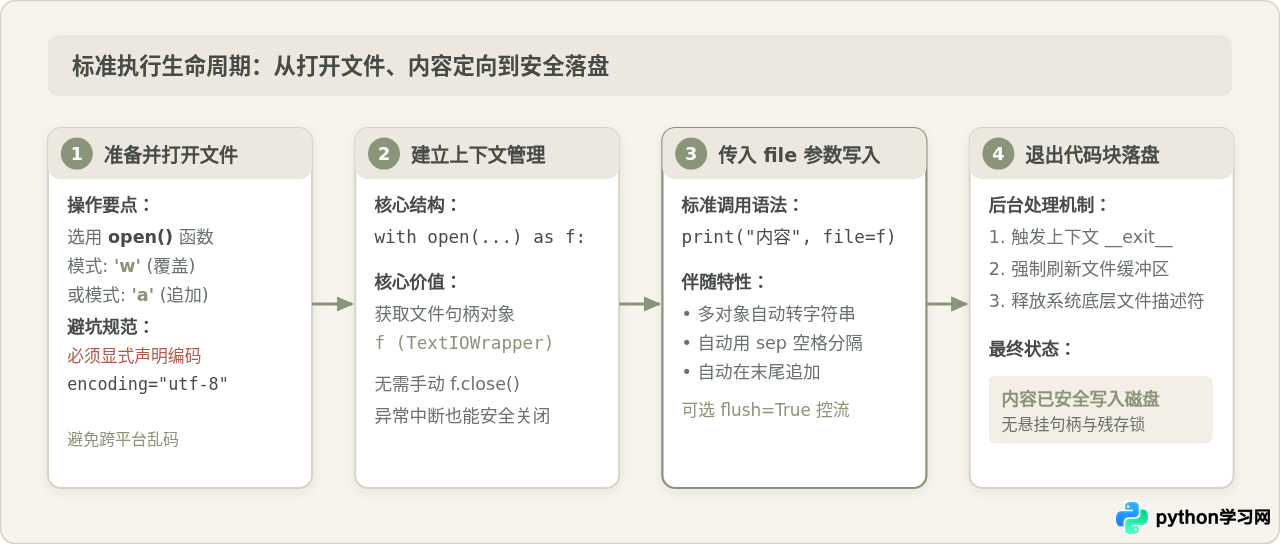
从上述步骤流程可以看出,利用上下文管理器结合 file=f,整个打开、格式化写入以及安全闭合文件描述符的流程是严丝合缝的,不需要手动调用 f.close()。
二、底层原理解析:数据流是如何转向文件的
为了更深刻地理解 file 参数的作用,我们需要了解 print() 函数的原生签名及其内部流水线机制:
print(*objects, sep=' ', end='
', file=None, flush=False)在底层实现中,print() 的数据分流过程包含以下四个关键环节:
- 序列化转换:
print()接收任意数量的入参(*objects),并在内部对每一个非字符串对象调用内置的str(obj)方法将其转换成文本表示。 - 多值拼接:使用
sep参数指定的字符串(默认为空格)将多个文本串联为一个整体。 - 附加结束符:在串联字符串的尾部自动拼接
end参数(默认为换行符 - 路由与写入:检查
file参数。如果file is None(默认状态),Python 会将目标指向sys.stdout(控制台标准输出);如果显式传入了文件对象,则将其直接转发给该对象的.write()接口。
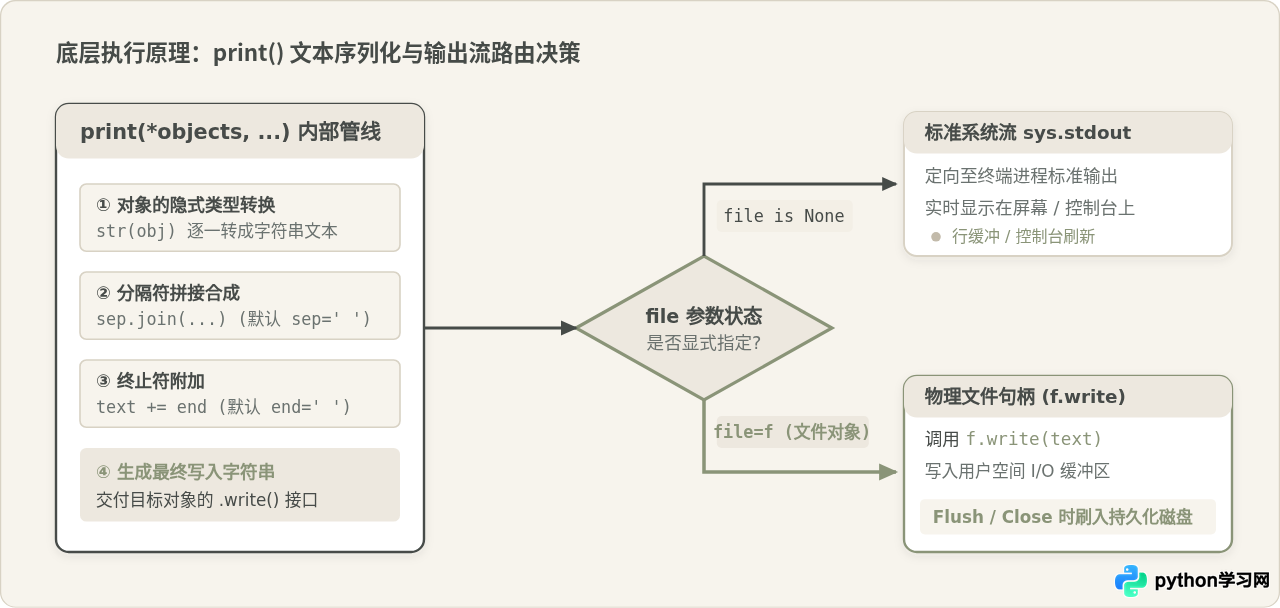
由此可见,print(..., file=f) 本质上是 Python 为开发者提供的一套“格式化前置处理器”,它在将数据派发给底层文件对象的 write() 方法前,自动帮我们处理好了对象序列化、间隔分隔与换行包装。
三、常见认知误区与深度辨析
误区一:“给 file 参数传文件路径字符串就行”
不少初次接触该参数的开发者常写出类似 print("hello", file="output.txt") 的代码。这种看似合理的设想会直接引发报错:
# 错误写法示例:
print("hello", file="output.txt")

# 实际报错信息:
# AttributeError: 'str' object has no attribute 'write'
原因辨析:file 参数期望接收的是一个具有 write(str) 方法的“类文件对象”(File-like Object),而不是一个表示路径的字符串。字符串类型本身并不具备 I/O 写入能力。因此,必须先通过 open() 返回文件句柄,再将该句柄传给 file。
误区二:“print(..., file=f) 和 f.write(...) 完全一样”
有人认为“既然 print 底层也是调用 write,那两者完全没有差别”。这种说法在底层归宿上成立(最终都是写文件),但在编码体验、适用场景和数据处理规则上有明显界限:
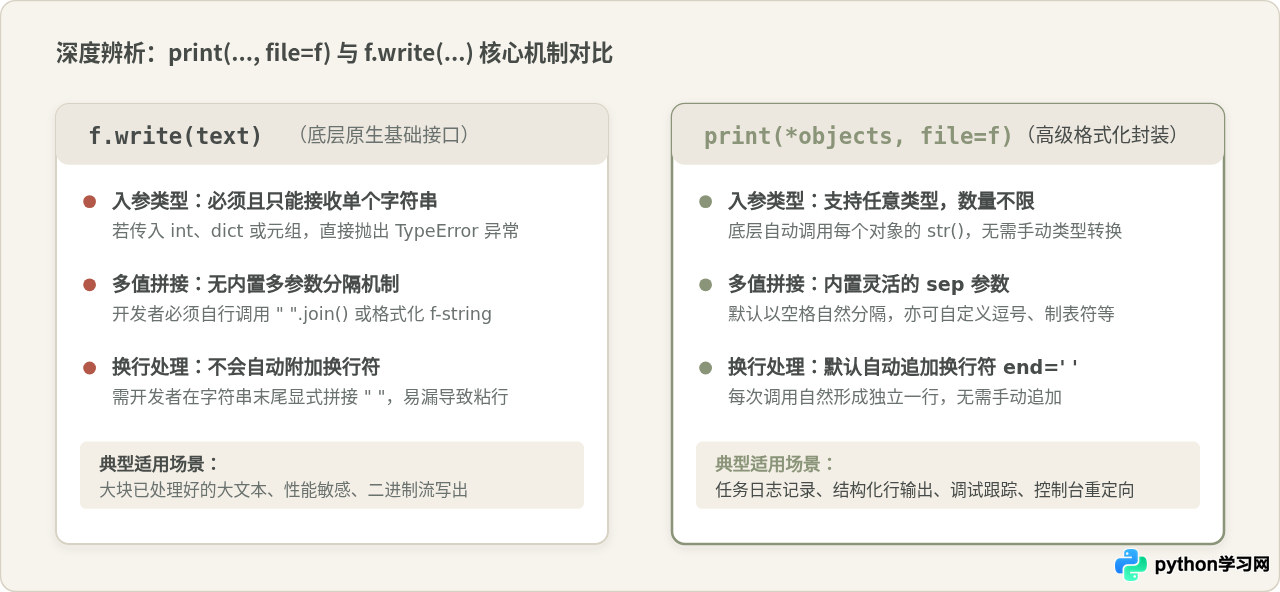
下表归纳了两者的核心差异,便于根据开发需求进行选型:
| 对比维度 | print(..., file=f) | f.write(...) |
|---|---|---|
| 参数接受能力 | 支持多个任意类型参数(数值、字典、对象等) | 仅能接收一个且必须是 str 类型的参数 |
| 多元素间隔 | 通过 sep 自动用空格或指定字符连接 |
无内置逻辑,须手动字符串拼接或格式化 |
| 换行控制 | 默认尾部自动添加
(由 end 决定) |
不会自动添加换行,必须开发者显式写
|
| 缓冲区刷新 | 可通过 flush=True 一键强刷 |
需额外调用 f.flush() |
| 典型适用定位 | 结构化日志、混合调试信息、逐行报告生成 | 大块预格式化文本、二进制流、高性能吞吐输出 |
四、进阶技巧与实用场景
1. 应对长任务中断:搭配 flush=True 即时落盘
在默认情况下,向磁盘写入文件是带有用户空间缓冲区的。如果执行一个长时间运行的爬虫、模型训练或数据批处理脚本,在没有达到缓冲区阈值或程序退出前,磁盘文件里的内容可能一直为 0 字节。此时若遭遇意外停电或被进程管理器强制杀死,缓冲区内的数据就会遗失。
只需在调用时指定 flush=True,即可在每次 print 后立即要求底层操作系统将数据从缓冲区刷新到磁盘中:
# 耗时循环任务中保证每条进度实时可见
import time

with open("progress.log", "w", encoding="utf-8") as log:
    for step in range(1, 4):
        # flush=True 保证外部通过 tail -f 查看时立刻能看到最新行
        print(f"当前已完成第 {step} 阶段计算...", file=log, flush=True)
        time.sleep(1)
2. 在内存中捕获打印内容:结合 io.StringIO
前面提到,file 参数接收的是只要实现了 write() 方法的任何对象。利用标准库 io.StringIO,我们可以在不落地任何磁盘文件的前提下,把函数或模块的打印结果完整捕获到内存变量中。这在编写单元测试或构建字符串模版时极其有用:
import io

# 创建内存字符流对象
memory_buffer = io.StringIO()

# 像操作普通文件一样传给 print
print("第一行数据", 100, file=memory_buffer)
print("第二行数据", 200, file=memory_buffer)

# 从内存中一次性取出所有捕获的内容
captured_text = memory_buffer.getvalue()
print("从内存中提取到的内容长度为:", len(captured_text))
3. 终端与文件双向输出(类 Linux tee 管道)
如果希望某条输出既在控制台上实时可见,又同步保存到日志文件中,无需写两遍 print。我们可以设计一个轻量级的适配器类,同时将写入指令派发给多个目标:
import sys

class DualStream:
    def __init__(self, *targets):
        self.targets = targets

    def write(self, message):
        for t in self.targets:
            t.write(message)

    def flush(self):
        for t in self.targets:
            t.flush()

# 使用双流输出
with open("dual_log.txt", "w", encoding="utf-8") as log_f:
    tee = DualStream(sys.stdout, log_f)
    print("这条信息会同时出现在屏幕控制台和 dual_log.txt 磁盘文件中!", file=tee)
五、全景总结与避坑速查表
利用 print() 的 file 参数进行文件写入,是 Python 简洁优雅设计理念的典型体现。在实际编写代码时,可以参考以下决策速查图与自查清单快速规避问题:
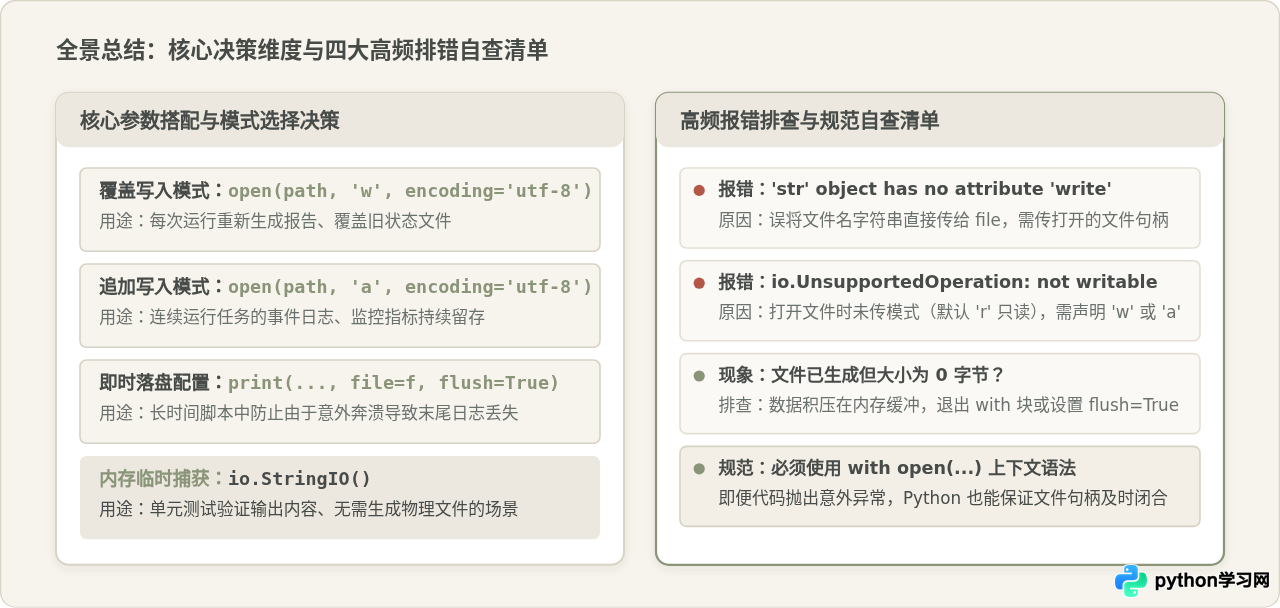
- 首选上下文语法:始终通过
with open(...) as f:开启文件,保障异常安全并自动处理资源闭合。 - 谨防类型传参错误:
file参数必须是已打开的文件对象或具备.write()接口的类文件对象,绝不能传入文件名字符串。 - 按需选用打开模式:生成整份新报表选用
'w';累加运行时日志选用'a';切勿遗漏encoding='utf-8'。 - 关键进度即时刷新:如果运行耗时较长且外部需要实时观察状态,善用
flush=True促使数据立刻落盘。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









