

Python怎么逐行读取超大txt文件以节省内存
针对数十GB甚至TB级的超大txt文本文件,本文深入讲解如何在Python中利用文件迭代器、生成器管道以及定长分块机制实现逐行流式读取,在保障高效处理的同时将常驻内存严格控制在常量级。
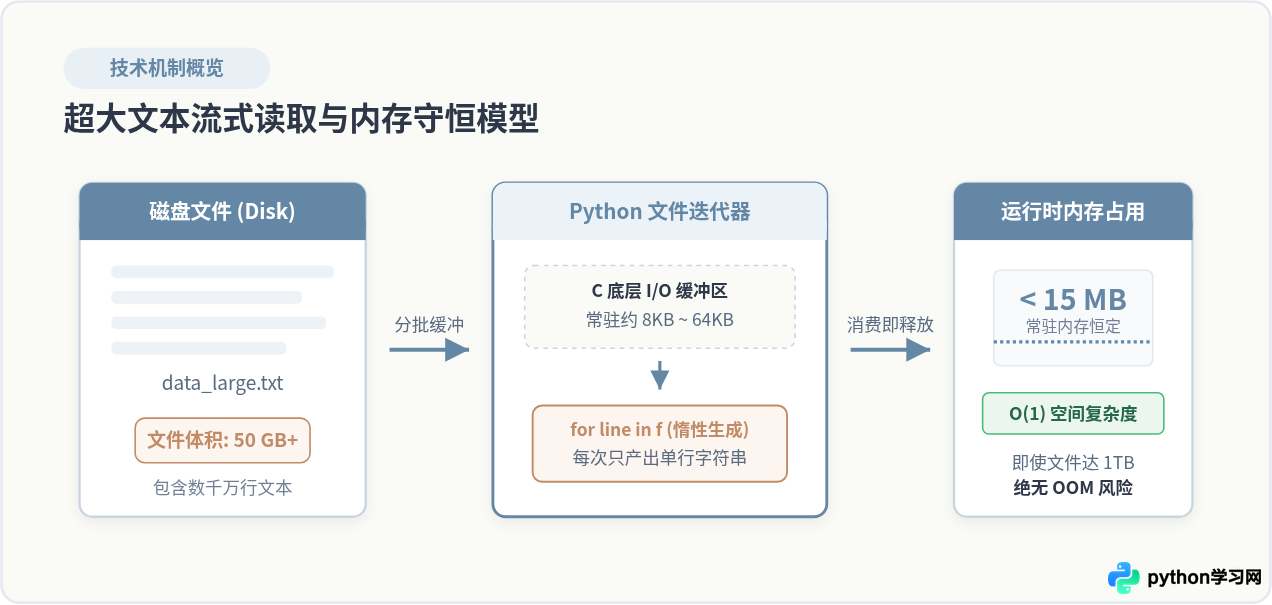
在 Python 中逐行读取超大 txt 文本文件以节省内存,最核心且经过官方高度优化的做法是直接遍历文件对象(即 with open(...) as f: for line in f:)。该语法基于 Python 底层的迭代器协议与 C 语言层缓冲区,只在当前循环步中加载当前行至内存,每处理完一行即由解释器垃圾回收释放,使内存常驻占用始终维持在数兆字节(O(1) 空间复杂度),彻底杜绝因文件体积极大而触发的 MemoryError 内存溢出问题。
一、为什么常规读取方法会耗尽内存
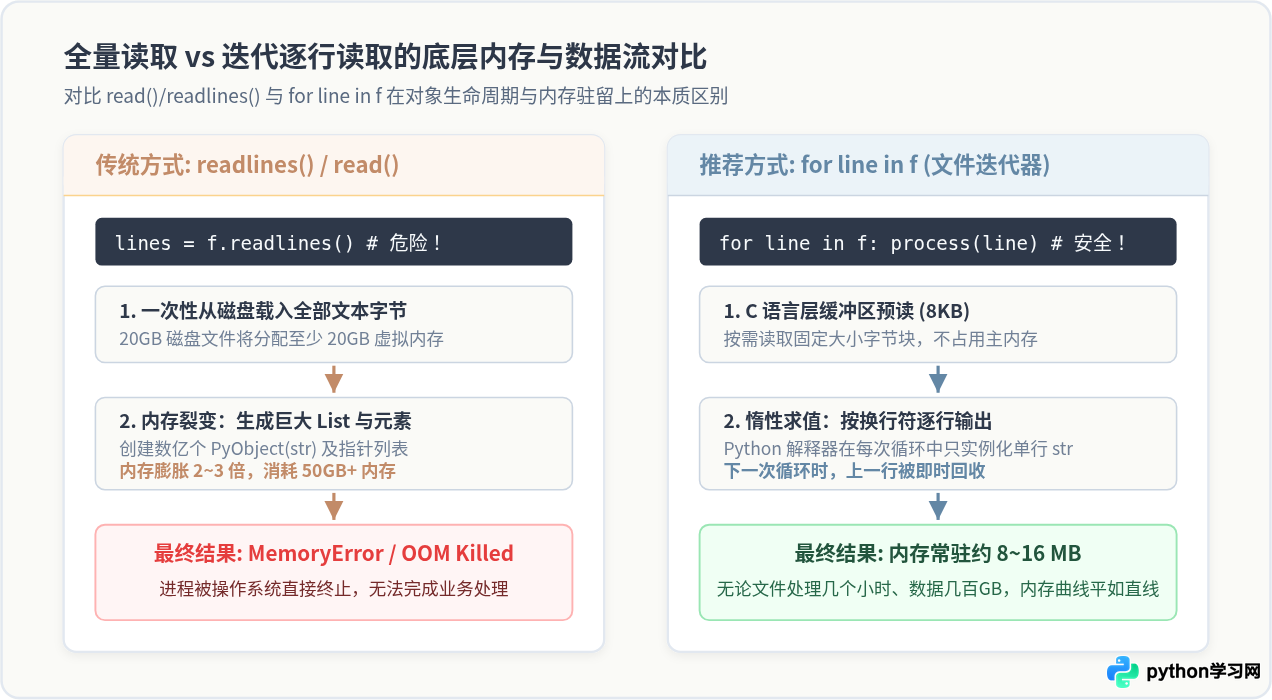
很多初学者在处理文件时习惯使用 f.read() 或 f.readlines()。对于几十兆以内的小文件,这些方法简单直观;但在面对几十吉字节(GB)的日志文件、数据转储文本或特征语料时,它们会迅速瘫痪程序:
f.read()的全量载入问题:该调用会一次性请求操作系统向 Python 进程分配与文件大小等额的连续虚拟内存空间,并将全部文本读取为一个巨大的字符串对象。如果服务器空闲内存小于文件体积,操作系统会立即抛出MemoryError或触发 Linux OOM Killer 强行杀掉进程。f.readlines()的对象裂变放大效应:该方法虽然也是按行组织,但它会将文件全部行同时实例化为一个庞大的 Pythonlist列表对象。在 CPython 虚拟机中,列表内部每一个元素都是一个独立的PyObject字符串对象外加指针引用开销,其在内存中的实际驻留体积往往是原磁盘 txt 文件的 2 到 3 倍。
二、标准解决方案:基于文件迭代器的逐行处理
Python 的文件对象本质上是一个惰性迭代器(Iterator)。通过 for line in f: 语法,Python 不会一次性解析全文,而是借由内置的 C 语言 I/O 缓冲区(默认大小通常为 8KB,亦可根据硬件环境调整),在底层成块预读并在内存中实时切出当前单行:
def process_large_file(file_path: str):
    """
    流式逐行读取超大txt文件
    内存常驻保持在常数级,支持任意大文件处理
    """
    with open(file_path, mode='r', encoding='utf-8', errors='replace') as f:
        for line in f:
            # 清理末尾换行符
            clean_line = line.rstrip('\r\n')

            # 此处执行业务处理逻辑,例如提取关键字段或写入目标文件
            if clean_line:
                handle_single_line(clean_line)

def handle_single_line(line_content: str):
    # 示例处理函数:打印长度或解析字段
    pass
for line in f: 迭代循环中,变量 line 在每次进入下一次迭代时都会被赋予新的单行字符串对象。上一行对象的引用计数立即归零,CPython 运行时的内存管理器(PyMalloc)能够立刻回收这部分内存空间,使得整个处理周期的常驻内存(RSS)稳定如直线。
三、生产环境中的关键操作细节与健壮性保障
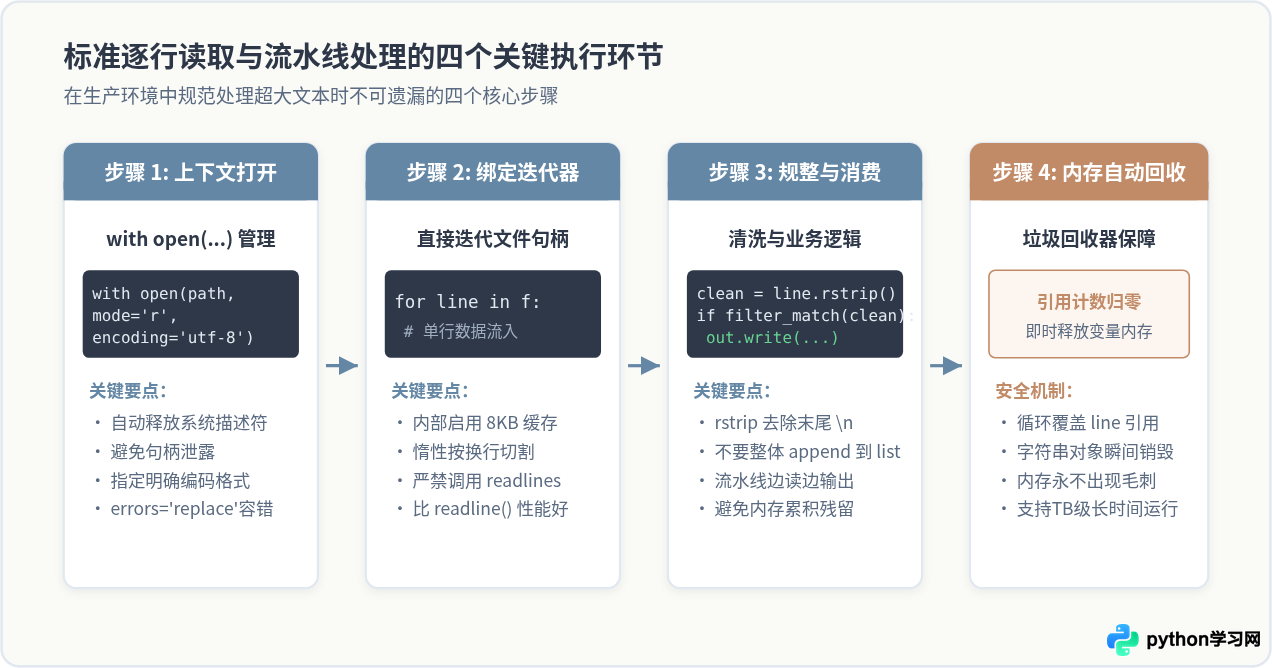
在实际生产服务器上处理超大规模文本时,除了写对循环结构,还需要特别关注以下四个工程细节:
1. 严格使用上下文管理器(with 语句)
超大文件处理往往伴随较长的运行时间。若直接通过 f = open(...) 并在末尾手动 f.close(),一旦处理过程中间抛出格式解析异常,文件描述符就无法被即时关闭。使用 with open(...) as f: 可以在任何异常退出或执行完毕时,自动触发 __exit__ 机制关闭系统句柄。
2. 规范剔除末尾换行符
迭代器产出的 line 会完整保留行尾的换行标记(如 Linux 下的 \n 或 Windows 下的 \r\n)。推荐使用 line.rstrip('\r\n') 精确剔除换行,而尽量避免不加参数的 line.strip(),防止误将行首或行尾用于对齐的有效制表符(Tab)和空格一并抹除。
3. 编码容错配置
超大 txt 文件(如累积数周的服务器 access log)极易掺杂损坏字节或混合编码。如果在 open 时使用默认的 errors='strict',程序运行几小时后一旦遇到一个非法字节便会全盘崩溃。在数据允许的场景下,建议显式设置 errors='replace' 或 errors='ignore':
# 采用替换策略,非法字符将转为 Unicode 替代符 '?',保障管道持续流转
with open("massive_data.txt", mode="r", encoding="utf-8", errors="replace") as f:
    for line in f:
        # 处理流程不受个别乱码中断
        pass
4. 避免将数据整体聚合到内存列表中
一种极易发生的隐蔽内存泄露是在流式循环内部写出 all_records.append(parse(line))。如果循环读取了 5000 万行并全部添加至内存中的一个 List,流式读取节省内存的努力将被彻底抵消。正确做法是将清洗结果即时写入新的输出文件,或分批(Batch)聚合到数据库中后清空局部列表。
四、进阶模式:使用生成器(Generator)解耦清洗管道
当单行处理涉及复杂的过滤、字段重组、正则提取或类型转换时,将所有逻辑塞入同一个 for 循环会导致代码高度耦合且不易单测。可以利用 Python 的 yield 关键字封装流式生成器函数,构建高内聚的流水线:
from typing import Generator

def stream_cleaned_lines(file_path: str) -> Generator[str, None, None]:
    """生成器:仅产出通过初步校验的有效文本行"""
    with open(file_path, mode='r', encoding='utf-8', errors='replace') as f:
        for raw_line in f:
            stripped = raw_line.rstrip('\r\n')
            # 过滤空行或特定注释行
            if stripped and not stripped.startswith('#'):
                yield stripped

def parse_log_records(lines: Generator[str, None, None]) -> Generator[dict, None, None]:
    """生成器:将文本解析为字典结构"""
    for line in lines:
        parts = line.split('\t')
        if len(parts) >= 3:
            yield {
                "timestamp": parts[0],
                "level": parts[1],
                "message": parts[2]
            }

# 业务消费端:保持极致轻量的常驻内存
def run_pipeline(source_path: str, output_path: str):
    raw_stream = stream_cleaned_lines(source_path)
    record_stream = parse_log_records(raw_stream)

    with open(output_path, mode='w', encoding='utf-8') as out:
        for record in record_stream:
            if record["level"] == "ERROR":
                out.write(f"{record['timestamp']} - {record['message']}\n")
五、极端边界场景:遇到超长单行或无换行文件怎么办
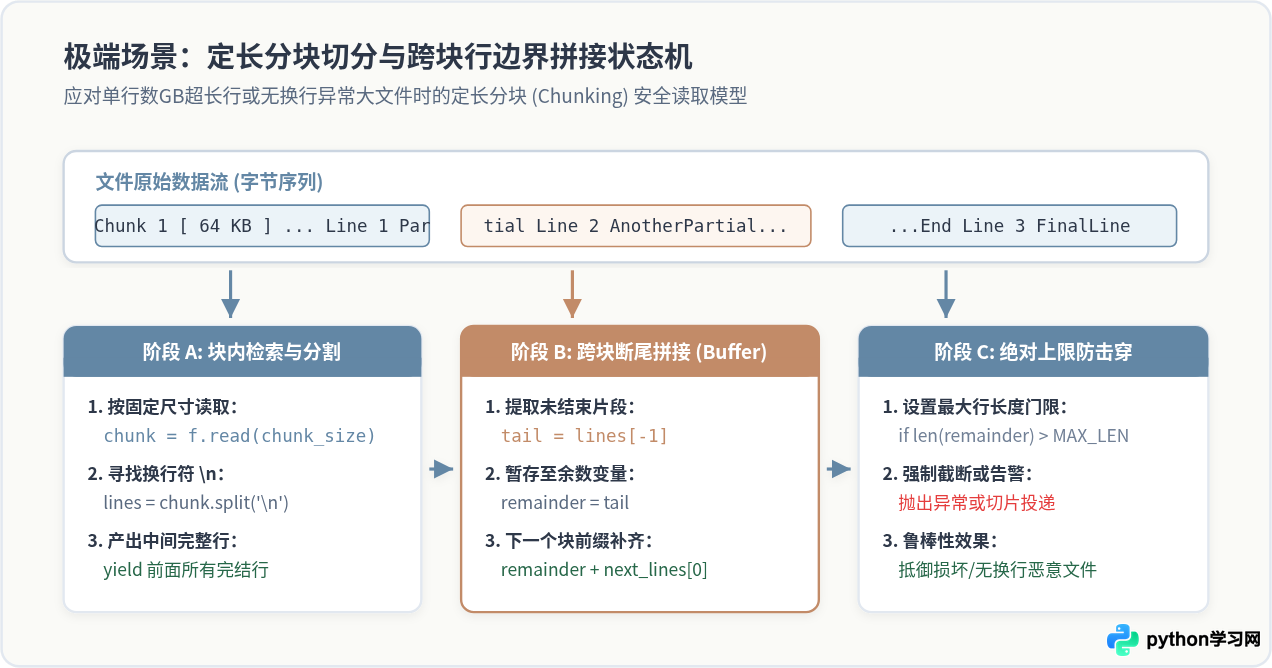
虽然 for line in f 能够胜任绝大多数标准 txt 文件的流式处理,但在极少数异常场景下存在潜在隐患:如果该文件缺乏换行符 \n(例如被格式压缩的单行超大 JSON、巨型 Base64 编码文件或二进制误存为 txt 的数据),Python 的文件迭代器为了寻找换行符,会持续从磁盘向内存缓冲,直到读取整个巨型单行,依然会引发 MemoryError。
针对这种不可预知单行长度的极端文件,可以通过 f.read(chunk_size) 定长分块读取,并在内存中通过状态机拼接跨块数据:
def read_in_chunks_by_line(file_path: str, chunk_size: int = 65536, max_line_len: int = 10485760):
    """
    定长块读取器:按固定字节大小缓冲,安全还原完整行
    即使单行损坏也能通过 max_line_len 门限保护进程不被 OOM 击穿
    """
    with open(file_path, mode='r', encoding='utf-8', errors='replace') as f:
        tail = ""
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                # 文件结束,产出末尾残留文本
                if tail:
                    yield tail
                break

            # 拼接上一块残留文本
            combined = tail + chunk
            lines = combined.split('\n')

            # 最后一个片段可能未到达换行符,留存到下一块
            tail = lines.pop()

            # 异常防击穿:若单行累计超过安全上限(如10MB),强制截断报警
            if len(tail) > max_line_len:
                yield tail
                tail = ""

            for complete_line in lines:
                yield complete_line
六、常见性能认知误区解析
在超大文件处理的性能调优中,常见以下三个认知偏差:
- 误区一:手动
while True: line = f.readline()比for line in f更快?
实际测试与源码证明恰恰相反。f.readline()每次调用都会经历一次 Python 虚拟机层的方法寻址与包装,而for line in f直接调用底层的 C 扩展迭代器协议,利用内部专属的高速预读取缓冲区(Lookahead Buffer),吞吐速度通常比显式readline()快 30% 到 50%。 - 误区二:多进程切分超大 txt 是否一定能大幅加速?
对于纯文本文件,如果盲目按文件字节偏移量(Offset)切分给多进程,极难在字节边界上精准对齐换行符,且多进程同时并发读取同一块机械硬盘或并发抢占 SATA/NVMe 磁盘通道时,容易造成磁头寻道瓶颈与 I/O 争用。除非数据位于高性能并行分布式文件系统,否则单进程高效流式处理往往兼具最佳的吞吐稳定性与最低的维护成本。 - 误区三:使用
linecache模块随机访问?
Python 标准库提供了linecache模块,但该模块的设计目的是为了调试器快速查看源代码文件。linecache会将文件的全部内容直接缓存到内存全局字典中。若将其用于 GB 级别的超大 txt,会立刻导致内存暴涨。
七、总结与选型指南
在 Python 中逐行处理超大 txt 文本文件,核心目标是在恒定的极低内存占用与极简的编码维护成本之间取得平衡:
| 读取策略 | 内存占用 | 代码复杂度 | 适用典型场景 |
|---|---|---|---|
with open(...) as f: for line in f |
常数级(几 MB) | 极低(标准原生) | 绝大多数标准文本与日志分析(首选标准方案) |
yield 生成器管道 |
常数级(几 MB) | 低(模块化良好) | 多阶段清洗、结构化解析、ETL 流式入库 |
f.read(chunk_size) 定长分块 |
受控常数(可设上限) | 中等(需维护行拼接) | 异常超长单行、缺失换行符、不可信未知大文件 |
f.readlines() / f.read() |
线性暴增(O(N) 放大) | 极低 | 严禁用于超大文件(必导致 OOM 崩溃) |
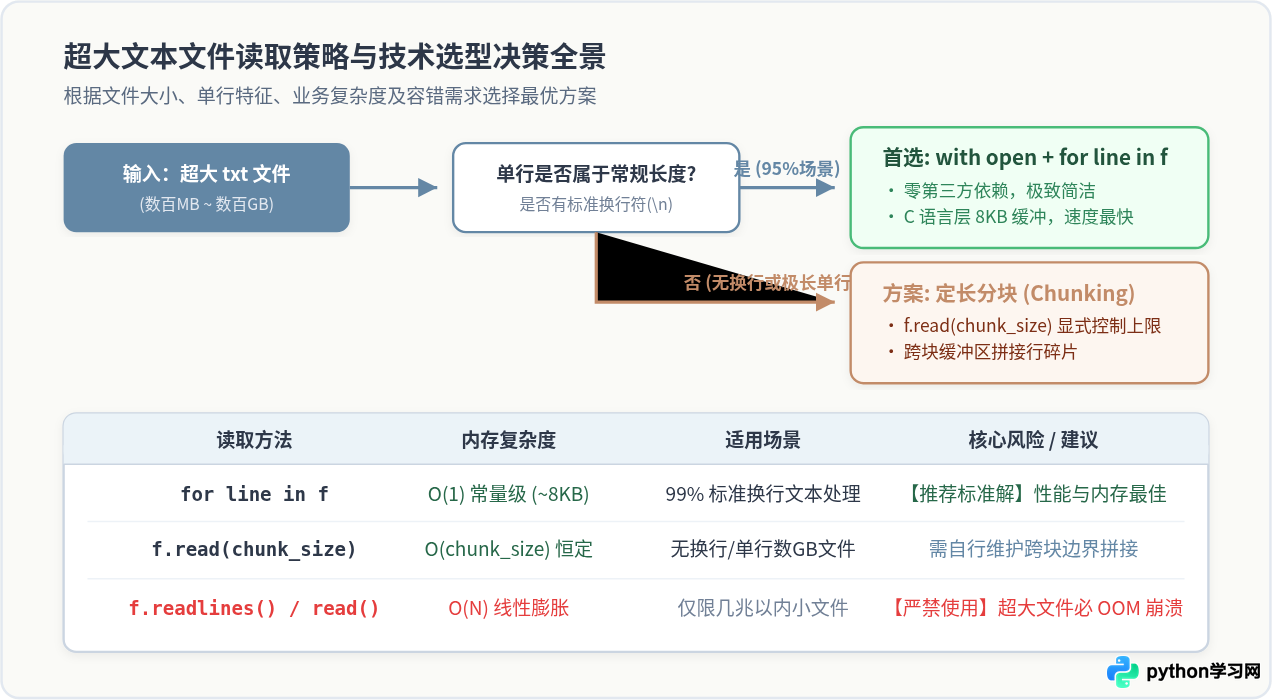
遵循标准文件迭代语法,合理结合上下文管理器与异常编码容错,即可在 Python 中安全、稳定、高效地应对任何体积的超大 txt 文本文件。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









