

Python爬虫数据怎么存?CSV、JSON与MySQL存储代码示例
针对Python爬虫数据持久化需求,系统讲解CSV文件、JSON/JSON Lines格式以及MySQL关系型数据库三种主流存储方式的选型边界、核心踩坑点及完整可执行代码示例。
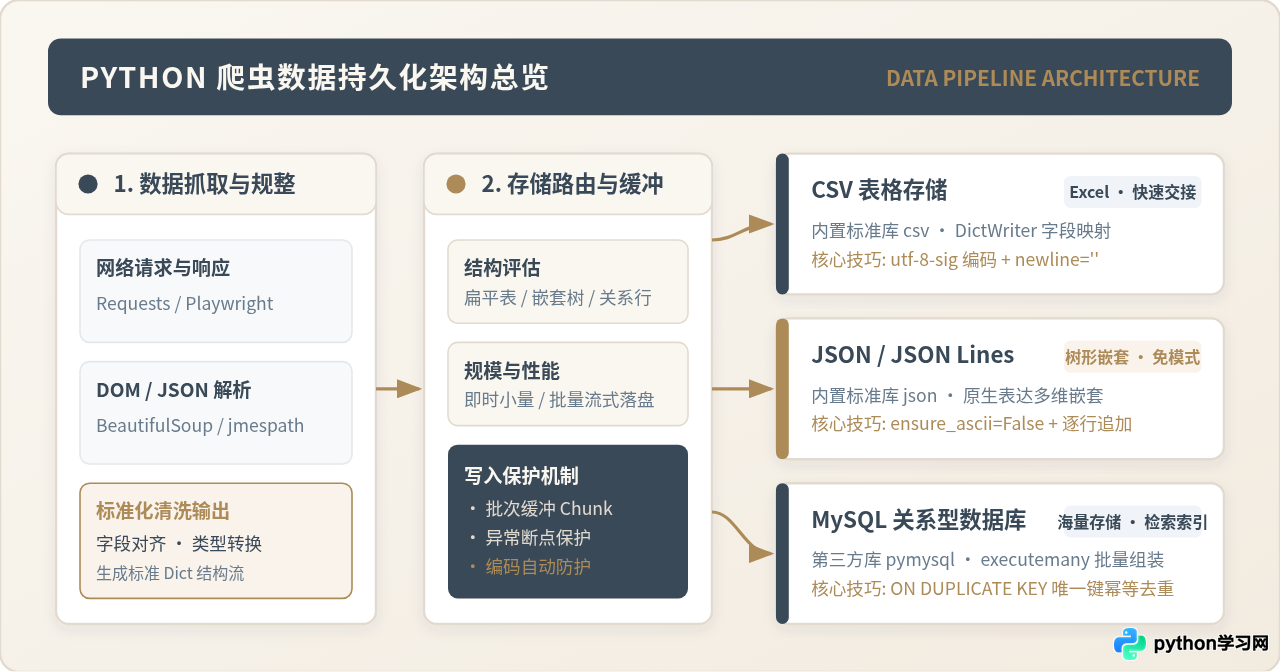
一、存储方案的选型依据与决策边界
很多爬虫新手在写完数据解析后,常常随手用一个列表把全部数据存起来,最后一次性写入文本,或者遇到任何需求都无条件启动重量级的数据库服务。这两种极端做法在实际项目中都会带来维护困难或性能浪费。
合理的技术选型应围绕三个硬性指标展开:数据维度复杂度、采集规模与并发要求,以及下游消费终端。
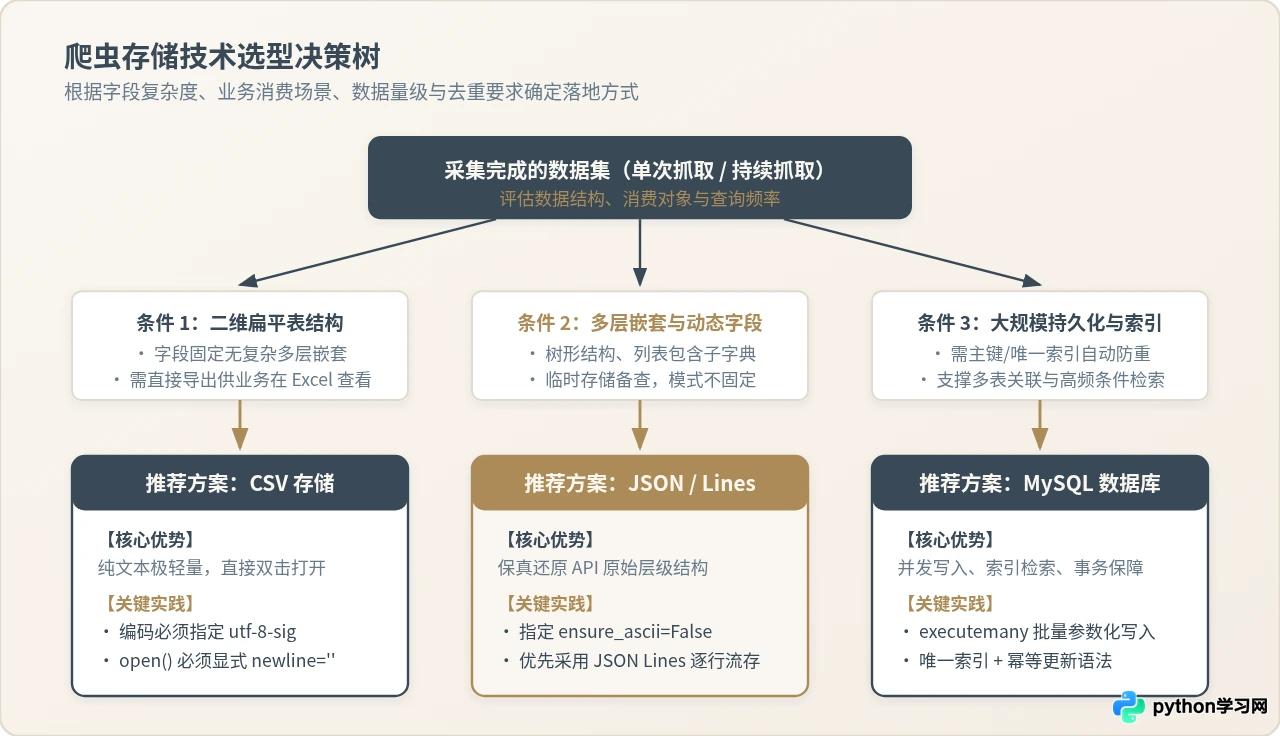
结合实际应用场景,选型规则可以清晰划分为以下三类:
- 选择 CSV:适合规则的二维表格数据(例如商品名称、价格、销量、发布时间)。数据字段完全固定,没有任何多层嵌套字典或子数组,且目标读者是运营或分析同事,需要直接用 Excel 或 WPS 双击打开查看。
- 选择 JSON / JSON Lines:适合抓取移动端 App 或前后端分离网站返回的原始响应。数据呈现多层级树状嵌套,不同条目的字段可能存在缺漏或动态增减。特别是中大型采集任务,采用逐行追加的 JSON Lines(.jsonl)可以避免程序意外中断导致整个文件损坏。
- 选择 MySQL:适合百万级以上的长期持续监控爬虫,或者需要按特定字段频繁进行条件过滤、区间统计和关联查询的场景。更重要的是,MySQL 依托唯一索引(UNIQUE KEY),能以极高的效率解决网络重试或周期性抓取中的数据去重问题。
二、CSV 格式存储:快速导出的轻量选择
CSV(Comma-Separated Values)本质上是用逗号分隔字段的纯文本文件。Python 内置的 csv 标准库提供了完备的读写支持,其中 csv.DictWriter 是爬虫开发中最推荐的类,因为它允许直接传入字典,自动依据表头名称对齐列顺序。
1. 核心注意事项
在 Windows 和各类办公软件环境下,CSV 文件有两个最容易踩坑的细节:
- 必须声明
newline='':调用open()打开文件时,如果不指定newline='',Python 的换行转换机制与 csv 模块自身的换行写入会发生冲突,在 Windows 系统下打开文件会出现“隔一行一个空行”的现象。 - 推荐使用
utf-8-sig编码:如果仅指定encoding='utf-8',Microsoft Excel 在打开带有中文的 CSV 时会默认采用系统本地编码(如 GBK)解码,从而出现大面积乱码;使用utf-8-sig会在文件开头写入 UTF-8 BOM 标识符,引导 Excel 自动识别为 UTF-8 编码。
2. 完整存储代码示例
import csv
import os

# 模拟爬虫提取出的标准化数据列表
crawled_books = [
    {"id": 101, "title": "Python核心编程", "price": 89.5, "rating": 4.8, "tags": "编程;Python"},
    {"id": 102, "title": "流畅的Python", "price": 128.0, "rating": 4.9, "tags": "进阶;架构"},
    {"id": 103, "title": "网络爬虫开发实战", "price": 79.0, "rating": 4.7, "tags": "爬虫;数据分析"},
]

def save_to_csv(file_path: str, data: list[dict]):
    """
    保存字典列表到 CSV 文件中。
    自动检测文件是否存在:若不存在则写入表头;若已存在则直接追加数据。
    """
    if not data:
        return

    # 从第一条记录中提取字段表头
    fieldnames = list(data[0].keys())
    file_exists = os.path.exists(file_path)

    # 关键参数:newline='' 防止空行,encoding='utf-8-sig' 解决 Excel 中文乱码
    with open(file_path, mode="a", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)

        # 仅在初次建文件时写入表头
        if not file_exists:
            writer.writeheader()

        # 批量写入多条数据字典
        writer.writerows(data)

if __name__ == "__main__":
    csv_filename = "books_data.csv"
    save_to_csv(csv_filename, crawled_books)
    print(f"数据已成功保存至 {csv_filename}")
上述代码通过 os.path.exists 自动判断是否需要写入表头,使用 mode="a" 追加模式,既支持爬虫启动时的首次批量写入,也支持后续抓取过程中分批追加,避免了每次重新打开都重复打印表头的问题。
三、JSON / JSON Lines 格式存储:应对嵌套结构与灵活字段
当抓取的数据包含层级关系(例如某条评论包含一个子列表展示所有回复),或者各个页面的字段不完全固定时,CSV 必须把列表或字典强行序列化成字符串,丢失了结构信息。此时,JSON 格式是保真度最高的文件存储方式。
1. 一次性 JSON 数组 vs 逐行 JSON Lines
初学者常用 json.dump(all_data, f) 将整个 Python 列表一次性转为 JSON 数组。这种方式对于几百条数据非常方便,但在抓取几十万条的大型任务中存在两大致命隐患:
- 内存激增:必须在内存中把所有爬取的数据完整保留为一个巨大列表,中途发生内存溢出(OOM)将前功尽弃。
- 容灾能力极弱:整个文件必须符合标准的 JSON 语法(以
[开头,以]结尾,中间逗号隔开)。如果爬虫在中途被意外中断或杀死,末尾缺少闭合括号,整个文件将彻底损坏无法直接解析。
工业级爬虫更推荐 JSON Lines(NDJSON) 格式:每行写入一个独立的合法 JSON 字符串。不仅写入开销极低(无需重写整个文件),即使进程随时被 Kill,之前已经落盘的每一行依然完全有效。
2. 完整存储代码示例
import json

# 包含嵌套字段的复杂爬虫数据
nested_articles = [
    {
        "post_id": "art_20261101_01",
        "author": {"name": "极客小张", "verified": True, "level": 5},
        "title": "深入理解协程与异步IO",
        "tags": ["Python", "Asyncio", "并发"],
        "metrics": {"views": 15200, "likes": 642, "comments": 38}
    },
    {
        "post_id": "art_20261101_02",
        "author": {"name": "数据探险家", "verified": False, "level": 3},
        "title": "Pandas 高性能数据清洗技巧",
        "tags": ["数据分析", "Pandas"],
        "metrics": {"views": 8900, "likes": 310, "comments": 15}
    }
]

def save_as_json_array(file_path: str, data: list[dict]):
    """一次性将数据存为格式化的标准 JSON 数组(适合小数据量)"""
    # ensure_ascii=False 确保中文字符不被转义为 \uXXXX
    # indent=2 输出美化缩进,便于直接阅读排查
    with open(file_path, mode="w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=2)

def save_as_json_lines(file_path: str, item: dict):
    """逐行追加单个字典到 JSON Lines 文件中(流式写入,推荐生产使用)"""
    with open(file_path, mode="a", encoding="utf-8") as f:
        # 将单个字典转换为无格式单行字符串并加上换行符
        line = json.dumps(item, ensure_ascii=False)
        f.write(line + "\n")

if __name__ == "__main__":
    # 方式一:保存为标准 JSON
    save_as_json_array("articles_pretty.json", nested_articles)

    # 方式二:流式追加至 JSON Lines 文件
    for article in nested_articles:
        save_as_json_lines("articles_stream.jsonl", article)

    print("JSON 与 JSON Lines 数据存储已完成。")
四、MySQL 关系型数据库存储:支撑规模化与并发去重
当爬虫数据需要被后台业务系统实时读取、或者采集任务需要长期增量运行(例如每天定时巡检全网价格)时,文件系统将面临查找极其低效、无法做唯一性去重等瓶颈。此时,使用 MySQL 关系型数据库是最成熟的解决方案。
1. 数据表建表与字段设计规范
在写 Python 入库代码之前,必须先在 MySQL 中创建对应的数据表结构。针对爬虫数据,有两个关键设计准则:
- 字符集选择
utf8mb4:现代互联网包含大量 Emoji 表情符号或特殊生僻字,标准的utf8只支持最多 3 字节,写入 4 字节的 Emoji 时会直接报错Incorrect string value,必须显式指定为utf8mb4。 - 建立唯一索引(Unique Index):通常使用业务主键(例如商品 ID、文章 ID),或者将网页 URL 经过 MD5 运算后作为唯一去重字段。
-- 准备建表 SQL 语句
CREATE TABLE IF NOT EXISTS `crawler_products` (
  `id` INT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  `item_id` VARCHAR(64) NOT NULL COMMENT '商品或业务唯一标识',
  `title` VARCHAR(255) NOT NULL COMMENT '商品标题',
  `price` DECIMAL(10, 2) NOT NULL DEFAULT 0.00 COMMENT '价格',
  `stock` INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '库存',
  `updated_at` TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
  UNIQUE KEY `uk_item_id` (`item_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='爬虫采集商品表';
2. 批量写入与幂等去重实现
在 Python 中连接 MySQL 通常使用第三方纯 Python 驱动 pymysql。在编写入库逻辑时,切忌每抓到一条就执行一次 cursor.execute("INSERT ..."),这会导致频繁的网络 TCP 往返和数据库事务开销。
最佳实践是采用 cursor.executemany() 进行批处理,并配合 ON DUPLICATE KEY UPDATE 语法,使重复的数据自动更新价格与库存,实现采集任务的幂等性。
import pymysql
from pymysql.cursors import DictCursor

# 待入库的抓取数据包
products_batch = [
    {"item_id": "SKU_8801", "title": "降噪无线头戴耳机", "price": 499.00, "stock": 120},
    {"item_id": "SKU_8802", "title": "4K超高清便携显示器", "price": 1299.00, "stock": 45},
    {"item_id": "SKU_8801", "title": "降噪无线头戴耳机 (降价更新)", "price": 459.00, "stock": 115}, # 模拟重复键更新
]

DB_CONFIG = {
    "host": "127.0.0.1",
    "port": 3306,
    "user": "root",
    "password": "your_password",
    "database": "crawler_db",
    "charset": "utf8mb4",
    "cursorclass": DictCursor,
    "autocommit": False # 建议关闭自动提交,手动控制批次事务
}

def batch_upsert_products(db_config: dict, items: list[dict]):
    """
    批量将商品数据持久化至 MySQL。
    利用 ON DUPLICATE KEY UPDATE 实现重复数据自动覆盖更新。
    """
    if not items:
        return

    # 准备参数化 SQL 模板,严禁使用 f-string 拼接 SQL 造成 SQL 注入漏洞
    sql = """
    INSERT INTO crawler_products (item_id, title, price, stock)
    VALUES (%s, %s, %s, %s)
    ON DUPLICATE KEY UPDATE
        title = VALUES(title),
        price = VALUES(price),
        stock = VALUES(stock);
    """

    # 将字典列表组装为二维元组列表
    data_tuples = [
        (item["item_id"], item["title"], item["price"], item["stock"])
        for item in items
    ]

    conn = pymysql.connect(**db_config)
    try:
        with conn.cursor() as cursor:
            # 批量执行 SQL 写入
            affected_rows = cursor.executemany(sql, data_tuples)
            # 提交当前批次事务
            conn.commit()
            print(f"写入成功!影响行数: {affected_rows}(包含新增与更新)")
    except Exception as e:
        conn.rollback() # 出现异常立即回滚事务
        print(f"数据入库失败,已执行回滚: {e}")
        raise
    finally:
        conn.close() # 释放数据库连接

if __name__ == "__main__":
    # 执行批量持久化操作(请先确保本地或测试 MySQL 环境已就绪)
    # batch_upsert_products(DB_CONFIG, products_batch)
    print("MySQL 批量幂等入库逻辑已配置完毕。")
五、爬虫数据持久化的标准流程与机制对比
无论选择文件存储还是数据库存储,健壮的爬虫程序都必须建立起清晰的数据流转生命周期。直接从抓取函数中向磁盘写数据是一种紧密耦合的坏习惯,一旦网络慢或者数据库发生抖动,爬虫的请求线程就会被死锁。
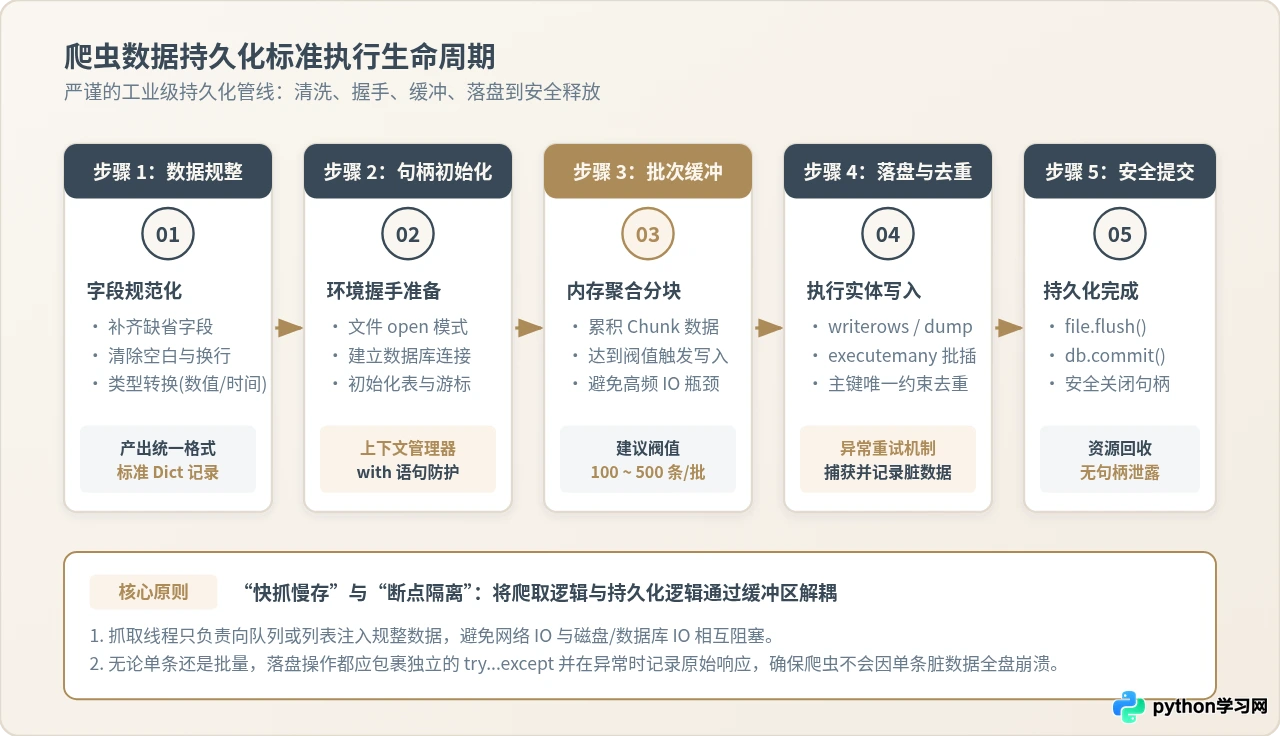
为了让大家更透彻地理解各种方案在实际运行中的资源消耗与功能权衡,下表整理了三者在底层组织形态、开销以及操作复杂度上的全方位对比:
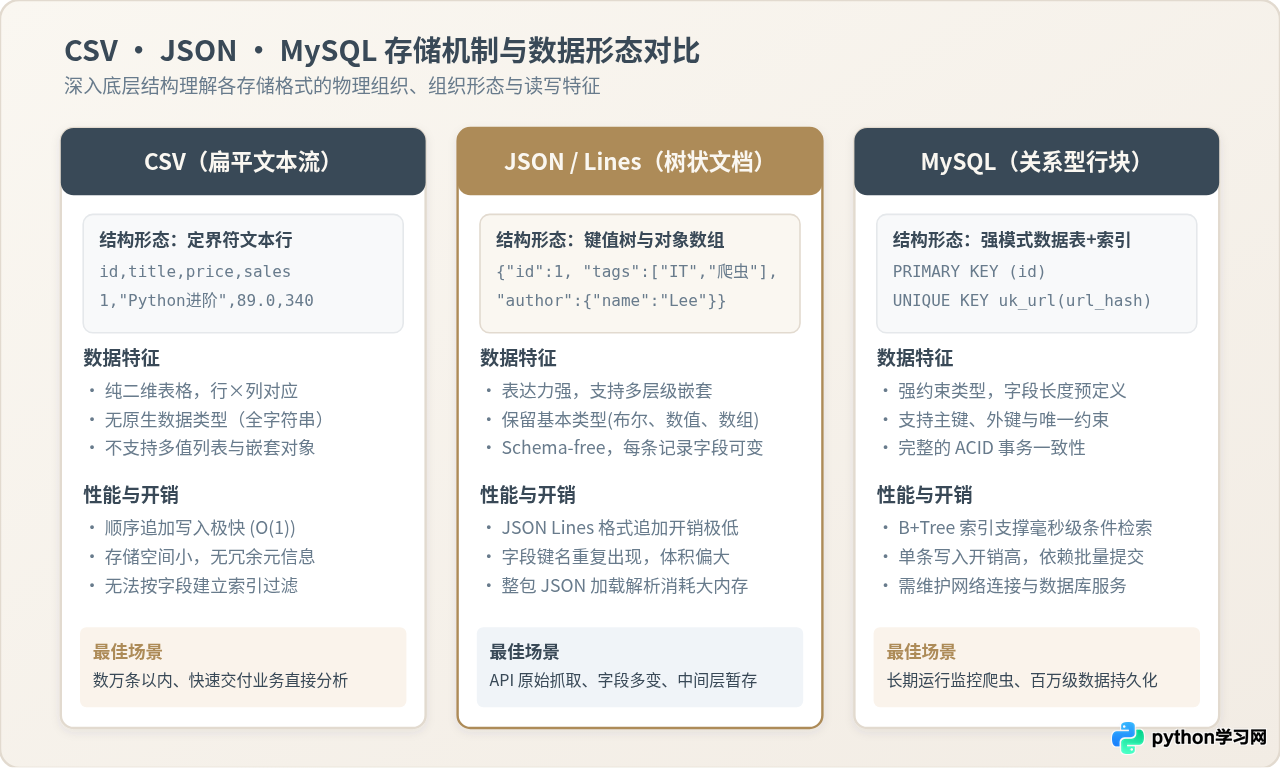
| 对比维度 | CSV 存储 | JSON / JSON Lines | MySQL 数据库 |
|---|---|---|---|
| 数据结构 | 严格二维平面表格 | 树状嵌套文档 / 数组 | 结构化关系数据表 |
| 环境依赖 | 零依赖(Python 内置) | 零依赖(Python 内置) | 需安装 MySQL 服务与 pymysql |
| 并发写入 | 较差(多进程追加易冲突) | 多进程安全(JSON Lines) | 极高(行级锁与事务隔离) |
| 查询检索能力 | 无索引,需全量扫描文件 | 需加载全文后通过代码筛选 | B+Tree 索引支撑毫秒级条件检索 |
| 去重与幂等 | 代码内存去重或后置清洗 | 通常靠 Set 集合内存去重 | 原生支持 UNIQUE KEY 索引幂等 |
| 适用数据量级 | 10 万条以内 | 100 万条以内(单文件) | 千万级及以上海量数据 |
六、工程实践防坑检查清单
在实际部署上线爬虫程序前,可以根据以下四项关键安全准则逐一校验你的持久化代码,规避常见的线上事故:
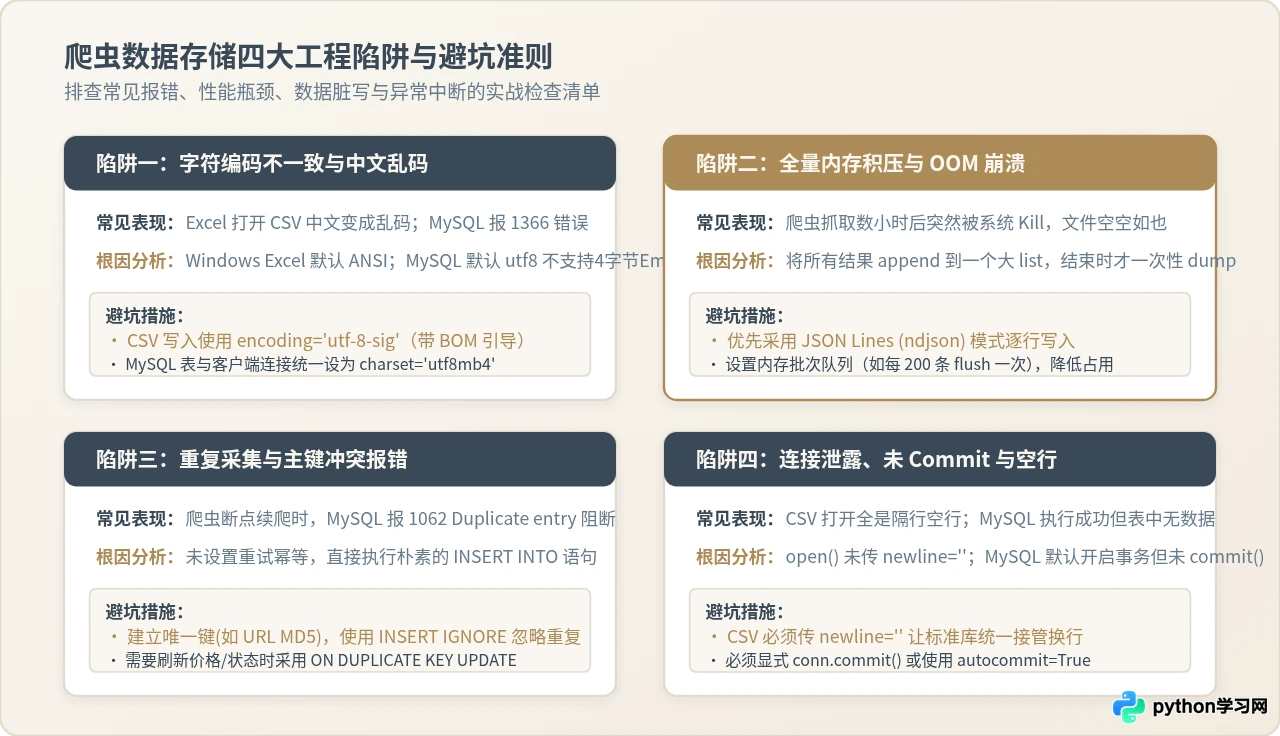
-
排查字符编码与标点防范:
写入 CSV 时务必固定使用
utf-8-sig;在将数据写入 MySQL 时,务必在建库、建表以及 Python 的connect()参数中三处全部保持charset='utf8mb4',防止网页中的表情符号引发入库崩溃。 -
防范大内存溢出与进程闪退:
当预计采集规模超过 5 万条时,严禁使用列表全局累加后一次性 dump 的模式。改用
jsonlines逐条刷盘,或者在内存中维持一个 200~500 条的短队列,满载后批量写入并清空队列。 -
坚持参数化查询,杜绝字符串拼接:
向数据库写入时,所有动态变量必须通过 SQL 占位符(如
%s)传递给执行器,由底层驱动负责特殊字符转义。任何用f"INSERT INTO ... VALUES ('{title}')"的写法,只要网页标题中包含单引号(如英文缩写it's)或反斜杠,就会引发语法报错甚至 SQL 注入安全漏洞。 -
确保资源释放与显式事务提交:
操作文件与数据库连接时,必须使用
with上下文管理器包裹,以确保在爬虫遭遇未捕获异常退出时,底层句柄能够自动 flush 刷盘并关闭;在使用 MySQL 时,必须在批次执行后显式调用conn.commit(),否则数据仅留在事务日志中,断开连接后数据将全部丢失。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









