

自学Python常犯的5个误区及避坑指南
针对自学Python学习者梳理的5大核心误区与实用避坑指南,从动手编码机制、知识边界界定、Traceback报错溯源、代码质量与工程交付等方面给出具体可执行的改进路径。
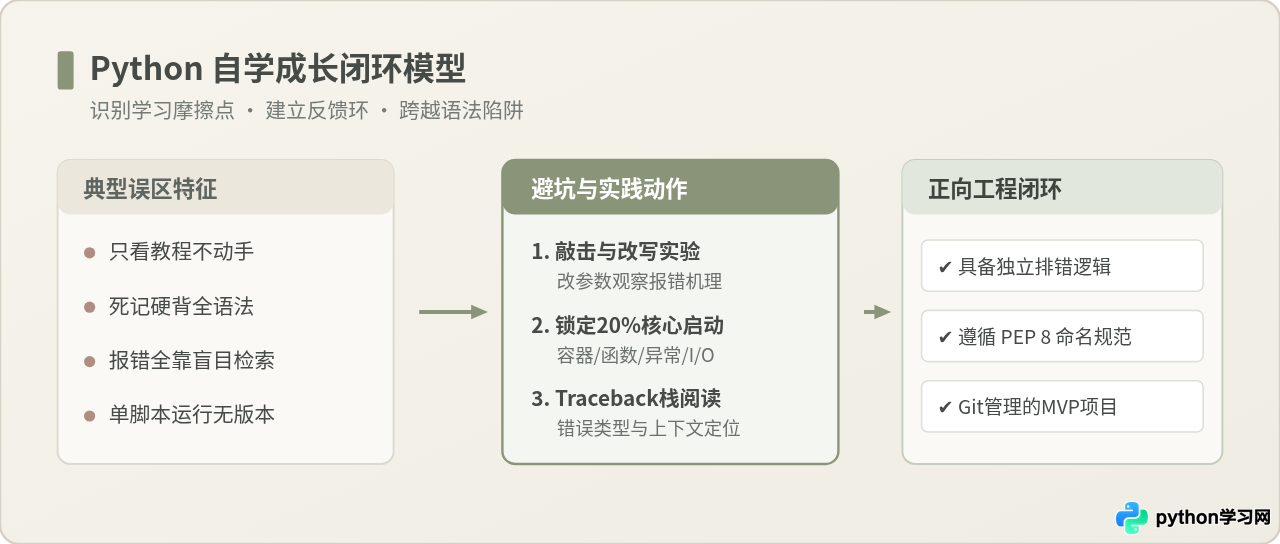
误区一:只看视频与整理笔记,缺乏脱敏动手与破坏性实验
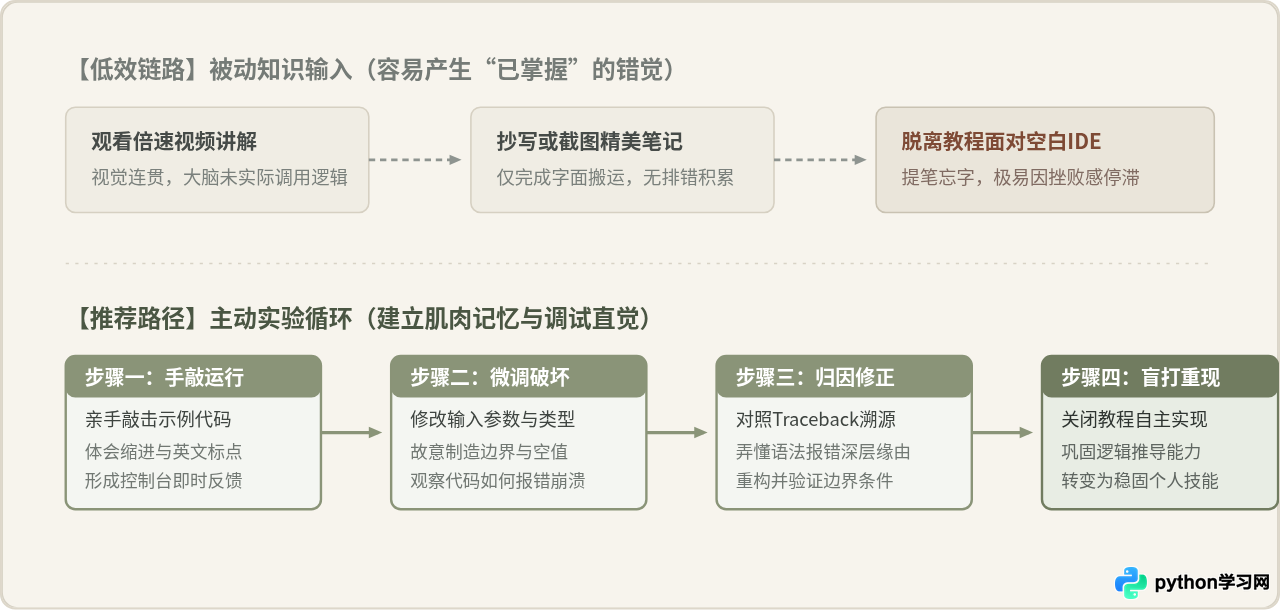
很多自学者在初学阶段习惯将时间花在两倍速刷视频教程或用笔记软件摘录语法规则上。这种做法之所以让人感觉良好,是因为观看讲师调试好的现成代码时,思路连贯流畅,大脑会产生“我已经完全听懂”的顺畅感。整理条理清晰的笔记也能带来即时成就感。
问题所在:编程是一门高度依赖手部肌肉记忆和异常排错直觉的技能。单纯的“看懂”只建立了概念记忆,并未激活将逻辑转化为语法符号的神经回路。当脱离教程面对空白的代码编辑器时,初学者往往会因为忘记英文标点、缺少缩进或拼写错误而频繁报错,从而产生强烈的挫败感并中途放弃。
避坑指南与具体做法
建立“输入与动手 1:1 原则”,并引入微小的改写实验。不要满足于原样复制运行讲师的代码,而是按照以下步骤主动打破代码:
- 逐行手敲:关闭复制粘贴功能,在本地编辑器中亲手敲击每一行示例,严格观察 Python 缩进与冒号的使用。
- 主动进行破坏性测试:在代码运行成功后,故意传入异常参数(如把整型改成字符串、给函数少传一个参数、传入空列表等),观察控制台返回什么错误信息。
- 独立盲打重现:关闭教程窗口,仅凭题目需求重新从零编写一遍刚才的逻辑,直至能够自主调通。
def calculate_discount(price: float, discount_rate: float) -> float:
    if not (0 <= discount_rate <= 1.0):
        raise ValueError("折扣率必须在 0 到 1.0 之间")
    return round(price * (1 - discount_rate), 2)

# 正向验证
final_price = calculate_discount(199.0, 0.15)
print(f"最终价格: {final_price}")

# 破坏性实验:传入非法范围观察报错机制
# calculate_discount(199.0, 1.5)
误区二:陷入“语法囤积症”,试图背下全套标准库再开始做项目
很多初学者总觉得自己的基础不够扎实,认为必须把 Python 的所有内置方法(如字符串的数十种切片替换方法、字典的所有内部操作、冷门的内建函数)甚至高级面向对象特性全背下来,才有“资格”去写一个实际小项目。
问题所在:软件开发是开放式查阅过程,没有任何资深工程师能默写所有库函数。语法如果不置于真实业务场景中反复调用,大脑会在两周内将其自然遗忘。盲目追求“学全”只会无限推迟实践时间,导致长时间停留在新手期。
避坑指南与具体做法
采用二八定律划分知识资产:只将 20% 的核心基础语法作为前置启动资本,其余 80% 的扩展库和进阶模块留在具体的“最小可行项目(MVP)”中按需查阅。
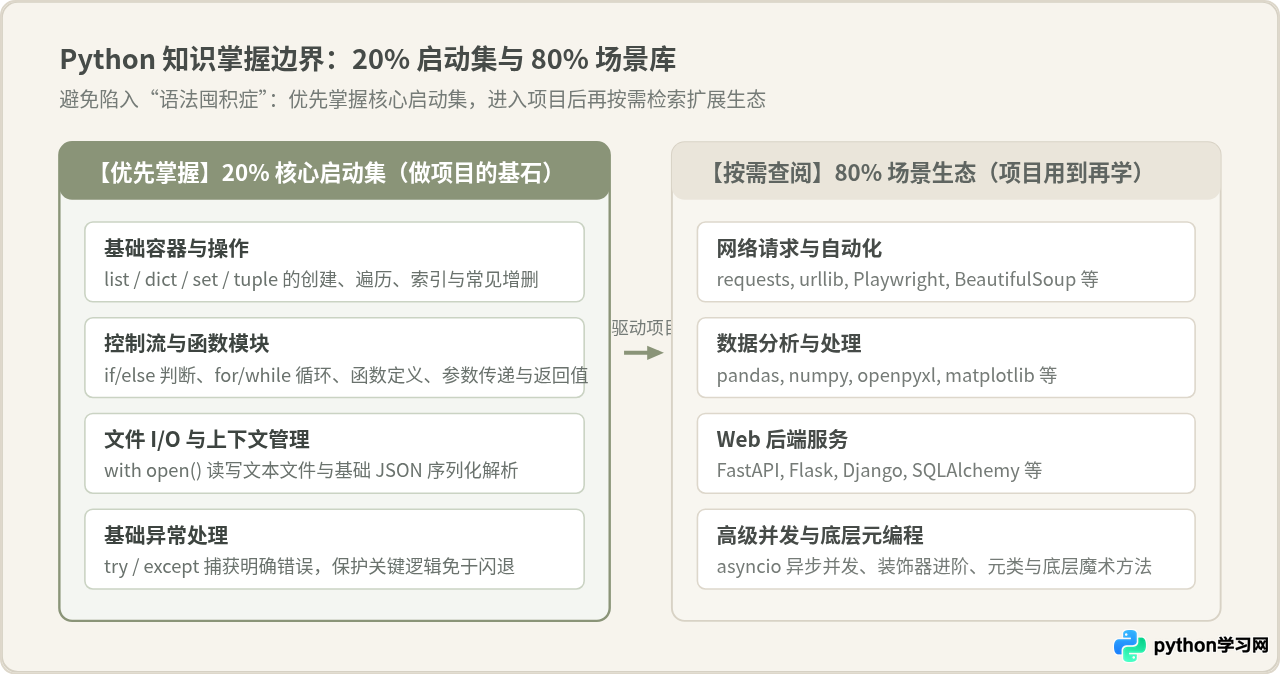
启动一个独立小工具只需要掌握以下核心骨架:
- 核心容器:列表(
list)、字典(dict)、集合(set)的基本增删改查。 - 基础流程控制:
if / elif / else条件分支与for/while循环。 - 函数模块化:明确入参(Arguments)与返回值(Return),做到单函数职责清晰。
- 文件读写与异常:使用
with open()安全读写文本或 CSV 文件,并用try...except兜底未知输入。
一旦掌握上述内容,即可立即动手开发如“本地文本日志关键字统计器”、“个人每日收支账本解析脚本”等微型项目。遇到不熟悉的库函数时,直接查阅官方文档(docs.python.org)或使用 help(obj) 与 dir(obj) 即可。
误区三:遇到报错直接复制机翻搜答案,忽略 Traceback 调用栈精读
终端一旦跳出一长串由红字或堆栈构成的 Traceback,初学者常常心生焦虑,本能地将最后一行复制到搜索引擎或 AI 问答框中。这种方式有时能碰巧拿到一段能用的修复代码,看似提高了解决当次问题的速度。
问题所在:报错信息不是程序的“惩罚”,而是 Python 解释器在用最精准的语言告知“在何处因何种原因违背了运行规则”。直接复制答案绕过了“阅读调用栈—假设原因—验证变量”的关键思维训练。脱离了现成答案,初学者换一个业务场景依然无法独立定位最基础的空值或类型错误。
避坑指南与具体做法
掌握“Traceback 标准排查三步法”,从终端给出的堆栈中逐步提取案发线索:
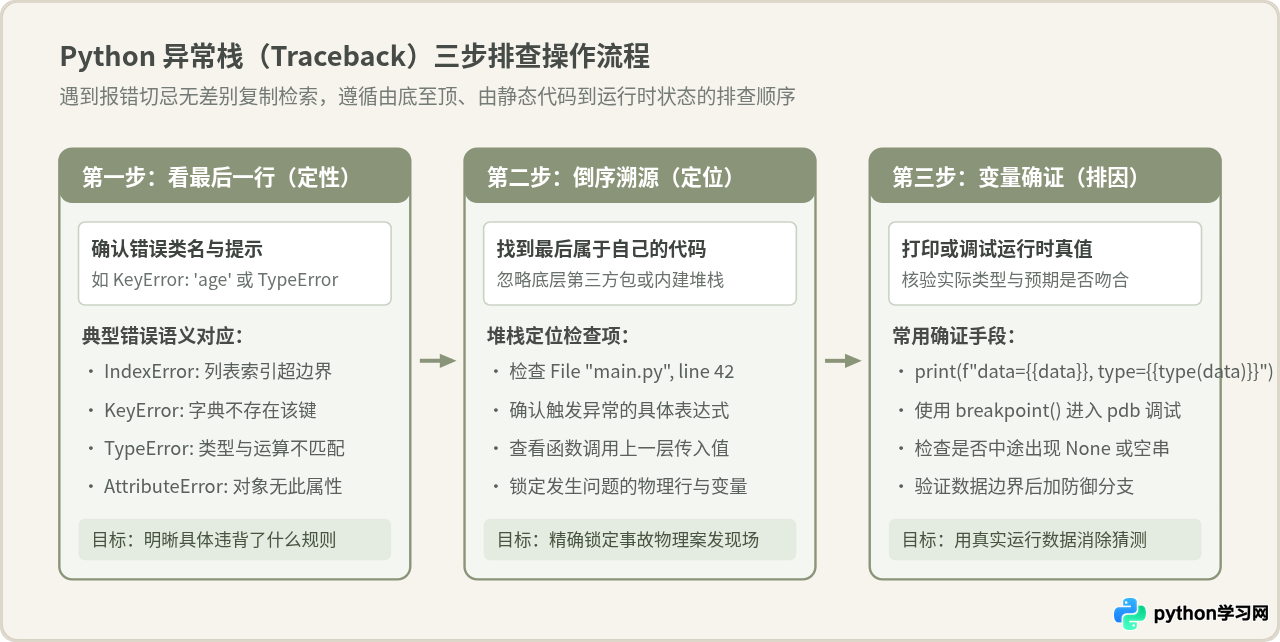
- 第一步:看最后一行确定异常类型(定性):确认是类型不匹配(
TypeError)、字典找不到键(KeyError)、列表越界(IndexError)还是对象没有该属性(AttributeError)。 - 第二步:自底向上寻找属于自己的那一行代码(定位):Traceback 会从底层调用逐层向上展示,忽略第三方库内部的实现文件,找到最后一行属于自己所编写的
.py文件与具体行号。 - 第三步:确证运行时变量的真实状态(排因):在报错行的上方加入状态打印或断点,打印该变量的当前值与数据类型。
# 模拟待解析的字典配置
server_config = {
    "host": "127.0.0.1",
    "port": "8080",      # 注意:此处从环境或外部读入的是字符串
    "debug": True
}

def start_server(config: dict):
    # 步骤三排查法:在疑似出错前打印真实变量与类型
    port_val = config.get("port")
    print(f"[DEBUG] port 的实际值: {port_val!r}, 类型: {type(port_val)}")

    # 若误写为: if port_val > 1024: 则会报 TypeError: '>' not supported between 'str' and 'int'
    # 正确做法:显式转换并增加防御检查
    clean_port = int(port_val)
    if clean_port > 1024:
        print(f"服务正常监听高位端口: {clean_port}")

start_server(server_config)
误区四:只关注“能跑通”,忽略 PEP 8 规范与基础数据结构复杂度
在练习初期,只要控制台最终输出了想要的数据,新手往往就认为大功告成。变量名随意使用 a、b、data1、temp_val,或者为了判断元素是否存在,直接在数十万个元素的列表(list)里使用 in 循环检索。
问题所在:混乱的代码可读性极差,一周后自己也难以维护;而不恰当的数据结构选择会导致程序在小样本下运行良好,一旦数据量增大到几万条就瞬间卡死或耗尽内存。
避坑指南与具体做法
遵循两项核心基准:代码遵循 PEP 8 命名风格,以及根据操作频次选用合适容器。
- 变量与函数命名:统一使用蛇形命名法(
snake_case),如user_id_list,不使用无意义单字母;常量全大写(MAX_RETRY_COUNT);类名使用大驼峰(DatabaseConnector)。 - 高频成员检索首选集合(
set)或字典(dict):在列表中查找元素的时间复杂度是 O(n),而在集合中基于哈希查找的时间复杂度平均是 O(1)。
# ===== 不推荐写法:命名晦涩且检索复杂度为 O(n) =====
l = ["user_102", "user_503", "user_999"] # 白名单
def c(d):
    res = []
    for x in d:
        if x in l: # 每次都在列表中线性扫描
            res.append(x)
    return res

# ===== 推荐写法:语义明确且利用 set 实现 O(1) 哈希检索 =====
ALLOWED_USER_IDS = {"user_102", "user_503", "user_999"} # 使用 set

def filter_active_users(target_user_ids: list[str]) -> list[str]:
    """根据白名单集合过滤出有效用户,保持线性遍历总体时间为 O(N)"""
    return [uid for uid in target_user_ids if uid in ALLOWED_USER_IDS]
误区五:单文件零散编写,缺乏 Git 版本控制与工程目录闭环
很多自学者电脑桌面散落着 test.py、test2.py、main_final.py、main_really_final.py。他们认为自己只是做练习题或写个几十行的小爬虫,配置 Git 和标准目录是在浪费时间。
问题所在:缺乏版本管理带来的直接后果是一旦修改代码引入隐蔽 bug 且无法撤销时,只能推倒重来;同时,没有依赖文件(requirements.txt)和说明文档,写出来的代码换一台电脑就因缺少依赖或路径错误而无法复现,无法作为求职或交流时拿得出手的作品。
避坑指南与具体做法
为哪怕只有几十行的小工具建立基础的项目骨架(Project Scaffolding)与日常 Git 提交习惯:
my_python_tool/
├── README.md               # 项目作用、安装依赖命令与快速运行示例
├── requirements.txt        # 第三方依赖锁定列表
├── .gitignore              # 忽略 __pycache__、.venv 与本地临时文件
├── src/
│   ├── __init__.py
│   └── core_service.py     # 核心功能业务函数
└── tests/
    └── test_core.py        # 针对核心函数的输入输出测试用例
日常练习建立极简 Git 工作流:
git init:在项目根目录初始化版本仓库。- 每完成一个小功能(例如“跑通数据读取”或“增加异常检查”),立即执行
git commit -m "feat: 实现CSV日志基础读取与校验"保存快照。 - 若调试改乱,可随时通过
git diff对比变动或通过git checkout回滚至上一稳定版本。
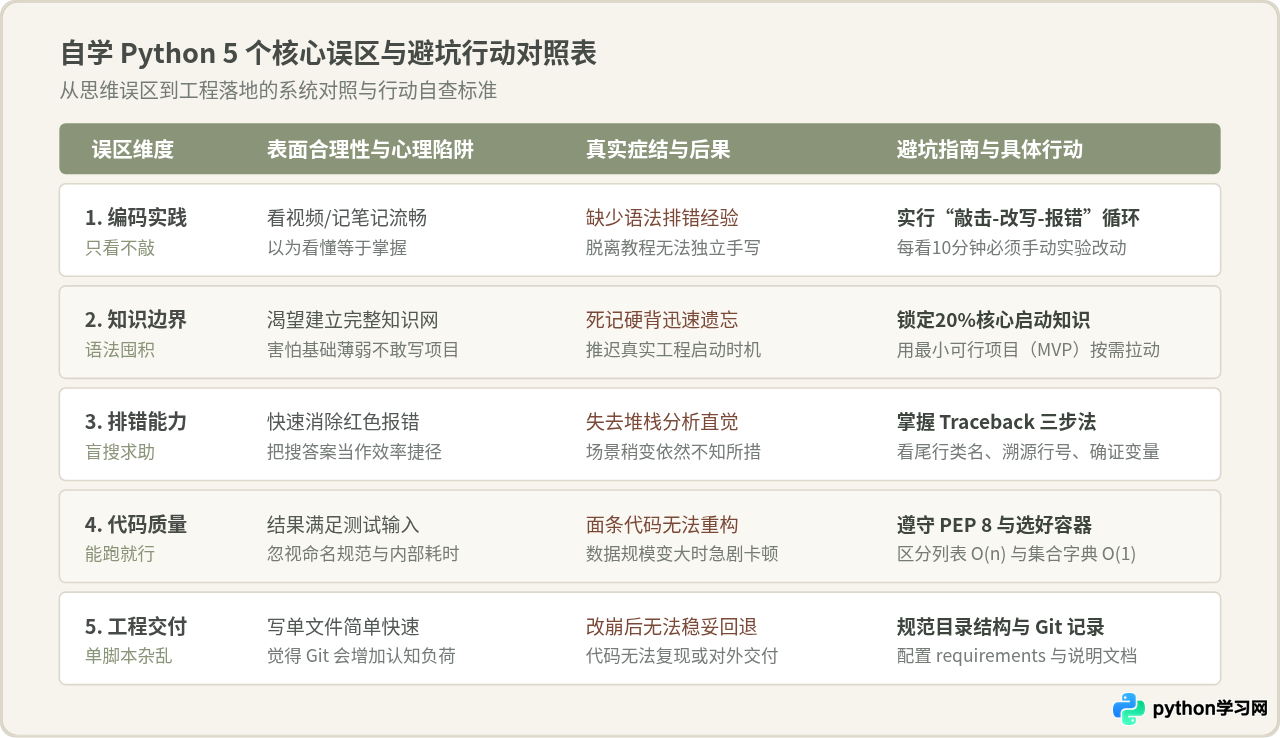
自学 Python 避坑指南全景自查矩阵
以下矩阵汇总了本文阐述的 5 个关键误区、心理诱因及对应的规范行动标准,供自学者在日常学习和项目推进时进行对照自查:
- 编码频率:本周是否保证敲击代码时长不少于观看讲解视频时长的 80%?
- 项目拉动:当前是否有一个正在迭代的最小实用工具,而不是单纯刷语法习题?
- 独立排错:遇到异常时,是否先从最后一行类名和倒数第一条本地代码行号展开分析?
- 代码整洁:函数名与变量名是否能让没有看代码实现的人一眼猜出用途?
- 资产沉淀:代码是否保存在结构清晰的文件夹中并拥有至少 3 次带有明确意图的 Git 提交?
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









