

解决Python NameError:变量名大小写拼写错误排查

在编写 Python 代码时,你可能刚刚定义了一个用于存储用户数据的变量 user_name = "Alice",紧接着在下一行打印 print(userName),程序却立即中断并抛出 NameError: name 'userName' is not defined。这类由标识符大小写或拼写笔误引起的异常极其普遍,核心原因在于 Python 是一门严格区分大小写的解释型语言,解释器在查找变量名时会将 user_name、userName 和 UserName 视为三个完全独立的标识符。本文将从原理机制、回溯信息解析、四步排查法到工程预防进行完整拆解,帮助你快速定位并根治拼写错误。
一、Python大小写敏感机制与命名查找原理
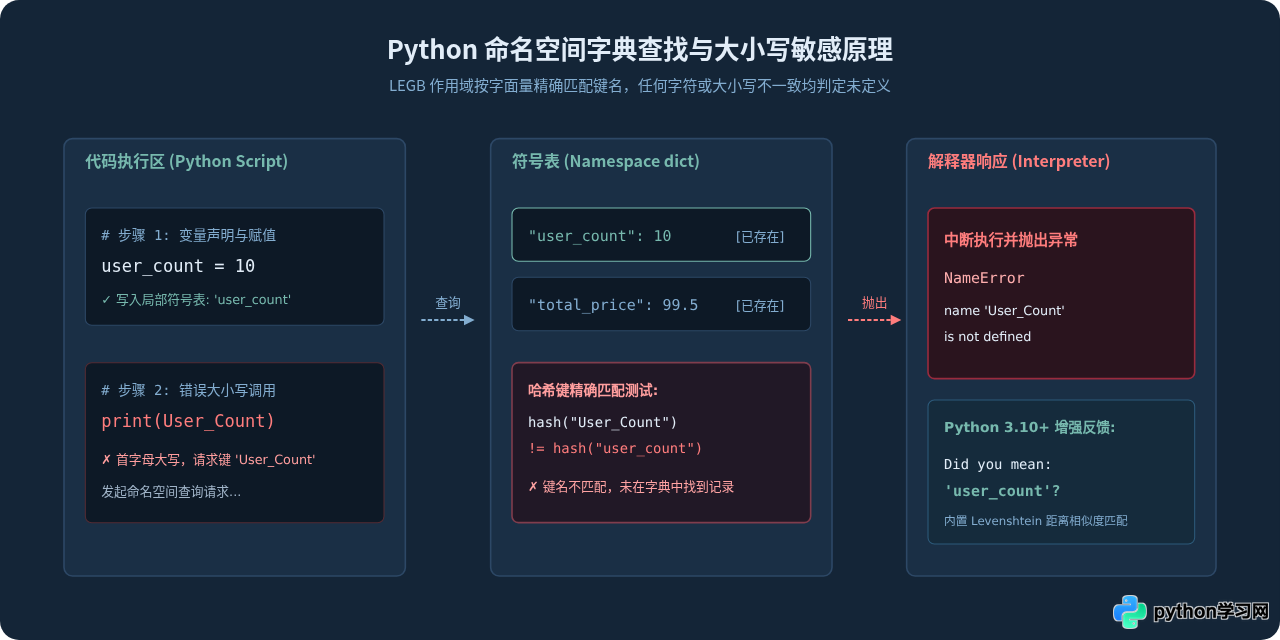
为了理解为什么微小的大小写差异会导致运行时崩溃,需要了解 Python 解释器在执行代码时是如何管理变量的。在 Python 内部,所有定义的变量、函数和类名都以键值对的形式存放在命名空间(Namespace)中,其底层本质是一个哈希字典(Dictionary)。
当执行赋值语句 user_count = 10 时,解释器在当前作用域的命名空间字典中写入键 "user_count"。随后当你尝试读取 User_Count 时,Python 会沿着 LEGB 作用域链(Local 局部 → Enclosing 闭包 → Global 全局 → Built-in 内建)依次检索字典键。因为字符串的哈希匹配要求字符编码完全一致,首字母的大写导致查找直接落空,最终触发 NameError。
二、剖析报错信息:从Traceback精准定位拼写异常
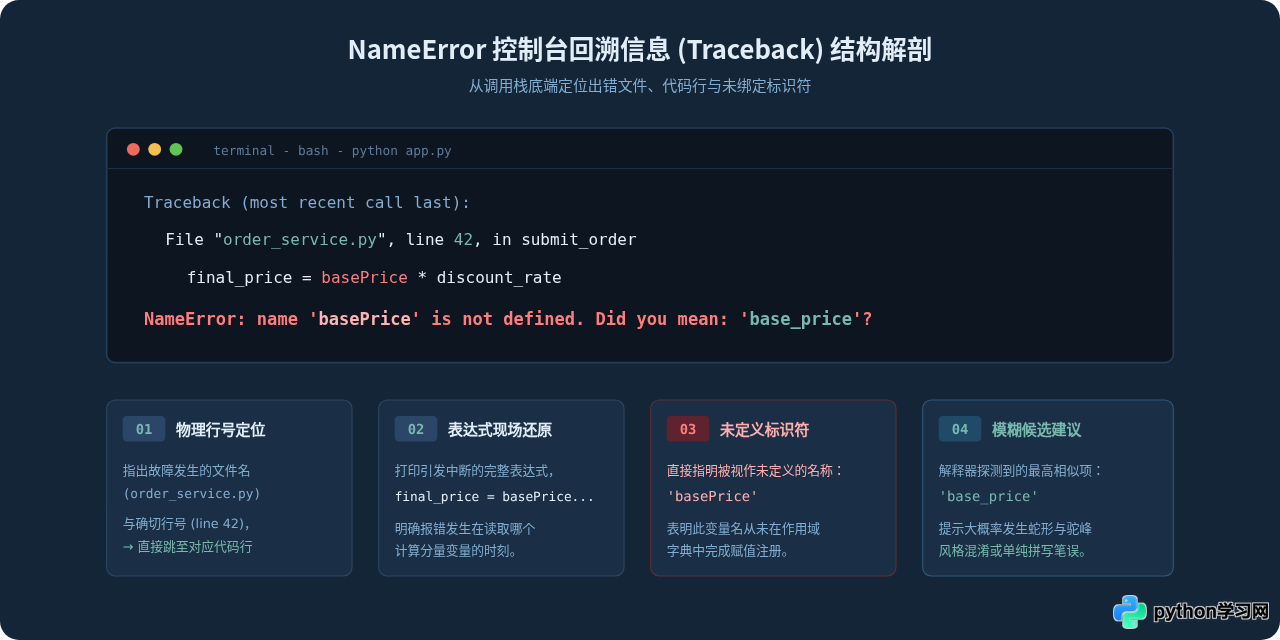
遇到报错时,不要直接猜测代码哪里写错,而是应当自底向上阅读 Python 控制台输出的 Traceback(错误回溯信息)。Traceback 提供了完整的调用栈序列,清晰标明了错误发生的源文件、绝对行号以及引发异常的具体语句。
以下是一段典型的控制台输出示例:
Traceback (most recent call last):
  File "data_processor.py", line 18, in calculate_average
    total = sum_values / item_Count
NameError: name 'item_Count' is not defined. Did you mean: 'item_count'?
在上面的示例中,Python 3.10 及更高版本引入了非常实用的改进:当解释器因未找到变量而抛出 NameError 时,它会自动扫描当前作用域内已存在的变量,并通过计算编辑距离评估相似度。如果发现存在大小写或个别字母微调匹配的候选词,便会给出类似 Did you mean: 'item_count'? 的智能补全建议。
三、实操步骤:变量名拼写排查四步法
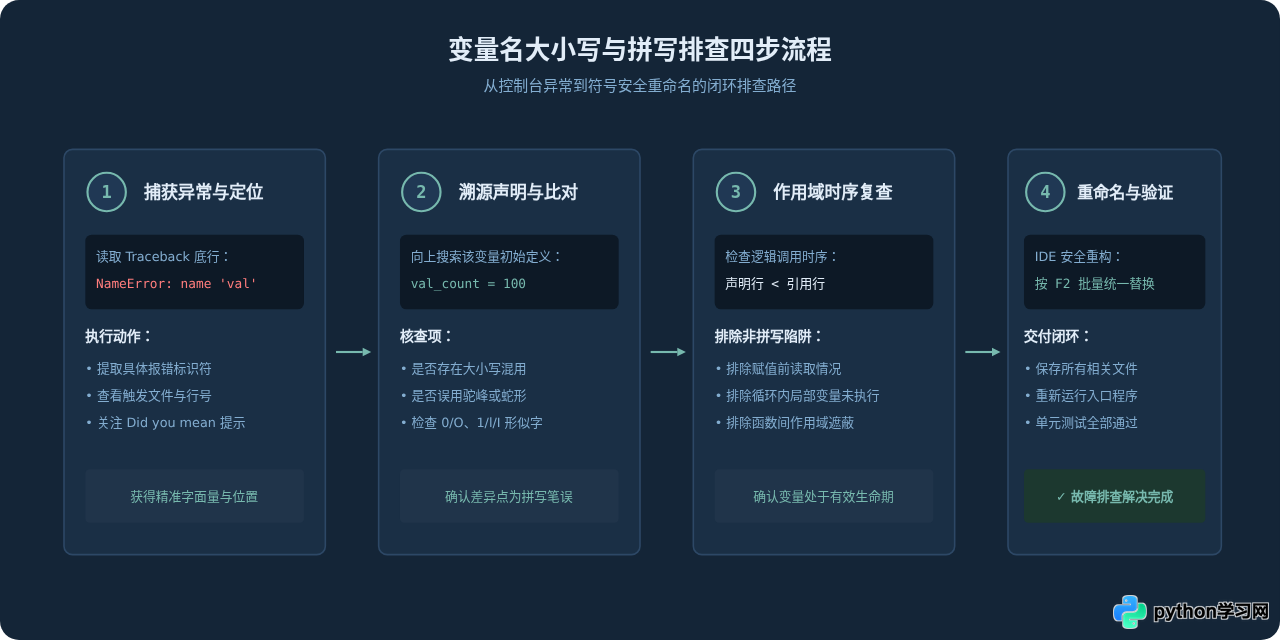
排查 NameError 时,应建立标准化、可复现的排查链路,而不是随意修改变量名字尝试运行。按照以下四个步骤,可以在一分钟内彻底排查并修复绝大多数拼写类问题:
第 1 步:核对 Traceback 终端行,提取目标变量字面量
在报错输出的最后一行找到类似 name 'xxx' is not defined 的标识符。必须原原本本地记录该标识符的每个字符,包括是否有下划线、字母的大小写等细节。例如报错给出的是 payload_Length,就要注意 L 是大写。
第 2 步:逆向检索定义点,核对字符一致性
在编辑器中打开报错文件,使用快捷键跳转至报错行(例如快捷键 Ctrl+G 或 Cmd+G)。从报错行向上检索该变量最初在何处被赋值。通常会发现以下几种典型不一致:
- 风格混淆(驼峰 vs 蛇形):定义时遵循了 PEP 8 规范写成了
payload_length,调用时下意识使用了 JavaScript 常见的驼峰命名payloadLength。 - 首字母大小写混淆:定义为
student_score,引用时写成了Student_score或Student_Score。 - 同音或形似字符:例如小写字母
l与数字1混淆,大写字母O与数字0混淆,或者字母顺序微调(例如lenght与length)。
第 3 步:确认作用域有效性(未提前引用)
即使拼写完全一致,如果调用发生在赋值之前,解释器依然会报 NameError。确保变量的赋值语句在物理执行顺序上位于读取语句之前,并且在同一个函数作用域内有效。
第 4 步:使用编辑器重构功能统一修改并复测
不要手动去每一个地方修改变量名,避免漏改引发新的未定义错误。在 VS Code 或 PyCharm 等现代 IDE 中,将光标置于正确定义的变量名上,按下 F2(重命名符号 / Rename Symbol),IDE 会安全地同步替换当前作用域内的所有同名引用。修改后重新运行测试脚本,确认报错解除。
四、常见代码反例与重构修复对比
为了让排查更加直观,我们来看三个日常开发中最容易误触大小写陷阱的典型场景:
场景 1:蛇形命名(snake_case)与小驼峰命名(camelCase)混杂
# 【错误示例】
def generate_report(user_id):
    user_info = fetch_user_data(user_id)
    # 错误:定义时使用了 snake_case,在此处使用了 camelCase
    print(userInfo["name"])  # 触发 NameError: name 'userInfo' is not defined

# 【正确修复】
def generate_report(user_id):
    user_info = fetch_user_data(user_id)
    print(user_info["name"])  # 严格保持同一种命名风格
场景 2:首字母大写导致的类与变量混淆
# 【错误示例】
class OrderManager:
    pass

order_manager = OrderManager()
# 错误:本意调用实例,却将首字母大写误当成了实例变量
Order_manager.process()  # 触发 NameError: name 'Order_manager' is not defined

# 【正确修复】
order_manager.process()  # 遵循实例对象全部小写的惯例
场景 3:Jupyter Notebook 单元格执行顺序导致的“伪拼写”错觉
在数据科学与交互式分析场景中,许多人误以为是大小写写错,但本质是单元格未执行。例如,你在上方单元格定义了 dataset = load_csv(),但没有点击运行该单元格,直接在下方运行 print(dataset),控制台同样会报告 NameError。排查时应先观察单元格左侧的执行编号 In [ ] 是否已产生数值。
五、长效预防:规范命名与现代工具链防御
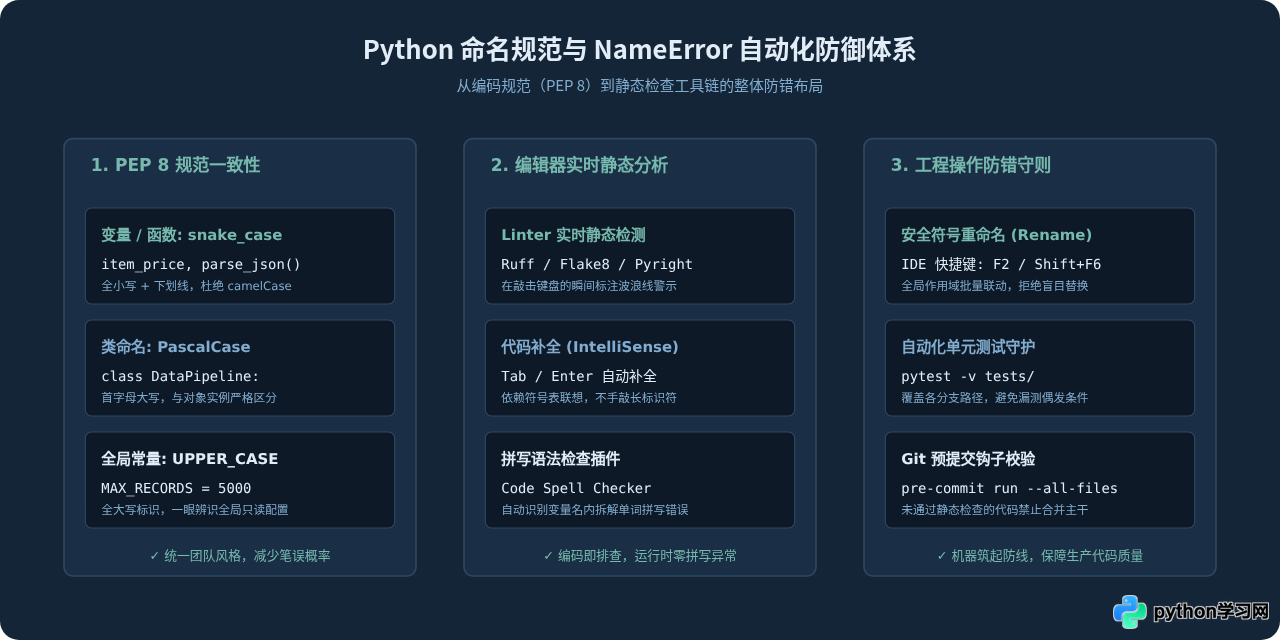
依靠肉眼寻找拼写错误效率极低,建立良好的编码习惯并配置现代化自动化工具,可以在编码阶段就将 NameError 消灭在萌芽状态。
PEP 8 命名法则提醒:
- 普通变量与函数名:统一采用全小写字母,单词之间使用下划线分隔,如
request_count、user_avatar_url。 - 类名:统一采用大驼峰命名法(PascalCase),每个单词首字母大写,如
UserProfile、HttpRequest。 - 模块级常量:统一采用全大写字母加下划线,如
MAX_RETRY_COUNT = 3。
在工程层面,推荐通过以下现代工具链形成防御闭环:
- 实时代码检查(Linter):在 VS Code 中安装
Ruff或Pylance,在 PyCharm 中开启静态代码检查。当你在代码中打出未定义的变量名时,编辑器会立即在其下方标出黄色或红色的波浪线告警。 - 代码自动补全(IntelliSense):输入前几个字母后,按下 Tab 或 Enter 接受 IDE 的符号自动补全,坚决避免手动一个字母一个字母地敲打长变量名。
- 拼写检查插件:安装
Code Spell Checker等插件,当变量名中出现拼写不符合词典的异常组合时,插件会提供视觉提醒。
六、总结
遇到 NameError 并不可怕,它是 Python 解释器在严格维护命名空间边界和作用域秩序。解决此类问题的关键,在于不盲目猜测、善读 Traceback 栈底信息、保持 PEP 8 命名规范一致性,并充分借力 IDE 自动补全和 Ruff 等现代化静态检查工具。只要将这些排查与预防习惯融入日常开发流程中,便能在几秒内化解大小写拼写引发的异常,写出更严谨健壮的 Python 程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









