

Dify的核心优势:可视化编排怎么降低大模型开发门槛
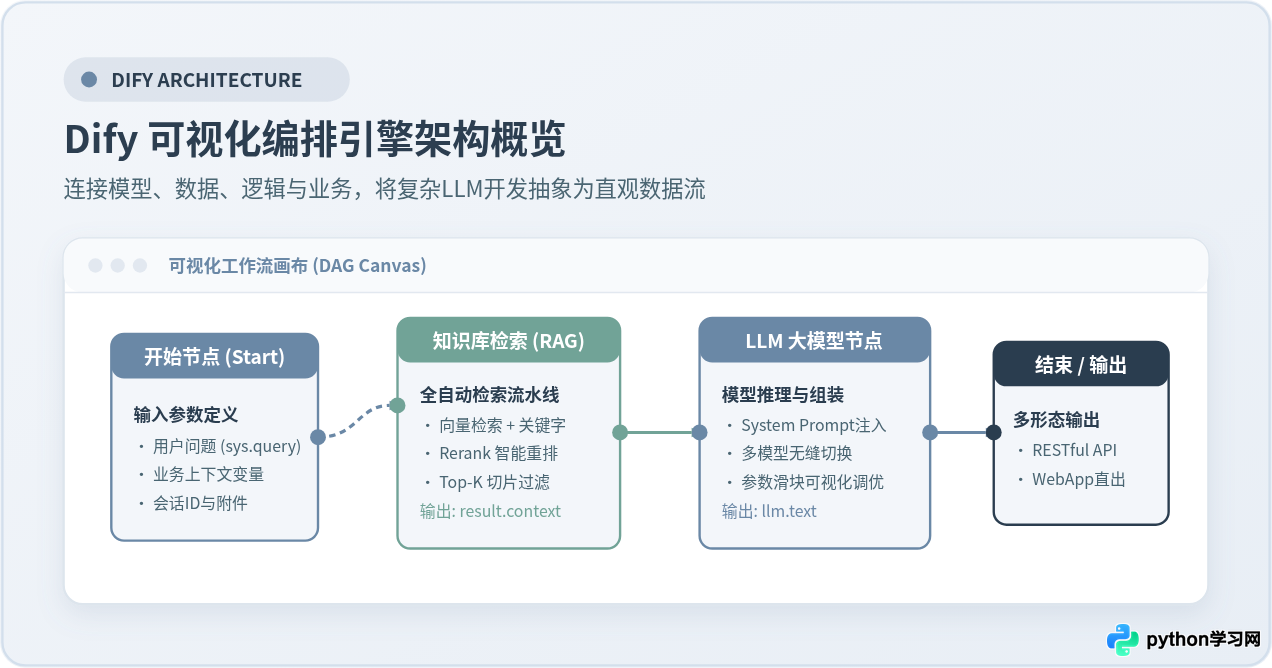
深入解析Dify可视化编排如何将复杂的提示词管理、RAG知识库检索、多分支逻辑与工具调用抽象为直观的DAG节点,从底层机制、操作步骤到协同维护,全面阐述其降低大模型应用开发门槛的核心优势。
一、传统代码开发与Dify可视化编排的本质差异
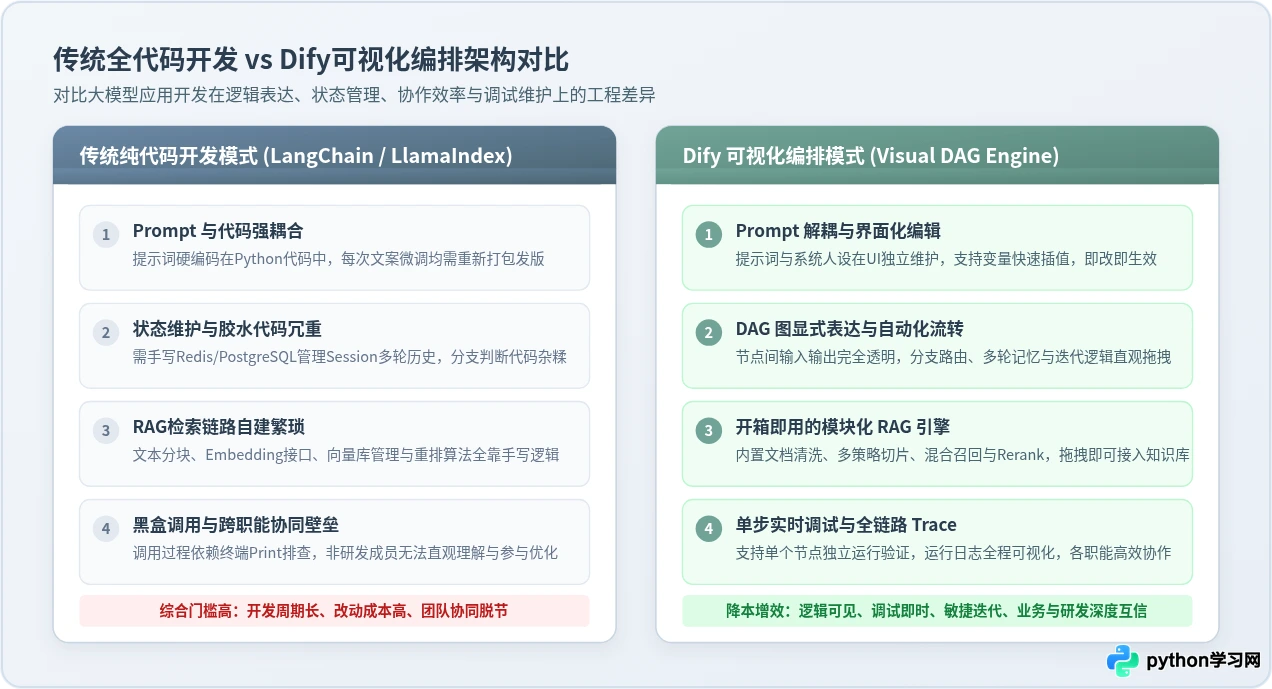
在以 LangChain 或 LlamaIndex 为代表的纯代码开发时代,构建一个具备实用价值的大模型应用往往意味着沉重的软件工程负担。开发者不仅需要调用大模型接口,更需要编写大量的“胶水代码”来处理多轮对话的上下文窗口、实现复杂的条件路由、对接向量数据库并手动拼装Prompt。
这种硬编码模式在实际工程实践中暴露出了三个无法忽视的门槛:
- Prompt与逻辑代码紧密耦合:提示词常常直接以硬编码字符串的形式散落在Python脚本中。一旦业务侧需要微调人设或输出格式,就必须经历完整的修改代码、跑测试用例、代码评审以及重新打包上线的冗长流程。
- 状态流转与分支控制不可见:多轮问答的历史记录需要开发者自行在Redis或关系型数据库中设计Session管理机制。当链路中引入IF/ELSE意图分支或工具调用时,代码复杂度呈指数级上升,调试几乎完全依赖控制台的日志打印。
- 跨职能协作断层:对业务场景最熟悉的产品经理、领域专家和运营人员无法直接接触代码,任何需求调整都必须经过多轮沟通转译,极易出现理解偏差与交付延期。
Dify 的核心突破在于采用有向无环图(DAG,Directed Acyclic Graph)将这些隐式、线性的代码逻辑彻底“实体化”。每一个功能单元被封装为一个独立的节点,数据输入与输出通过明确的引脚进行连线,将原本黑盒的调用链转变为任何人都能一目了然的可视化拓扑图。
二、核心机制:可视化编排如何组织数据流与节点状态
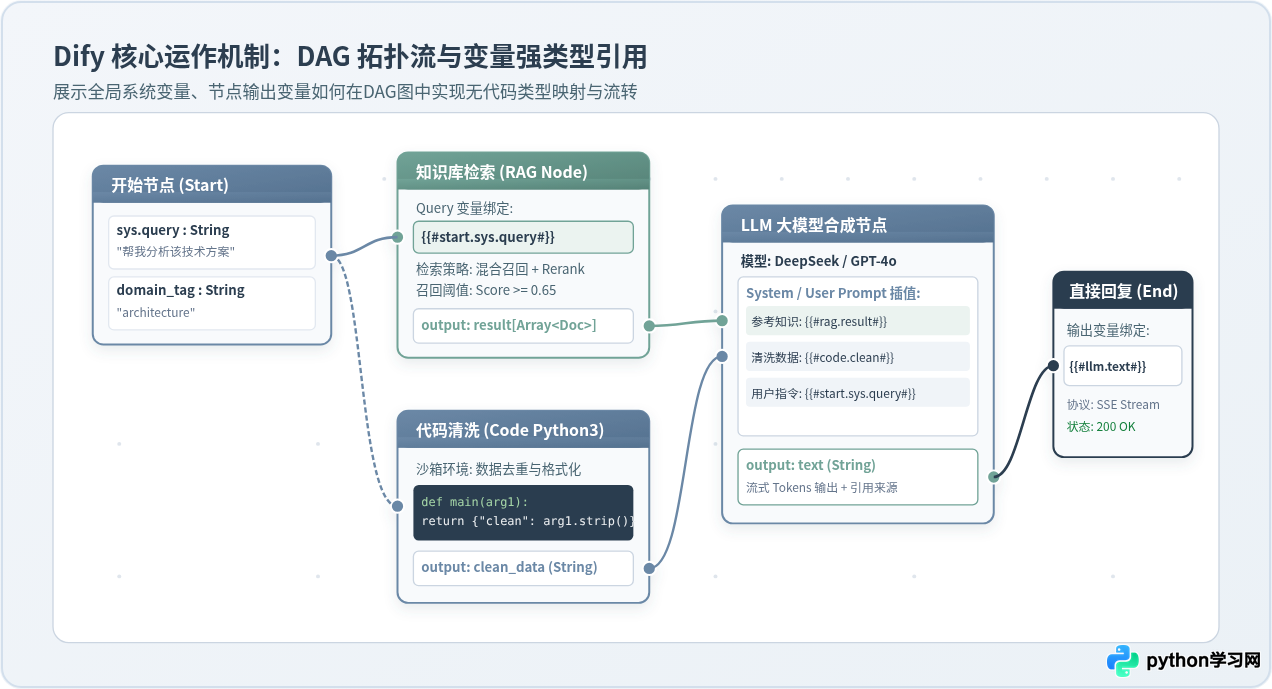
许多初学者常误以为可视化编排只是简单的“低代码UI外壳”,但Dify之所以能支撑企业级复杂场景,关键在于其严谨的底层数据拓扑设计与变量类型管理系统。
1. 显式输入输出契约与强类型引用
在Dify画布中,每个节点都不是孤立的界面卡片,而是拥有严格的输入(Inputs)和输出(Outputs)定义的Schema执行单元。当上游节点执行完毕后,其产生的结构化数据(如文本字符串、对象字典、文件列表或文档数组)会被打上唯一的节点命名空间标签。
下游节点在消费数据时,无需在代码中通过复杂的数据下标解析JSON,只需在面板中通过可视化的变量拾取器直接引用。例如,在提示词输入框中输入 {#1712034.text#} 或 {#rag_node.result#},即可在运行时自动完成数据绑定的变量插值替换。
2. 全局环境与会话变量(Environment & Conversation Variables)
除了节点间的局部变量传递,Dify还原生提供了系统级变量容器:
- 系统预置变量(System Variables):包括终端用户的提问内容(
sys.query)、发起请求的用户标识(sys.user_id)、会话标识(sys.conversation_id)以及用户上传的多模态文件列表(sys.files)。 - 会话记忆(Conversation Memory):传统开发中极度头疼的“历史对话滑动窗口”在Dify中被封装为内置机制。开发者只需在LLM节点中开启“Memory”开关并设置轮数窗口,系统便会自动加载关联的历史问答并注入Prompt。
3. 条件分支与循环迭代机制
现实业务往往不是单线进行的。Dify的可视化编排提供了两大结构控制节点:
- 条件分支(IF/ELSE):支持基于上游变量的数值、字符串匹配(包含、等于、正则等)或布尔状态进行多路路由分流,例如当检索返回的分数低于阈值时,自动引导至人工客服或兜底回答分支。
- 迭代节点(Iteration):当上游输出的是一个列表(例如搜索返回的5条新闻链接、批量处理的一组表格行数据)时,迭代节点允许在画布内部对列表项进行循环处理,并将多轮结果聚合后输出,彻底消除了手写
for循环的编码门槛。
三、关键节点深度解析:消解传统大模型开发的硬门槛
Dify 将大模型生态中最为碎片化、门槛最高的几大工程模块,沉淀为了标准化的功能节点:
| 节点类型 | 解决的核心工程痛点 | 可视化配置项与关键特性 | 适用业务场景 |
|---|---|---|---|
| LLM 大模型节点 | 不同模型厂商SDK接口不兼容、参数繁琐 | 可视化下拉切换模型供应商(OpenAI、Claude、DeepSeek等),滑块调节 Temperature 与 Top_P,Prompt变量可视化插值 | 文本生成、意图提取、对话推理、角色扮演 |
| 知识库检索 (RAG) | 向量库连接池配置、切分算法、多路召回与重排 | 一键勾选多个知识库,混合检索模式切换(语义向量+全文关键词),直接配置 Rerank 模型与分数阈值 | 企业知识库问答、产品手册查阅、垂直领域专业助手 |
| 代码执行 (Code) | 纯LLM在数学计算、正则提取、时间格式化上的幻觉与不精确 | 安全容器沙箱支持原生 Python 3 与 JavaScript 运行,定义清晰的入参与返回值类型 | 复杂JSON解析、字符串裁剪、精确时间运算、业务数据结构转换 |
| 工具与HTTP请求 | 调用外部系统需自建后端API桥接层 | 直接导入 OpenAPI/Swagger JSON,可视化填写 URL、请求头与 Query 参数,支持自动鉴权认证 | 查询实时天气、内部CRM/ERP数据查询、触发Webhook通知 |
| 模板转换 (Template) | 多变量混排时容易产生字符转义错误与语法歧义 | 采用轻量级 Jinja2 模板引擎,将复杂结构转化为规范化文本或Prompt片段 | 生成标准化Markdown表格、构建固定格式报告草稿 |
四、实操教学:从零搭建一个复合问答工作流
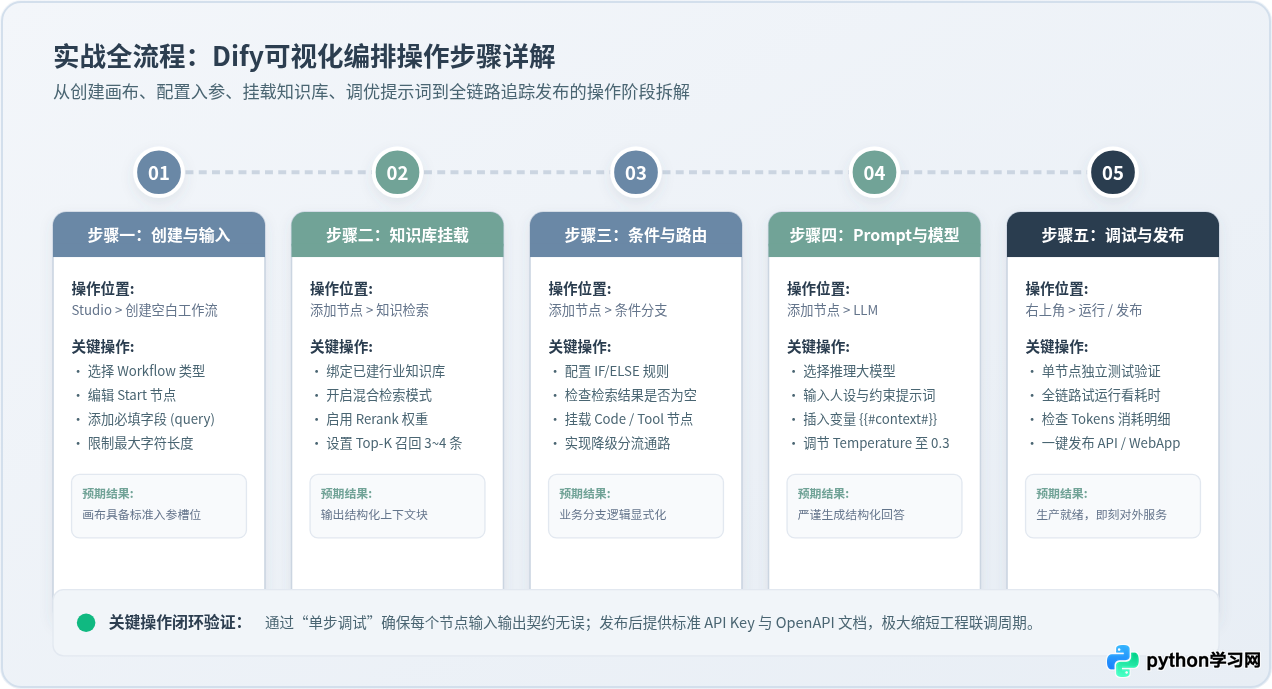
为了让读者直观感受可视化编排的高效性,下面以一个典型的“行业研报智能问答与实时信息补充”工作流为例,演示从创建到发布的完整操作步骤。
进入 Dify 工作台的 Studio 页面,点击“创建空白应用”,在应用类型中选择“工作流(Workflow)”并命名。进入画布后,点击默认的“开始(Start)”节点,在右侧参数面板中添加输入变量:
- 字段名:
user_query,类型:文本(String),标签:“用户问题”,设置为必填。 - 字段名:
industry_category,类型:下拉单选,选项包含“金融科技”、“新能源”、“半导体”,用于后续条件分流。
在画布中点击 Start 节点右侧的“+”连接点,选择添加“知识库检索”节点。在节点配置面板中:
- 关联知识库:勾选提前建立好的“2026行业深度研报库”。
- 检索Query绑定:点击变量选择器,绑定为
{#start.user_query#}。 - 召回策略:选择“混合检索(Hybrid Search)”,并开启重排序模型(如 BAAI/bge-reranker-large),设置召回上限 Top-K 为 3,相似度过滤阈值设定为 0.65。
在大模型分析之前,判断问题是否涉及“实时趋势”或“特定时间”。从知识库节点后拉出连接线,添加“条件分支(IF/ELSE)”节点:
- 分支 A 条件:设置
start.user_query“包含”关键词“最新”或“今日”。分支 A 指向一个 HTTP 工具节点,用于调用外部财经新闻实时 API。 - 分支 ELSE:直接绕过实时工具,进入后续合成环节。
聚合各路数据进入 LLM 节点。在模型选择下拉菜单中指定 DeepSeek-V3 或 GPT-4o,并将 Temperature 设置为 0.2 以保证事实严谨性。在 System Prompt 编辑区输入结构化指导语:
你是一名专业的行业分析助手。请严格根据以下提供的参考资料回答用户问题。
如果参考资料不足以支撑结论,请直接说明“资料中未提及相关信息”,严禁凭空捏造。

【参考研报切片】:
{#knowledge_retrieval.result#}

【补充实时资讯】:
{#http_request.body#}
在 User Prompt 中直接填入 {#start.user_query#},并将 LLM 节点的输出引脚连接至最终的“结束(End)”节点。
点击任意节点右上角的“运行此步骤”按钮,可以单独为该节点输入测试数据并即时查看返回结果,无需等待整个应用从头执行。确认无误后,点击画布右上角的“发布”,即可直接获取该工作流的访问 API Key 与专属 WebApp 预览链接。
五、团队协同与全生命周期维护:消除“隐形门槛”
很多技术团队在评估工具时,往往只关注“最初写出Demo的速度”,却忽视了后续长期维护、测试和调优的“隐形门槛”。在实际业务中,80% 的工作量发生在应用上线后的 Prompt 调优、Bad Case 排查与模型换代上。
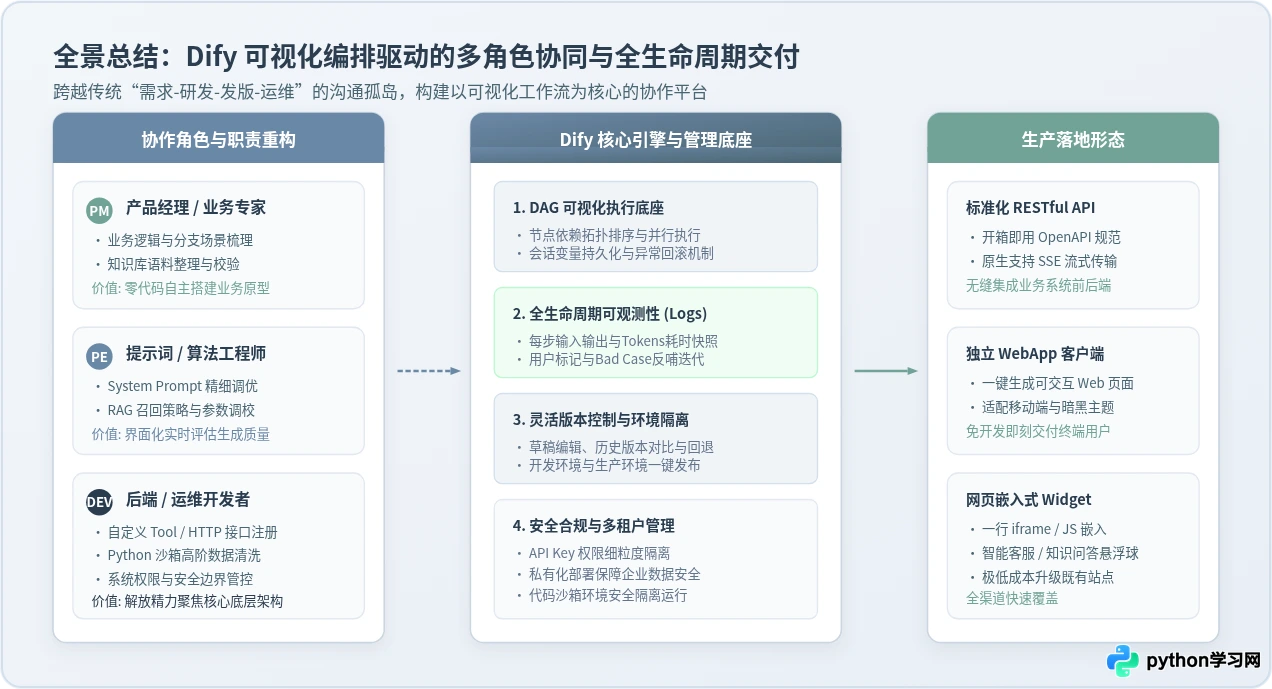
1. 职能解耦与敏捷调优
Dify 的可视化架构从根本上解耦了团队分工:业务经理或提示词工程师可以在画布中直接优化提示词的引导逻辑,或者调整知识库的切片策略;全栈开发者只需专注于编写底层特定的 Tool 插件或接入鉴权。业务侧的改动无需提交 Git 仓库代码、无需重新构建 Docker 镜像,在界面点击“更新发布”即可全量生效。
2. 可视化全链路追踪(Observability & Trace)
在传统代码应用中,当模型给出一个荒谬回答时,排查过程极其痛苦:是用户输入格式异常?还是知识库没有召回相关Chunk?亦或是Prompt插值后超出了上下文截断?
Dify 为每一次运行提供了详尽的 Trace 视图:
- 时间轴与耗时瀑布图:精确记录检索耗时(如 120ms)、外部 API 耗时(如 450ms)以及 LLM 首字延迟(TTFT)与总耗时。
- 快照回放:点击任意历史请求,可以完整查看该次运行中每一个节点接收到的原始输入与产出的真实输出,连同 Token 消耗数量一并清晰呈现,极大加速了 Bad Case 的定位效率。
六、常见配置误区与最佳实践排坑指南
尽管可视化编排大幅降低了技术门槛,但在实际搭建工作流时,若缺乏工程化思维,仍容易陷入以下几个典型误区:
初学者常常习惯于在一个 LLM 节点的提示词中写满各种复杂的逻辑要求(“如果用户问A,你就回答X;如果用户问B,你就按格式Y输出...”)。这极易引发模型遵循能力下降与逻辑混乱。
正确做法:遵循“单一职责原则”,利用 Dify 的条件分支或“问题分类器(Question Classifier)”节点,将意图识别与具体任务回答拆解为不同分支节点,让每个模型节点只承担简明的专注任务。
为了避免遗漏信息,部分用户将召回数量设为 10 甚至 20 个切片,这不仅会导致 Token 消耗成倍增加,还会引入大量低相关度噪点,造成模型的“迷失中间(Lost in the Middle)”现象。
正确做法:开启 Rerank 模型,将初筛召回设为 10~15 条,重排后精选保留最优质的 Top 3~4 条切片传递给 LLM 节点,同时设置严格的相关度过滤阈值。
当某些条件分支未命中时,对应节点的输出变量可能为
null 或空字符串。如果下游节点直接引用该变量而未作判空,可能导致整个工作流运行时报错中断。
正确做法:在关键汇聚节点之前,使用 Code 节点对关键参数提供默认兜底值,或在分支逻辑中确保每条通路都有合法的输出映射。
七、总结
Dify 的核心价值并不仅仅在于“省去了几行代码”,而在于用工业级的可视化规范重构了大模型应用的工程协作范式。
它把深奥的提示词工程转化为可视化的表单与变量插值,把复杂的 RAG 算法沉淀为开箱即用的检索节点,把难以捉摸的多轮会话转变为清晰的状态数据流,并通过即时单步调试与全链路可观测性消除了跨角色的沟通鸿沟。无论是需要快速验证产品原型的个人开发者,还是追求敏捷迭代与高可用落地的企业团队,Dify 的可视化编排都提供了一条从概念直达生产的最短路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









