

Python怎么定义数组:列表list与array模块的区别
深入解析Python中如何定义数组,详细对比内置列表(list)与标准库array模块在内存结构、数据类型约束、运行性能及二进制I/O操作上的关键区别与选型策略。
list);若需要以C原生紧凑格式高效存储单一数字类型,则可以使用标准库提供的 array 模块。本文将详细演示这两种定义方式的具体语法与操作流程,并从底层内存布局、数据类型约束、运行性能及二进制持久化等维度剖析两者的本质区别。
一、Python 中“数组”的两种定义方式
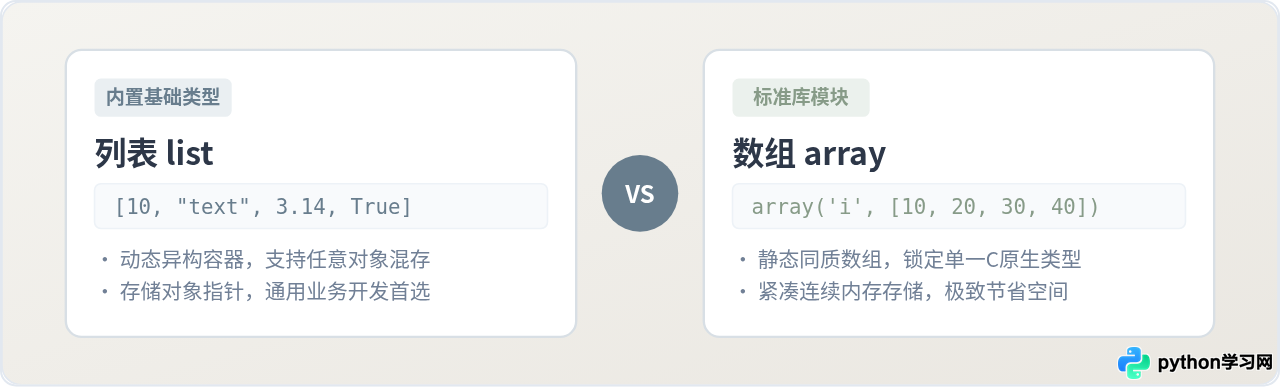
很多初学Python的开发者在寻找类似于C或Java中 int arr[10] 的数组语法时,会发现Python语言核心并没有名为 array 的内置基础关键字。在日常工程实践中,根据场景诉求的不同,主要有两种标准实现途径:
1. 方式一:使用内置列表(list)当作动态数组
列表是Python内置的序列类型,也是最普遍的数组替代品。定义列表只需使用中括号 [],内部元素使用逗号隔开即可。列表长度可变,能够随时动态追加、插入和删除元素。
# 定义存储纯整数的列表
scores = [92, 85, 78, 96, 88]

# 列表支持混合类型(异构性)
mixed_list = [100, "hello", 3.14, True]

# 动态添加元素
scores.append(90)
print("列表内容:", scores)
print("列表长度:", len(scores))列表长度: 6
列表的语法直观简单,但它的灵活性带来了一定的内存开销:列表中存储的并不是实际数值本身,而是指向各个Python对象的引用地址。
2. 方式二:使用标准库 array 模块定义严格类型数组
当需要处理数以百万计的数值,或者需要与C语言API进行内存交互时,Python标准库中的 array 模块提供了真正意义上的连续单精度数组。使用该模块前需要先导入,并在实例化时明确指定一个类型码(Typecode),以此锁定数组中所有元素的原生底层C类型。
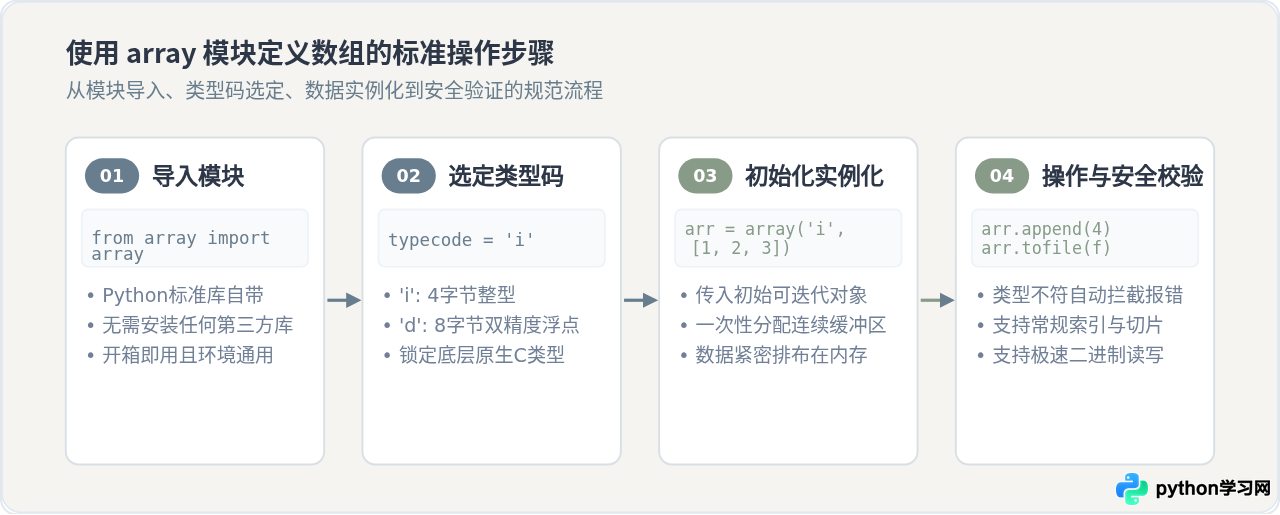
以下是使用 array 模块定义与操作数组的完整示例:
from array import array

# 步骤 1 & 2:指定类型码 'i'(带符号4字节整数),并用初始数据构建数组
int_array = array('i', [10, 20, 30, 40, 50])

# 步骤 3:正常进行索引与迭代
print("第一个元素:", int_array[0])

# 步骤 4:追加相同类型的数据
int_array.append(60)
print("追加后的数组:", int_array)

# 步骤 5:类型安全性检查(若追加不符合类型码的数据将触发异常)
try:
    int_array.append("非法字符串")
except TypeError as err:
print("类型捕获拦截:", err)追加后的数组: array('i', [10, 20, 30, 40, 50, 60])
类型捕获拦截: 'str' object cannot be interpreted as an integer
二、底层内存布局对比:指针引用 vs 原生连续字节
为什么有了列表,Python还要在标准库中保留一个 array 模块?其根本原因在于底层内存组织形态的不同。
在CPython底层实现中,list 本质上是一个变长对象指针数组(PyObject**)。即便你在列表中存入 [1, 2, 3],列表本身只连续存放三个指向各个独立 PyLongObject 对象的指针。每个 PyLongObject 在64位系统中都包含引用计数(8字节)、类型指针(8字节)和数值大小元数据(8字节),导致哪怕只存一个数字1,都需要占用28字节或更多内存,并且内存分布在堆的不同区域,无法充分利用CPU硬件缓存。
与之相反,array.array 直接封装了一块真正的C语言原生连续内存缓冲区(类似C中的 int* 或 double*)。在指定类型码为 'i' 时,每个元素严格只占4个字节,且所有元素紧凑相邻地排列在一起。没有对象头,没有独立引用计数,内存占用仅为列表的几分之一甚至十几分之一。
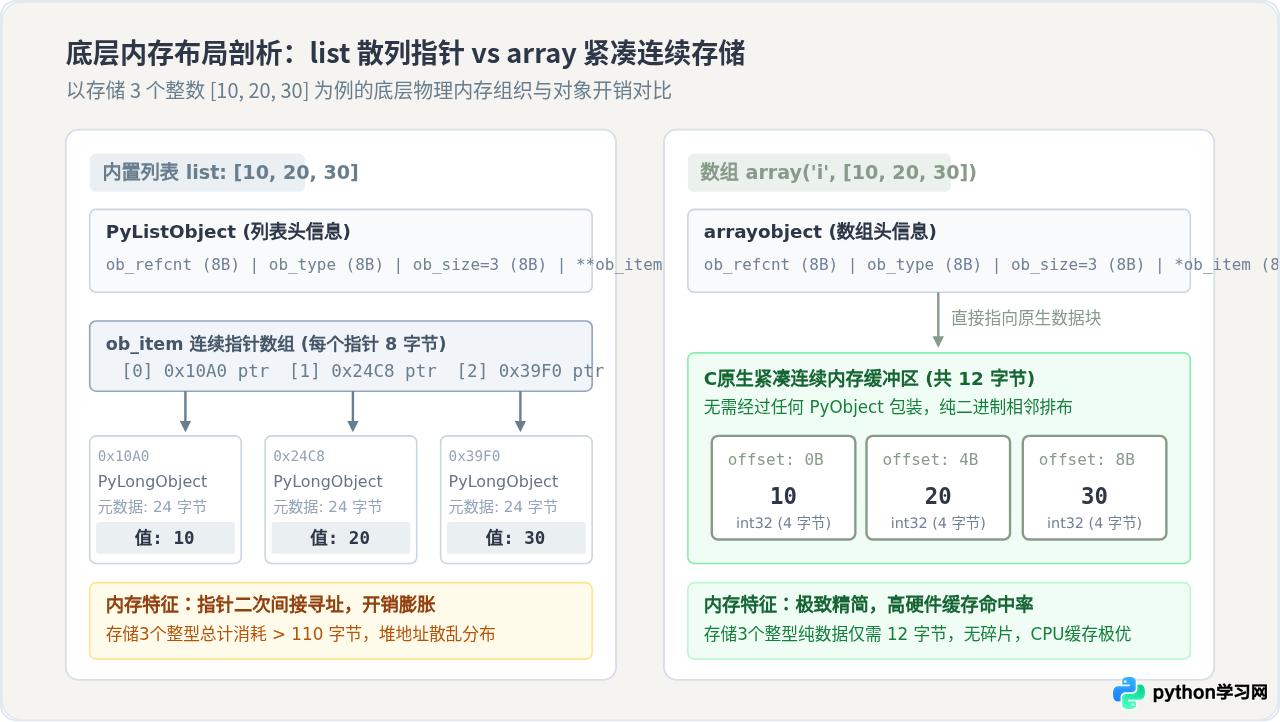
为了直观验证这种内存差异,我们可以通过 sys.getsizeof() 观察两者在存储相同规模数据时的内存开销:
import sys
from array import array

# 构建包含 100,000 个整数的序列
count = 100000
sample_list = list(range(count))
sample_array = array('i', range(count))

list_mem = sys.getsizeof(sample_list)
array_mem = sys.getsizeof(sample_array)

print(f"数据量: {count:,}")
print(f"列表自身指针数组大小: {list_mem:,} 字节 (未计入各个整数对象本身的内存)")
print(f"array 模块数组总大小: {array_mem:,} 字节 (已包含全部实际数值)")列表自身指针数组大小: 800,984 字节 (未计入各个整数对象本身的内存)
array 模块数组总大小: 400,064 字节 (已包含全部实际数值)
sys.getsizeof(sample_list) 仅仅统计了列表容器本身的指针数组开销(约800KB);如果加上10万个独立整型对象本身的内存(每个约28字节,合计约2.8MB),列表实际占用的总堆内存超过3.6MB。而 array 结构存储相同的10万个整数总共仅需约400KB。
三、数据类型约束与类型码机制
list 属于动态类型容器,其内部可以混合容纳任何Python对象,比如同时放入字符串、字典、自定义类实例甚至是另一个列表:
# 列表允许异构存储
mixed_data = ["sensor_A", 1024, 36.5, {"status": "active"}]
而 array 模块严格要求同质性(Homogeneous)。在实例化 array 时必须提供单个字符的类型码,由类型码直接映射到底层C语言数据类型与机器字节长度。
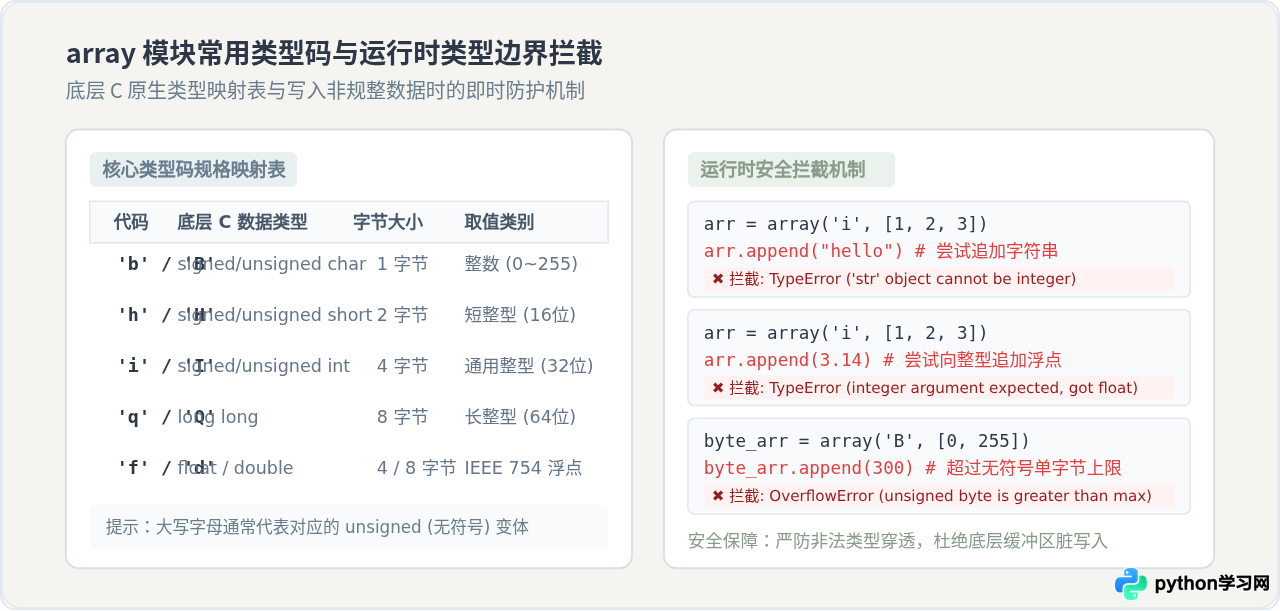
下表整理了 array 模块中最常用的类型码与规格对应关系:
| 类型码 (Typecode) | 对应 C 语言类型 | Python 等效类型 | 最小字节数 | 取值范围与适用说明 |
|---|---|---|---|---|
'b' / 'B' |
signed / unsigned char | int | 1 字节 | -128~127 或 0~255,适用于原始字节流 |
'h' / 'H' |
signed / unsigned short | int | 2 字节 | 短整型,适用于音频PCM数据等 |
'i' / 'I' |
signed / unsigned int | int | 4 字节 | 标准32位整型,通用计数与索引 |
'q' / 'Q' |
signed / unsigned long long | int | 8 字节 | 64位长整型,大时间戳或海量ID |
'f' |
float | float | 4 字节 | 单精度浮点数(32位 IEEE 754) |
'd' |
double | float | 8 字节 | 双精度浮点数(64位 IEEE 754) |
如果在执行过程中向 array 写入了类型不匹配或超出取值范围的数值,Python会在运行时立即抛出 TypeError 或 OverflowError:
from array import array

# 定义无符号单字节数组(范围 0~255)
byte_arr = array('B', [0, 128, 255])

try:
    # 尝试写入溢出数值 256
    byte_arr.append(256)
except OverflowError as err:
print("超出范围异常:", err)四、二进制 I/O 与高效文件持久化
除了节省内存之外,array 模块最具实际价值的功能之一是能够直接与原生二进制字节流相互转换,并支持极高速度的磁盘文件读写。
在日常开发中,如果需要将包含数百万个浮点数的 list 写入磁盘,通常需要通过 json、pickle 序列化,或者遍历将其转换为文本格式,这涉及繁琐的字符串格式化与高昂的CPU开销。而 array 提供了 tofile() 与 fromfile() 原生方法,直接将连续内存缓冲区与文件描述符对接,执行底层直接内存拷贝(Direct Memory Copy)。
import os
from array import array

# 创建包含 500,000 个双精度浮点数的数组
float_arr = array('d', [float(i) * 0.1 for i in range(500000)])

# 直接写入二进制文件
file_path = "sensor_data.bin"
with open(file_path, "wb") as f:
    float_arr.tofile(f)

# 从二进制文件中高速还原数据
restored_arr = array('d')
file_size = os.path.getsize(file_path)
with open(file_path, "rb") as f:
    # 500,000 个 double (8字节),总大小为 4,000,000 字节
    restored_arr.fromfile(f, 500000)

print(f"二进制文件大小: {file_size:,} 字节")
print(f"还原后元素数量: {len(restored_arr):,}")
print("前3个元素验证:", restored_arr[:3])

# 清理临时文件
if os.path.exists(file_path):
os.remove(file_path)还原后元素数量: 500,000
前3个元素验证: array('d', [0.0, 0.1, 0.2])
这种与底层字节缓冲区的天然互通性,使得 array 在网络套接字传输、音频原始采样处理、嵌入式传感器数据接收等场景中具备独特优势。
五、核心维度对比与选型决策指南
在面对具体的开发任务时,究竟应该使用内置的 list,还是使用标准库的 array 模块?我们可以通过以下综合维度对照表与选型决策图快速厘清边界。
| 对比维度 | 内置列表 (list) | 标准库数组 (array.array) |
|---|---|---|
| 使用门槛 | 语言内置,使用 [] 即可直接声明,零心智负担 |
需要导入 from array import array 并熟悉类型码 |
| 类型特性 | 动态异构,支持任何混合类型的Python对象 | 静态同质,必须全为同一种指定基本数据类型 |
| 内存布局 | 散列指针数组,每个元素包含完整的对象头与元数据 | 紧凑连续的C原生内存块,无额外指针和对象头开销 |
| 内存消耗 | 较大(大量小数值时额外消耗显著) | 极小(接近原生C语言内存消耗极限) |
| I/O 与序列化 | 需要通过 pickle/json 或逐项字符串编码 | 内置 tofile() / frombytes() 原生极速二进制流 |
| 数学与向量计算 | 不支持向量化运算(如 list * 2 仅为复制拼接) |
不支持向量化运算(数学运算需循环遍历) |
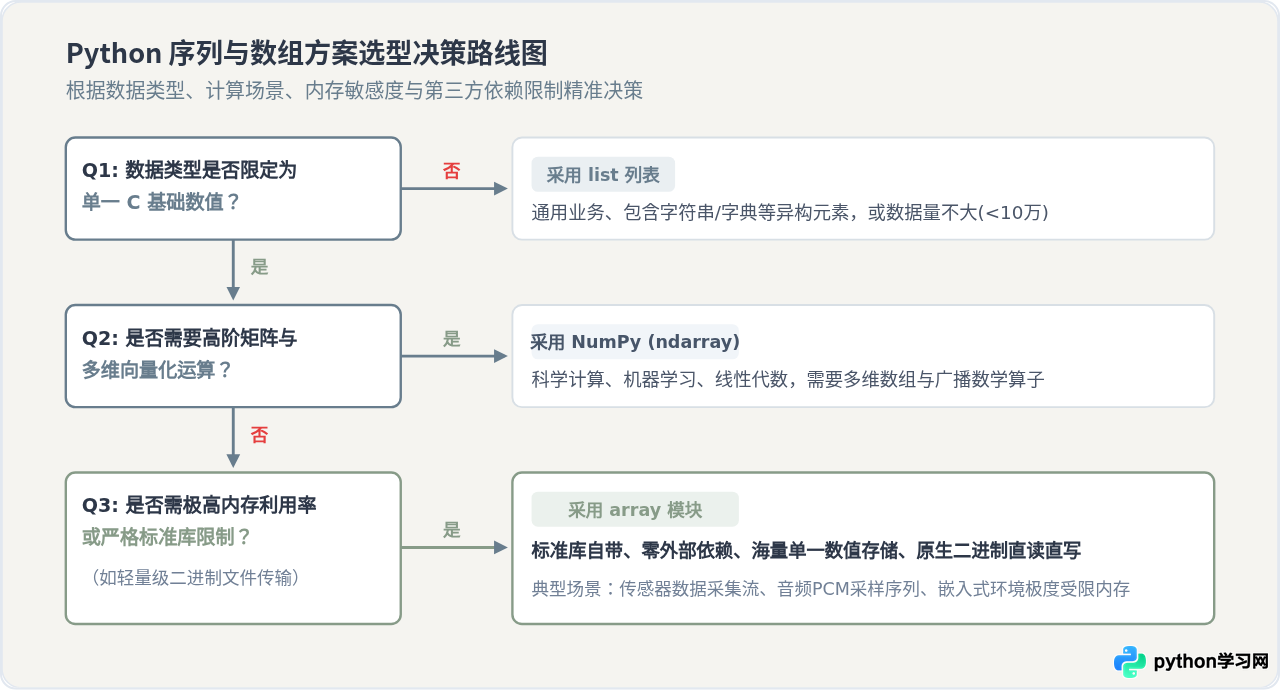
实战选型总结:
- 绝大多数日常业务逻辑:首选内置列表(list)。列表语法优雅,内置丰富的方法(如
sort(),pop(), 列表推导式),开发效率最高,且完全能够满足通用场景的性能要求。 - 海量单一数值存储或纯二进制通信:选择标准库 array 模块。在不需要引入外部第三方依赖、内存资源极其有限、或频繁进行文件二进制字节直读直写的场景下,
array是极具性价比的标准库原生工具。 - 涉及矩阵运算、科学计算与数据分析:引入第三方 NumPy 数组。如果你的核心需求是对数组进行高效的矩阵相乘、广播运算、傅里叶变换等向量化计算,标准库的
array模块并不提供相关算子,此时应直接采用numpy.ndarray。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









