

Python解析嵌套JSON数据并提取深层键值的技巧
深入讲解在Python中解析复杂嵌套JSON数据并安全提取深层键值的实用技巧,包括路径式安全访问、递归键名提取、容错防护与JSONPath高阶过滤方案。
在调用第三方平台 RESTful API 或分析分布式日志时,返回的数据通常是多层字典与列表交织的深层嵌套 JSON。如果目标键藏在第 5 层甚至更深处,且数据中可能出现字段缺失、值为 null 或列表为空等情况,直接使用硬编码连续下标访问(例如 data["res"]["items"][0]["info"]["id"])极易引发 KeyError、IndexError 或 TypeError 导致程序崩溃。本文将完整介绍从静态路径安全提取、动态全树递归搜索到高级表达式查询的实用技巧与防御性编程方案。
一、嵌套结构特征与直接访问的脆弱性
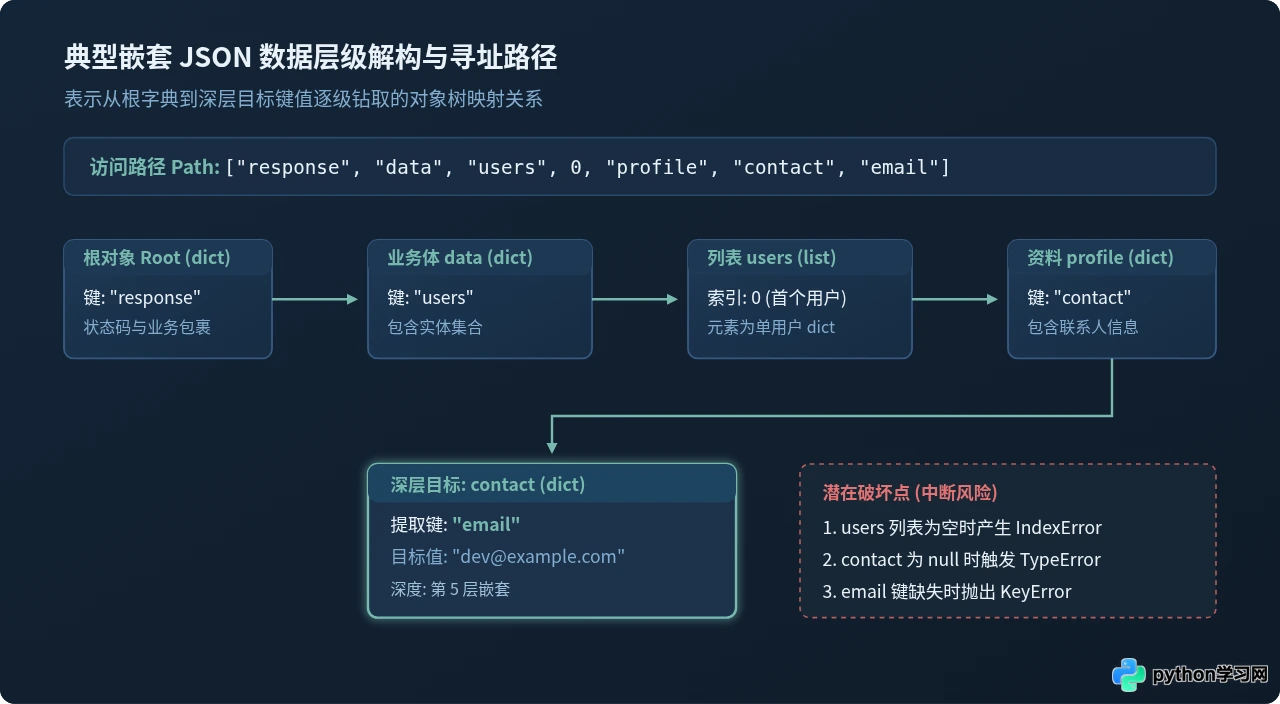
假设我们正在接入一个电商订单接口,其响应报文的结构如下所示。用户信息深嵌在包裹对象和数组列表中,任意一个中间层级都可能在某些特定业务状态下返回空对象或 null:
import json

raw_json = '''
{
  "status": 200,
  "response": {
    "data": {
      "users": [
        {
          "id": 1001,
          "profile": {
            "contact": {
              "email": "dev@example.com",
              "phone": "13800000000"
            }
          }
        }
      ]
    }
  }
}
'''
data = json.loads(raw_json)
如果直接采用下标取值 data["response"]["data"]["users"][0]["profile"]["contact"]["email"],代码能顺利拿到邮箱字符串。但现实业务场景存在三个明显的不确定性风险:
- 列表可能为空:当查询无果时,
"users"是一个空列表[],直接使用[0]会抛出IndexError: list index out of range。 - 中间字段为 null:若用户未完善资料,
"profile"对应的值可能为null(Python 解析为None),后续继续取["contact"]会抛出TypeError: 'NoneType' object is not subscriptable。 - 键名不存在:若某个版本接口将
"data"变更或省略,直接取键将立即抛出KeyError。
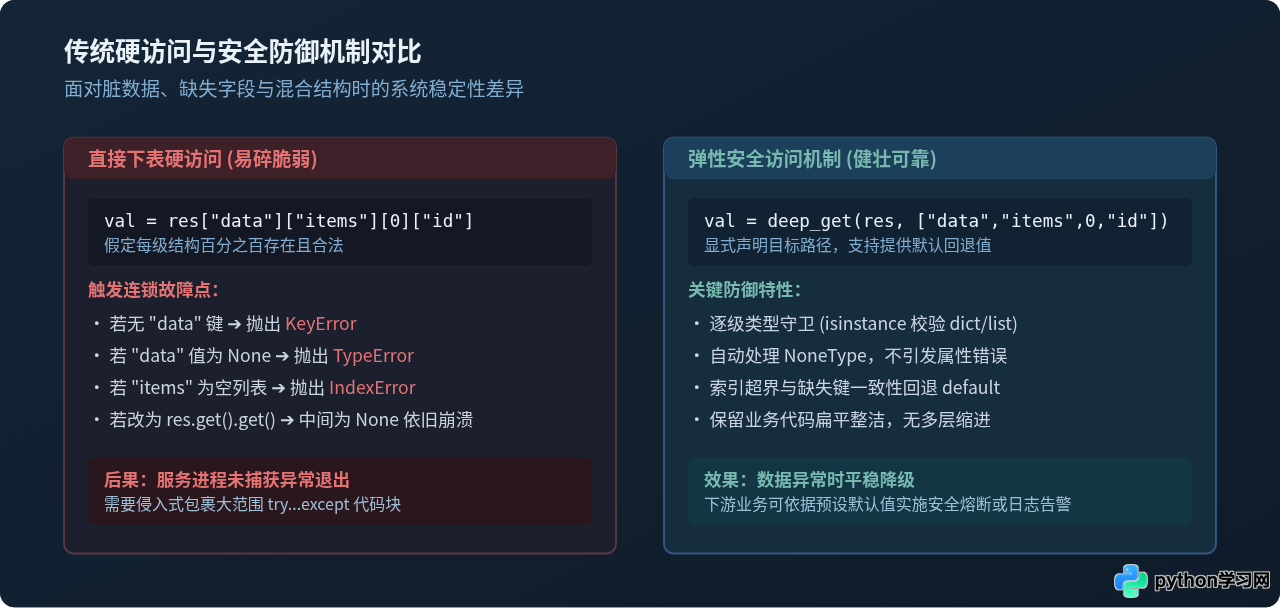
很多开发者习惯使用 data.get("response", {}).get("data", {})。这种写法遇到空值时极易失效:如果 "data" 的值在 JSON 中本身就是 null,那么 data.get("data", {}) 得到的依然是 None,下一个 .get() 会直接触发 AttributeError: 'NoneType' object has no attribute 'get';此外,.get() 也无法直接索引列表元素。
二、实现通用的深层路径安全提取器
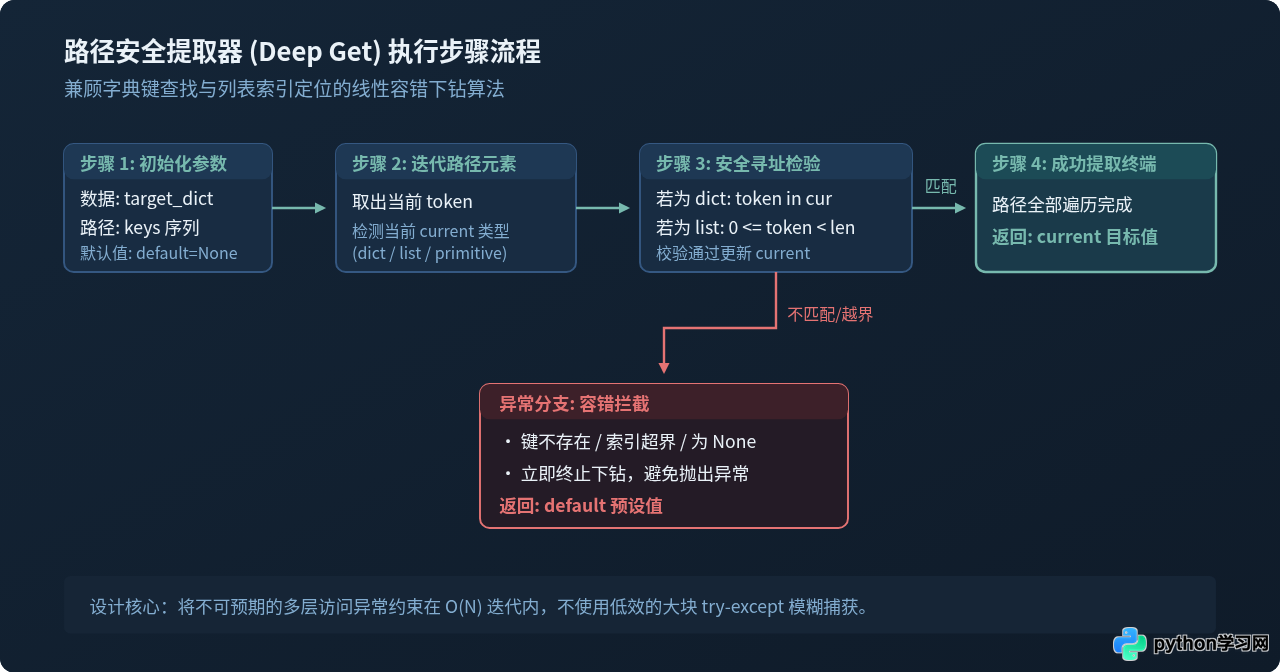
针对固定路径或已知层级结构的深层提取,最优雅的解法是编写一个能够同时兼容字典键与列表索引的路径提取函数。通过线性迭代并结合类型判断,在遇到非法路径或空节点时安全熔断并返回设定的默认值。
1. 核心实现代码
以下 deep_get 函数接收目标数据、路径序列(支持列表或元组)以及可选的默认回退值:
from typing import Any, Sequence, Union

def deep_get(data: Any, path: Sequence[Union[str, int]], default: Any = None) -> Any:
    """
    沿指定路径顺序穿透嵌套字典与列表,安全提取深层值。

    :param data: 待解析的根对象 (dict 或 list)
    :param path: 键或索引序列,例如 ["data", "users", 0, "email"]
    :param default: 寻址失败时的回退默认值
    :return: 目标值或默认值
    """
    current = data
    for token in path:
        if isinstance(current, dict):
            if token in current:
                current = current[token]
            else:
                return default
        elif isinstance(current, (list, tuple)):
            if isinstance(token, int) and 0 <= token < len(current):
                current = current[token]
            else:
                return default
        else:
            # 当前节点是基元类型或 None,无法继续深入寻址
            return default

    return current
2. 运行示例与结果验证
使用上述实现的 deep_get 对各种异常结构进行提取测试:
# 正常提取邮箱
email = deep_get(data, ["response", "data", "users", 0, "profile", "contact", "email"])
print(f"提取结果 1: {email}")

# 访问越界索引 (例如取第 10 个用户)
out_of_bounds = deep_get(data, ["response", "data", "users", 10, "profile"], default="USER_NOT_FOUND")
print(f"提取结果 2: {out_of_bounds}")

# 访问不存在的深层键
missing_val = deep_get(data, ["response", "data", "users", 0, "avatar", "url"], default="DEFAULT_AVATAR")
print(f"提取结果 3: {missing_val}")
提取结果 2: USER_NOT_FOUND
提取结果 3: DEFAULT_AVATAR
无论中间某一层是缺失、索引越界还是 None,该函数都能在常数级时间内完成判断,避免了多层嵌套 try-except 导致的性能开销与代码杂乱。
三、递归搜索:提取未知层级与分散的目标键
在很多实际场景中,JSON 数据的嵌套深度并不固定,或者相同的键名(例如 "id"、"price")分散在不同的树枝节点下。此时无法预先给出确定的路径序列,需要采用递归生成器对整个结构进行深度优先遍历。
1. 递归生成器实现
使用 Python 的生成器函数(yield from),可以做到惰性遍历,当只需要找到第一个匹配值时无需完整遍历全树:
from typing import Any, Generator

def find_keys(obj: Any, target_key: str) -> Generator[Any, None, None]:
    """
    深度优先递归遍历任意嵌套的 dict/list,生成所有匹配 target_key 的值。
    """
    if isinstance(obj, dict):
        for k, v in obj.items():
            if k == target_key:
                yield v
            # 继续深入子节点查找
            if isinstance(v, (dict, list)):
                yield from find_keys(v, target_key)
    elif isinstance(obj, list):
        for item in obj:
            if isinstance(item, (dict, list)):
                yield from find_keys(item, target_key)

def find_first_key(obj: Any, target_key: str, default: Any = None) -> Any:
    """获取全树中首个匹配的键值"""
    return next(find_keys(obj, target_key), default)
2. 复合异构数据解析示例
面对树状组织的部门与人员结构:
org_tree = {
    "department": "技术研发中心",
    "lead": {"name": "张经理", "email": "manager@test.com"},
    "teams": [
        {
            "name": "架构组",
            "members": [
                {"name": "李工", "email": "li@test.com"},
                {"name": "王工", "email": "wang@test.com"}
            ]
        },
        {
            "name": "运维组",
            "members": [
                {"name": "赵工", "email": "zhao@test.com"}
            ]
        }
    ]
}

# 提取整棵树中的全部邮箱
all_emails = list(find_keys(org_tree, "email"))
print(f"查找到的全部邮箱: {all_emails}")

# 获取首个出现的部门名称
dept = find_first_key(org_tree, "department")
print(f"首个部门: {dept}")
首个部门: 技术研发中心
四、防御性编程与边界异常对比
在解析生产数据时,容错性直接决定了任务的健壮度。传统直接索引和规范的安全访问机制在面对不可控数据输入时的表现有着本质差异。
在实施深层取值时,必须关注以下三个关键细节:
- 区分布尔假值与缺失:当深层字段的值本身就是
False、0或""时,不能使用简单的val or default进行赋值,因为这会错误地将有效数据覆盖为默认值。应当严格依赖包含性检测(如token in current)。 - 区分键名类型:某些 JSON 的键是数字字符串(如
"0"),在 Python 字典中它是str类型的键;而在列表中索引必须是int。路径序列应明确区分"0"(字典键)与0(数组索引)。 - 控制递归深度:如果接收到的 JSON 数据层级极深(例如数千层),递归函数可能会触发 Python 的
RecursionError。处理超深或不受信结构时,建议采用基于显式栈的迭代算法。
五、复杂查询场景:利用 JSONPath 进行模式匹配
当需求不仅是获取单一键值,而是需要根据业务属性进行条件筛选(例如“提取所有特定分类的书籍”或“提取所有子订单的总价列表”),手写循环与递归会变得十分冗长。此时可以借助成熟的 jsonpath-ng 工具库。
1. 环境准备与基础语法
通过 pip 安装依赖包:
pip install jsonpath-ngJSONPath 常见选择符说明:
$:代表 JSON 根对象。.或[]:子节点运算符。..:递归深度搜索(类似于全树通配)。*:匹配所有元素或字段。
2. 查询示例代码
from jsonpath_ng import parse

order_data = {
    "store": {
        "books": [
            {"category": "Python", "title": "Fluent Python", "price": 89.0},
            {"category": "Go", "title": "Go Programming", "price": 75.0},
            {"category": "Python", "title": "Python Cookbook", "price": 98.0}
        ]
    }
}

# 表达式 1: 提取所有书籍的书名 (利用 .. 通配任意层级)
expr_all_titles = parse("store.books[*].title")
titles = [match.value for match in expr_all_titles.find(order_data)]
print(f"所有书名: {titles}")

# 表达式 2: 提取任意深度的所有 price 键
expr_all_prices = parse("$..price")
prices = [match.value for match in expr_all_prices.find(order_data)]
print(f"全树所有价格: {prices}")
全树所有价格: [89.0, 75.0, 98.0]
六、方案选型与工程实践总结
在面对不同形态与规模的 JSON 数据时,应当按需选取最精简且高效的技术方案:
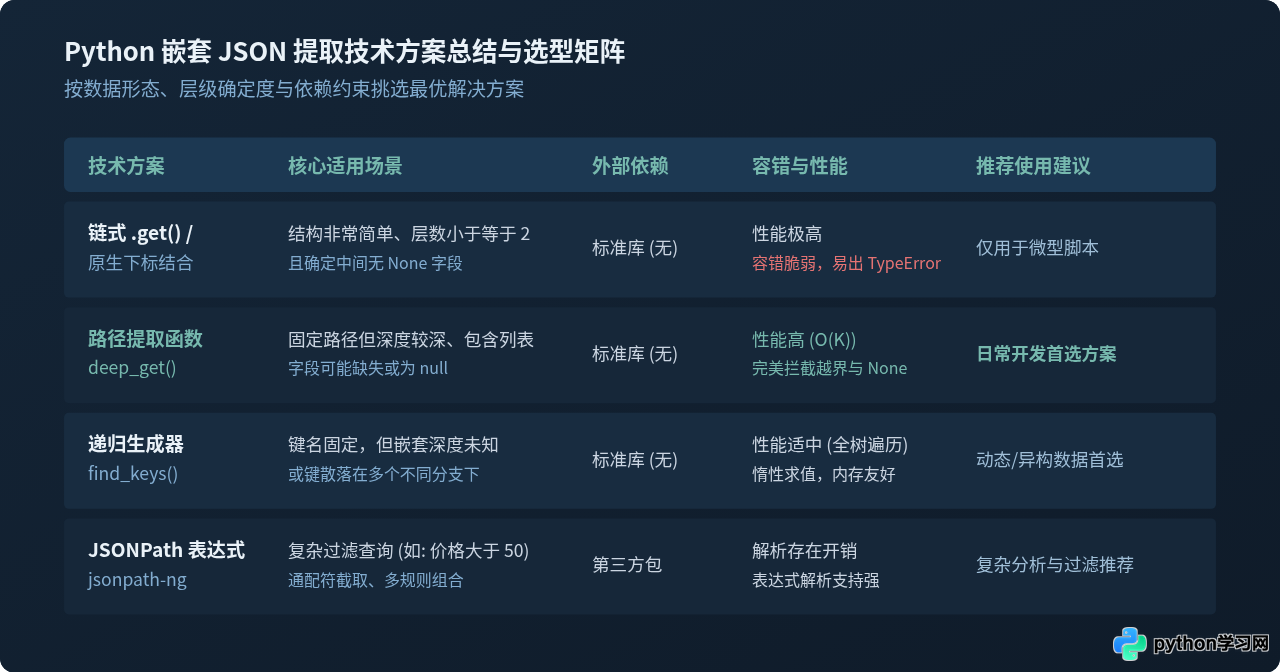
在工程落地中,推荐遵循以下准则:
- 对于常规且路径明确的后端响应,优先使用轻量的
deep_get路径函数,兼具零外部依赖、高执行效率与完备的容错能力。 - 对于层级结构多变或仅需按键名聚合数据的场景,优先使用 递归生成器
find_keys,充分利用 Python 惰性迭代节省内存。 - 对于涉及通配、聚合过滤或规则由外部配置驱动的场景,引入 JSONPath,以声明式语法降低业务代码的复杂度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









