

自学Python基础遇到瓶颈怎么办?高效突破的学习策略
针对自学Python基础过程中普遍遭遇的看懂语法却写不出代码、报错排查困难、概念模糊等瓶颈,提供系统化的四步拆解法、逆向报错调试策略与实战认知模型,助你高效跨越初学鸿沟。
自学 Python 基础进入瓶颈期,通常不是理解力不够,而是学习方式发生了结构性脱节:语法视频看了几十个小时,面对空白编辑器却敲不出一行完整的业务代码;练习题换个参数就毫无头绪;一旦终端飘红报错就陷入恐慌。突破这个瓶颈的核心策略只有一条——立刻停止无节制的被动刷课与记忆语法,全面转向“最小目标驱动的代码拆解与报错逆向排查”。本文将针对“写不出代码”、“理解抽象概念吃力”以及“惧怕报错”三个核心痛点,给出可落地的认知模型与日常操作方案。
一、诊断瓶颈根源:从“被动识别”到“主动构建”的断层
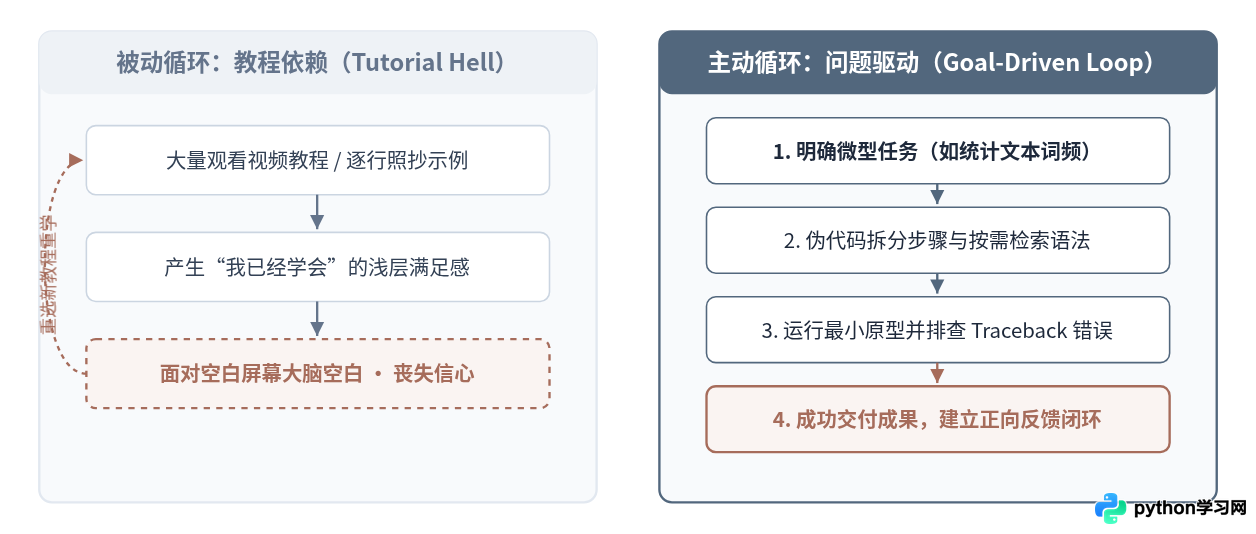
绝大多数初学者遭遇停滞,是因为掉入了心理学上的“识记错觉”(The Illusion of Competence)。看教学视频或跟随教材照抄代码时,大脑处于“模式识别”(Recognition)状态,逻辑链路是由讲师提供好的,读者只需确认“这段代码我看懂了”,便误以为自己已经掌握。
然而,真实编写代码是一个“主动生成”(Generation)过程。它要求学习者自己完成从模糊需求到细致步骤的转化,再把步骤翻译为具体的 Python 语法结构。如果平时所有的练习都只是被动临摹现成代码,大脑负责“需求拆解与结构拼装”的神经链路就始终得不到训练。一旦脱离教程,自然寸步难行。
二、突破“写不出代码”:四步拆解实操法
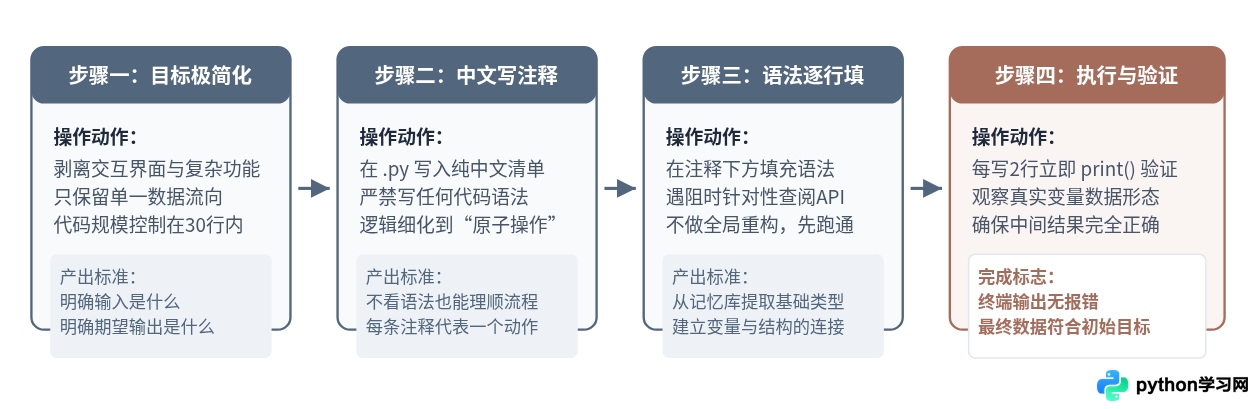
面对具体需求时不知道如何下笔,关键在于试图从自然语言思维直接跨越到代码语言。正确的做法是在中间增加一个“逻辑缓冲层”。无论任务多么微小,都严格按照以下四个步骤推进:
- 微型化目标定义:初学者最忌讳设定宏大项目(例如“写一个自动化电商爬虫系统”)。应该将其缩减为可以在 30 行代码内完成的具体动作(例如“只抓取一个静态页面的所有标题文本”)。
- 编写纯中文伪代码:在编辑器中新建一个
.py文件,先用 Python 的单行注释#罗列出该任务必须完成的物理顺序。在这一步完全不考虑任何语法、函数名或模块。 - 积木化语法映射:针对注释中的每一句话,寻找对应的基础语法结构。如果不知道某个具体动作在 Python 中怎么写(比如“怎么把字符串按空格切开”),只对这一个子问题去查文档或搜索引擎。
- 单步验证与集成:每写完两三行代码,立刻在终端运行打印输出结果(
print()),确认数据符合预期后,再写下一步。
实战演练:以“清洗用户数据文本”为例
假设需求是:读取一行包含混杂空格和无效符号的用户输入字符串,提取出所有合法的手机号并过滤掉重复项。如果是新手,不要一开始就考虑正则表达式或高阶函数,而是按步骤展开:
# 步骤 1:准备测试用的原始数据
raw_data = " 13800138000, 13912345678 , 13800138000 , invalid_num, 13788889999 "

# 步骤 2:先按逗号把整个长文本切开为独立片段
raw_items = raw_data.split(",")
print("切分后的片段:", raw_items)  # 步骤 4 立即验证

# 步骤 3:定义一个空列表存放符合规则的结果
valid_phones = []

# 步骤 4:逐个检查每个片段
for item in raw_items:
    # 去除两端多余空格
    cleaned = item.strip()
    # 规则判断:必须是纯数字且长度为11位
    if cleaned.isdigit() and len(cleaned) == 11:
        valid_phones.append(cleaned)

print("过滤后的手机号:", valid_phones)

# 步骤 5:利用 set 数据结构去重并排好序
unique_phones = sorted(list(set(valid_phones)))
print("最终去重结果:", unique_phones)
输出示例(终端实际呈现):
切分后的片段: [' 13800138000', ' 13912345678 ', ' 13800138000 ', ' invalid_num', ' 13788889999 ']
过滤后的手机号: ['13800138000', '13912345678', '13800138000', '13788889999']
最终去重结果: ['13788889999', '13800138000', '13912345678']
通过这套方法,哪怕代码只有 15 行,初学者也完成了需求理解、切分、遍历、条件判断、方法调用与去重等综合语法的自我合成。
三、击碎调试恐惧:读懂 Traceback 与逆向排错
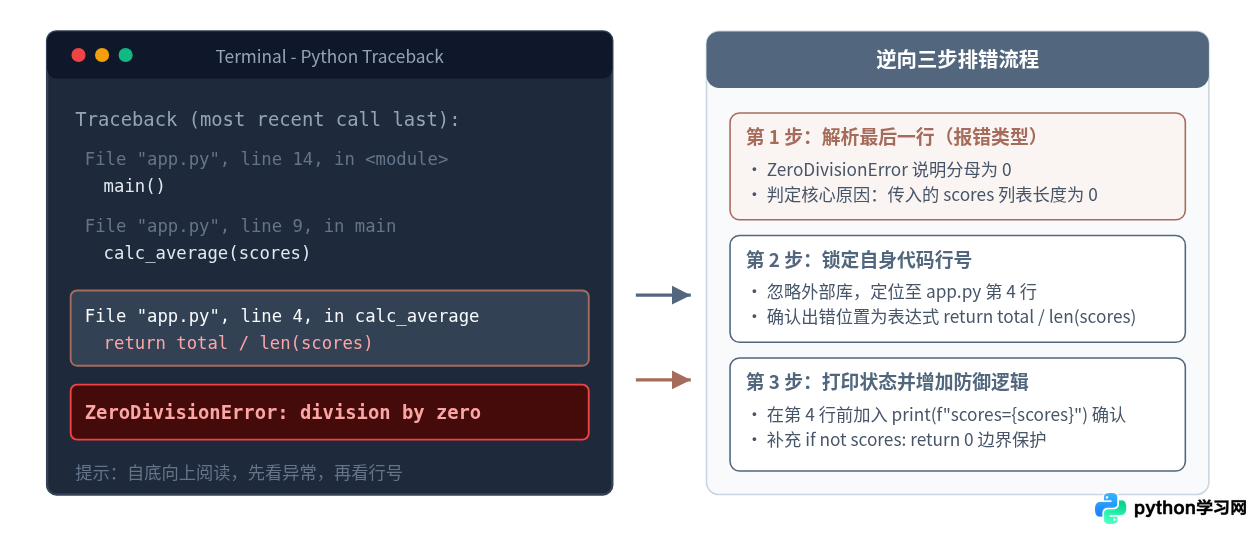
自学者常有的另一个严重心理障碍,是对终端红色报错的恐惧。很多初学者一看到红字就直接刷新重来,或者盲目乱改变量名。事实上,Python 的调用栈(Traceback)是语言给开发者最精确的调试工具。
排查 Python 错误时,阅读顺序必须是自底向上(Bottom-Up),而不是从第一行顺流向下:
- 第一眼看最后一行:这里标明了异常类型与错误核心原因。例如
IndexError: list index out of range或KeyError: 'age'。 - 第二眼看倒数第二段:这里给出了出错的具体文件路径与代码行号。直接跳过 Python 标准库内部的代码文件,定位到自己编写的那个文件。
- 第三眼核实当前变量状态:在报错那一行代码的正上方,加入
print()或type()打印出传入变量的真实值。90% 的初学者错误都是因为“变量里存的数据形态”与“你以为它存的形态”不一致。
四、突破核心概念:避开死记硬背,建立内存具象模型
Python 语法初看简单,但进入函数与对象阶段后,很多学习者会卡在“作用域(Scope)”、“可变与不可变对象”、“浅拷贝与深拷贝”等概念上。死记概念名词只会让人越学越困惑,必须在脑中建立正确的物理模型:
1. 变量不是“盒子”,而是“便利贴(引用)”
在很多初级教程中,常把变量比喻成放东西的盒子。但在 Python 中,这种比喻是有害的。在 Python 的底层设计里,所有数据都是内存中的对象,而变量只是贴在对象上的名字标签(引用)。
一旦理解了“标签”模型,许多看似诡异的现象就迎刃而解:
# 经典陷阱:可变对象别名绑定
a = [1, 2, 3]
b = a  # 并不是把盒子里的东西复制了一份,而是把标签 b 也贴到了同一个列表对象上
b.append(4)

print("a 的内容:", a)  # 输出 [1, 2, 3, 4]
print("b 的内容:", b)  # 输出 [1, 2, 3, 4]
print("二者内存地址是否一致:", a is b)  # True
2. 函数默认参数不要使用可变对象
另一个高频瓶颈陷阱是函数的默认参数定义。Python 的函数在被解释器定义(def)的那一瞬间,默认参数对象就创建好了,并且全局只创建一次。如果把列表或字典当做默认参数,后续所有的调用都会共享同一个对象:
# 错误写法(踩坑模式)
def add_item_bad(item, target_list=[]):
    target_list.append(item)
    return target_list

print(add_item_bad("A"))  # 输出: ['A']
print(add_item_bad("B"))  # 输出: ['A', 'B']  <-- 并非预期的 ['B']!

# 正确写法(规范模式)
def add_item_good(item, target_list=None):
    if target_list is None:
        target_list = []  # 每次调用时独立生成新列表
    target_list.append(item)
    return target_list

print(add_item_good("A"))  # 输出: ['A']
print(add_item_good("B"))  # 输出: ['B']  <-- 独立且安全
五、突破瓶颈的高效执行策略全景
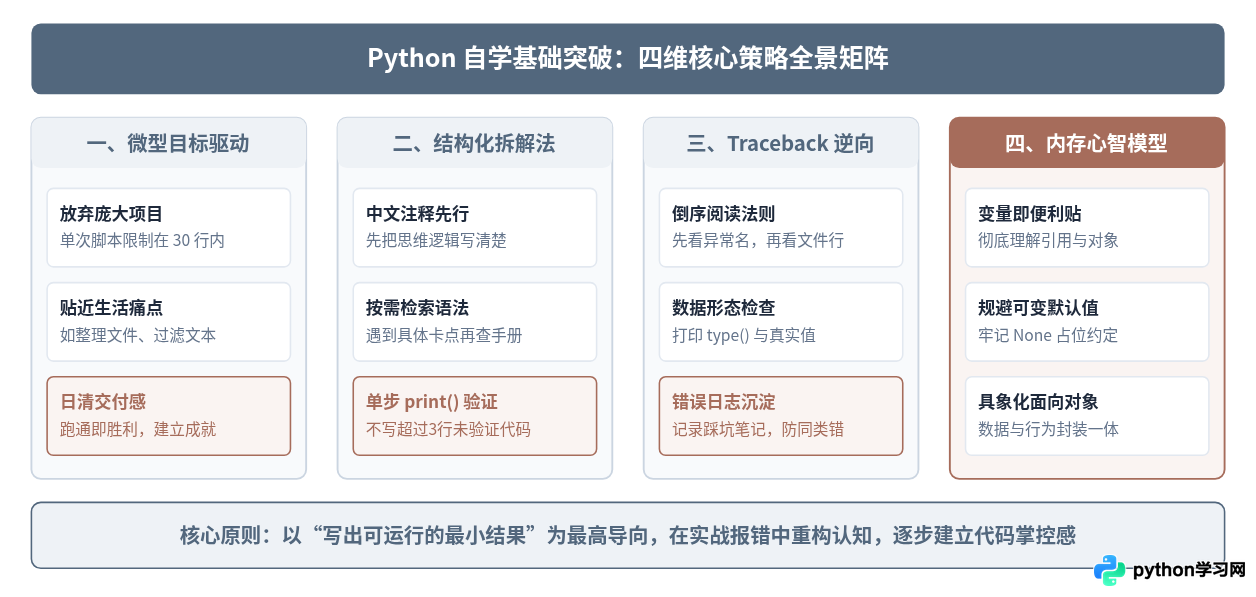
摆脱瓶颈不需要每天投入连续 6 个小时的死磕,关键在于维持一种“低阻力、高频次、有交付”的正向反馈体系。下表列出了常见自学误区与对应的修正举措:
| 卡点现象 | 错误应对方式(无效消耗) | 突破策略(高效替代) |
|---|---|---|
| 语法记不住 | 拿笔记本手抄语法、背诵常用内置函数列表 | 只记概念框架,具体参数随时查官方文档或用 help() / dir() 实时自省。 |
| 面对空白没思路 | 重新回看教学视频第三遍,继续跟着打一遍 | 关掉视频,用中文写出 3-5 行执行步骤,逐行填充代码,哪怕先写死硬编码数据。 |
| 复杂概念看不懂 | 强行阅读枯燥的学术定义(如类、多态) | 用具象生活场景模拟(如“角色卡属性”),并在 Python Tutor 网站观察内存指向图。 |
| 学习动力衰退 | 给自己定下“一个月精通数据分析/爬虫”的宏大目标 | 设定每天 20 行代码的“微型自闭环工具”(如自动重命名文件夹下的照片)。 |
结语:让正向反馈驱动长期精进
遇到瓶颈并不意味着你不适合学习编程,它是每一个独立自学者在由“知识消费者”转变为“逻辑生产者”时的必然阵痛。从今天起,收起那些尚未看完的冗长视频,打开编辑器,建立一个名为 my_first_script.py 的文件,用四步拆解法写一个哪怕只有 10 行但能切实解决你眼前某个小烦恼的程序。
当终端第一次完整打印出你亲手构思的数据、顺利通过所有报错时,你就已经跨过了 Python 基础学习最艰难的那道门槛。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









