

Python爬虫数据解析技巧:XPath与CSS选择器的高效使用方法
系统剖析Python网络爬虫中XPath与CSS选择器的底层机制、语法对照、定位技巧与性能调优方案,帮助开发者高效、稳健地完成HTML数据提取。
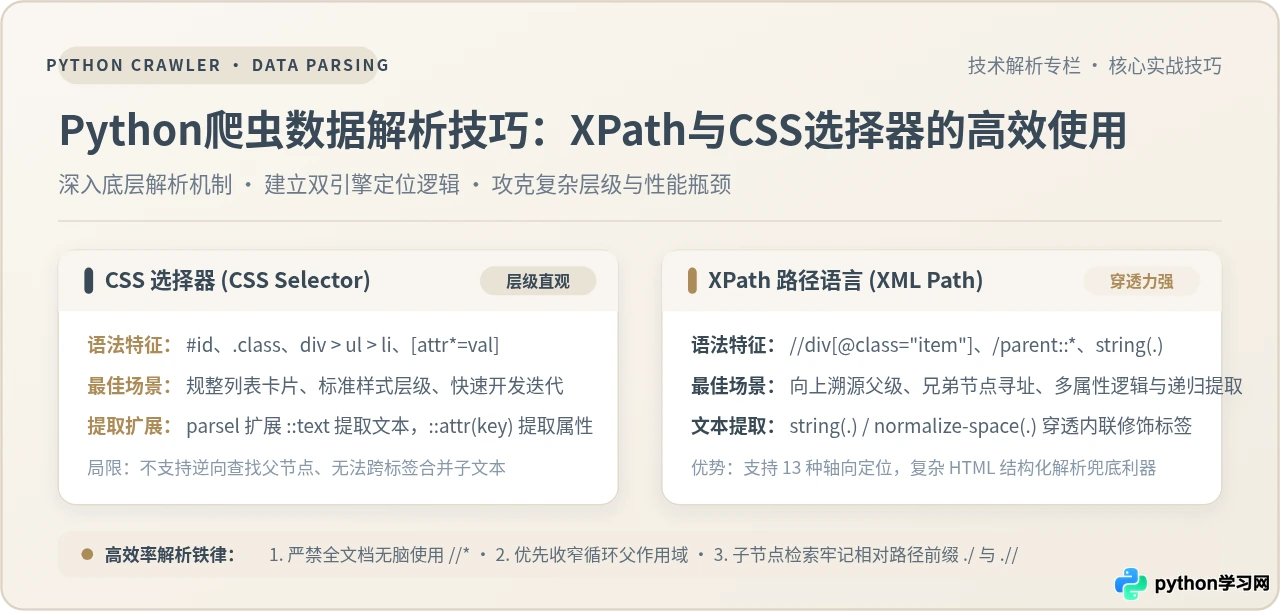
一、解析基础与双引擎环境准备
网页数据解析的本质,是将服务端返回的无序 HTML 文本流转换为具备父子、兄弟层级关系的 DOM(文档对象模型)树结构,随后通过预设的寻址语法定位到目标节点并取出文本或属性。
在 Python 生态中,底层解析速度最快的库是基于 C 语言 libxml2 实现的 lxml。而在实际工程开发中,推荐使用由 Scrapy 团队维护的轻量解析库 parsel。它在底层对 lxml 与 cssselect 进行了高度整合,同一个选择器对象能够同时、无缝调用 .xpath() 与 .css() 方法,无需在多个库之间来回转换数据结构。
在当前 Python 环境下执行依赖安装命令:
# 终端安装命令
pip install parsel lxml
安装完成后,即可编写基础解析代码。下例展示了在同一段模拟 HTML 上,分别使用 XPath 与 CSS 选择器提取页面标题与容器属性的标准用法:
from parsel import Selector

# 模拟从 requests 或 httpx 获取到的原始 HTML 文本
html_text = """
<div id="container" class="wrapper active" data-version="2.0">
    <h1 class="main-title">Python数据解析指南</h1>
    <p class="status">连载中</p>
</div>
"""

# 初始化选择器(单次建树)
selector = Selector(text=html_text)

# 方式 1:使用 CSS 选择器提取标题文本与容器属性
css_title = selector.css('h1.main-title::text').get()
css_version = selector.css('#container::attr(data-version)').get()

# 方式 2:使用 XPath 提取标题文本与容器属性
xpath_title = selector.xpath('//h1[@class="main-title"]/text()').get()
xpath_version = selector.xpath('//div[@id="container"]/@data-version').get()

print(f"[CSS解析结果] 标题: {css_title} | 版本: {css_version}")
print(f"[XPath解析结果] 标题: {xpath_title} | 版本: {xpath_version}")
[XPath解析结果] 标题: Python数据解析指南 | 版本: 2.0
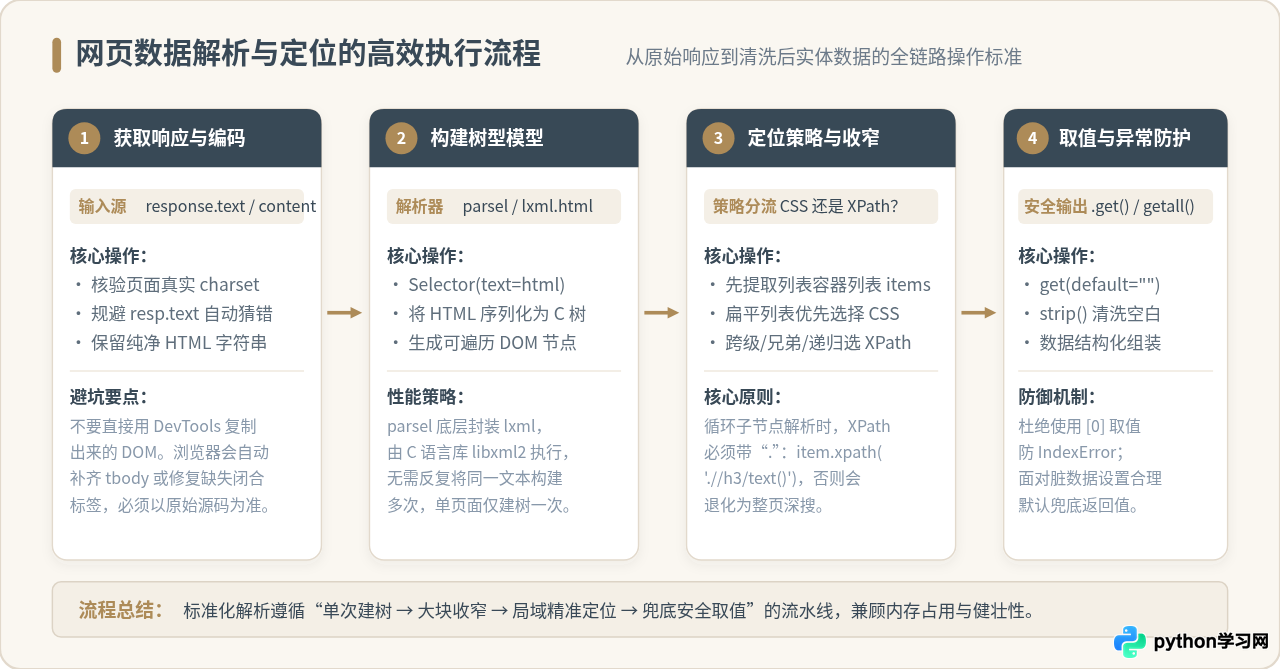
如图 1 所示,标准解析流水线包含四个阶段:获取原始响应、单次序列化构建 DOM 树、根据节点关系分流选择器策略、以及最后通过 .get() 进行安全的取值与默认值回退。这种流水线设计避免了多次重复构建解析树带来的高额 CPU 开销。
二、XPath 高效解析语法与核心技巧
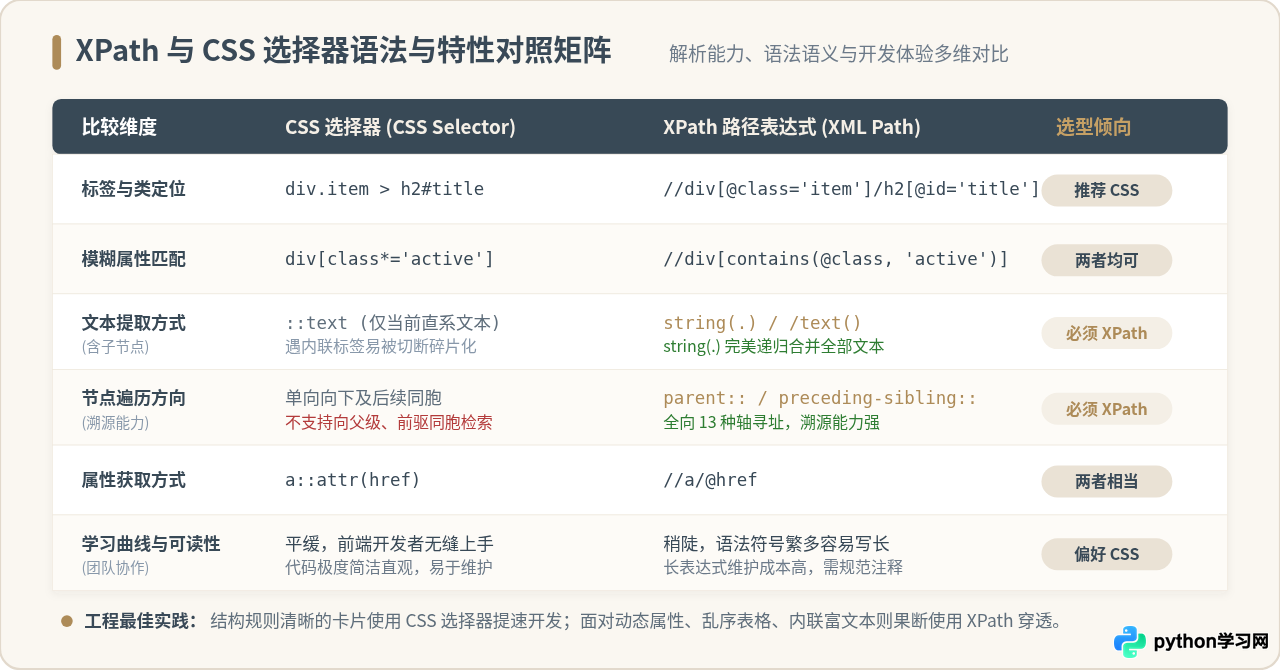
XPath(XML Path Language)是一种在 XML 与 HTML 文档中寻址节点的查询语言。与仅支持单向查找的 CSS 相比,XPath 的最大优势在于拥有 13 种轴(Axes)机制,支持逆向寻找父级节点、横向定位兄弟节点,以及强大的字符串聚合处理函数。
1. 路径起点与属性筛选
绝对路径以单斜杠 / 开头,必须从根节点 /html 一层层递进;相对路径以双斜杠 // 开头,可在文档任意位置匹配匹配标签。在爬虫开发中,切忌使用浏览器右键直接复制的冗长绝对路径(如 /html/body/div[2]/div[1]/ul/li[3]),前端页面的任何细微改动都会导致路径断裂。
在属性筛选中,当遇到包含多个 class 属性的元素时(例如 <div class="item card active">),使用全等匹配 [@class="item"] 会匹配失败。此时应使用 contains() 函数进行模糊匹配:
# 错误写法:无法匹配多 class 节点
selector.xpath('//div[@class="item"]')

# 正确且稳健的写法:使用 contains 匹配
selector.xpath('//div[contains(@class, "item")]')

# 多条件与逻辑组合
selector.xpath('//div[contains(@class, "item") and @data-status="online"]')
2. 轴向定位:向上回溯与兄弟节点锚定
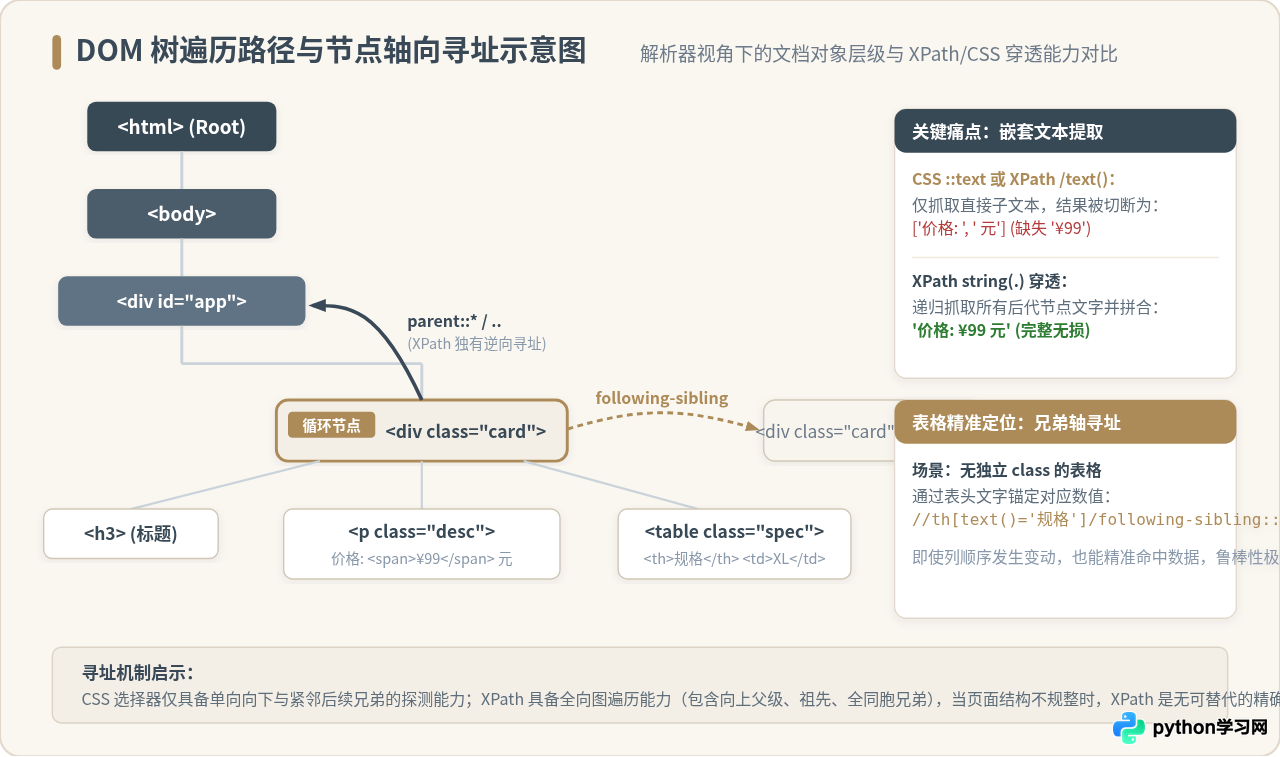
在许多电商与企业信息网站中,数据以键值对表格形式呈现,但数值单元格本身并没有专属的 class 名称。此时必须先定位已知文字的标签(如“规格”),再通过兄弟轴 following-sibling:: 精准获取相邻单元格:
# 定位内容为“规格”的 th,并获取紧随其后的 td 内容
selector.xpath('//th[text()="规格"]/following-sibling::td[1]/text()').get()

# 逆向寻找父级:从内层图标反向获取所属的整张卡片
selector.xpath('//span[@class="badge-icon"]/parent::div[contains(@class, "card")]')
3. 文本提取陷阱:text() 与 string(.) 的本质区别
初学者常误以为 /text() 能够提取标签内的全部文字。但实际上,/text() 只抓取当前节点的直接子文本节点。一旦目标文本内部混入了 <span>、<b>、<em> 等内联修饰标签,文字就会被分割成碎片甚至丢失。
解决该问题的最佳实践是使用 XPath 内置函数 string(.) 或 normalize-space(.)。它们会递归遍历当前节点下所有后代标签的文本并拼合成连续字符串,同时自动剔除首尾的多余空白字符:
# 演示 HTML:价格文本中嵌套了 currency span
sample_snippet = '<p class="price">售价:<span class="cur">¥</span>99.5<em>元</em></p>'
sel = Selector(text=sample_snippet)

# 使用 /text():只得到 ['售价:'],关键数字丢失
bad_res = sel.xpath('//p[@class="price"]/text()').getall()

# 使用 string(.) 穿透:完整提取
good_res = sel.xpath('string(//p[@class="price"])').get()
# 或使用 normalize-space 清洗首尾空白换行
clean_res = sel.xpath('normalize-space(//p[@class="price"])').get()

print(f"bad_res: {bad_res}")
print(f"good_res: '{good_res}'")
good_res: '售价:¥99.5元'
//li[1] 代表第一个列表项,//li[last()] 代表最后一个列表项,而 //li[0] 在 XPath 标准中是非法的,不会匹配到任何节点。
三、CSS 选择器的高效应用与速查
CSS 选择器凭借与样式表完全一致的声明语法,具有无可比拟的直观性。对于前端结构整齐、类名规范的列表页或内容页,CSS 选择器通常是书写速度最快、维护成本最低的选择。
1. 层级关系与常用属性模式
在 CSS 选择器中,空格表示“后代节点”(包含子级、孙级所有深层元素),而大于号 > 表示“直接子节点”。在提取具有严格父子约束的内容时,优先使用 > 能减少不必要的深层扫描。
E#id:根据 ID 唯一定位元素。E.class1.class2:同时具备多个类名的元素(交集选择器)。E[attr="val"]:属性值精确匹配。E[attr*="val"]:属性值包含某子字符串(等价于 XPath 的 contains)。E[attr^="val"]:属性值以指定字符串开头(适合匹配动态生成的 ID 前缀)。E:nth-of-type(n):匹配同类型标签中的第 n 个元素。
2. parsel 扩展伪元素语法
W3C 原生 CSS 选择器仅能选中 Element 节点,无法直接选中节点的文本或属性。为了弥补这一短板,parsel 库扩展了专用的伪元素语法:
::text:提取当前元素直接子文本。::attr(attribute_name):提取指定属性的取值,如a::attr(href)或img::attr(src)。
以下为一个完整的商品列表卡片信息抽取示例:
from parsel import Selector

catalog_html = """
<div class="goods-grid">
    <div class="goods-card" data-sku="SKU-1001">
        <a href="/item/1001" class="thumbnail">
            <img src="https://example.com/p1.jpg" alt="机械键盘"/>
        </a>
        <div class="info">
            <h3 class="title">客制化机械键盘 87键</h3>
            <p class="price-box">¥<span class="num">399</span></p>
        </div>
    </div>
    <div class="goods-card" data-sku="SKU-1002">
        <a href="/item/1002" class="thumbnail">
            <img src="https://example.com/p2.jpg" alt="无线人体工学鼠标"/>
        </a>
        <div class="info">
            <h3 class="title">无线人体工学鼠标 双模</h3>
            <p class="price-box">¥<span class="num">189</span></p>
        </div>
    </div>
</div>
"""

sel = Selector(text=catalog_html)
cards = sel.css('div.goods-grid > div.goods-card')

goods_list = []
for card in cards:
    sku = card.css('::attr(data-sku)').get()
    title = card.css('h3.title::text').get()
    detail_url = card.css('a.thumbnail::attr(href)').get()
    price = card.css('span.num::text').get()

    goods_list.append({
        "sku": sku,
        "title": title,
        "url": detail_url,
        "price": float(price) if price else 0.0
    })

print(f"成功解析商品数: {len(goods_list)}")
print(f"首个商品实体: {goods_list[0]}")
首个商品实体: {'sku': 'SKU-1001', 'title': '客制化机械键盘 87键', 'url': '/item/1001', 'price': 399.0}
四、性能调优、防御性编码与常见陷阱
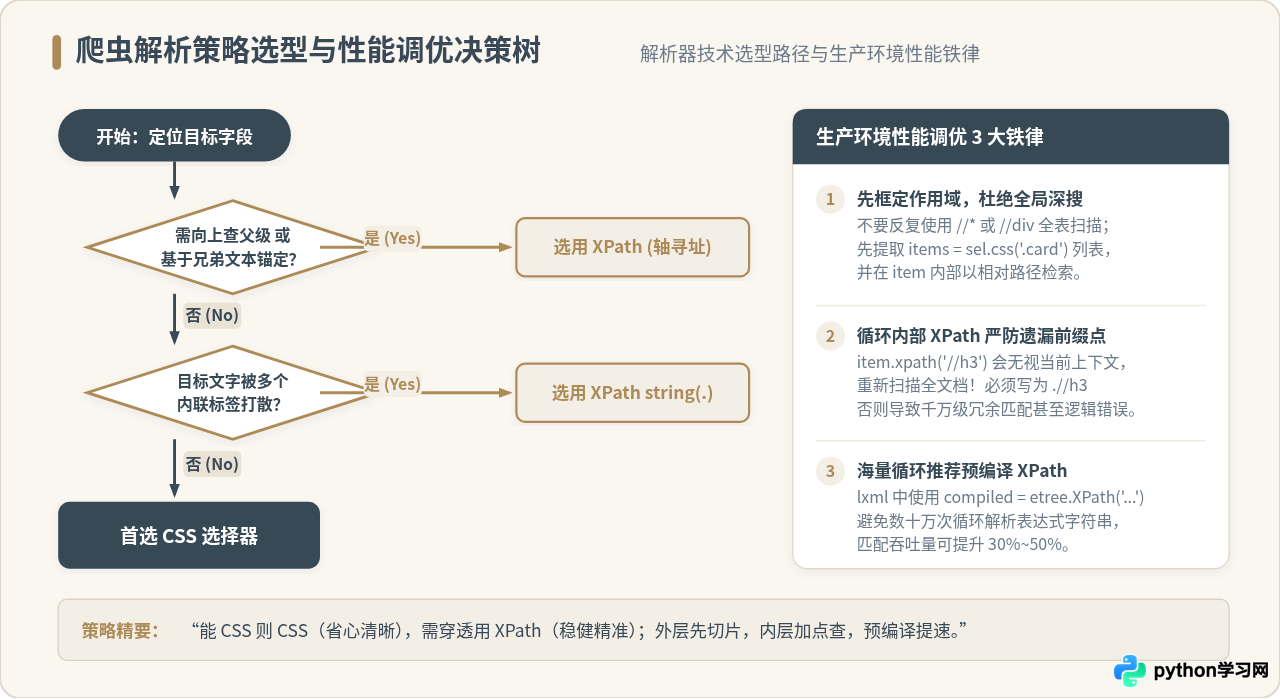
在进行千万级页面抓取时,解析阶段的 CPU 占用与内存表现直接影响整个爬虫系统的吞吐量。以下是在生产环境中保证解析稳定与高吞吐的三条核心原则。
1. 作用域收窄与“遗漏前缀点”的重大隐患
解析批量数据时,务必先定位最外层的容器列表(例如 items = sel.xpath('//div[@class="item"]')),再在循环体内部针对每个子块局部解析。
在循环内部调用 item.xpath() 时,如果表达式写成 item.xpath('//h3/text()'),XPath 引擎会无视当前 item 上下文,直接从整篇文档的根节点重新扫描所有 h3 标签!
正确写法必须添加前缀点:item.xpath('.//h3/text()') 或 item.xpath('./div/h3/text()')。遗漏前缀点不仅会导致严重的数据匹配串行,还会产生 $O(N imes M)$ 的全量 DOM 深搜,使 CPU 使用率骤增。
2. 预编译高频 XPath 表达式
每次调用 xpath('...') 时,解析引擎都需要对传入的字符串进行语法词法分析并生成查询 AST(抽象语法树)。如果一个任务中需要循环数万次相同结构的页面,可以通过直接调用底层 lxml.etree.XPath 预编译表达式:
from lxml import etree

# 预编译 XPath 对象(仅初始化一次)
COMPILED_TITLE_XPATH = etree.XPath("string(.//h3[@class='title'])")
COMPILED_PRICE_XPATH = etree.XPath(".//span[@class='price']/text()")

def fast_parse_item(tree_element):
    # 直接在编译对象上调用,省去字符串解析耗时
    title = COMPILED_TITLE_XPATH(tree_element)
    prices = COMPILED_PRICE_XPATH(tree_element)
    return {
        "title": title.strip(),
        "price": prices[0] if prices else ""
    }
3. 动态渲染与 DevTools 源码差异
开发者在 Chrome 或 Edge DevTools 中审查元素时看到的 DOM,是经过浏览器自动化纠错(例如给 <table> 自动补齐 <tbody>)以及客户端 JavaScript 动态渲染后的结果。
如果爬虫直接通过 requests.get() 请求纯静态 HTML,响应体中往往根本不存在 <tbody> 标签。此时若按照 DevTools 复制的形如 //table/tbody/tr 的路径编写爬虫,查询结果将始终为空列表。调试时务必以 Python 实际接收到的 response.text 原始内容为准。
res[0],因为一旦页面遇到缺省字段或广告占位卡片,将直接抛出 IndexError 导致整个进程中断。始终使用 .get(default="") 进行安全提取,或在列表推导式中显式检查边界条件。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









