

Python xlrd库读取Excel指定单元格报IndexError怎么办
针对Python使用xlrd库读取Excel指定单元格时报IndexError: list index out of range的常见故障,深入剖析0基与1基索引差异、空表及边界越界成因,提供标准化排查流程、坐标转换公式与防御式安全读取代码。
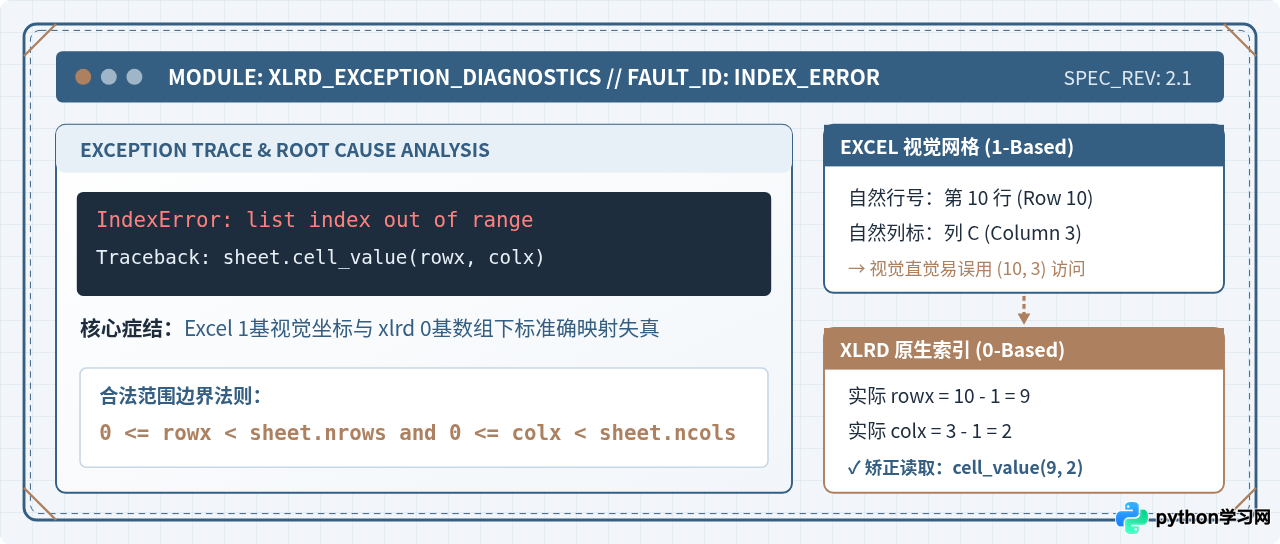
在 Python 中使用 xlrd 库读取 Excel 指定单元格时抛出 IndexError: list index out of range,根本原因在于代码传入的行索引(rowx)、列索引(colx)或工作表索引超出了工作表的实际有效范围(必须严格满足 0 <= rowx < sheet.nrows 且 0 <= colx < sheet.ncols)。解决该问题的核心路径是:核对并矫正 Excel 视觉界面(1基)与 Python 内部数组(0基)的索引偏移、前置检查工作表实际有效行列尺寸,以及在读取逻辑中加入边界判断守卫或安全读取封装。
一、报错现场表现与核心机制剖析
当开发者调用 xlrd 提供的单元格取值方法时,常见的报错调用通常表现为以下几种形式:
# 常见的三种抛出 IndexError 的调用方式
val = sheet.cell_value(rowx, colx)
val = sheet.cell(rowx, colx).value
val = sheet.row_values(rowx)[colx]执行后程序中断并打印标准回溯信息:IndexError: list index out of range。要理解这一报错,必须明确 xlrd 在内存中组织表格数据的数据结构。
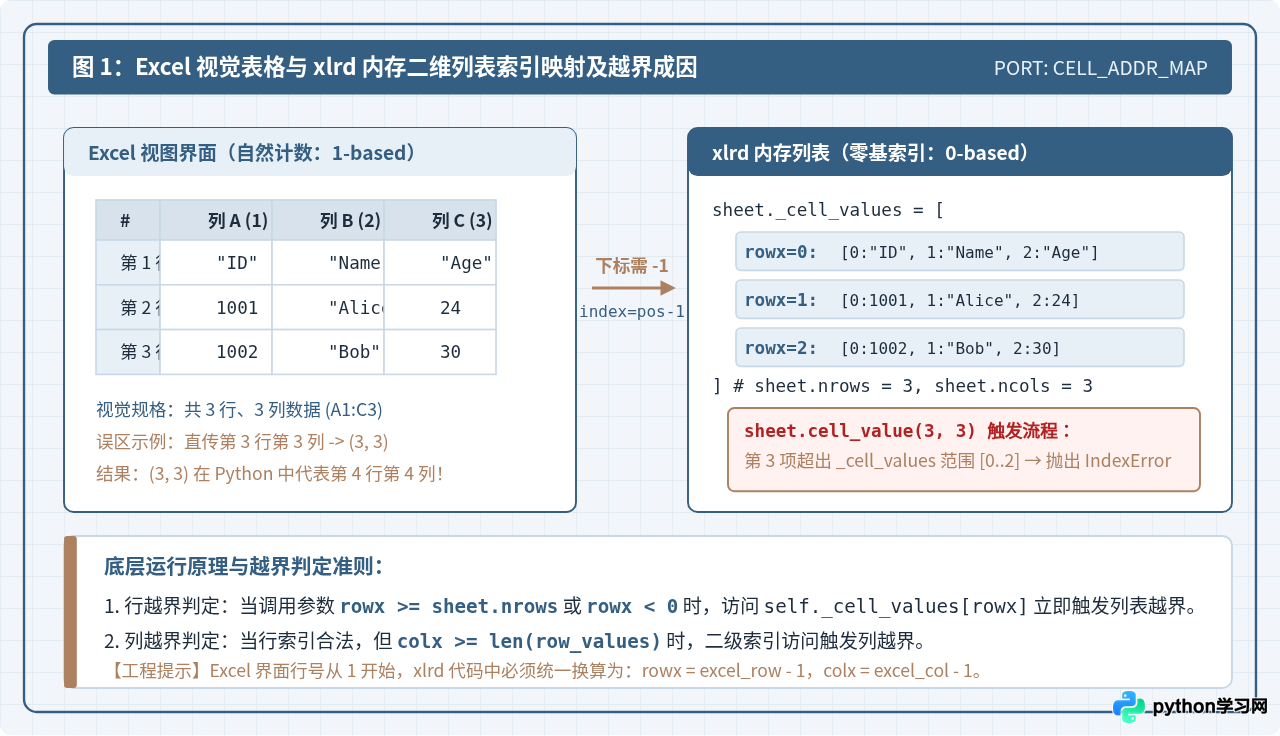
xlrd 在调用 open_workbook 解析 Excel 文件时,底层将每个工作表(Sheet)中的单元格数据保存在二维列表结构(嵌套 List)中,即 sheet._cell_values。在这个二维列表中,第一层存储行列表,第二层存储对应行中各列的单元格值。Python 原生列表仅允许访问位于有效下标范围 [0, len - 1] 内的元素;一旦给定的行号 rowx >= sheet.nrows,在访问外层列表时便会立即触发列表越界。同理,当给定的列号 colx >= sheet.ncols(或超出该行已填充的元素长度),在二级索引寻址时同样会引发该异常。
二、导致 IndexError 的四大常见诱因及排查
在实际业务脚本中,IndexError 往往不是由单一语法错误引起的,而是由于数据状态与开发者预期不符。以下是导致该问题的四个高频原因及对应的现场排查思路:
1. 0 基索引与 1 基序号混淆(最常见)
在日常使用 Excel 软件时,界面左侧的行号从 1 开始,列标从 A(即第 1 列)开始,这是典型的人类阅读习惯(1-based 计数)。然而 Python 语言与 xlrd 库严格遵循从 0 开始的计算机下标规则(0-based 计数)。
如果一个表格有 10 行数据,其合法行索引范围是 0 到 9。如果开发者直接按照 Excel 界面的“第 10 行”传入 sheet.cell_value(10, 0),索引 10 超出了最大允许索引 9,系统就会精准抛出 IndexError。同理,读取列 C 时若直接传入 3 而非 2,在只有 3 列的表格中同样会因列越界崩溃。
2. 空工作表或空数据行导致行列数为 0
Excel 界面即使没有任何数据,也会展示成片灰色网格线,容易给初学者造成“单元格始终存在”的错觉。但在底层数据文件中,没有任何填充内容的表格其 sheet.nrows 和 sheet.ncols 的值均为 0。
在空表状态下,即便是传入最基础的 sheet.cell_value(0, 0),由于有效行数是 0,任何大于等于 0 的下标都属于非法访问,会直接导致程序崩溃。
3. 工作表索引越界(Sheet Index Out of Range)
该问题发生在获取 Sheet 对象的阶段。例如开发者使用了 book.sheet_by_index(sheet_index),若工作簿总共只有 1 个工作表(其合法索引仅有 0),而代码中指定了 sheet_by_index(1),此时抛出的同样是 IndexError: list index out of range。
4. 循环遍历时边界设定有误
在批量处理表格时,很多循环结构写成了 for r in range(1, sheet.nrows + 1)。当循环执行到末尾项 sheet.nrows 时,恰好比最大下标大 1,导致脚本在前几千行运行正常,却在最后一行突然报 IndexError 中断退出。
三、具体修复方法与健壮代码实现
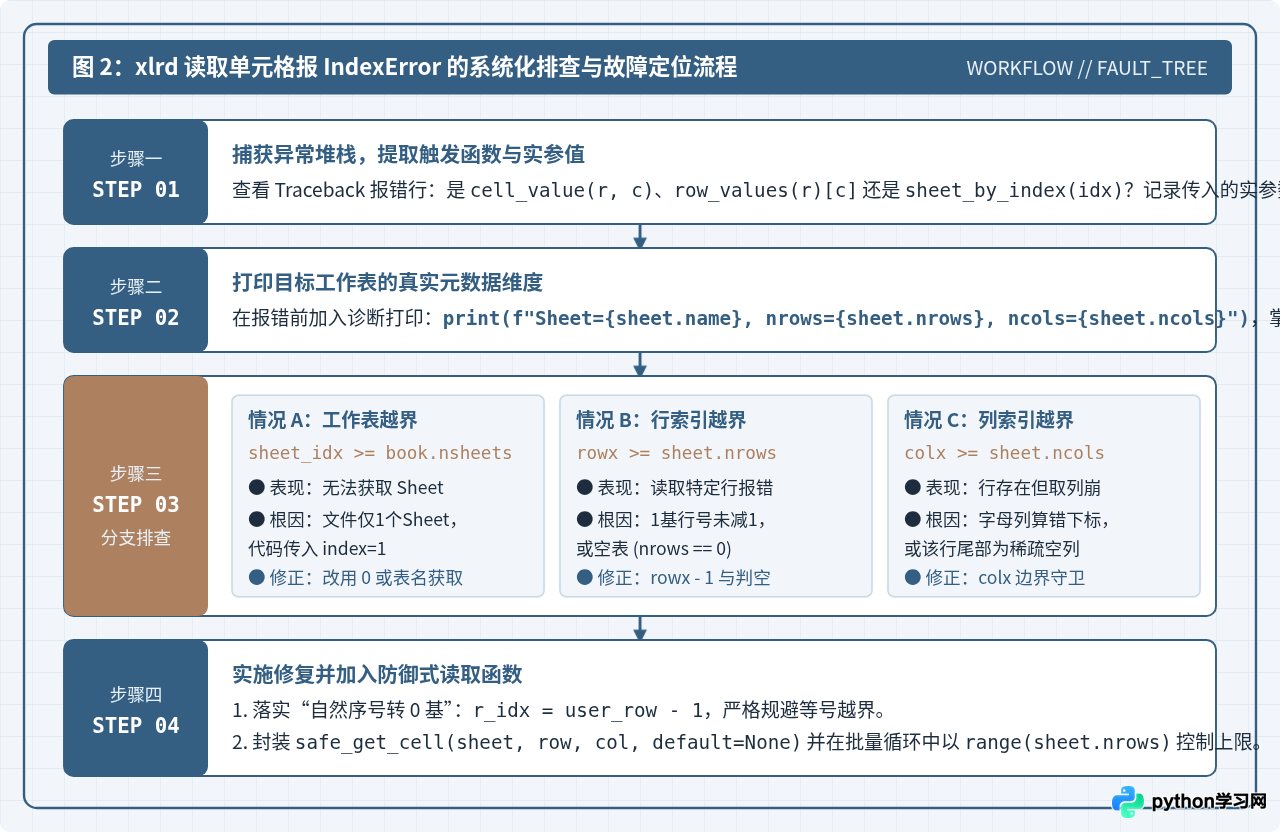
针对上述诱因,解决 IndexError 不能仅仅依靠“把数字改小一点”,而应建立工程化的防护机制,从规范转换、边界校验到防御式封装层层设防。
方法 1:规范化 0 基转换逻辑
如果业务输入是人类习惯的行号(例如从外部配置文件、命令行参数或界面输入获得的行号和列标),必须在传入 xlrd 前统一执行换算:
import xlrd

def get_cell_by_human_pos(sheet, excel_row, excel_col):
    """
    通过人类习惯的 1 基行号和 1 基列号安全读取
    :param excel_row: Excel 界面的行号(如第 1 行输入 1)
    :param excel_col: Excel 界面的列号(如第 1 列输入 1)
    """
    rowx = excel_row - 1
    colx = excel_col - 1

    if 0 <= rowx < sheet.nrows and 0 <= colx < sheet.ncols:
        return sheet.cell_value(rowx, colx)
    else:
        raise ValueError(
            f"坐标越界:请求 Excel 位置 ({excel_row}, {excel_col}),"
            f"当前表格最大范围为 ({sheet.nrows} 行, {sheet.ncols} 列)"
        )
方法 2:构建通用安全读取函数(推荐工程方案)
在自动化批量任务中,避免程序因个别单元格空缺或表格尺寸波动而意外中断的最佳实践是封装一个具备“优雅降级”能力的安全读取工具函数:
import xlrd
import logging

logging.basicConfig(level=logging.INFO, format="%(levelname)s: %(message)s")

def safe_cell_value(sheet, rowx, colx, default=""):
    """
    安全读取单元格值,防止 IndexError 导致程序崩溃
    :param sheet: xlrd 的 Sheet 对象
    :param rowx: 0 基行索引 (int)
    :param colx: 0 基列索引 (int)
    :param default: 越界或异常时的默认返回值
    :return: 单元格内容或默认值
    """
    # 1. 基础有效性验证:确保索引为非负整数
    if not (isinstance(rowx, int) and isinstance(colx, int)):
        logging.warning("行列索引必须为整数,当前输入: rowx=%s, colx=%s", rowx, colx)
        return default

    if rowx < 0 or colx < 0:
        logging.warning("索引不能为负数: rowx=%d, colx=%d", rowx, colx)
        return default

    # 2. 静态尺寸守卫:确保坐标在有效数据区间内
    if rowx >= sheet.nrows:
        logging.warning("行越界警告: rowx=%d 超出有效行数 (nrows=%d)", rowx, sheet.nrows)
        return default

    if colx >= sheet.ncols:
        logging.warning("列越界警告: colx=%d 超出有效列数 (ncols=%d)", colx, sheet.ncols)
        return default

    # 3. 底层访问与二次保护
    try:
        return sheet.cell_value(rowx, colx)
    except IndexError as err:
        logging.error("底层读取异常: %s (rowx=%d, colx=%d)", err, rowx, colx)
        return default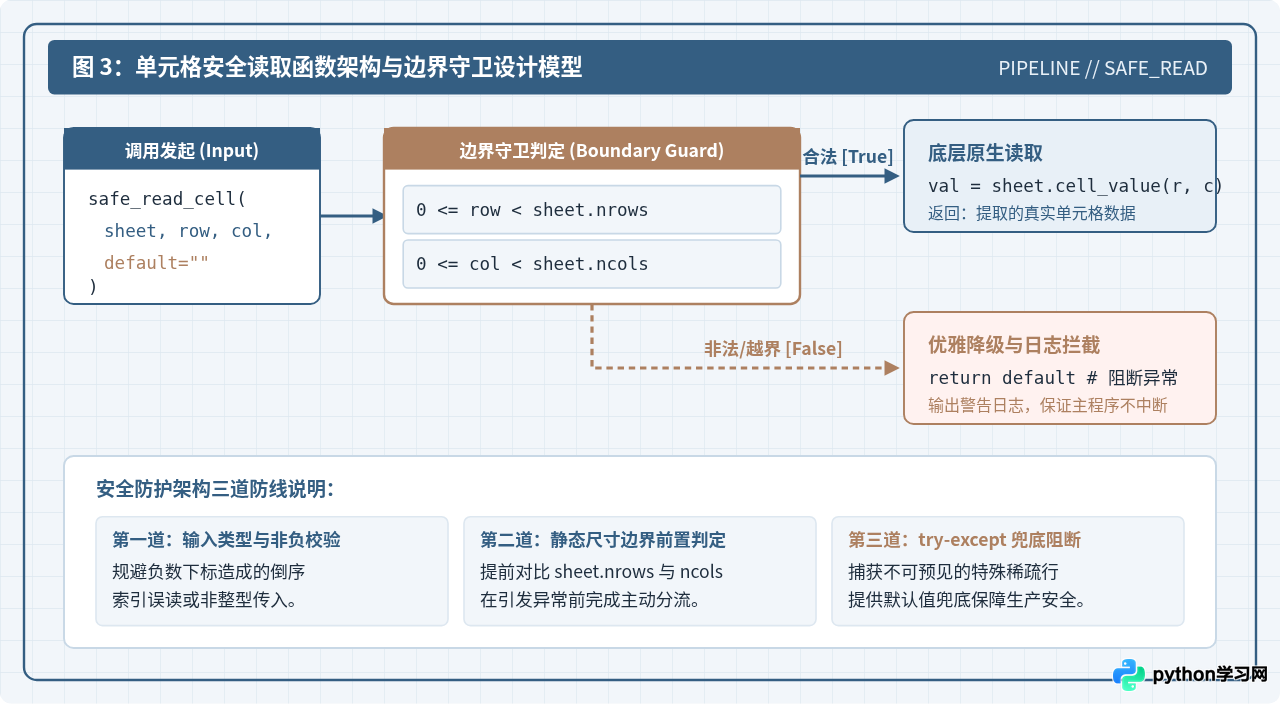
四、结果验证与排查确认
为了确认问题彻底修复,可以在加载文件后编写自检断言或诊断代码,验证代码在正常边界与非法越界条件下的表现:
import xlrd

def verify_sheet_access(file_path):
    book = xlrd.open_workbook(file_path)

    # 1. 验证工作表获取
    print(f"工作簿总工作表数: {book.nsheets}")
    assert book.nsheets > 0, "工作簿不包含任何有效 Sheet"

    sheet = book.sheet_by_index(0)
    print(f"已加载工作表 [{sheet.name}]: nrows={sheet.nrows}, ncols={sheet.ncols}")

    # 2. 空表检测
    if sheet.nrows == 0 or sheet.ncols == 0:
        print("提示:当前工作表为空,跳过单元格访问")
        return

    # 3. 边界测试:首个单元格 (0, 0)
    first_val = sheet.cell_value(0, 0)
    print(f"首单元格 (0, 0) 验证成功,内容: {first_val}")

    # 4. 边界测试:最后一个有效单元格 (nrows-1, ncols-1)
    last_val = sheet.cell_value(sheet.nrows - 1, sheet.ncols - 1)
    print(f"末单元格 ({sheet.nrows - 1}, {sheet.ncols - 1}) 验证成功,内容: {last_val}")

    # 5. 循环验证:标准遍历范式
    print("开始遍历全部行首列...")
    for r in range(sheet.nrows):
        _ = sheet.cell_value(r, 0)
    print("遍历完成,无越界异常!")

# 执行验证
# verify_sheet_access("sample_data.xls")注意:xlrd 2.0.0 之后的版本官方已正式移除了对 .xlsx 格式的支持。如果读取的文件是 .xlsx 格式,直接使用 xlrd 会抛出 XLRDError: Excel xlsx file; not supported;此时建议使用 openpyxl 库。使用 openpyxl 时需特别注意:其原生 cell(row, column) 采用的是 1 基索引(即 row=1, column=1),切勿混淆两者的索引规则。
五、核心要点与排查速查
通过掌握下述速查卡片,可在遇到各类单元格索引异常时迅速定位症结并规避重复出错:
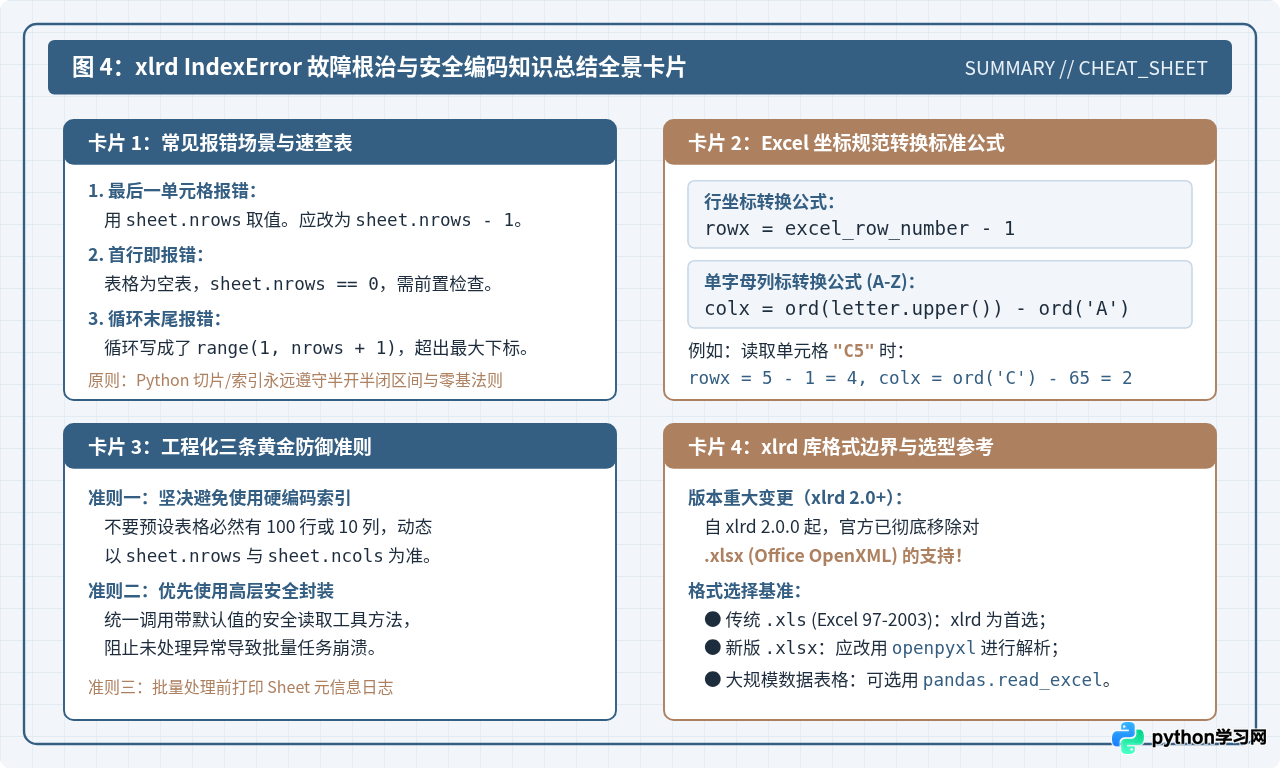
| 场景 | 典型错误代码 | 报错原因 | 标准修复方式 |
|---|---|---|---|
| 读取末尾行/列 | sheet.cell_value(sheet.nrows, 0) |
误把元素总数当成了最大合法下标 | 使用 sheet.nrows - 1 |
| 自然语言混淆 | sheet.cell_value(1, 1) 读 A1 |
A1 对应的 0 基下标为 (0, 0) | 统一减 1:(row - 1, col - 1) |
| 全表迭代 | range(1, sheet.nrows + 1) |
循环上限超出了有效行范围 | 改用 range(sheet.nrows) |
| 动态未知表格 | 直接调用 cell_value 未判空 |
空表 nrows=0 导致直接越界 |
前置判断 0 <= r < sheet.nrows |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









