

Python爬虫数据解析:XPath与CSS选择器的高效提取技巧

在编写Python网络爬虫时,通过网络请求库拿到HTML源码只是第一步,核心任务是从纷繁复杂的DOM结构中准确、高效地提取出目标文本、属性或链接。XPath与CSS选择器是当前爬虫开发中最主流的两套解析定位语法,无论是在lxml、parsel还是Scrapy中均被广泛支持。理解两者的底层匹配机制、掌握高频提取表达式与避坑规则,是提升爬虫开发效率与程序稳定性的关键基石。
一、网页DOM树与两种选择器的解析机制
浏览器加载HTML后会将其构建为树状的对象模型(DOM,Document Object Model)。每一个HTML标签对应树上的一个元素节点,标签内的文字对应文本节点,属性则是元素的属性节点。爬虫数据解析的本质,就是沿着这棵树的层级结构定位目标节点并抽取数据。
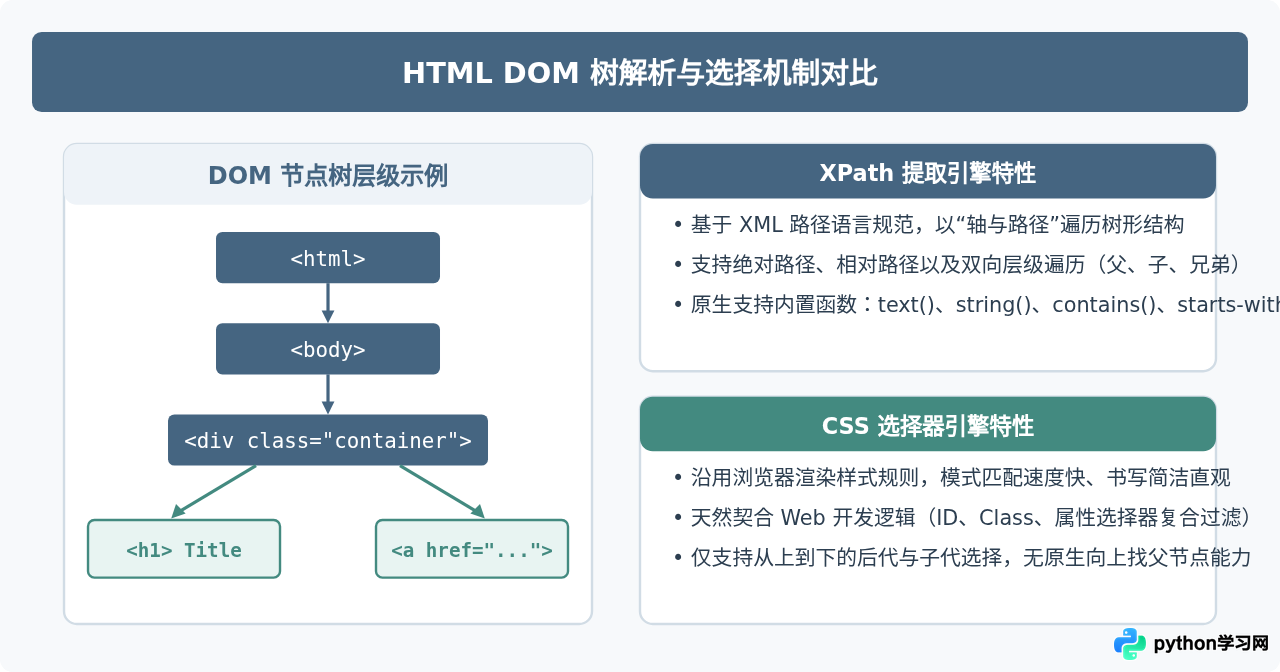
在Python生态中,最常用的解析工具包括:
- lxml:基于 C 语言编写的
libxml2和libxslt库封装,解析效率极高,原生提供完善的 XPath 1.0 支持。 - parsel:Scrapy 团队提取出的通用选择器库,底层依托 lxml,同时封装了极其易用的
.xpath()与.css()混合调用接口,并扩展了伪元素语法。
二、XPath 高效提取实战与避坑指南
XPath(XML Path Language)利用路径表达式在 XML 或 HTML 文档中导航。编写 XPath 规则时,掌握从根匹配与相对匹配的区别至关重要。
1. 常用节点定位与属性获取语法
//tagname:在全文档范围内查找所有名为tagname的元素,不限制层级深度。/:从当前节点选取直接子节点。[@attr='val']:属性谓词过滤。例如//div[@id='content']精确匹配 id 属性为 content 的 div。/@attr:提取属性值。例如//a/@href直接获取所有 a 标签的链接。/text():获取当前节点的直接文本内容。string(.):获取当前节点及其所有后代节点的全部拼接文本,常用于富文本段落提取。
2. 高级函数匹配
现实抓取中,很多标签的 class 往往包含多个动态类名(例如 class="news-card active fl")。此时直接使用等号 @class='news-card' 将匹配失败,必须使用 contains() 函数:
# 匹配包含特定类名的节点
tree.xpath("//div[contains(@class, 'news-card')]")

# 匹配属性以某字符串开头的节点
tree.xpath("//a[starts-with(@href, 'https://article')]")

# 获取包含指定文本的按钮或标签
tree.xpath("//button[contains(text(), '下一页')]")
避坑核心:循环遍历列表项时的相对路径错误
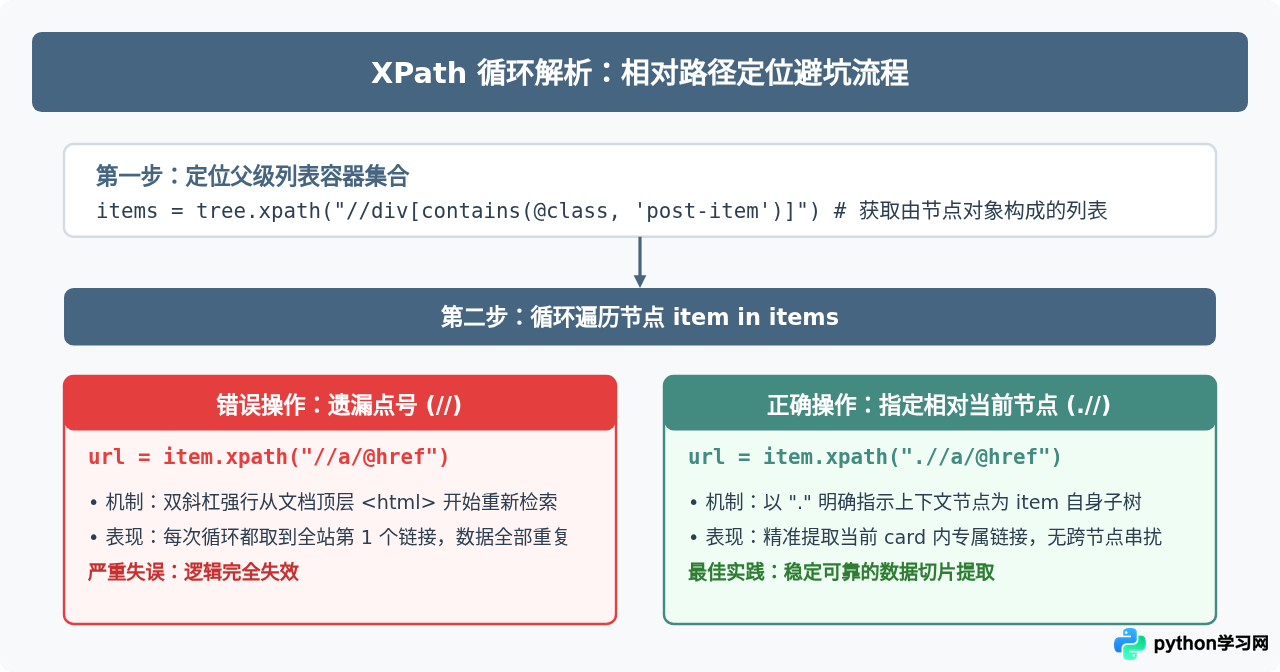
初学者极易犯的典型错误是在遍历父级元素列表时,误用 // 而非 .//。在 XPath 规范中,即使你在一个局部节点对象上调用 .xpath("//a/@href"),开头的双斜杠依然代表从整个文档根节点开始检索,导致每一次循环取出来的都是全网页的第一个 a 标签。正确的写法必须是以圆点开头的 .//,表示从当前节点向下查找。
三、CSS 选择器高效提取技巧
CSS 选择器语法与现代前端开发习惯完全一致,语法短小清晰,阅读成本极低。借助 parsel 库提供的伪类与伪元素扩展,CSS 选择器提取效率极为强劲。
1. 常见选择器模式
#main-title:ID 选择器,唯一定位。.entry-content:类选择器,匹配置有该 class 的元素。div.card > h3:子代选择器,严格匹配div.card下的直接子元素h3。ul.nav a:后代选择器,匹配ul.nav下任意层级的所有a标签。li:nth-child(2):伪类选择器,选取其父元素下的第 2 个子元素。a[href^="https://"]:属性匹配,匹配 href 以 https:// 开头的链接。
2. parsel 库中的语法糖:::text 与 ::attr()
原生 CSS 选择器主要用于样式命中,并不提供获取文本或属性的语法。parsel 为此扩展了专有伪元素语法:
from parsel import Selector

selector = Selector(text=html_content)

# 提取标签内文本
titles = selector.css("div.post-card h2::text").getall()

# 提取特定属性
image_urls = selector.css("img.thumb::attr(src)").getall()

# 提取首个匹配项并提供默认值
first_title = selector.css("h1.main::text").get(default="未命名")
四、XPath 与 CSS 选择器核心语法对比
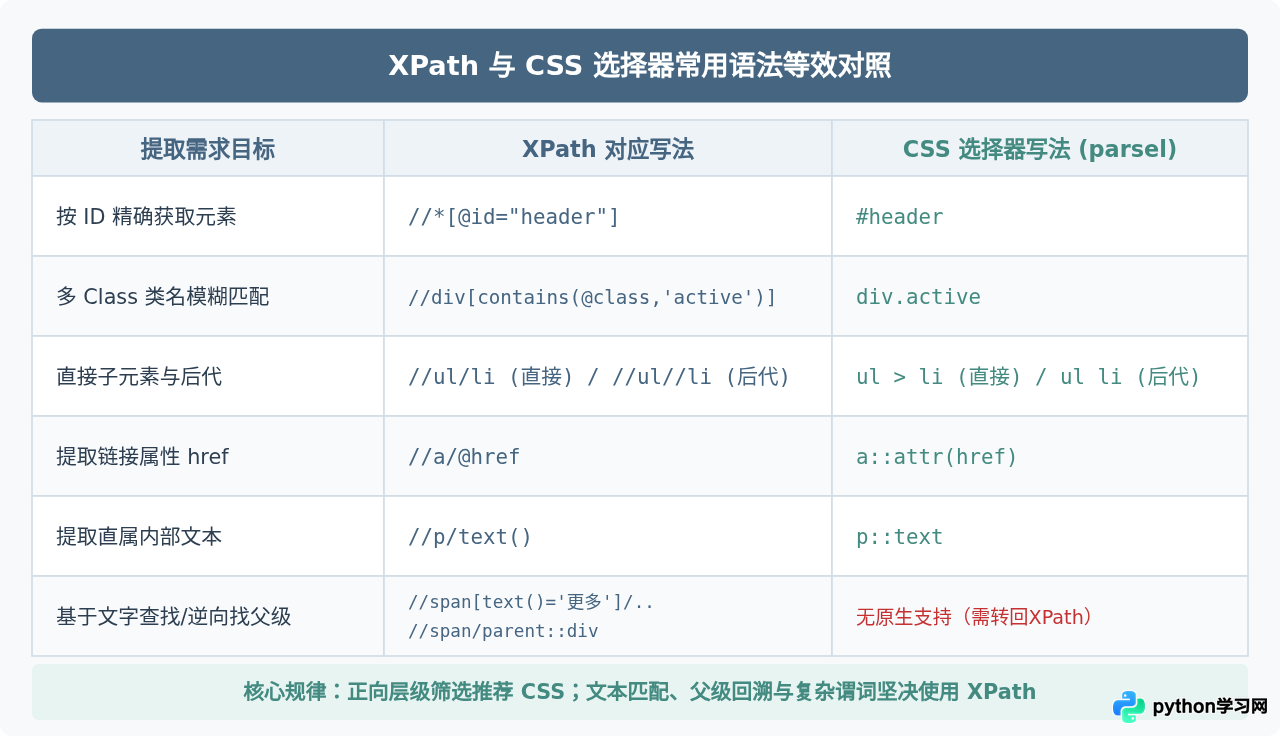
在面对复杂解析任务时,清晰掌握两者的等效转换规则有助于根据网页特征挑选最便捷的选择器。
五、工程化实战:混合提取与性能优化
在真实抓取场景下,我们往往并不拘泥于单一语法,而是采用两者结合的最佳实践。例如,用简短的 CSS 选择器快速锚定大容器,再用 XPath 的精准文本或轴关系进行深度细化。
1. 完整实战代码示例
from parsel import Selector

html_doc = """
<div class="container">
    <div class="article-box item-1" data-id="101">
        <h2 class="title"><a href="/detail/101.html">Python爬虫性能优化指南</a></h2>
        <div class="meta">
            <span class="author">张工</span>
            <span class="views">浏览量: <b>1250</b></span>
        </div>
    </div>
    <div class="article-box item-2" data-id="102">
        <h2 class="title"><a href="/detail/102.html">XPath与CSS选择器深度对比</a></h2>
        <div class="meta">
            <span class="author">李工</span>
            <span class="views">浏览量: <b>3420</b></span>
        </div>
    </div>
</div>
"""

sel = Selector(text=html_doc)

# 1. 使用 CSS 选择器提取父级卡片列表
cards = sel.css("div.article-box")

results = []
for card in cards:
    # 2. CSS 提取简单属性与标题
    title = card.css("h2.title a::text").get()
    href = card.css("h2.title a::attr(href)").get()

    # 3. 混合使用 XPath 相对路径提取深层嵌套富文本 (使用 string 拼接 b 标签内部数字)
    views_text = card.xpath(".//span[@class='views']//text()").getall()
    clean_views = "".join(views_text).replace("浏览量:", "").strip()

    # 4. XPath 向上追溯或属性获取
    data_id = card.xpath("./@data-id").get()

    results.append({
        "id": data_id,
        "title": title,
        "link": href,
        "views": clean_views
    })

print("提取结果:", results)
2. 性能提升关键准则
- 避免滥用全文档深搜
//*:在几万行的巨大 HTML 文档中,盲目的深层搜索会导致 DOM 全表扫描。务必先找到具有唯一 ID 或特定语义的父容器,缩窄搜索范围。 - 优先编译复用 XPath 表达式:在处理数万级页面的高频解析循环中,若使用
lxml.etree,可通过etree.XPath("//div[@class='item']")预先编译表达式,避免每次解析都重复构建抽象语法树。 - 正确处理空值兜底:Web 页面常有缺失字段。使用
.get(default="")能有效避免因提取失败引发的IndexError,大幅提升生产爬虫的容错健壮性。
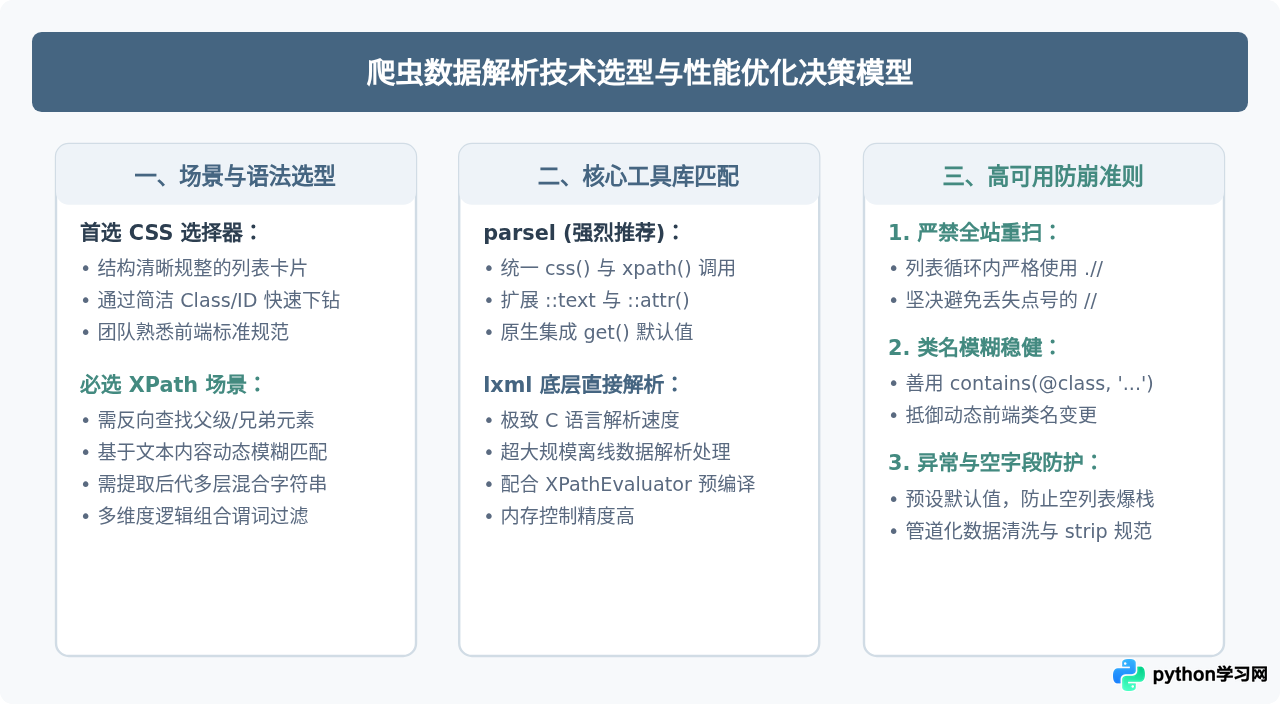
总结而言,XPath 与 CSS 选择器并不存在绝对的优劣之分,而是相辅相成的互补工具。在实际工程项目中,推荐将 CSS 选择器用于页面宏观容器的快速定位与标准属性抓取,同时保留 XPath 用于处理文本内容查找、向上追溯父容器及复杂的谓词逻辑。两者协同运用,并严格遵守局部相对定位 .// 规范,便能在面对各类动态、复杂的 Web 结构时游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









