

Python怎么对字典列表按指定键值进行排序
详细解析在Python中如何使用sorted()和sort()方法对字典列表按指定键值进行排序,包含lambda表达式、operator.itemgetter性能对比、多字段混合排序与缺失键容错处理。
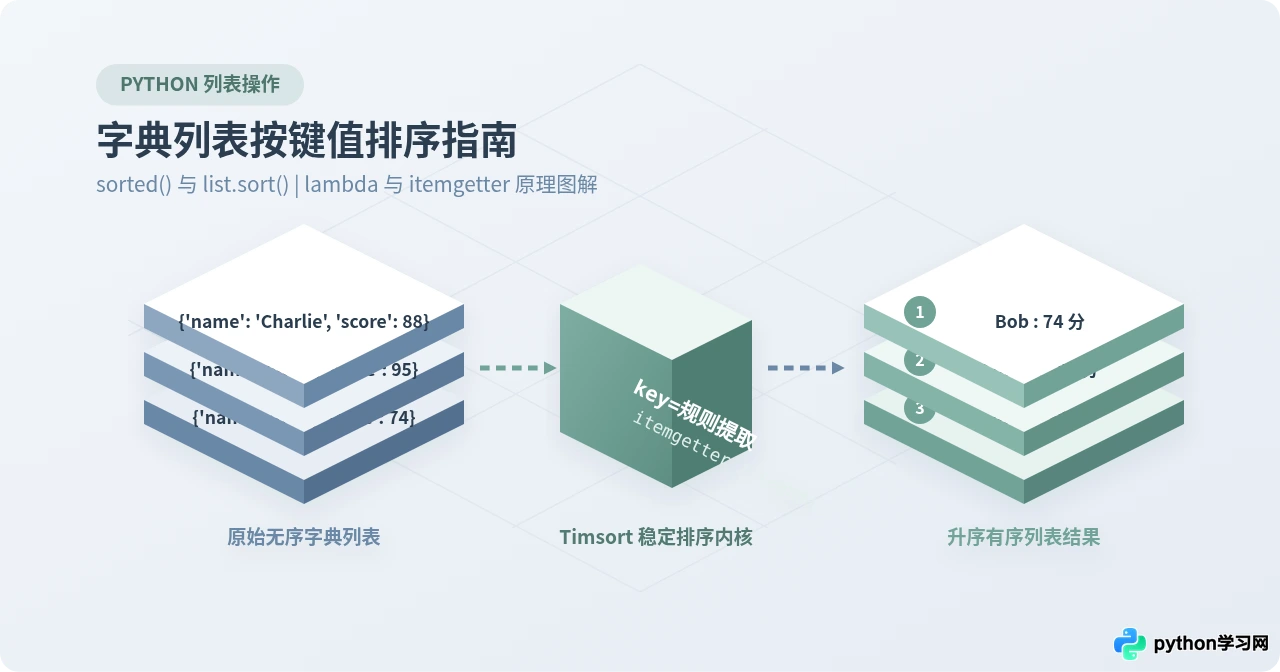
sorted() 函数或列表对象的 list.sort() 方法,并通过 key 参数指定提取字典字段的规则。常规业务开发中最推荐使用标准库 operator.itemgetter,其在 C 语言层执行且语法清晰;而在需要做数学计算、格式清洗或缺失键防御时,则搭配 lambda 匿名函数处理。如果需要降序排列,只需在方法中附加 reverse=True 即可。
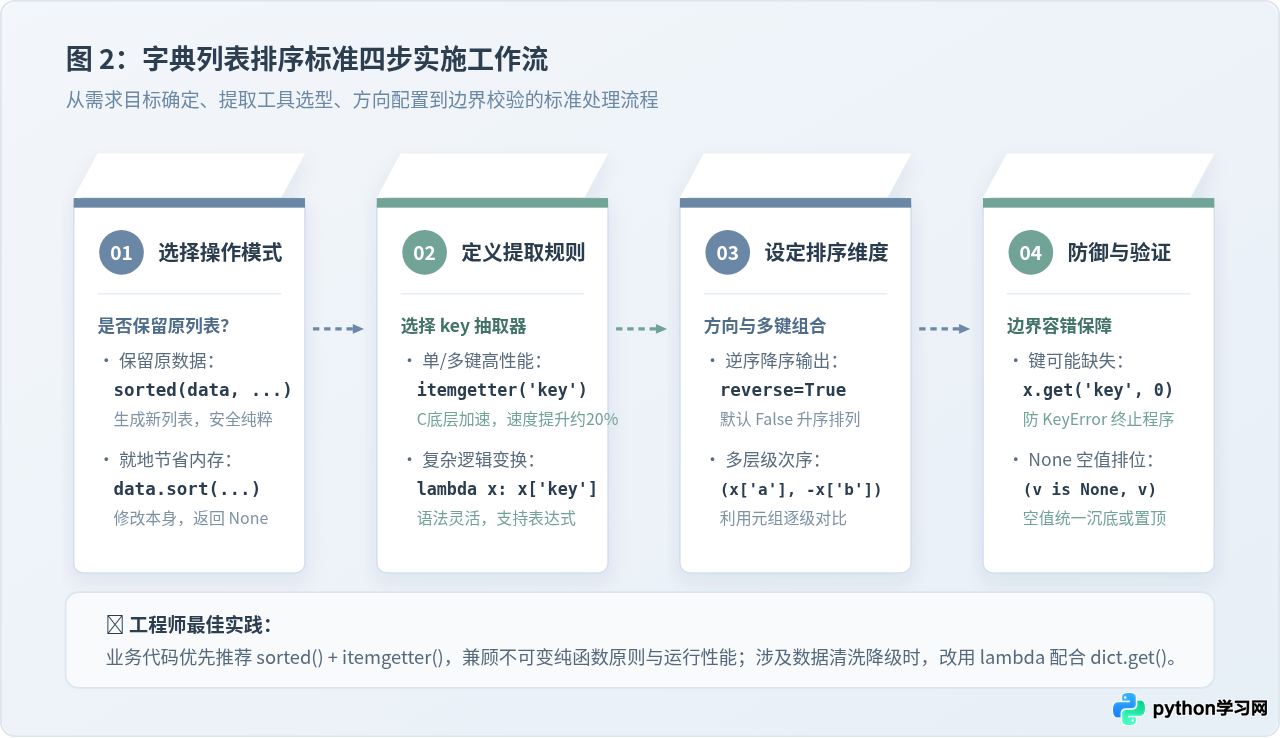
一、排序机制解析:sorted() 与 list.sort() 的选型
在编写排序代码之前,首先需要明确一个核心选择:排序后是需要生成一个全新的有序列表,还是允许直接修改原列表。Python 为此提供了两种基础工具:
sorted(iterable, key=..., reverse=False):内置函数,接收任何可迭代对象,排序后返回一个全新的列表。原始字典列表保持原封不动。list.sort(key=..., reverse=False):列表对象的内置方法,直接在原始列表的内存空间中进行重排(原地修改),该方法执行后返回值为None。
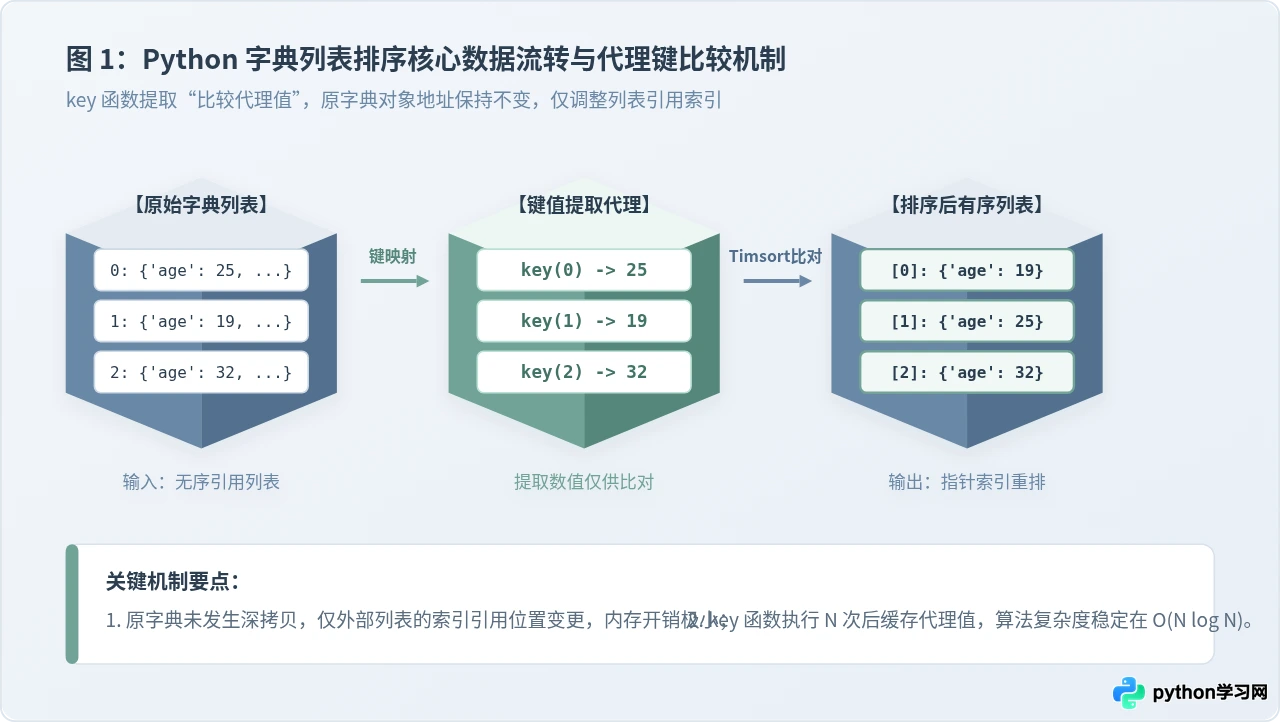
无论采用上述哪种方式,其内部使用的排序算法都是 Timsort(一种结合了归并排序与插入排序的高性能稳定算法)。在对字典列表进行排序时,字典本身并不能直接比较大小(Python 3 中字典之间无法直接使用小于号 < 对比),因此必须通过 key 参数传入一个提取函数。这个提取函数会作用于列表中的每一个字典,提取出可比较的代理键(如整数、浮点数或字符串),Timsort 引擎随后依据代理键调整列表内字典引用的前后顺序。
二、方法一:使用 lambda 匿名函数指定排序键
lambda 是最直观的单行函数定义方式。当我们需要按字典中的某个字段(例如学生的成绩 score)排序时,可以将每个字典对象映射为其键值:
# 示例:使用 lambda 按指定键值进行升序与降序排序
students = [
    {"name": "Alice", "score": 95},
    {"name": "Bob", "score": 74},
    {"name": "Charlie", "score": 88}
]

# 1. 默认升序(成绩由低到高)
sorted_by_score_asc = sorted(students, key=lambda item: item["score"])

# 2. 降序排序(成绩由高到低,添加 reverse=True)
sorted_by_score_desc = sorted(students, key=lambda item: item["score"], reverse=True)

print("升序结果:", sorted_by_score_asc)
print("降序结果:", sorted_by_score_desc)降序结果: [{'name': 'Alice', 'score': 95}, {'name': 'Charlie', 'score': 88}, {'name': 'Bob', 'score': 74}]
如果希望就地修改原列表以节省大内存开销,直接调用 students.sort(key=lambda item: item["score"]) 即可。注意不能书写 students = students.sort(...),因为 sort() 的返回值为 None,这样会导致原始变量丢失。
三、方法二:使用 operator.itemgetter 提升执行效率
Python 标准库的 operator 模块提供了专门用于属性与项提取的工具函数 itemgetter。在对大规模字典列表(如数万甚至上百万条数据)排序时,itemgetter 相比于 lambda 拥有更显著的性能优势。
lambda x: x['score'] 在排序的每次比较阶段都需要在 Python 虚拟机层面压栈调用函数对象;而 itemgetter('score') 是由 C 语言在底层直接实现的高效检索器,无需额外的函数调用开销,通常能带来 15% 到 25% 的速度提升。
from operator import itemgetter

products = [
    {"id": 101, "name": "键盘", "price": 299},
    {"id": 102, "name": "鼠标", "price": 99},
    {"id": 103, "name": "显示器", "price": 1299}
]

# 按商品价格 price 从低到高排序
sorted_products = sorted(products, key=itemgetter("price"))

print("按价格升序排序结果:")
for item in sorted_products:
print(f" {item['name']} - ¥{item['price']}")鼠标 - ¥99
键盘 - ¥299
显示器 - ¥1299
四、进阶场景:按多个键进行多级组合排序
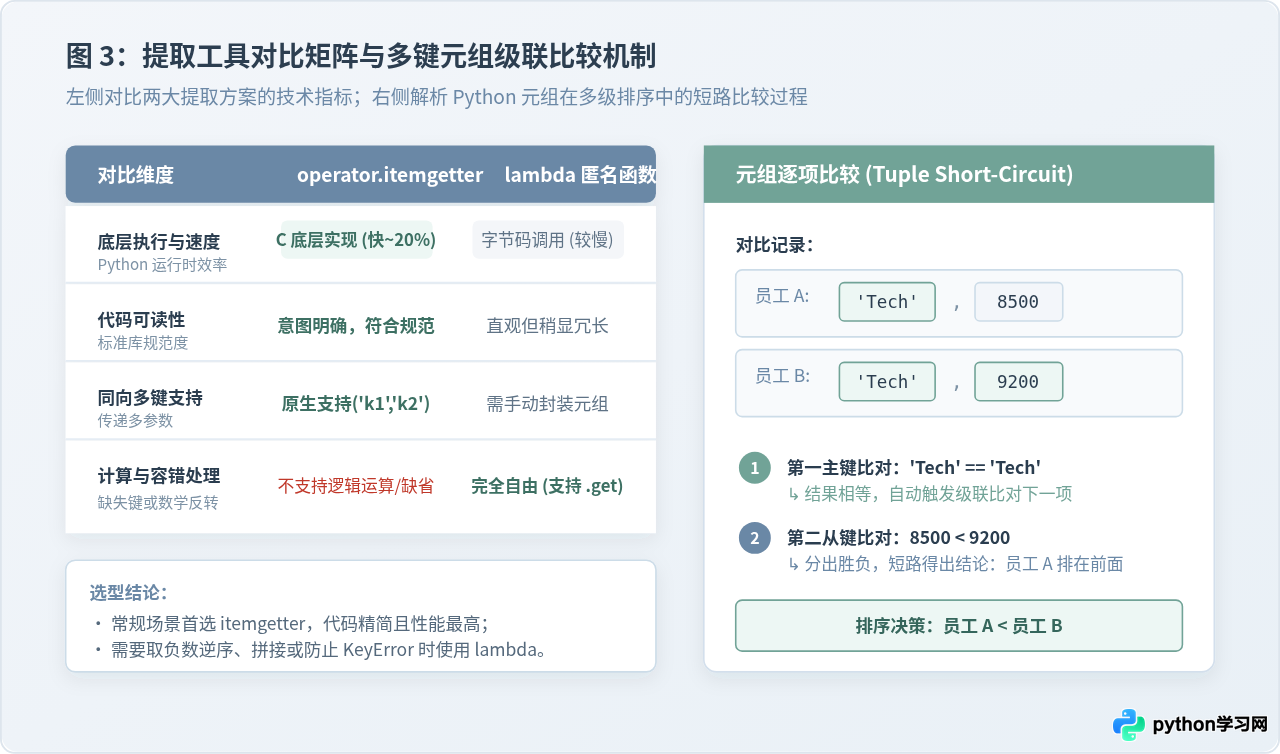
在实际业务中,单键排序往往无法满足要求。例如对员工数据排序时,通常要求“先按部门名称升序排序;若部门相同,再按绩效分数降序排序”。Python 原生支持元组(Tuple)之间的逐项比较机制:
当对比两个元组 (a1, a2) 与 (b1, b2) 时,Python 会首先对比第一项 a1 与 b1;只有当第一项相等时,才会继续对比第二项 a2 与 b2。利用这一特性,我们可以让 key 函数返回一个元组,实现多级排序。
1. 多字段同向排序(均为升序或均为降序)
若所有排序维度的升降方向一致,operator.itemgetter 原生支持传入多个键名,它会自动为每个字典提取由指定字段组成的元组:
from operator import itemgetter

employees = [
    {"name": "赵六", "dept": "技术部", "level": 3},
    {"name": "张三", "dept": "运营部", "level": 2},
    {"name": "李四", "dept": "技术部", "level": 5},
    {"name": "王五", "dept": "技术部", "level": 2}
]

# 先按部门 dept 升序,同部门下按职级 level 升序
sorted_emp = sorted(employees, key=itemgetter("dept", "level"))

print("多键同向升序排序结果:")
for emp in sorted_emp:
print(f" {emp['dept']} - {emp['name']} (Lv.{emp['level']})")技术部 - 王五 (Lv.2)
技术部 - 赵六 (Lv.3)
技术部 - 李四 (Lv.5)
运营部 - 张三 (Lv.2)
2. 多字段异向混排(如字符升序、数值降序)
如果不同字段的排序方向不一致(例如部门要求字母升序,而薪资或绩效要求数值降序),由于 reverse 参数只能全局作用于整个元组,此时可以通过数值取反(-value)的技巧快速实现异向混排:
staff = [
    {"name": "Alice", "dept": "Dev", "salary": 12000},
    {"name": "Bob", "dept": "Dev", "salary": 18000},
    {"name": "Charlie", "dept": "Dev", "salary": 15000},
    {"name": "David", "dept": "Art", "salary": 14000}
]

# 部门 dept 升序,薪资 salary 降序(通过对数值加负号改变比较大小)
mixed_sorted = sorted(staff, key=lambda x: (x["dept"], -x["salary"]))

print("部门升序 + 薪酬降序结果:")
for s in mixed_sorted:
print(f" [{s['dept']}] {s['name']}: {s['salary']}")[Art] David: 14000
[Dev] Bob: 18000
[Dev] Charlie: 15000
[Dev] Alice: 12000
五、边界防范:处理字典缺失键与 None 空值
在处理外部接口数据、爬虫数据或非结构化日志时,并非列表中每一个字典都严格包含目标键,部分字段的值可能还存在 None。如果直接使用 x['key'] 或 itemgetter('key'),程序会立刻抛出 KeyError 或 TypeError。
1. 缺失键容错:使用 dict.get() 提供安全默认值
当字段可能缺失时,改用 lambda x: x.get('key', default) 可以指定当键不存在时的占位默认值,避免程序异常中断:
raw_records = [
    {"user": "u1", "age": 28},
    {"user": "u2"},  # 缺失 age 键
    {"user": "u3", "age": 21}
]

# 缺失 age 的用户统一视作 0 岁排列在最前
safe_sorted = sorted(raw_records, key=lambda x: x.get("age", 0))
print("缺失键兜底排序:", safe_sorted)2. 字段包含 None 空值的稳妥定位
在 Python 3 中,整数与 None 无法直接进行大小对比(会抛出 TypeError: '<' not supported between instances of 'NoneType' and 'int')。如果希望将包含 None 或缺失的数据统一稳定地放置在列表末尾或开头,可以通过布尔标记元组来解耦比较:
items = [
    {"name": "Task A", "priority": 2},
    {"name": "Task B", "priority": None},
    {"name": "Task C", "priority": 1}
]

# 在 Python 中 False < True
# (val is None, val) 会把非 None 归为第 0 组(False),None 归为第 1 组(True),从而将 None 稳定置底
none_last_sorted = sorted(
    items,
    key=lambda d: (d.get("priority") is None, d.get("priority"))
)

print("None 稳定置于末尾结果:")
for t in none_last_sorted:
print(f" {t['name']} - 优先级: {t['priority']}")Task C - 优先级: 1
Task A - 优先级: 2
Task B - 优先级: None
六、总结与选型决策指南
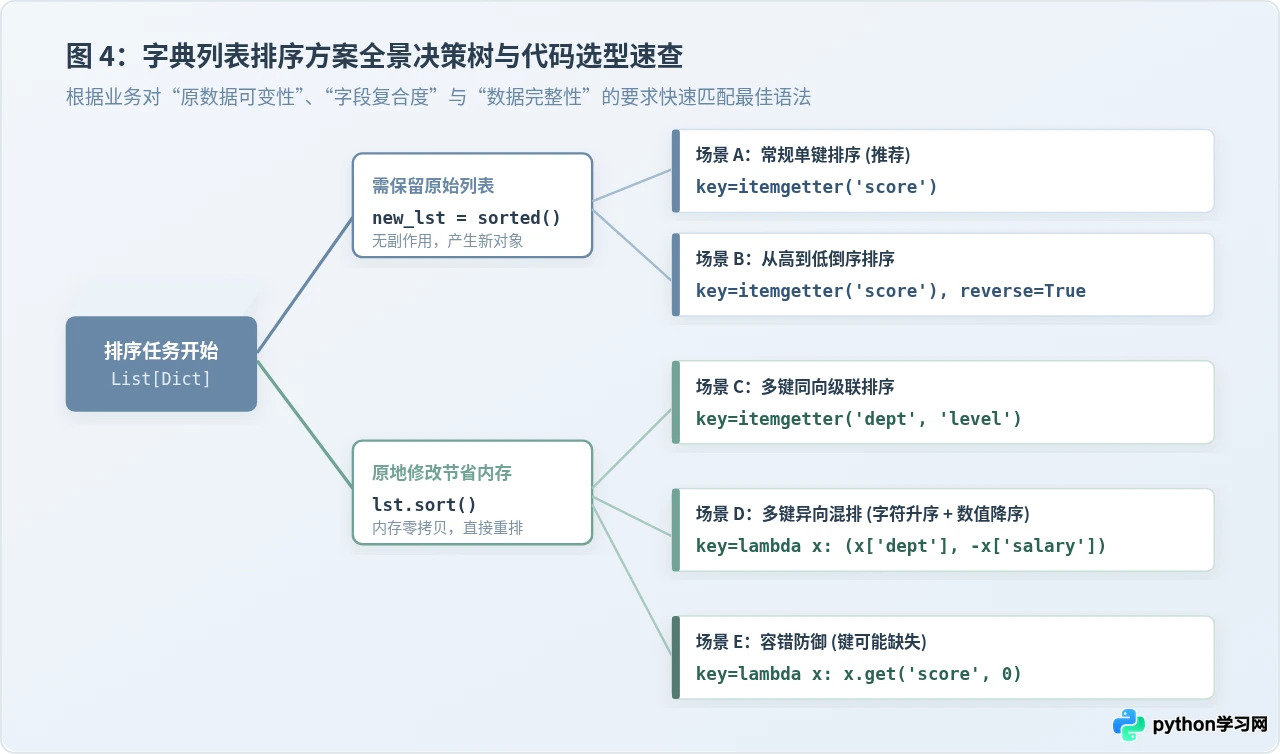
对字典列表排序是 Python 开发中最常见的数据组织操作。为了保证代码既高效又具备鲁棒性,可以依据以下规则进行技术选型:
- 常规单键排序:优先选用
sorted(list, key=itemgetter('key')),保持原数据不变且运行最快。 - 内存敏感场景:处理大型数据集且不需要原顺序时,直接调用
list.sort(key=itemgetter('key'))。 - 多字段同向级联:使用
itemgetter('key1', 'key2'),简洁直观。 - 多字段异向混排:针对数值字段取负数
key=lambda x: (x['k1'], -x['k2'])。 - 非纯净数据源:字典可能缺键或含
None时,必须使用lambda搭配.get()提供安全的默认占位值。
key 提取函数在排序过程中会对每个元素严格执行一次(并在内部缓存供比较使用)。请确保 key 函数内部为轻量计算,避免在 key 中执行耗时的网络请求、文件读取或复杂的正则编译,以确保算法能充分发挥 Timsort 的性能优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









