

Python怎么对字典列表和嵌套列表进行排序
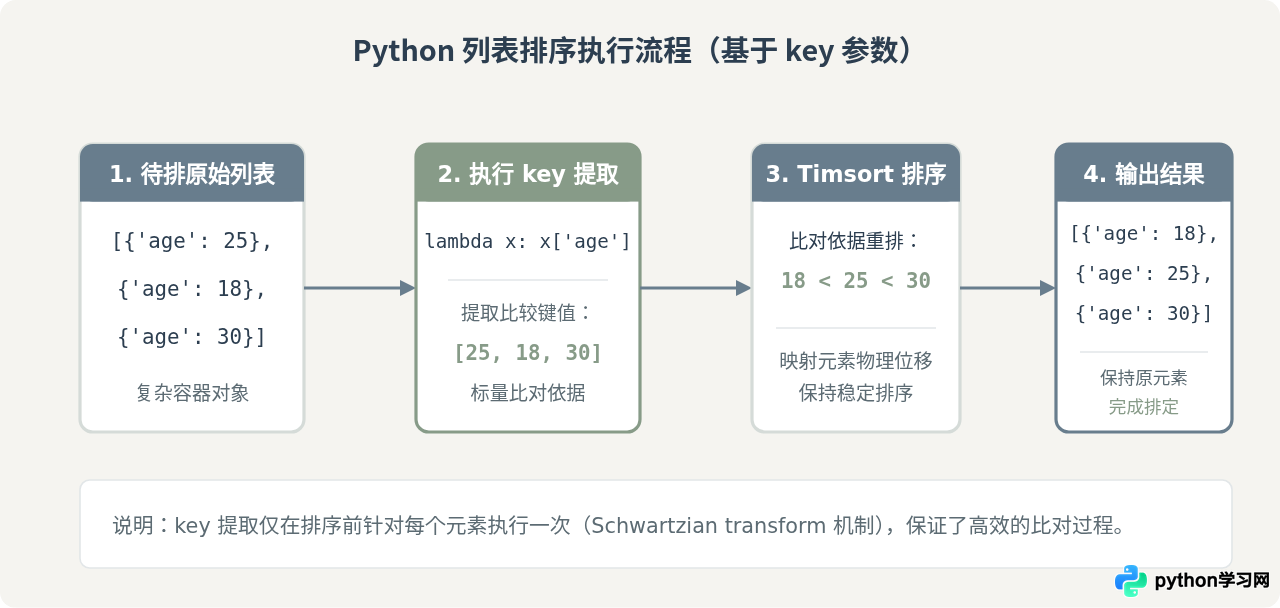
在 Python 中,对包含复杂结构(如字典或子列表)的序列进行排序,核心在于向内置的 sort() 方法或 sorted() 函数提供一个提取比较依据的 key 参数。无论是按字典中指定的键值排序,还是按子列表的某个索引位置排序,Python 都会在底层基于 Timsort 算法提取的计算值完成排序。掌握这一机制,不仅能应对单字段排序,还能从容处理多条件复合排序和缺失键异常。
一、排序的核心机制:sort() 与 sorted()
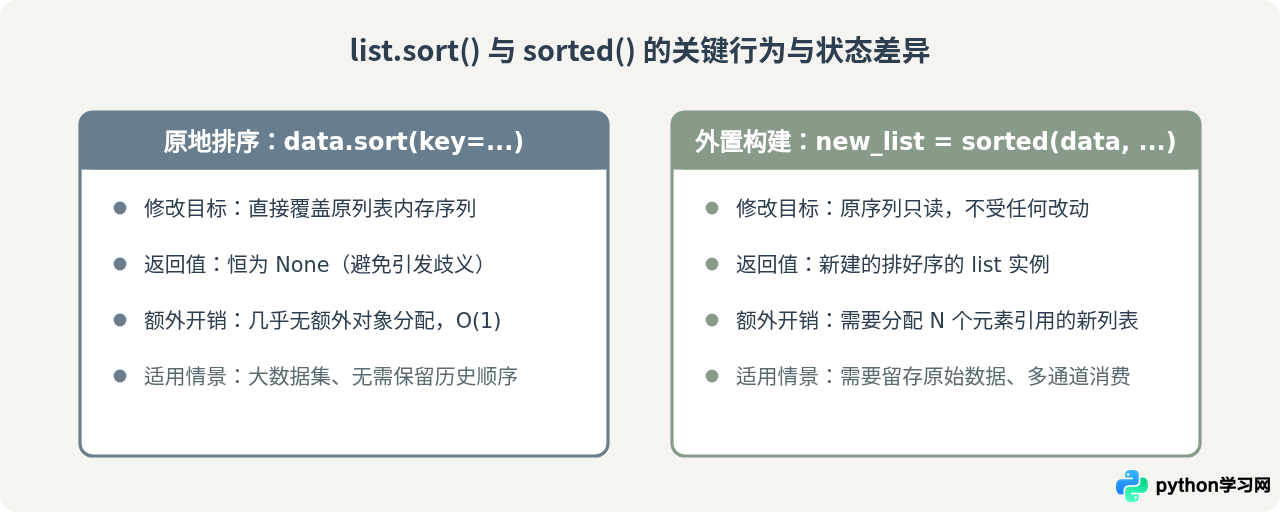
在具体编写排序规则之前,需要先明确 Python 提供的两种排序手段及其差异。这是决定代码是否会产生预期副作用的关键。
list.sort(key=..., reverse=...):列表对象独有的方法。它会直接对原列表进行就地修改(In-place),原列表中元素的存储顺序会被直接重排,该方法返回None。sorted(iterable, key=..., reverse=...):Python 内置的全局函数。它接收任意可迭代对象,并在内存中构造并返回一个全新的列表,原序列保持原封不动。
两种方式都包含一个关键参数 key。key 接收一个单参数可调用对象(例如普通函数、lambda 表达式或类方法)。在排序时,Python 会依次将列表里的每一个元素传入该函数,将其返回值作为实际的比对指标,但最终列表中存放的依然是原本的原始元素。
二、对字典列表进行排序
字典列表中,每个元素都是一个独立的键值映射结构。通常我们需要按照其中某一个指定键的值进行升序或降序排列。
1. 使用 lambda 表达式按单个键排序
这是最直观且常用的方式。通过定义匿名函数,将当前遍历到的字典对象映射为其键值:
students = [
    {"name": "Alice", "score": 88, "age": 20},
    {"name": "Bob", "score": 95, "age": 19},
    {"name": "Charlie", "score": 75, "age": 21}
]

# 按成绩升序排列(生成新列表)
sorted_by_score = sorted(students, key=lambda x: x["score"])

# 按年龄降序排列(原地修改原列表)
students.sort(key=lambda x: x["age"], reverse=True)
2. 使用 operator.itemgetter 提升性能与可读性
Python 标准库的 operator 模块提供了 itemgetter 函数。它的功能相当于在底层用 C 语言级别实现了提取 __getitem__ 的操作,在大数据量列表下往往比 Python 层的 lambda 表达式执行更快:
from operator import itemgetter

# 使用 itemgetter 指定排序键
sorted_students = sorted(students, key=itemgetter("score"))
3. 多字段复合排序
当首要排序字段出现相同值时,往往需要指定次要字段来决胜。在 Python 中,可以通过返回一个元组(tuple)来实现这一需求。Python 在比较两个元组时,会从左到右依次比较元素:
data = [
    {"name": "Jack", "grade": 3, "score": 90},
    {"name": "Lucy", "grade": 2, "score": 95},
    {"name": "Tom", "grade": 3, "score": 85},
    {"name": "Lily", "grade": 2, "score": 90}
]

# 先按年级 grade 升序,若年级相同则按成绩 score 升序
sorted_data = sorted(data, key=lambda x: (x["grade"], x["score"]))

# 也可以直接使用 itemgetter 传入多个参数
from operator import itemgetter
sorted_data_ig = sorted(data, key=itemgetter("grade", "score"))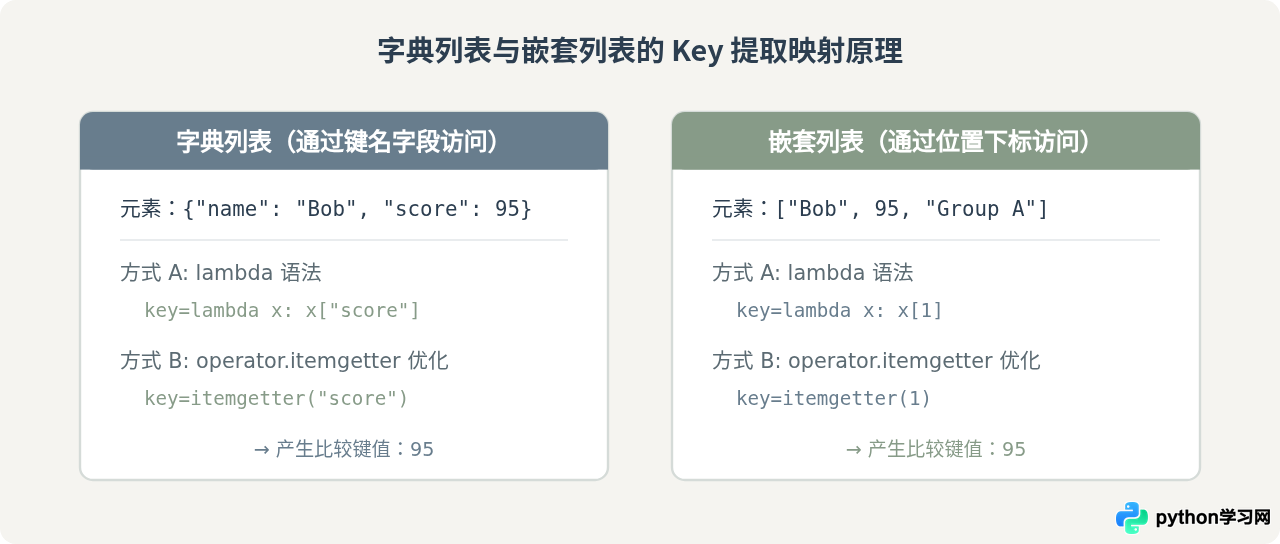
三、对嵌套列表进行排序
嵌套列表是指列表内部的元素仍然是序列(列表或元组)。与字典通过键名访问不同,嵌套列表必须通过数字索引位置(index)来定位字段。
1. 按子列表的指定列索引排序
假设我们有一份员工信息列表,格式为 [姓名, 年龄, 薪资],按薪资(索引 2)进行升序排列:
employees = [
    ["Alice", 28, 7500],
    ["Bob", 22, 6000],
    ["Charlie", 35, 12000],
    ["David", 26, 6000]
]

# 按薪资升序排列
employees_sorted_salary = sorted(employees, key=lambda x: x[2])

# 使用 itemgetter 按年龄升序排列
from operator import itemgetter
employees.sort(key=itemgetter(1))
2. 多列组合与混合正反向排序
当需要按“薪资升序,若薪资相同则按年龄降序”这样正反方向混合的规则排序时,有两种常见方案:
- 数值取反法(仅适用于数值类型):将需要降序的数值字段加上负号
-。 - 利用 Timsort 的稳定性进行多轮排序:先对次要字段排序,再对主要字段排序。
# 方案一:数值取反(薪资升序,年龄降序)
# x[2] 正常升序,-x[1] 将较大年龄变为较小负数从而实现降序
sorted_emp = sorted(employees, key=lambda x: (x[2], -x[1]))

# 方案二:利用稳定排序特性(适用于非数值类型或多方向组合)
# 第一步:先按次要关键字(年龄)降序排
employees.sort(key=lambda x: x[1], reverse=True)
# 第二步:再按主要关键字(薪资)升序排
# 因为 Timsort 是稳定排序,薪资相同的元素会严格保持前一步的相对次序!
employees.sort(key=lambda x: x[2], reverse=False)sort() 串联不同维度的升降序成为可能。
四、进阶场景与常见错误排查
1. 字典中存在缺失键时的安全处理
直接通过 x['key'] 访问时,若某个字典缺少该字段,程序会抛出 KeyError。使用字典的 .get(key, default) 方法可以为缺失键指定保底默认值:
users = [
    {"username": "alpha", "points": 100},
    {"username": "beta"},  # 缺少 points 字段
    {"username": "gamma", "points": 80}
]

# 为缺失 points 的项赋予默认分值 0
sorted_users = sorted(users, key=lambda x: x.get("points", 0))
2. 类型不兼容导致的 TypeError
在 Python 3 中,不同类型之间默认不支持大小比较(例如 str 与 int 或 None 与数值)。如果在同一字段中存在混杂类型,排序会直接中断并抛出 TypeError: '<' not supported between instances of ...。
解决策略: 在 key 函数内部进行统一类型转换或分类包装:
mixed_data = [
    {"id": 1, "value": 50},
    {"id": 2, "value": "100"},
    {"id": 3, "value": 20}
]

# 统一转换为 int 参与比较
sorted_mixed = sorted(mixed_data, key=lambda x: int(x["value"]))| 对比维度 | lambda 匿名函数 | operator.itemgetter |
|---|---|---|
| 实现原理 | 纯 Python 层面的函数调用开销 | CPython 原生 C 语言高效提取器 |
| 代码灵活性 | 极高,支持类型转换、条件判断、默认值 | 固定调用 __getitem__,不支持表达式扩展 |
| 缺失字段处理 | 可使用 .get() 进行优雅降级 |
直接抛出 KeyError 或 IndexError |
| 多字段提取形式 | 返回显式元组:(x['a'], x['b']) |
多参数自动拼装元组:itemgetter('a', 'b') |
| 推荐使用场景 | 含有容错、转换逻辑或方向混排 | 规则简单明确的大规模字典/列表清洗 |
五、总结与排序决策速查
针对不同的数据结构与排序目标,开发者只需按照如下决策路径选择适配的方案:
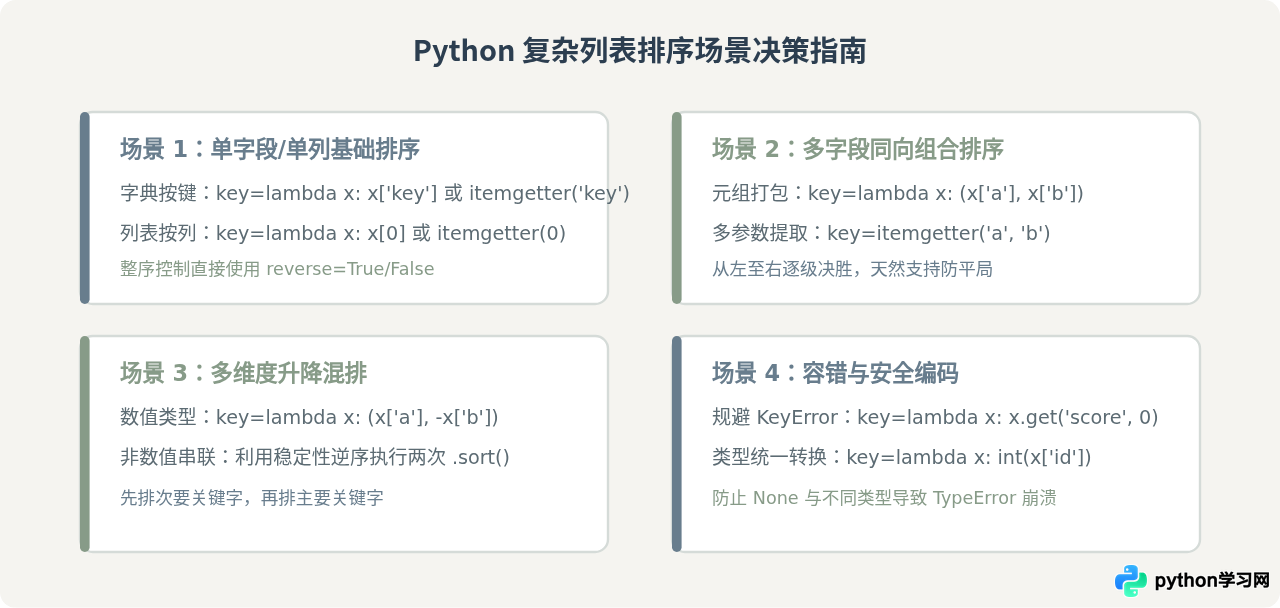
无论是简单的日常脚本还是庞大的数据处理管道,牢记 key 参数只负责“提供比对依据”,配合 Python 稳定的底层排序机制,就能清晰、高效地完成各种复杂序列的排序任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









