

Linux环境中pip与conda安装Python库的区别及选择建议
深入对比Linux操作系统下pip与conda在架构层级、底层二进制依赖、解析算法与隔离机制上的核心差异,提供生产级操作规范与场景选型决策指南。
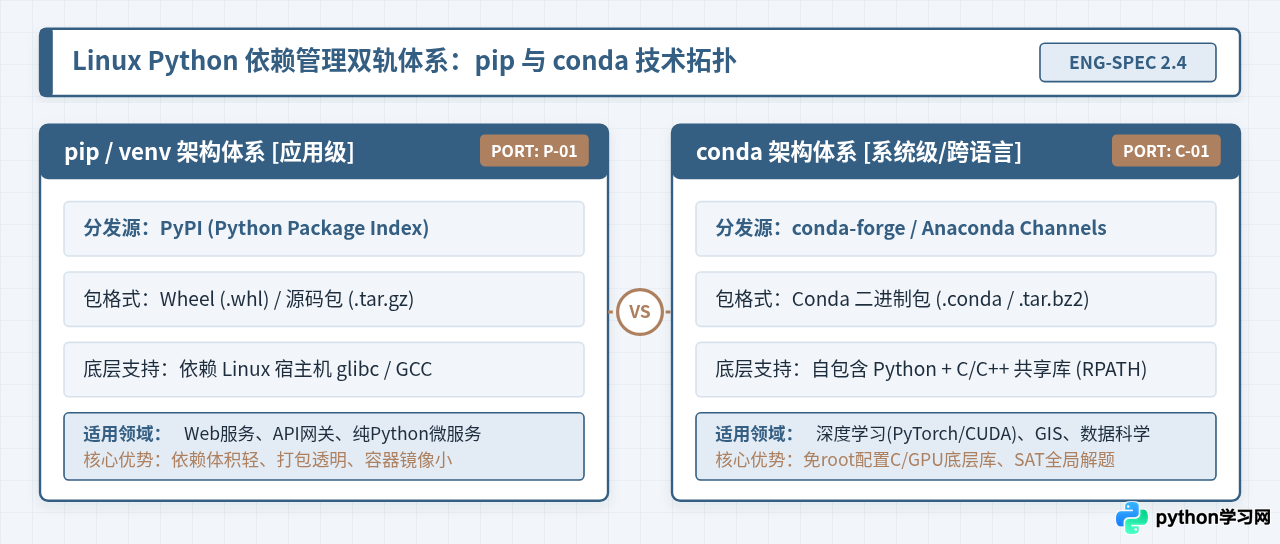
venv + pip;而涉及GPU深度学习、科学计算、空间地理信息以及多版本C/C++依赖隔离的复杂研发环境,首选conda(或搭配mamba)。
一、架构定位与管理层级差异
要在Linux下清晰分辨两个工具的行为,首先必须理解它们在系统调用链条中所处的位置。Linux是一个强依赖动态共享对象(.so文件)与C运行库(glibc)的环境。当一个Python库需要调用底层硬件加速或高性能C代码时,两种工具的处理路径截然不同。
pip的依附型架构:pip本身是一个Python脚本,必须依附于宿主机中已经存在的某个具体Python解释器运行。当使用python3 -m venv myenv创建虚拟环境时,venv只是创建了一个包含bin/和lib/python3.x/site-packages/的目录骨架,并通过软链接指向宿主机全局的Python可执行文件。pip安装的软件包仅存放在该环境的site-packages下。一旦某个包需要编译(缺少对应平台的Wheel),或者需要调用非Python共享库,pip只能转向宿主机系统的编译器(GCC)和全局头文件(如通过apt install python3-dev libpq-dev预先安装的系统依赖)。若系统环境缺少这些底层库,pip将直接报出编译或链接错误。
conda的自包含沙箱架构:与pip不同,conda不是一个单纯的Python包工具,而是一个由C/C++与Python编写的二进制环境管理器。在conda的世界里,Python解释器自身被视为一个普通的二进制软件包(如python=3.10.12)。当在Linux中创建一个conda环境时,它会在$CONDA_PREFIX/lib目录下独立部署配套的C标准库、动态链接器以及相关的系统级共享对象。conda通过Linux的动态链接器机制(如RPATH和RUNPATH硬编码二进制查找路径),强制环境内的可执行文件优先加载本环境私有的.so文件,从而与宿主机的/usr/lib彻底解耦。
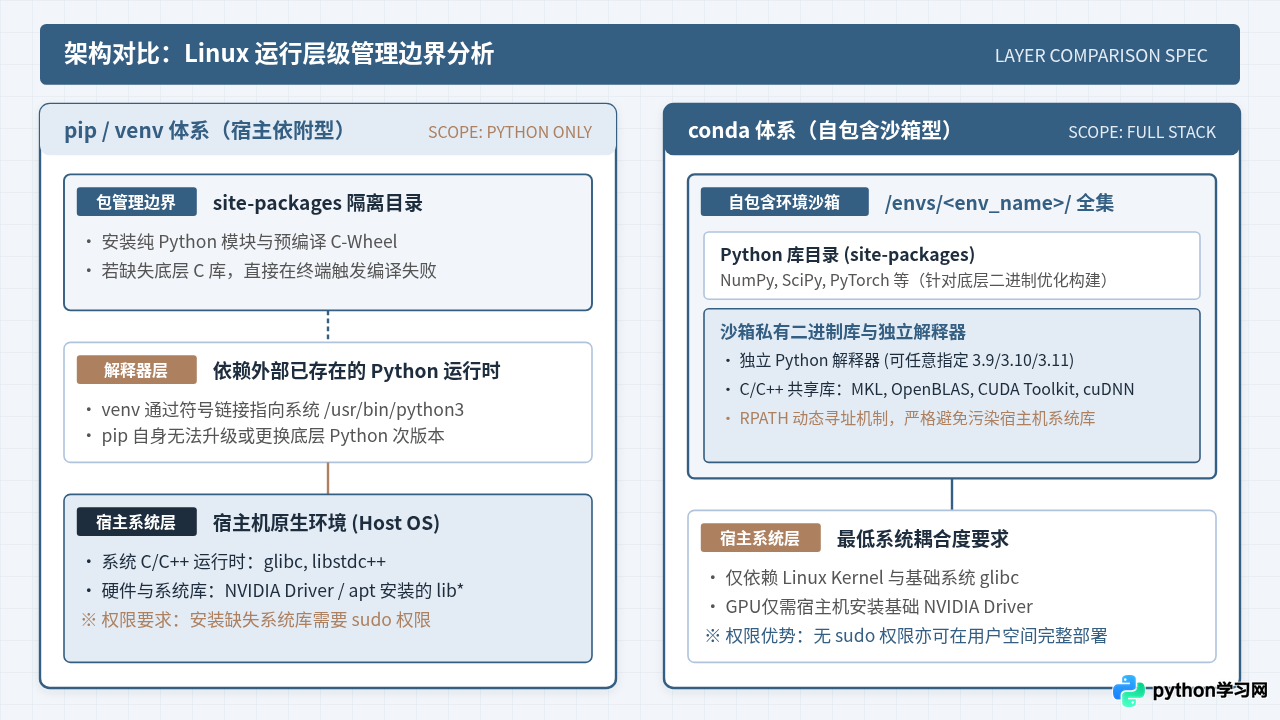
sudo管理员权限去执行apt-get install。此时若使用pip遇到C扩展缺少底层库,安装将彻底卡死;而conda允许普通用户在个人家目录下完整部署一整套包含特定版本CUDA Toolkit与C++运行时的自闭环环境。
二、依赖解析算法与底层二进制处理机制
除管理层级外,两个工具在解析依赖拓扑图时采用的数学模型与冲突防御机制也存在本质差异。在依赖复杂的大型工程中,安装时是否会发生意外覆盖或环境破损,完全取决于底层的解析算法。
1. pip 的启发式回溯机制(Backtracking Resolver)
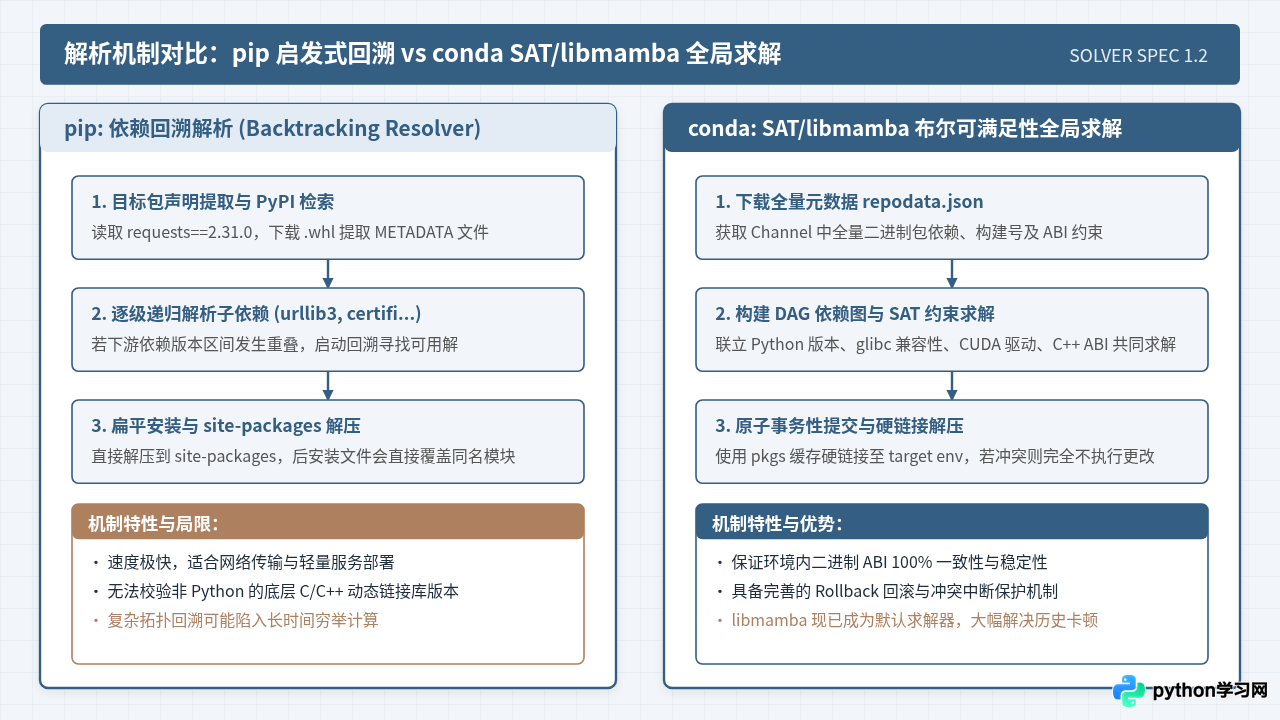
现代pip(pip 20.3之后)引入了基于回溯算法的新解析器。当用户执行pip install packageA packageB时,pip会逐个从PyPI拉取元数据,推导版本交集。若发现版本冲突,pip会沿着依赖链回退并尝试下载上一个兼容版本。
然而,pip的解析边界仅限于Python生态。pip无法感知Linux宿主机已加载的动态库ABI版本。例如,当系统中同时存在依赖特定BLAS版本的两个科学计算库时,pip只能基于Wheel元数据中的Python版本进行粗粒度匹配。一旦两个Wheel内部打包的C动态库产生符号冲突,Python在运行时便会抛出臭名昭著的Segmentation fault (core dumped)(段错误),而pip在安装阶段对此毫无感知。
2. conda 的布尔可满足性全局求解器(SAT / libmamba)
conda将包管理问题抽象为运筹学中的布尔可满足性问题(Boolean Satisfiability Problem, SAT)。在安装之前,conda会从配置的软件源(如conda-forge)下载完整的repodata.json,其中详细记录了每一个二进制包的精确约束,包括Python版本、C++ ABI标签、编译通道、glibc版本以及CUDA构建号。
求解器将所有约束条件输入SAT方程进行全局联立求解。如果找到可行解,conda会给出涵盖所有层级(从底层so库到上层Python模块)的一致性变更计划;如果不存在可行解,求解器会直接报错并终止,确保宿主磁盘上的现有环境不被破坏。以往经典conda使用纯Python编写的pycosat求解器,在元数据庞大时会出现长时间卡在Solving environment...的现象;目前conda已原生集成C++编写的高性能libmamba求解器,求解效率已得到质的提升。
三、Linux生产与研发协同标准操作步骤
理解原理后,在真实的Linux终端中建立规范的工作流是避免依赖混乱的根本手段。无论是选择纯pip路线还是conda路线,都必须遵循严格的隔离与验证准则。
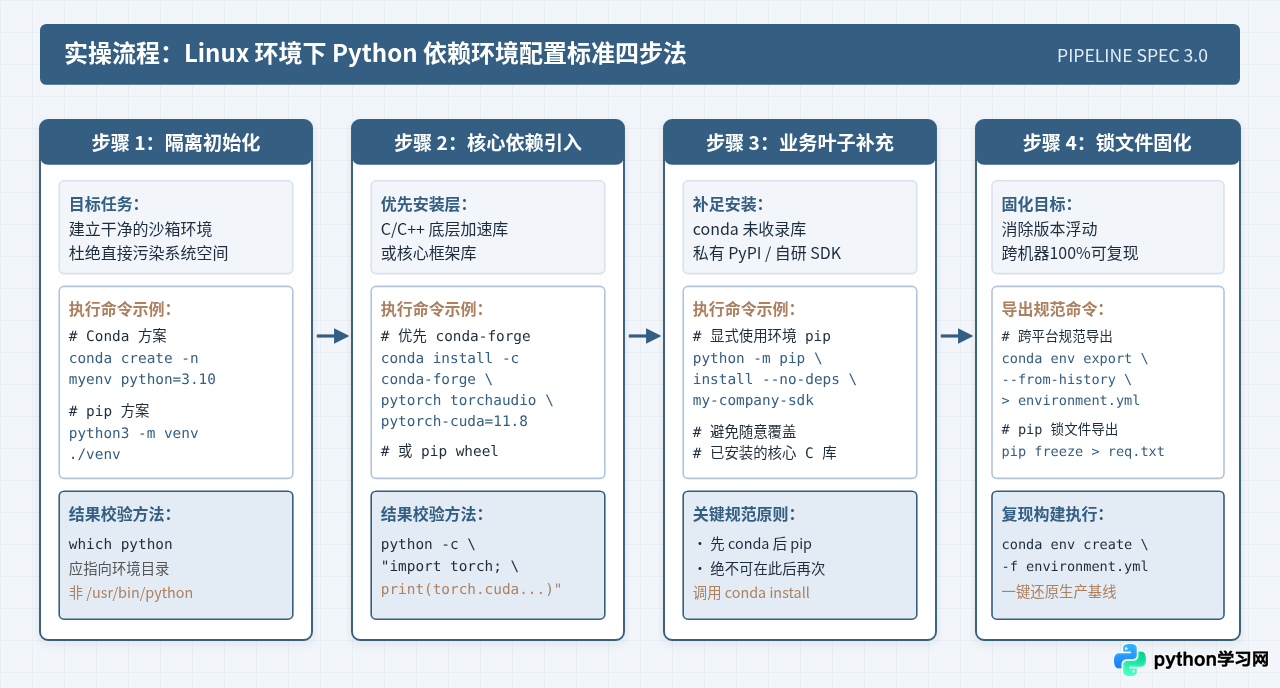
步骤 1:创建并激活严格隔离的环境
切忌在Linux系统中直接以root身份运行pip install或直接在conda的base环境中堆积库。应始终根据项目生命周期创建独立沙箱:
# 指定精确的 Python 次版本,并设置默认从 conda-forge 严格解析
conda create -n prj_cv_py310 python=3.10 -c conda-forge --override-channels -y
conda activate prj_cv_py310# 使用 Linux 系统原生 Python 3 创建隔离虚拟环境
python3 -m venv /opt/deploy/envs/api_service_env
source /opt/deploy/envs/api_service_env/bin/activate激活环境后,务必立即校验当前终端环境变量,确认当前生效的Python执行路径已切换至沙箱内:
which python && which pip步骤 2:核心依赖引入与硬件加速绑定
对于需要GPU加速、数学内核优化或复杂底层图形库(如OpenCV、GDAL)的项目,优先通过conda安装预编译的二进制全家桶。以安装带CUDA 11.8支持的PyTorch为例:
conda install pytorch torchvision pytorch-cuda=11.8 -c pytorch -c nvidia -y完成后在终端执行一行验证代码,确保CUDA运行时动态库已正确加载且设备就绪:
python -c "import torch; print('CUDA Available:', torch.cuda.is_available()); print('Device Count:', torch.cuda.device_count())"步骤 3:业务叶子节点的混用规范
在实际开发中,经常会遇到某些专有SDK、企业内部私有包或新兴的开源库仅发布在PyPI上,并未收录于conda-forge通道。此时必须采用“先conda打底,后pip补充”的铁律:
- 使用显式调用方式:永远使用
python -m pip install代替裸pip install,确保安装目标必定与当前正在运行的Python解释器路径绑定。 - 禁止后续逆向操作:在当前环境中执行过
pip install之后,严禁再次使用conda install安装其他依赖包。因为conda无法完整回溯pip写入site-packages的修改记录,再次调用conda很可能会静默降级或覆盖pip引入的库,导致整个虚拟环境被破坏。
# 显式使用当前激活环境下的 python 解析器安装私有库
python -m pip install --no-cache-dir my-internal-rpc-client==1.4.2
步骤 4:锁文件固化与多节点可复现复刻
为了保证团队协作与自动化CI/CD能够无误构建,必须将环境依赖状态沉淀为文本锁文件。
Conda 环境导出规范:请避免直接运行无参数的conda env export,因为该命令会将包含Linux本地编译哈希值(如=h14c3975_1002)的全部底层构件倾倒出来,极易导致跨机器甚至跨小版本Linux发行版还原时失败。推荐使用--from-history参数导出核心声明:
conda env export --from-history > environment.ymlpip 体系导出规范:在纯venv环境中,直接使用标准freeze命令冻结确切版本:
pip list --format=freeze > requirements.txt四、典型场景选型依据与决策路径
在实际Linux工程实践中,盲目统一使用某一种工具往往会导致运维困难或镜像冗余。读者应结合部署形态、性能要求及团队基础设施进行权衡。
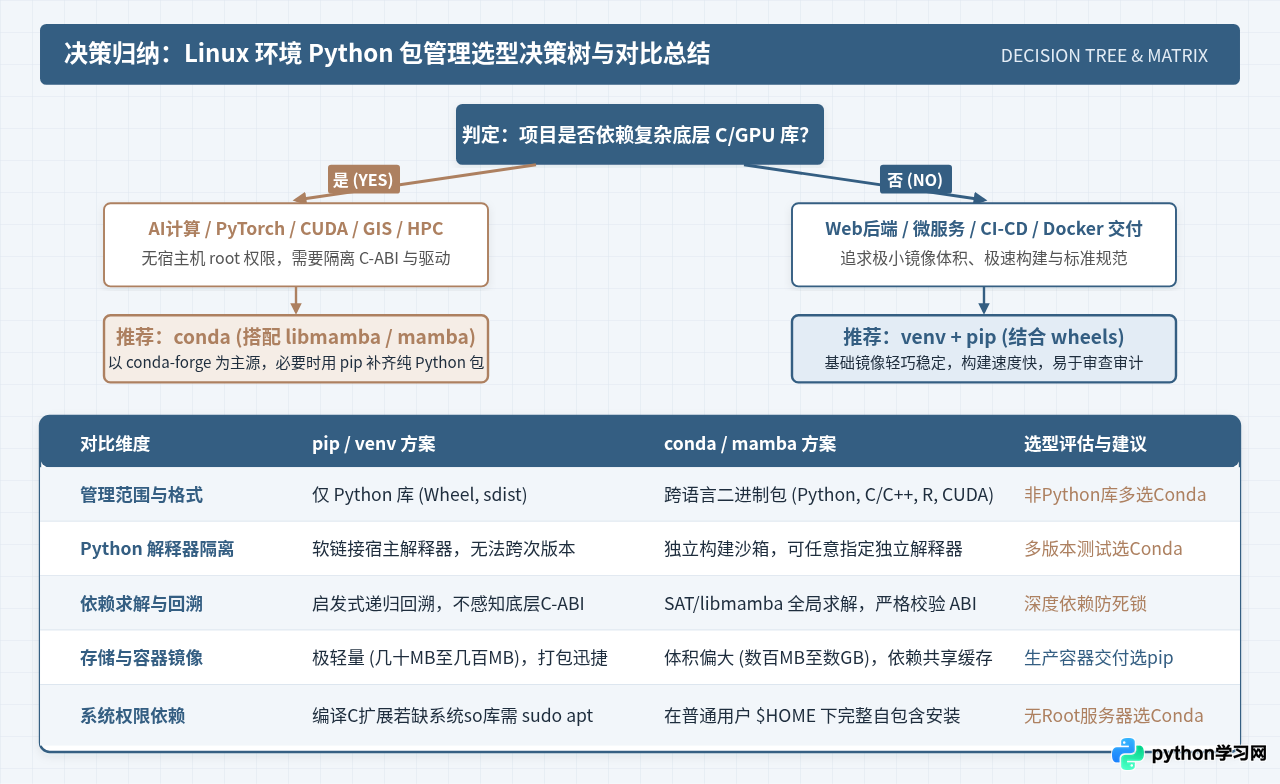
场景 1:生产环境 Docker 容器化与轻量微服务交付(强烈推荐:venv + pip)
适用条件:基于FastAPI、Django、Flask的Web API开发;纯业务逻辑处理;Kubernetes集群中规模化横向扩缩容的微服务。
选择依据:生产容器镜像必须追求轻量与安全性。若在Docker基础镜像中使用Miniconda,即使仅安装几个轻量包,镜像体积也常突破1.5GB;而采用官方python:3.11-slim或Debian精简镜像结合pip install --no-cache-dir,容器镜像通常可以压缩在150MB至300MB以内。更小的镜像能显著降低镜像仓库带宽消耗、缩短K8s拉取镜像与冷启动时间,且大幅缩减CVE脆弱性漏洞的暴露面积。
场景 2:深度学习与跨语言计算研发(强烈推荐:conda / micromamba)
适用条件:PyTorch / TensorFlow 模型训练与调优;OpenCV 图像处理;GIS 空间分析(GDAL、GEOS);生信分析(Bioconda)。
选择依据:此类项目严重依赖系统级外部C动态库与NVIDIA CUDA运行时。如果使用pip安装,开发者常常被迫在Linux宿主机上处理复杂的驱动版本对应、手写编译参数、排查GCC多版本共存问题。借助conda,不仅可以在同一台物理GPU服务器上为不同项目独立分发CUDA 11.8与CUDA 12.1运行时,还能完全规避root权限限制,把环境搭建时间从数小时缩短至几分钟。
场景 3:多成员共享服务器与离线受限网络(推荐:conda 离线缓存池)
适用条件:科研团队、高校算力实验室、涉密或金融机构受限离线局域网。
选择依据:conda具备独特的包缓存机制($CONDA_PREFIX/pkgs/)。当多个用户在同一台机器上创建不同环境时,相同版本的底层库仅需下载一次,随后通过硬链接(Hard Link)瞬间映射至用户环境。这既节省了宝贵的服务器SSD空间,又极大减轻了局域网外网出口的带宽压力。
五、Linux环境下混用与排错实操要点
1. 警惕系统级 Python 污染:禁止 sudo pip install
在Ubuntu、Debian或RHEL等主流Linux发行版中,操作系统自身的许多管理脚本(如apt的补丁机制、ufw防火墙管理、系统监控工具等)都深度依赖系统自带的Python(/usr/bin/python3)。一旦使用sudo pip install,pip会将第三方库解压写入/usr/local/lib/python3.x/dist-packages,极易篡改系统关键依赖的版本(如更新了系统旧版自带的urllib3或cryptography),导致系统包管理器崩溃甚至云主机无法正常启动。在现代Linux发行版(如Debian 12+与Ubuntu 23.04+)中,系统已全面引入PEP 668限制,直接运行pip会触发externally-managed-environment报错,正是为了阻断此种危险操作。
2. 解除 Conda 解析过慢瓶颈:迁移至 libmamba 或 micromamba
若在执行conda install时长期卡死在求解阶段,可直接将全局求解引擎切换为C++内核的libmamba:
# 启用 conda-libmamba-solver 插件为全局默认求解引擎
conda install -n base conda-libmamba-solver -y
conda config --set solver libmamba
若对CLI启动延迟和占用有更极致的要求,可以直接在Linux服务器上下载单个静态二进制文件micromamba,它不需要预装体积庞大的base Python运行时,能以极高效率执行相同的conda-forge包管理逻辑。
3. 识别并修复混用导致的动态链接库破损
若在conda环境中不慎通过pip覆盖了底层包,导致出现ImportError: /lib/x86_64-linux-gnu/libstdc++.so.6: version `GLIBCXX_3.4.30' not found等链接错误时,可以通过Linux底层的ldd命令定位动态库的实际引用链:
ldd $(python -c "import torch, os; print(os.path.join(torch.__path__[0], '_C.cpython-310-x86_64-linux-gnu.so'))") | grep -E "stdc\+\+|cuda"
如果发现链接器回退到了宿主机的/lib/x86_64-linux-gnu/旧版so文件,说明pip安装的二进制Wheel未能匹配conda私有库路径。此时最简便可靠的修复方法不是手动修改系统符号链接,而是导出依赖声明并重新构建一个纯净的conda沙箱环境。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









