

文科生适合学Python编程吗?非理工背景的学习路径与跨界应用
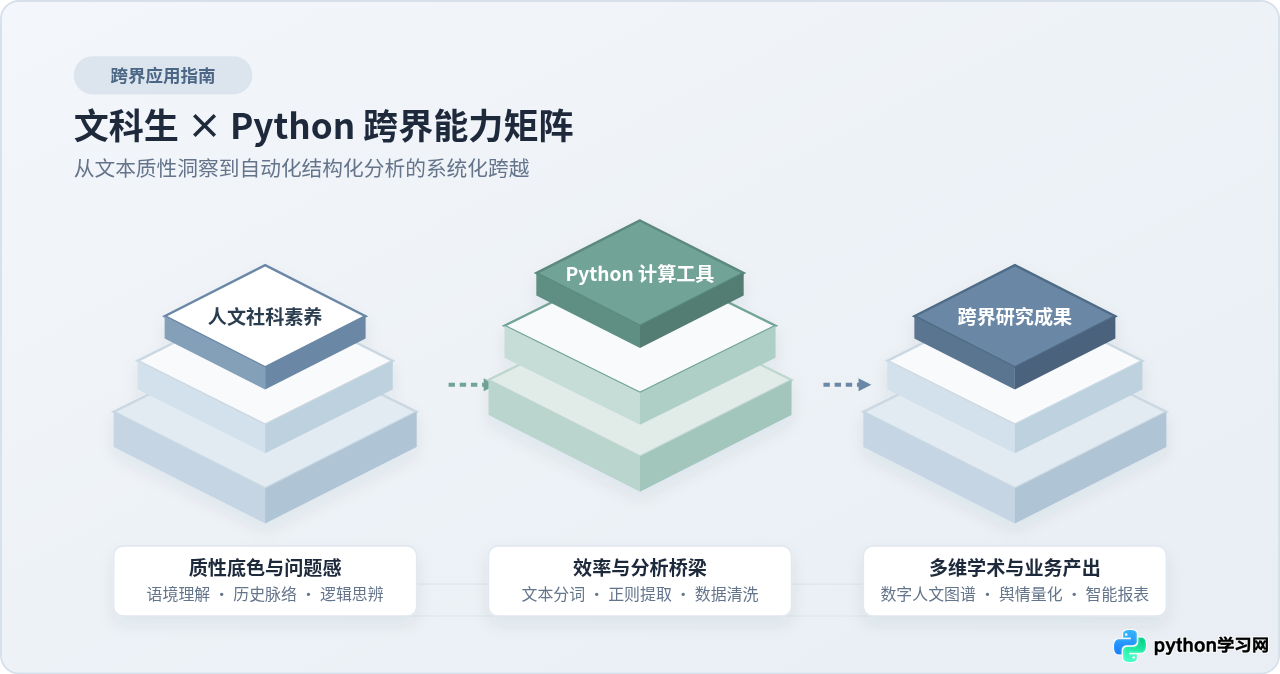
针对非理工背景学习者的实用指南:文科生如何明确自身优势,避开计算机工程底层弯路,掌握高收益Python技能树,并在文献分析、办公自动化与社科调研中实现跨界应用。
一、定位辨析:文科生学编程到底要解决什么问题?
很多非理工背景的学习者对编程抱有天然的畏难情绪,大多是因为误将“学习编程”等同于“成为软件工程师”。计算机专业的培养目标是构建复杂系统、优化底层算法性能与保障大型高并发服务的稳定性,这要求扎实的离散数学、汇编语言和操作系统底座。
文科学习者的需求截然不同。文科的核心课题在于对文化、社会、法律、传播等现实问题的观察与解读,研究与工作中面临的最大瓶颈通常不是系统运行效率,而是海量文献查阅缓慢、手工整理报表繁琐、多源数据无法整合统计。Python 恰恰具备简洁的语法结构与丰富的现成工具库,被称为计算机领域的“胶水语言”。文科生学习 Python,本质上是掌握一套能够自动化处理海量文本、提取规律并生成结构化证据的辅助工具。
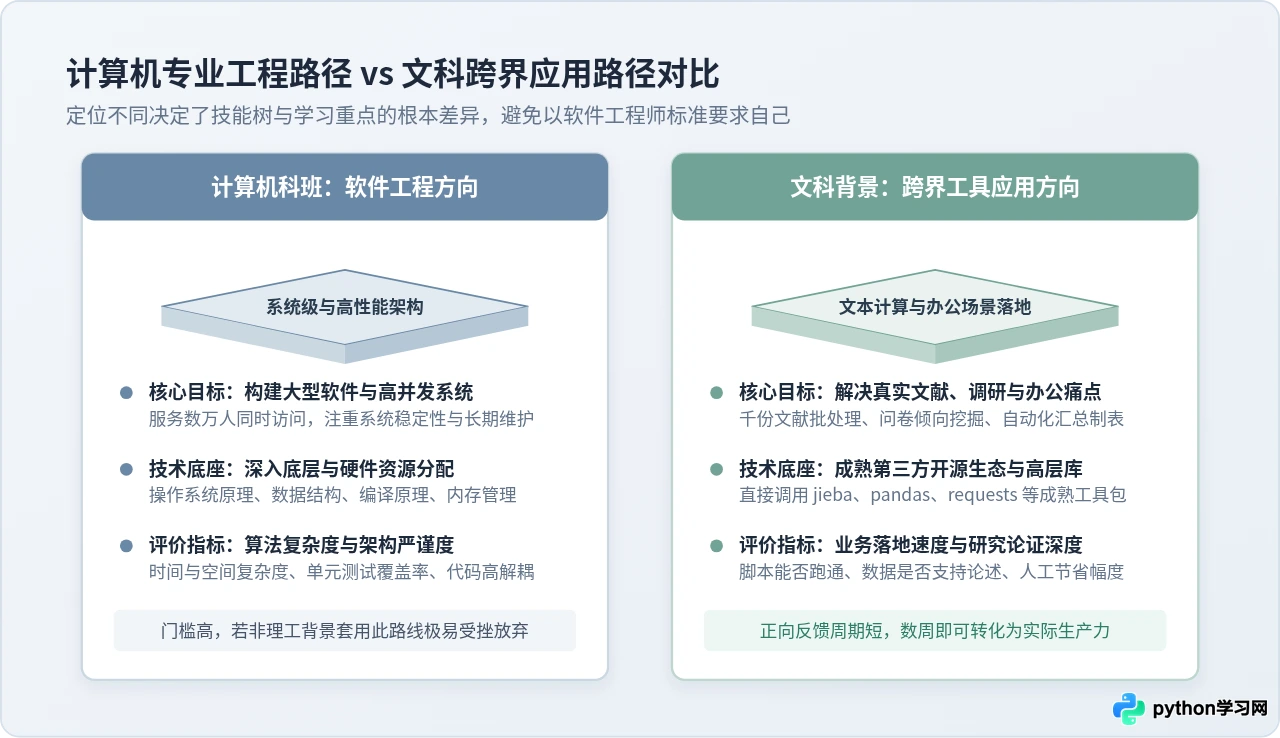
文科背景在跨界学习中拥有不可替代的专业优势:
- 问题意识敏锐:代码本身无法凭空产生意义,文科训练赋予研究者提出深刻课题、界定变量关系与挖掘人文内涵的能力。
- 文本语境感知深厚:计算机能够精准统计词频,但对反讽、隐喻、历史演变及情感细微倾向的判别,必须依赖文科背景的知识储备。
- 论证逻辑严密:文科论文对证据链条与推论过程的要求,与编程中的因果执行流程高度契合。
二、非理工背景的高效四阶学习路径
为了避免落入“学完语法题却不知道怎么用”的循环,建议非理工背景学习者采取减法策略,沿应用链条渐进式推进。
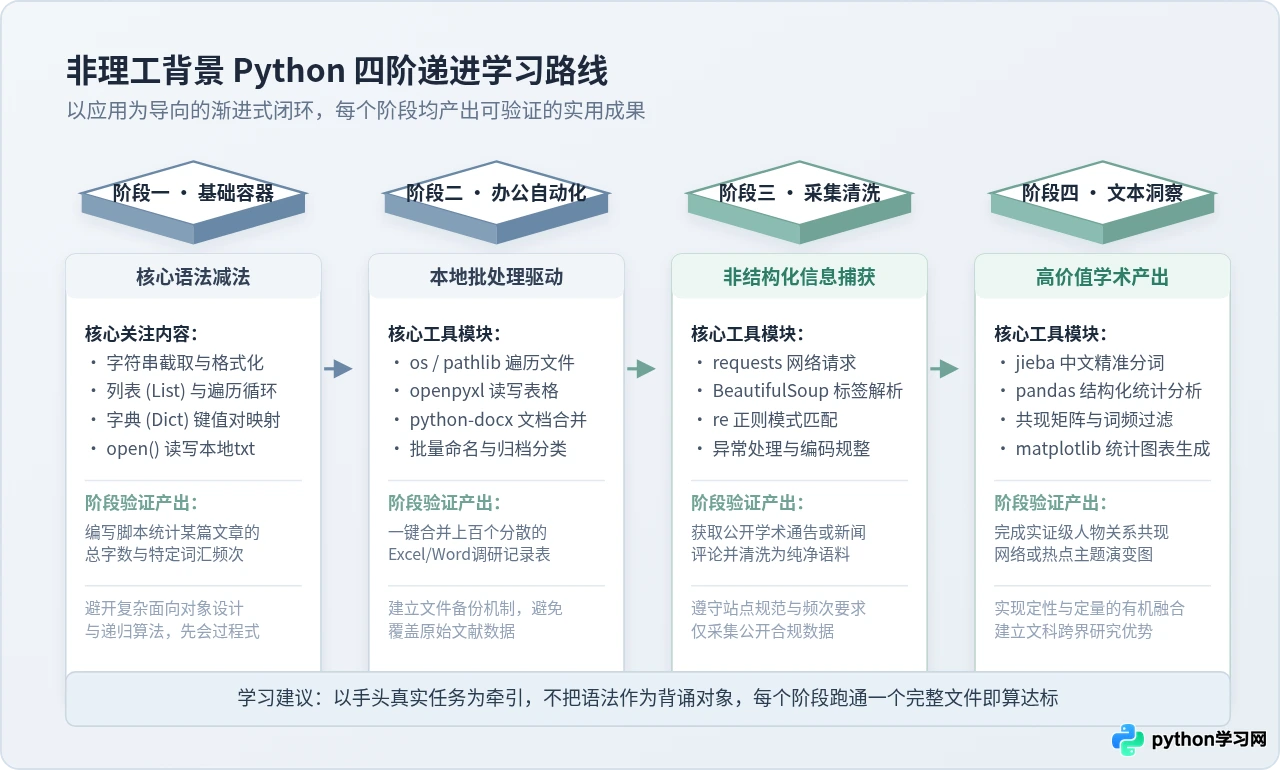
阶段一:核心语法减法与基础数据容器
初学阶段不需要面面俱到地掌握面向对象类继承、反射机制或多线程。文科应用中最频繁使用的是四项核心内容:
- 基础字符串操作:字符串切片、拼接、
strip()去除首尾空白、split()按符号切分文本。 - 列表(List)与循环遍历:使用
for循环按行扫描文字材料,存储每一段落或词条。 - 字典(Dict)映射:构建键值对结构,用于保存“词汇-出现频次”、“人名-所属阵营”等对应关系。
- 内置文件读写:熟练使用
with open("file.txt", "r", encoding="utf-8") as f:读取本地文本材料。
阶段二:本地办公与批量文件自动化
打通本地文件系统的批量读写,是文科生建立技术自信的最快切入点。在这个阶段,重点掌握 os 与 pathlib 模块扫描文件夹,以及利用 openpyxl 库读写 Excel 表格。例如面对数十个分散的调查问卷表,编写数行代码即可瞬间自动合并为一个总表,显著减少人工复制粘贴的耗时与失误率。
阶段三:网络数据采集与非结构化清洗
文科研究往往需要大量外部一手资料,包括公开的政策文件、史料档案、学术会议通报或新闻报道。通过 requests 发起网络请求,配合 BeautifulSoup 解析网页 HTML 结构,使用 re(正则表达式)剥离杂乱格式标签,能够建立起属于自己的专属资料库。
阶段四:文本挖掘与跨界产出
当数据完成清洗与归整后,文科学习者便可调动中文自然语言处理工具包 jieba 进行分词,使用 pandas 进行表格数据分组聚合运算,并借助 matplotlib 绘制趋势图与分布图,让定性分析获得强有力的定量数据支持。
三、三大典型跨界应用场景与落地代码示例
在真实研究与工作实践中,Python 主要通过以下三个典型场景发挥跨界效能。
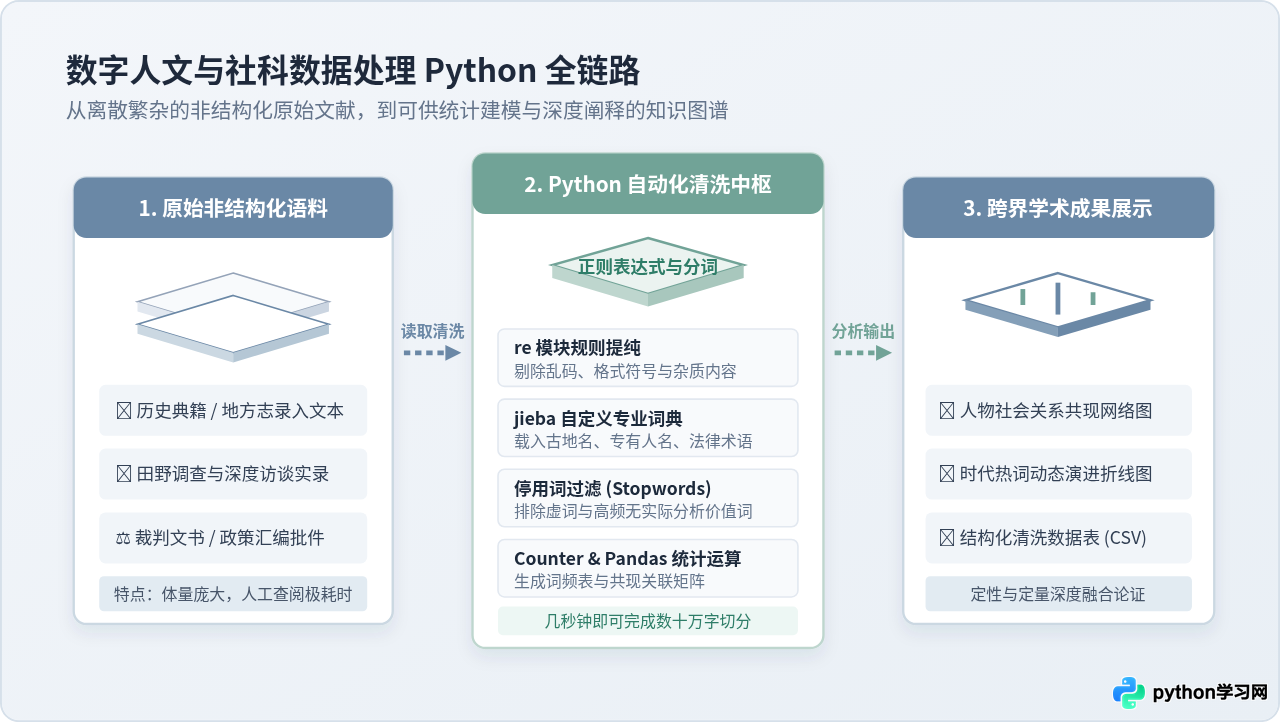
场景一:文学与历史研究——大规模文献人物与高频词共现提取
在长篇历史文本或古典文学研究中,传统的人工考据耗时长且容易遗漏次要人物。利用 Python 可以精准统计特定人物词汇在同一段落中的共现频次,从而构建出人物社交网络。
以下为一个完整可运行的轻量级共现统计脚本:
import re
from collections import Counter

# 准备模拟的历史考据文本段落
corpus_text = """
建安五年,曹操与袁绍相持于官渡。绍遣淳于琼等将兵万余人运粮,宿乌巢。
荀彧运筹于许都,致书曹操策画战机。操乃留曹洪守大营,自将步骑五千夜袭乌巢。
袁绍遣张郃、高览攻营不下。及乌巢火起,袁绍大军崩溃。郭嘉亦赞其奇谋。
曹操定河北,厚抚荀彧、郭嘉等谋士,并收降张郃。
"""

# 定义需要重点关注的历史人物列表
target_characters = ["曹操", "袁绍", "荀彧", "郭嘉", "张郃", "淳于琼"]

# 1. 按换行或句号拆解段落
paragraphs = [p.strip() for p in corpus_text.strip().split("
") if p.strip()]

# 2. 统计人物出现总频次
char_frequency = Counter()
for p in paragraphs:
    for char in target_characters:
        char_frequency[char] += len(re.findall(re.escape(char), p))

# 3. 统计段落级别的人物共现对(用于后续绘制关系网)
co_occurrence = Counter()
for p in paragraphs:
    present_chars = [char for char in target_characters if char in p]
    for i in range(len(present_chars)):
        for j in range(i + 1, len(present_chars)):
            pair = tuple(sorted([present_chars[i], present_chars[j]]))
            co_occurrence[pair] += 1

print("【人物出现频次排行】")
for name, count in char_frequency.most_common():
    print(f"人物:{name} -> 出现 {count} 次")

print("
【人物核心共现关系统计】")
for (char_a, char_b), count in co_occurrence.most_common():
    print(f"关联对:{char_a} - {char_b} -> 共现 {count} 次")
【人物出现频次排行】
人物:曹操 -> 出现 4 次
人物:袁绍 -> 出现 3 次
人物:荀彧 -> 出现 2 次
人物:郭嘉 -> 出现 2 次
人物:张郃 -> 出现 2 次
人物:淳于琼 -> 出现 1 次

【人物核心共现关系统计】
关联对:曹操 - 袁绍 -> 共现 2 次
关联对:曹操 - 荀彧 -> 共现 2 次
关联对:曹操 - 郭嘉 -> 共现 2 次
关联对:袁绍 - 张郃 -> 共现 2 次
关联对:曹操 - 张郃 -> 共现 2 次
关联对:郭嘉 - 荀彧 -> 共现 1 次
场景二:新闻传播与社会学——网络问卷与舆情文本清洗
社会调查中常常收集到数以千计的开放式填空题回复。人工逐条标记耗费大量精力,且容易受到主观情绪影响。通过 Python 对回答进行去噪、停用词剔除和关键词聚类,研究者可以在几分钟内掌握公众关切的核心痛点与高频词簇,为后续的定性深度访谈提供方向指引。
场景三:法律与行政文书——结构化要素正则批量提取
法学案例分析和政务公文处理中,经常需要从数千份非结构化文书中快速抽取出“案件文号”、“当事人名称”与“诉讼标的金额”。正则表达式(Regular Expression)能够依照固定规则实现自动化采集。
以下为从判决书摘要中快速抽取关键信息的实例代码:
import re

# 示例判决书文本片段
doc_text = """
北京市朝阳区人民法院民事判决书,案号:(2025)京0105民初9821号。
原告:北京某文化传播有限公司,统一社会信用代码91110105MA001XXX。
被告:张某某,住北京市海淀区中关村南大街。
本院审理认为,原告主张之版权赔偿合理合法,判决被告向原告赔偿经济损失人民币45000元,并承担案件受理费850元。
"""

# 使用正则表达式模式匹配关键要素
case_number_pattern = r"(\d4)[京津沪渝冀豫云辽黑湘皖鲁新苏浙赣鄂桂甘晋蒙陕吉闽贵粤青藏川宁琼]\d4民初\d+号"
amount_pattern = r"赔偿经济损失人民币(\d+)元"
plaintiff_pattern = r"原告[::]\s*([^\s,,。]+)"

case_num = re.search(case_number_pattern, doc_text)
amount = re.search(amount_pattern, doc_text)
plaintiff = re.search(plaintiff_pattern, doc_text)

extracted_data = {
    "案件编号": case_num.group(0) if case_num else "未匹配",
    "原告主体": plaintiff.group(1) if plaintiff else "未匹配",
    "判赔金额(元)": amount.group(1) if amount else "0"
}

print("【结构化文书要素提取结果】")
for key, value in extracted_data.items():
    print(f"{key}: {value}")
【结构化文书要素提取结果】
案件编号: (2025)京0105民初9821号
原告主体: 北京某文化传播有限公司
判赔金额(元): 45000
四、避坑指南:非理工学习者最常遭遇的四大卡点与排错心法
在长期学习过程中,非理工背景学习者最容易在以下四个节点遇到阻力,掌握应对策略能够大幅降低放弃概率。
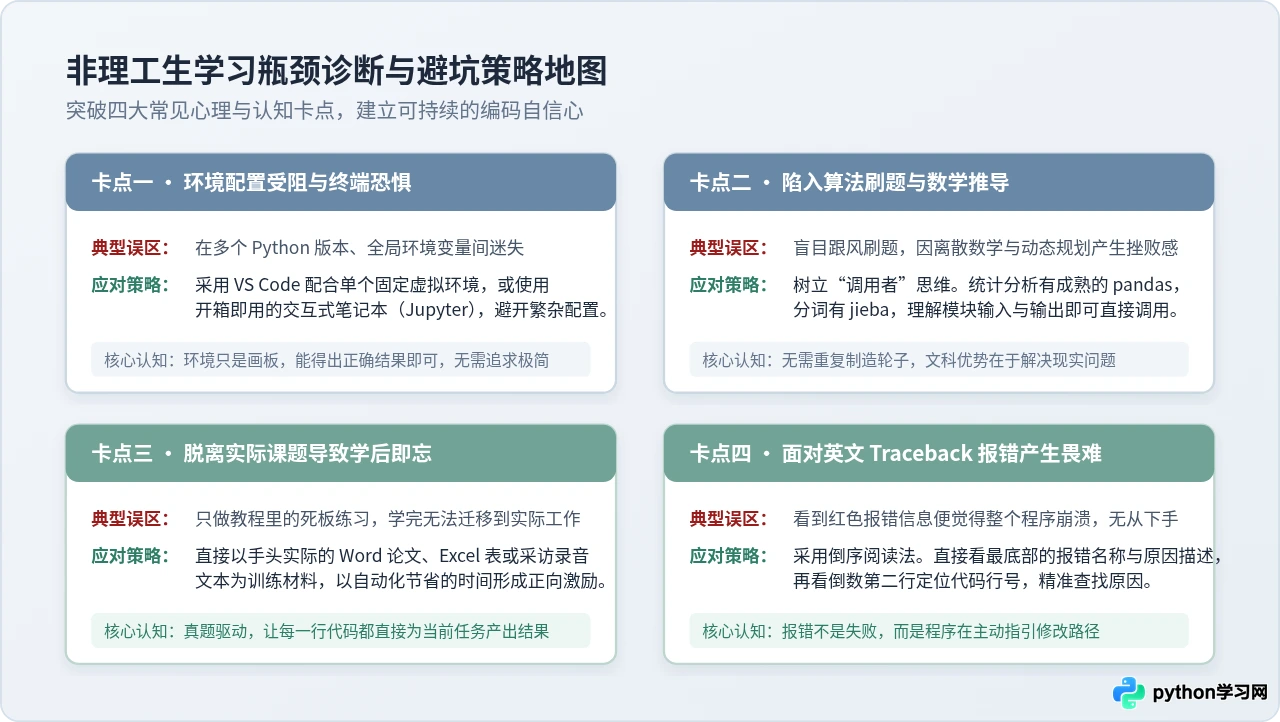
很多初学者在安装 Python、配置全局 PATH 环境变量或排查包版本冲突时受挫。建议直接安装现代编辑器(如 VS Code)配合单个受管环境,或者使用基于浏览器的交互式 Jupyter Notebook。编写代码的核心在于产出分析结果,环境只需稳定可用即可,不必苛求极致精简。
不少文科生在网络论坛上盲目跟随计算机专业路线刷 LeetCode 题目,被红黑树、动态规划和复杂的数学证明劝退。文科生应当始终坚持“调用者思维”:文本分词直接调用 jieba,统计计算直接使用 pandas,明确输入参数与输出格式即可,不必耗费精力去重复实现基础算法。
跟着教材敲一遍“学生成绩管理系统”往往让人索然无味,学完很快遗忘。最有效的学习方式是从第一天起就用自己正在处理的课题作为练习目标:用手头现成的毕业论文文献、部门周报、采访录音文本来写脚本。每一次运行成功节省下来的手工时间,都是维持长期学习动力最好的正反馈。
看到终端弹出一长串红色的英文报错信息时,容易误以为程序彻底损坏。处理报错只需三步倒序法则:直接看最末尾一行了解具体错误类型(如 FileNotFoundError 说明路径写错,KeyError 说明字典找不到键);看倒数第二行定位具体代码行号;在对应行加上 print() 检查变量的实际内容。报错不是失败,而是程序在明确告知哪里需要调整。
结语:重塑文科研究与办公的生产力边界
文科生学习 Python,不是为了舍弃专业底色去转行成为平庸的初级程序员,而是为了让人文社科所积淀的思想深度与敏锐洞察,获得现代计算工具的强力支持。通过合理的路径规划与工具化思维,编程能够从一门看似高深的技术学科,转变为文科研究者与文字工作者手中高效、可靠的得力助手。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









