

Python lxml与BeautifulSoup在网页编辑中的选择
深入对比 Python 中 lxml 与 BeautifulSoup 在网页编辑、DOM重构、节点增删与属性清洗等场景下的核心机制、语法体验与性能表现,提供清晰直接的技术选型决策。
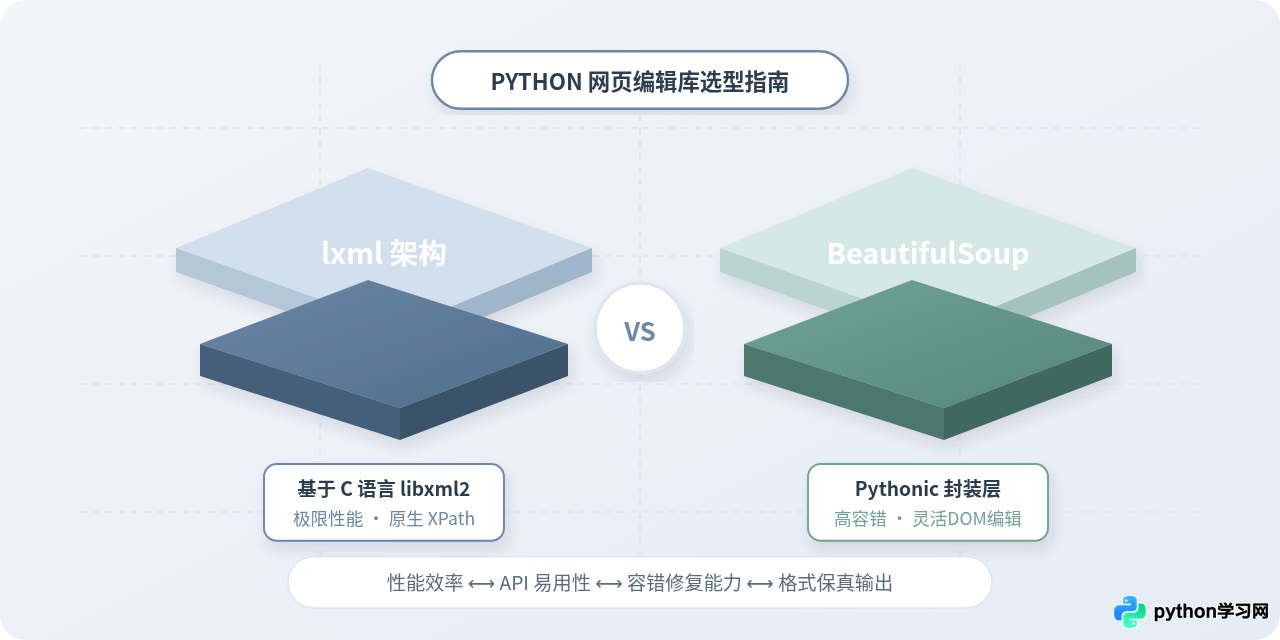
一、核心机制与底层架构差异
很多初学者常将 lxml 与 BeautifulSoup 看作对立的替代品,但从底层实现机制上看,两者的设计定位有本质不同。lxml 是对 C 语言底层库 libxml2 与 libxslt 的高层 Cython 封装,所有 DOM 节点在内存中均以 C 语言结构体形式存在;Python 脚本中所操作的 Element 对象,实际上是对底层 C 节点指针的轻量引用。这种机制赋予了 lxml 极其强悍的解析吞吐速度和极低的内存开销。
与此相对,BeautifulSoup 4(bs4)本质上是一个通用的文档树构建与包装层。它自身并不直接执行底层的 HTML 词法切分,而是充当上层调度者,将底层的解析事件转换成纯 Python 对象(Tag、NavigableString、Comment 等)。值得注意的是,BeautifulSoup 可以将 lxml 作为自身的底层解析引擎(即 BeautifulSoup(markup, 'lxml')),兼顾 lxml 的 C 级词法解析速度与自身直观的 Pythonic 对象模型。
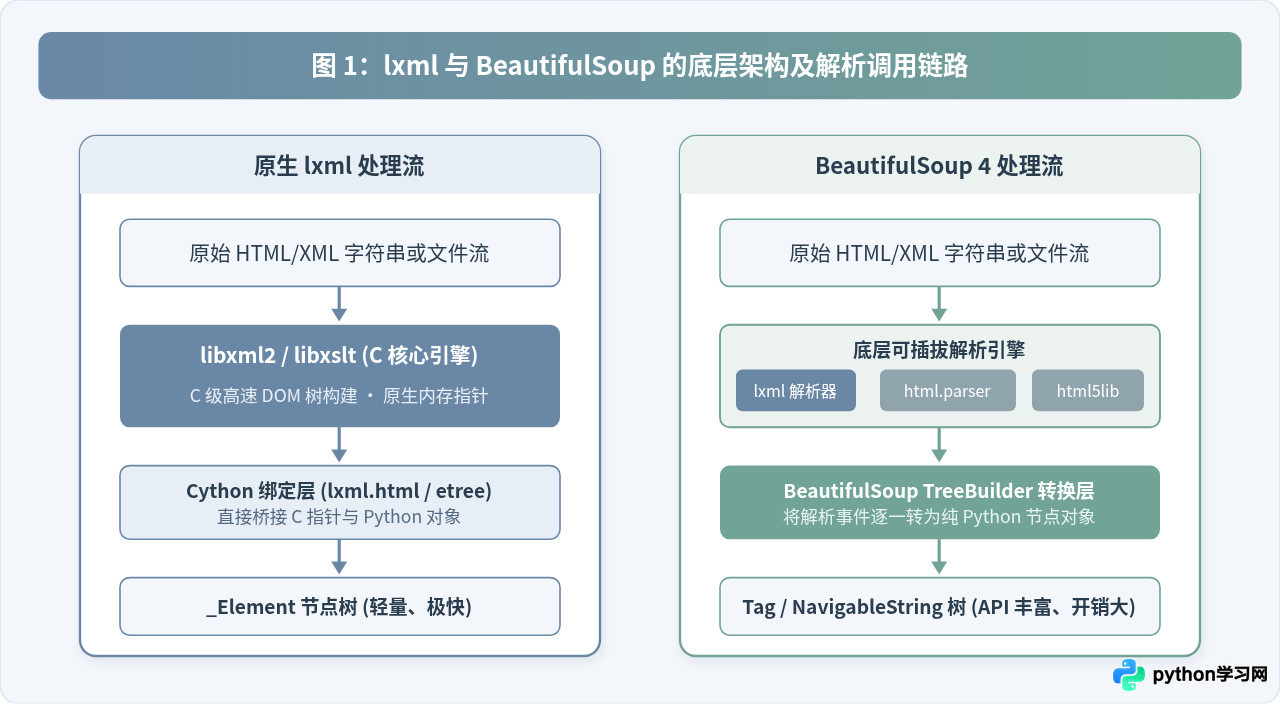
这种架构差异直接决定了两者在“网页编辑”过程中的首要权衡点:原生 lxml 避免了 Python 对象的大量实例化与引用维护,在大批量 HTML 文件的清洗重写中具有数量级的速度优势;而 BeautifulSoup 的 Tag 对象封装了更贴近人类直觉的编辑方法,但在内存中维持大型文档树时会带来显著的内存与 GC 压力。
二、网页编辑典型操作与语法对比
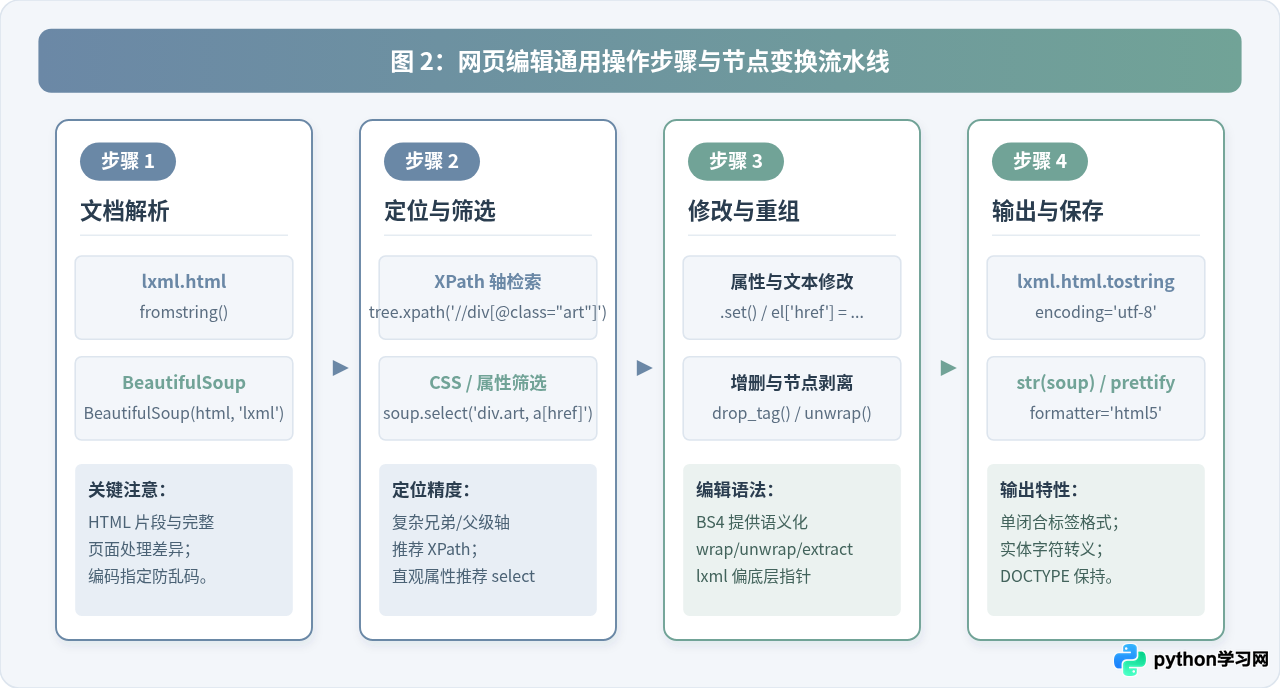
在实际编写网页编辑脚本时,核心操作通常可以抽象为四个步骤:解析载入、定位目标节点、就地修改属性与 DOM 结构、序列化导出。两套库在每个环节均有独特的语法风格与适用边界。
1. 节点定位与筛选
对目标节点的高效定位是进行任何编辑操作的前提。lxml 原生支持完备的 XPath 1.0 规范,在处理复杂的层级关系(如“查找包含特定文本的段落下方的第二个兄弟 div”)时,XPath 能用一行表达式精准定位,不需要多层循环判断:
# lxml 中通过 XPath 进行高精度定位
from lxml import html

tree = html.fromstring('<div class="content"><p>标题</p><a href="/link1">链接1</a></div>')
# 定位 class 为 content 下的所有 a 标签
target_links = tree.xpath('//div[@class="content"]/a')
BeautifulSoup 对 XPath 没有原生支持(除非借助第三方辅助),但它对 CSS 选择器和属性过滤提供了极为亲切的 API:
# BeautifulSoup 中使用 CSS 选择器与语义化查找
from bs4 import BeautifulSoup

soup = BeautifulSoup('<div class="content"><p>标题</p><a href="/link1">链接1</a></div>', 'lxml')
target_links = soup.select('div.content > a')
# 或使用属性关键词查找
first_link = soup.find('a', href=True)
2. 节点属性与文本修改
在批量更新网页超链接、添加 rel="nofollow"、修改图片 src 或调整样式类时,两者的属性修改方式均类似于字典操作,但 lxml 额外提供了 .attrib 映射视图与 .set() 方法。
# [示例] 批量为外部链接添加安全属性 rel="noopener nofollow"

# --- lxml 方案 ---
for link in tree.xpath('//a[@href]'):
    href = link.get('href', '')
    if href.startswith('http'):
        link.set('rel', 'noopener nofollow')
        link.set('target', '_blank')

# --- BeautifulSoup 方案 ---
for link in soup.find_all('a', href=True):
    if link['href'].startswith('http'):
        link['rel'] = ['noopener', 'nofollow']  # 支持多值属性列表
link['target'] = '_blank'class、rel)自动解析为 Python 列表,修改时可以直接 append();而 lxml 始终将属性值视为原始字符串,如需追加 class 名称需手动进行字符串拼接。
3. 节点增删、替换与包裹重组
在需要重组网页正文结构时(例如去掉多余的包裹标签、将纯文本升级为带链接的标签、移除广告横幅),两者的 API 设计哲学差异最为鲜明。
-
BeautifulSoup 的语义化优势:bs4 原生提供了
wrap()、unwrap()、replace_with()与decompose()。例如剥离无用的<span>保留文本,只需调用span.unwrap();彻底销毁节点及其后代,只需调用ad_div.decompose()。 -
lxml 的指针式操作:lxml 依赖父节点与兄弟节点的相对位置来管理树结构。例如删除节点有两种策略:
parent.remove(node)(连同内部后代一起删除)或node.drop_tag()(剥除本标签但保留子标签与文本,类似于 unwrap)。
# [示例] 结构重构:清洗行内无用 span 并替换特定广告节点

# --- BeautifulSoup 方式 ---
for span in soup.find_all('span', class_='useless'):
    span.unwrap()  # 展开标签,内部文字保留在原父节点中

for ad in soup.find_all('div', class_='ad-banner'):
    ad.decompose()  # 彻底销毁节点并释放关联引用

# --- lxml 方式 ---
for span in tree.xpath('//span[@class="useless"]'):
    span.drop_tag()  # 移除 span 标签本身,保留子文本

for ad in tree.xpath('//div[@class="ad-banner"]'):
    ad.drop_tree()   # 彻底移除节点树及尾部文本
三、畸形 HTML 容错与输出保真度比对
在现实网络中,待编辑的网页往往存在大量不规范的 HTML 代码,如未闭合的标签、错误的块级元素嵌套或不合法的字符实体。如何安全地解析、修复并在修改后导出,是选型时必须考察的关键因素。
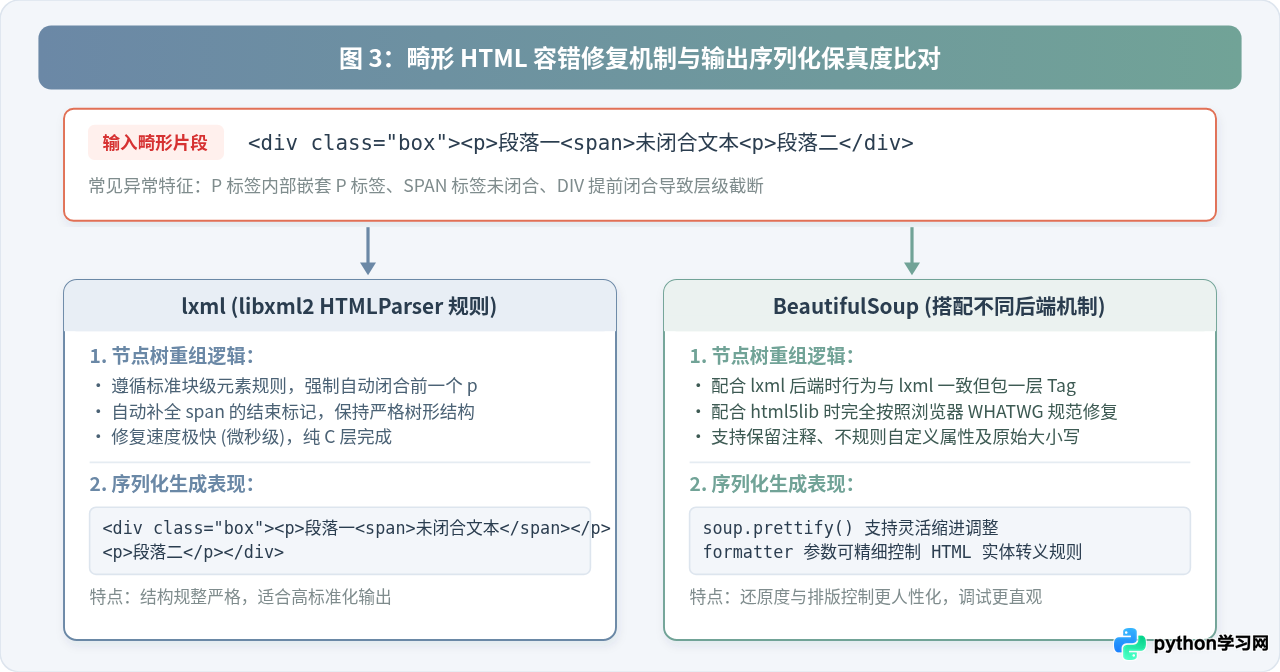
1. 容错修复逻辑的差异
原生 lxml.html 内置了 libxml2 的 HTML 恢复解析器(Recovery Parser)。面对缺失结束标签的段落,它会根据 HTML 4/XHTML 的标准规则快速补齐。这种修复是在 C 内存层由状态机同步完成的,执行效率极高,但遇到极为晦涩的错乱层级时,修复结果可能偏向于严格的文档闭合,偶有将子元素移出目标容器的情况。
如果待编辑网页属于年代久远、错乱极度严重的杂乱页面,BeautifulSoup 提供了更弹性的后端选择:通过引入 html5lib 解析器(BeautifulSoup(markup, 'html5lib')),bs4 能够完全按照现代浏览器(WHATWG HTML5 规范)的容错算法来重构 DOM 树。无论是遗漏的表单元素还是交叉嵌套标签,都能得到与浏览器审查元素完全一致的结构。
2. 序列化与格式保真度
网页编辑完成后,我们需要将内存中的树结构重新输出为 HTML 字符串或文件:
-
lxml 的序列化:使用
lxml.html.tostring(tree, encoding='utf-8')。其输出紧凑且严格遵循标准。如果需要输出单个片段而不自动补全<html><body>,可以使用lxml.html.fragment_fromstring()。 -
BeautifulSoup 的序列化:直接调用
str(soup)或soup.decode()。如果需要用于展示的人性化排版,可使用soup.prettify();此外,通过设置formatter="html5"或formatter=None,可以精准控制特殊符号(如&、>、中文汉字)的转义行为,避免汉字被强制转为&#x...;实体。
四、性能基准与资源开销分析
当任务规模从单个测试页面扩展到数万篇甚至数百万篇历史文章的批量编辑时,性能差异会成为决定性的分水岭。
在典型的文档解析与 DOM 遍历基准测试中:
-
解析速度:原生
lxml.html通常比BeautifulSoup(markup, 'lxml')快 3 到 8 倍,比使用html.parser的 bs4 快 10 倍以上,比html5lib快 30 到 50 倍。 - 内存占用:原生 lxml 构建的 C 树节点内存开销极小。而 BeautifulSoup 在构建树时,需要为每个标签、属性字典及字符串片段创建独立的 Python 堆对象,在处理数十兆大小的庞大 HTML 页面时,bs4 的内存消耗可能达到原生 lxml 的 5 至 10 倍。
因此,对于在线实时网关服务、高并发 Web 爬虫清洗通道或海量网页离线批处理系统,原生 lxml 能够极大节省 CPU 周期与容器内存预算。
五、综合选型决策矩阵与场景指南
为了帮助开发者在实际项目中迅速做出合理决策,我们将各项核心指标汇总如下,并给出清晰的决策流程。
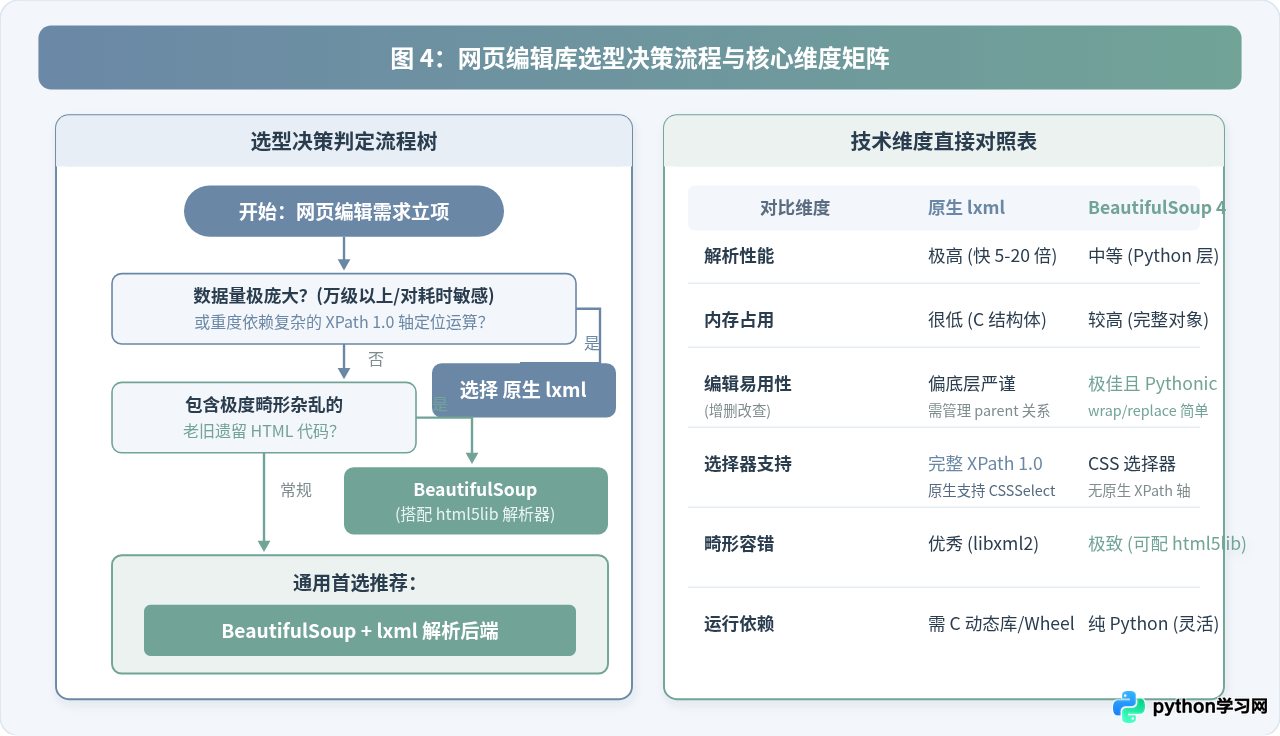
| 评估维度 | 原生 lxml | BeautifulSoup 4 (配 lxml) | BeautifulSoup 4 (配 html5lib) |
|---|---|---|---|
| 解析与编辑性能 | 极致(C 级速度,数微秒级) | 良好(受 Python 对象层限制) | 较慢(纯 Python 规范实现) |
| 内存资源占用 | 极低(轻量 C 结构体指针) | 中等(完全 Python 对象化) | 较高(复杂状态机构建) |
| 选择器能力 | 完整 XPath 1.0 + CSSSelect | CSS 选择器 + 丰富过滤器 | CSS 选择器 + 丰富过滤器 |
| DOM 变换 API 友好度 | 偏底层,需熟练掌握树指针 | 极高,语义化方法丰富(unwrap等) | 极高,语义化方法丰富 |
| 极端畸形容错 | 优秀(遵循标准 C 快速补齐) | 优秀(继承 lxml 容错) | 极致(完全符合现代浏览器行为) |
| 依赖与部署复杂度 | 需预编译二进制 Wheel 或 libxml2 | 依赖 bs4 库及所选解析器 | 需额外安装 html5lib |
实战场景选型推荐:
-
选择“原生 lxml”的典型场景:
- 企业级 CMS 平台的内容入库批处理通道,每日需格式化数十万篇网页正文。
- 重度依赖复杂 XPath 轴运算(如父级回溯、兄弟节点条件统计)进行精确编辑的场景。
- 内存受限的微服务容器或 Serverless 云函数环境,追求高冷启动速度与低资源占用。
-
选择“BeautifulSoup(搭配 lxml 后端)”的典型场景:
- 中小型项目的日常运维脚本、爬虫数据入库清洗与 SEO 标签优化。
- 需要高频执行标签包裹(
wrap)、标签展开剥除(unwrap)等灵活重构操作。 - 团队协作开发,希望代码直观易读、API 学习曲线平缓,不愿维护冗长复杂的指针逻辑。
-
选择“BeautifulSoup(搭配 html5lib)”的特异场景:
- 来源极其杂乱不可控的历史旧网存档修复,其他解析器均解析失败或产生层级错位时。
六、常见陷阱与注意事项
在 lxml 中直接循环
tree.xpath(...) 的同时调用 node.drop_tree() 或删除节点,通常是安全的,因为 XPath 返回的是列表镜像;但如果在 BeautifulSoup 中遍历迭代器(如 soup.children 或生成器)的同时修改树结构,可能导致跳过后续节点。建议在修改前先将结果转为静态列表:for tag in list(soup.find_all(...)):。
在 lxml 的 ElementTree 模型中,一个标签闭合后、下一个同级标签之前的文本被称为
tail。在移除或移动节点时,如果直接删除节点,其绑定的 tail 文字也会随之丢失。若需保留其后跟随的文本,请务必使用 node.drop_tag() 而不是 parent.remove(node)。
在较新的 lxml 版本中,原有的
lxml.html.clean 模块因安全维护策略已被剥离为独立的扩展包 lxml_html_clean。如果编写涉及富文本 XSS 过滤的编辑代码,需要额外安装 pip install lxml_html_clean,并在代码中显式导入。
lxml.html.tostring() 默认返回 bytes 类型(当指定 encoding='utf-8' 时);如果要直接写入文本文件或得到 Python str,需显式调用 .decode('utf-8') 或指定 encoding='unicode'。而 BeautifulSoup 的 str(soup) 则直接返回 Python 字符串对象。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









