

Python方法重写与重载有什么区别
深入解析Python中方法重写(Override)与方法重载(Overload)的核心区别。从底层命名空间机制、继承体系MRO链条、代码示例到地道替代方案,助你清晰掌握面向对象设计中的关键差异。
在面向对象编程中,方法重写(Override)与方法重载(Overload)是两个高频出现却容易被混淆的概念。在 Python 中,两者的本质分界非常明确:Python 原生完全支持方法重写,用于子类重新定义父类的行为;而像 C++ 或 Java 中那样依靠“同名不同参数签名”自动分派的方法重载,在原生 Python 中并不存在。在同一个类中连续定义同名方法,后面的定义会直接覆盖前面的定义。理解这一机制与 Pythonic 的替代实践,是写出健壮面向对象代码的基础。
一、方法重写(Override):继承体系下的多态机制
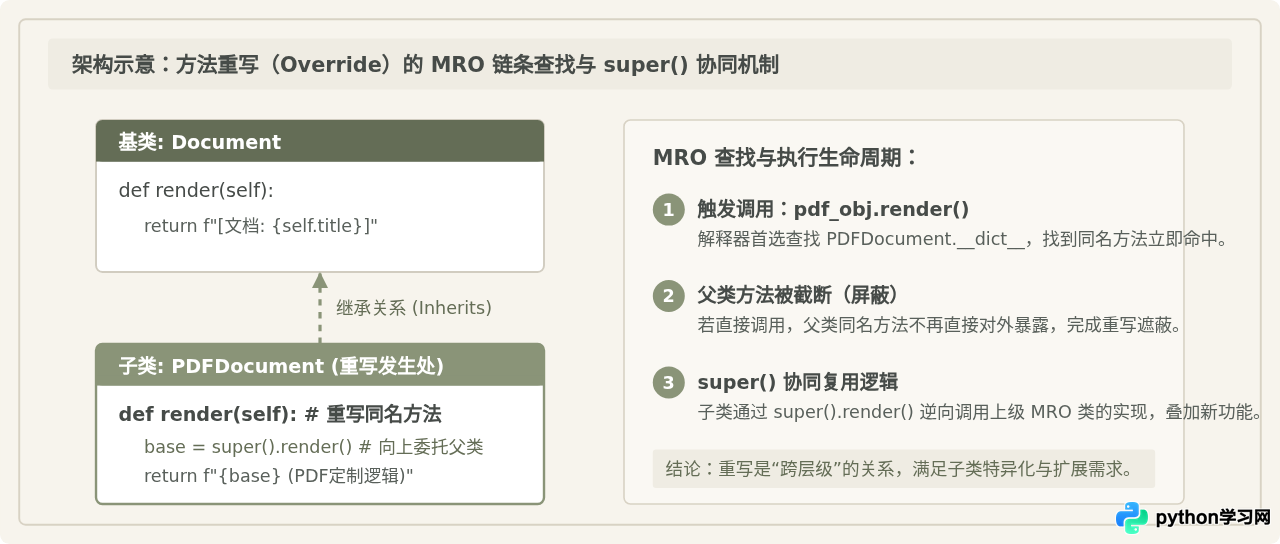
方法重写(Method Overriding)发生在父类与子类之间。当子类继承了父类的方法,但该方法的默认实现无法满足子类业务需求时,子类可以重新编写一个与父类同名的方法,从而在子类实例上替代父类的原有行为。
在 Python 中,方法重写是实现面向对象多态性(Polymorphism)的核心手段。其实际调用遵循 Python 的方法解析顺序(Method Resolution Order, MRO)。当通过对象调用方法时,Python 解释器从当前类开始向上搜索属性字典,一旦匹配到同名函数即停止搜索并执行。
1. 基础重写与 super() 协同调用
在编写重写方法时,有两种常见的业务模式:完全替换父类逻辑,或通过 super() 在保留父类通用逻辑的基础上追加子类特性。以下为规范示例:
class Document:
    def __init__(self, title: str):
        self.title = title

    def render(self) -> str:
        # 父类基础实现
        return f"[文档标题: {self.title}]"

class PDFDocument(Document):
    def __init__(self, title: str, pages: int):
        # 扩展父类初始化
        super().__init__(title)
        self.pages = pages

    def render(self) -> str:
        # 重写父类方法:先调用父类渲染,再叠加页数信息
        base_content = super().render()
        return f"{base_content} - 格式: PDF (共 {self.pages} 页)"

doc = Document("年度报告")
pdf = PDFDocument("技术白皮书", 42)

print(doc.render())  # 示例输出: [文档标题: 年度报告]
print(pdf.render()) # 示例输出: [文档标题: 技术白皮书] - 格式: PDF (共 42 页)TypeError。
二、方法重载(Overload):为什么 Python 原生没有传统重载?
在 C++、Java 等静态强类型语言中,方法重载(Method Overloading)允许在同一个类中声明多个名字相同、但参数数量或参数类型不同的方法。编译器在编译期或运行期会根据调用方传入的具体实参类型与个数,自动绑定到匹配的重载版本。
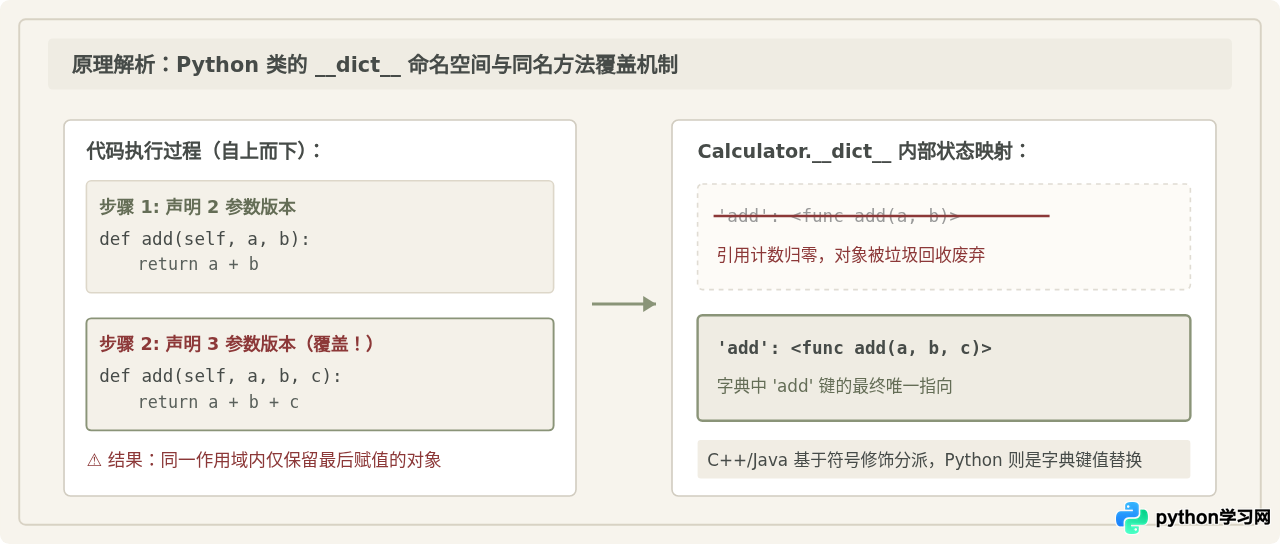
然而,原生 Python 并不支持这种同名不同签名的重载机制。如果在 Python 的同一个类或模块中写了两个同名函数,前面的定义不会被保留,而是直接被后面的定义彻底覆盖。
1. 为什么会覆盖:Python 类命名字典的本质
Python 中的函数是“一等公民(First-Class Object)”。当 Python 解释器执行到一个 class 块时,它本质上是在创建一个局部的名字字典(命名空间 __dict__)。
语句 def calculate(self, x): ... 实际上是将一个函数对象赋值给字典中的键 'calculate'。紧接着若写下 def calculate(self, x, y): ...,这只是对键 'calculate' 的一次重复赋值。前一个函数对象的引用计数减少,原有的定义直接丢失。
class Calculator:
    def add(self, a: int, b: int) -> int:
        return a + b

    # 重复定义同名方法:后面的覆盖前面的
    def add(self, a: int, b: int, c: int) -> int:
        return a + b + c

calc = Calculator()

# 尝试按照前一个定义传两个参数
try:
    print(calc.add(10, 20))
except TypeError as err:
    print("抛出异常:", err)
    # 示例输出: 抛出异常: Calculator.add() missing 1 required positional argument: 'c'
上述报错清晰地证实:类字典中只存活了最后定义的那个接收 3 个参数的 add。原生语法层面没有任何机制能保留并分派这两套不同的函数签名。
三、在 Python 中实现“重载需求”的 3 种地道方案
虽然没有静态语言的自动重载,但现实开发中常常需要同一个方法能灵活处理不同数量或不同类型的入参。Python 社区总结出了三种规范且优雅的实现途径:
方案 1:默认参数与可变参数(最地道、最常用)
对于因“入参数量不同”而产生的重载需求,直接使用默认参数(Default Arguments)或 *args, **kwargs 即可在单个函数中解决,代码直观且运行开销最低:
class AreaCalculator:
    # 使用可选的默认参数应对 1 个或 2 个入参的需求
    def calculate(self, width: float, height: float | None = None) -> float:
        if height is None:
            # 单参数分支:计算正方形面积
            return width * width
        # 双参数分支:计算长方形面积
        return width * height

calc = AreaCalculator()
print(calc.calculate(5))      # 示例输出: 25 (正方形)
print(calc.calculate(5, 8))   # 示例输出: 40 (长方形)
方案 2:标准库 functools.singledispatchmethod(类型单分派)
如果方法的行为需要根据第一个参数的类型不同而分流执行,Python 标准库提供了内置的 @singledispatchmethod(Python 3.8+),这在运行时实现了真正基于类型的优雅分派:
from functools import singledispatchmethod

class DataFormatter:
    @singledispatchmethod
    def format(self, data):
        # 默认回退处理
        raise NotImplementedError(f"不支持的数据类型: {type(data)}")

    @format.register
    def _(self, data: str) -> str:
        # 字符串重载分支
        return f"文本内容: {data.strip()}"

    @format.register
    def _(self, data: list) -> str:
        # 列表重载分支
        return f"列表项汇总: {', '.join(str(x) for x in data)}"

formatter = DataFormatter()
print(formatter.format("  Hello Python  "))  # 示例输出: 文本内容: Hello Python
print(formatter.format([10, 20, 30]))        # 示例输出: 列表项汇总: 10, 20, 30
方案 3:typing.overload(面向类型检查器与 IDE 提示)
很多开发者在大型开源库(如 requests 或标准库 json)中看到过 @overload 装饰器,误以为 Python 支持了原生重载。实际上,typing.overload 只在静态类型检查期(Mypy / Pyright / IDE)生效。在运行时,它不会执行任何分派,必须在所有 @overload 声明后编写一个最终的、包含具体分支逻辑的实现函数:
from typing import overload, Union

class Parser:
    # 静态声明 1:传入 int 返回 str
    @overload
    def parse(self, val: int) -> str: ...

    # 静态声明 2:传入 list[int] 返回 int
    @overload
    def parse(self, val: list[int]) -> int: ...

    # 最终的统一实现:运行时实际执行此方法
    def parse(self, val: Union[int, list[int]]) -> Union[str, int]:
        if isinstance(val, int):
            return f"数字转换: {val}"
        elif isinstance(val, list):
            return sum(val)
        raise TypeError("不支持的入参类型")

p = Parser()
print(p.parse(100))        # 示例输出: 数字转换: 100
print(p.parse([1, 2, 3]))  # 示例输出: 6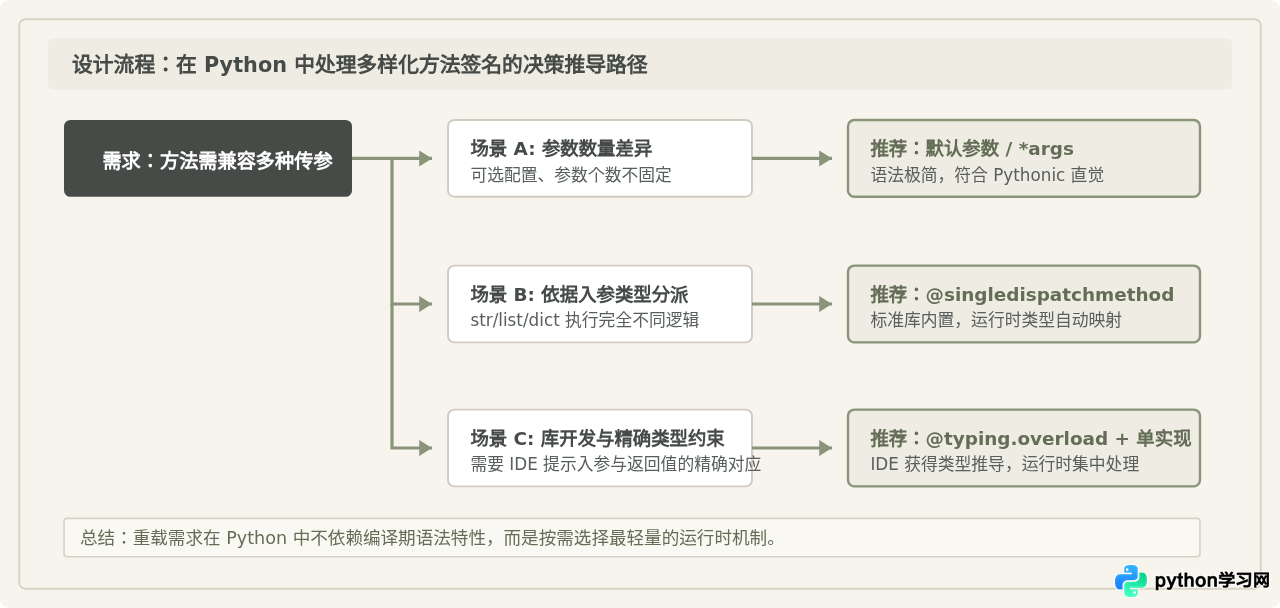
四、认知纠偏:易混淆说法的辨析
在讨论重写与重载时,初学者甚至部分有静态语言经验的工程师经常会产生一些貌似合理却存在偏差的看法。下面对三项高频疑问进行具体辨析:
1. “Python 是不是有 @overload 装饰器,所以实际上支持原生方法重载?”
辨析与修正:这种说法只对了一半。typing.overload 仅仅是一个静态类型标注标记。如果你在没有提供最终实现的情况下,仅写了两个带 @overload 的同名方法,直接运行调用会抛出异常或被后者覆盖。它在 Python 运行时内部没有任何符号分派表。因此,它解决的是“类型检查与编辑器自动补全”体验,而非“Python 解释器拥有重载能力”。
2. “Python 不支持原生重载是语言特性的缺失吗?”
辨析与修正:并不是缺失,而是设计哲学的选择。C++/Java 之所以高度依赖方法重载,是因为它们是静态强类型语言,一个 int 类型的参数必须在编译期就固定下来,无法直接接纳其他类型;而 Python 作为动态类型语言,遵循鸭子类型(Duck Typing)。同一个参数名在运行时可以接收任何对象,结合默认参数,一个函数天然具备处理多种类型和不定数量参数的能力,根本不需要通过声明多个同名方法来解决问题。
3. “子类重写父类方法时,参数个数可以随意更改吗?”
辨析与修正:语法上 Python 不会报错,但工程实践中存在隐患。如果子类重写父类方法时移除了某些参数,当外部代码以多态形式(即只把对象当作父类实例)调用该方法并传递这些参数时,程序会在运行时直接崩溃。因此,重写方法时如果需要新增参数,必须设置默认值(例如 def process(self, data, timeout=30): ...),保证旧的调用契约依然成立。
五、方法重写与重载全维度对比与速查矩阵
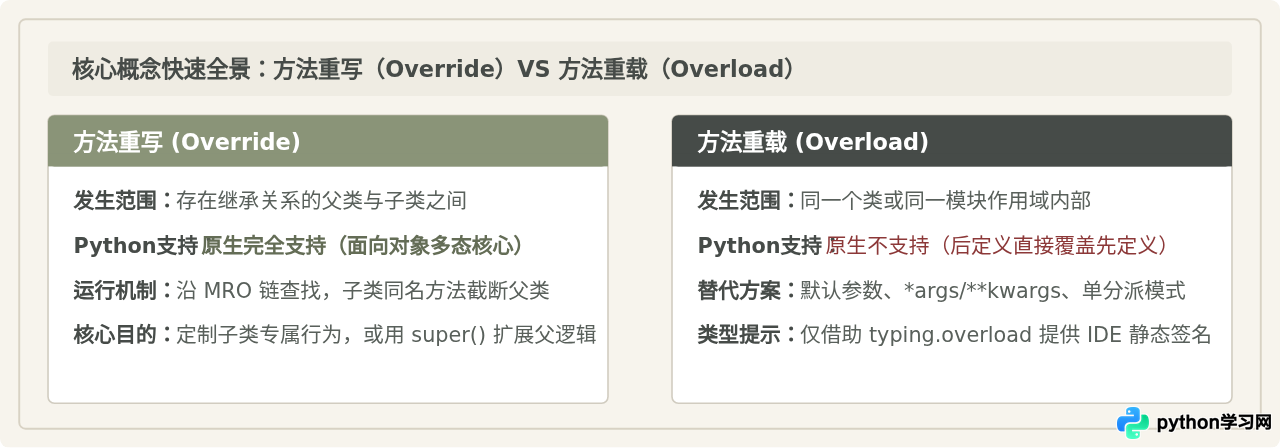
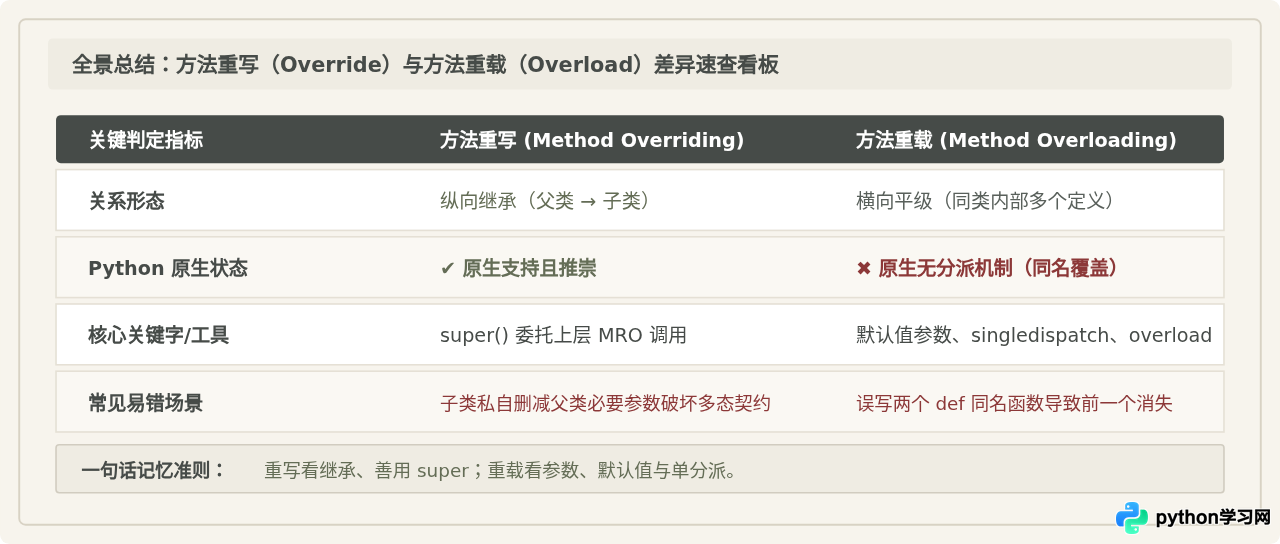
为了在架构设计和编码实现时快速做出正确判断,下表和总结图示梳理了重写(Override)与重载(Overload)在各个维度的核心差异:
| 对比维度 | 方法重写 (Method Overriding) | 方法重载 (Method Overloading) |
|---|---|---|
| 发生作用域 | 具有继承关系的父类与子类之间(垂直跨层) | 同一类或同一模块作用域内部(水平同层) |
| Python 原生支持 | 原生完全支持,面向对象核心特性之一 | 原生不支持,同名方法以后定义的为准并覆盖 |
| 方法名与签名 | 方法名必须相同,参数签名通常保持兼容 | 传统要求方法名相同,参数个数或类型必须不同 |
| 底层运行机制 | 沿类的 MRO 链从下至上动态查找,找到即停止 | 命名空间字典 __dict__ 的键值赋值与替换 |
| 核心设计目的 | 特化或扩展子类行为,实现运行时的对象多态 | 统一接口名称,方便根据不同入参触发对应逻辑 |
| Pythonic 落地方式 | 子类直接 def 同名方法,按需借助 super() |
默认参数、*args/**kwargs、单分派或 typing.overload |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









