

怎么用Python提高爬虫速度?多线程与aiohttp异步并发详解
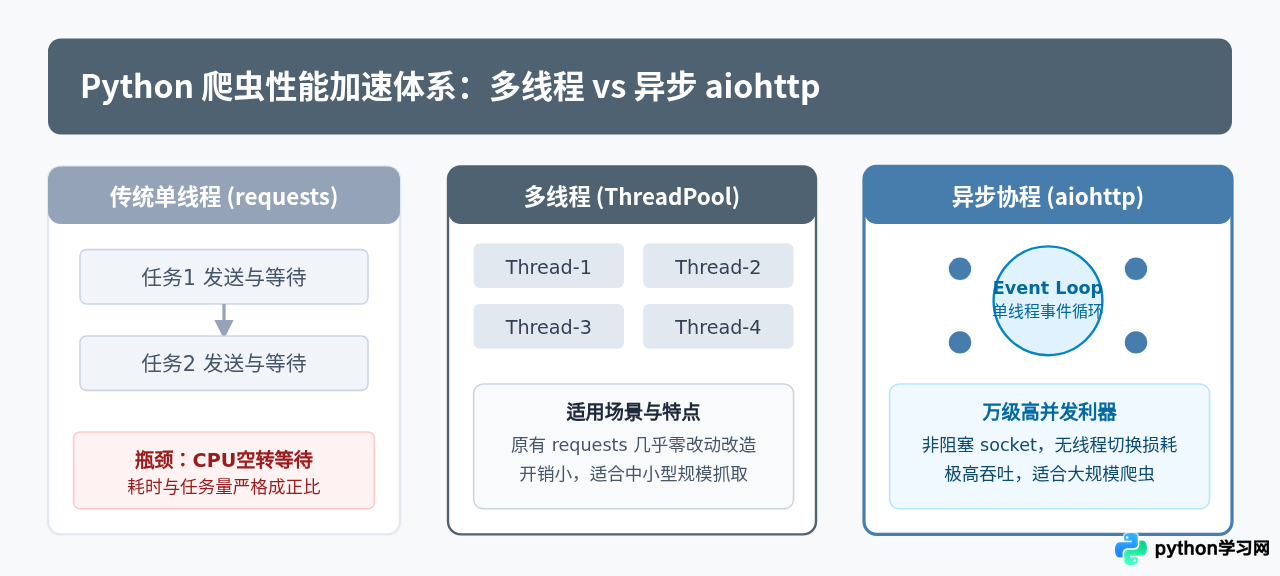
深入详解如何用Python提高网络爬虫抓取速度。对比传统单线程瓶颈,系统剖析ThreadPoolExecutor多线程与aiohttp异步协程的实现机制、完整代码模板、控频策略及技术选型指南。
concurrent.futures.ThreadPoolExecutor 的多线程方案与基于 aiohttp 的异步协程方案。
一、为什么单线程爬虫这么慢?识别网络 I/O 阻塞瓶颈
在编写基础爬虫时,大多数人最常用的组合是 requests.get() 配合简单的 for 循环。这种写法逻辑清晰,但面对成百上千个 URL 时,抓取耗时往往难以接受。
造成速度缓慢的根本原因在于网络 I/O 阻塞(Network I/O Wait)。当我们在代码中执行一次 HTTP 请求时,计算机会经历 DNS 解析、建立 TCP 握手、发送请求报文、服务端内部查询并生成响应、网络链路传输数据等一系列外部阶段。在这整个过程中,本地 CPU 的计算负荷几乎为 0,程序只能停在当前行死等服务器响应,这就是典型的串行等待。
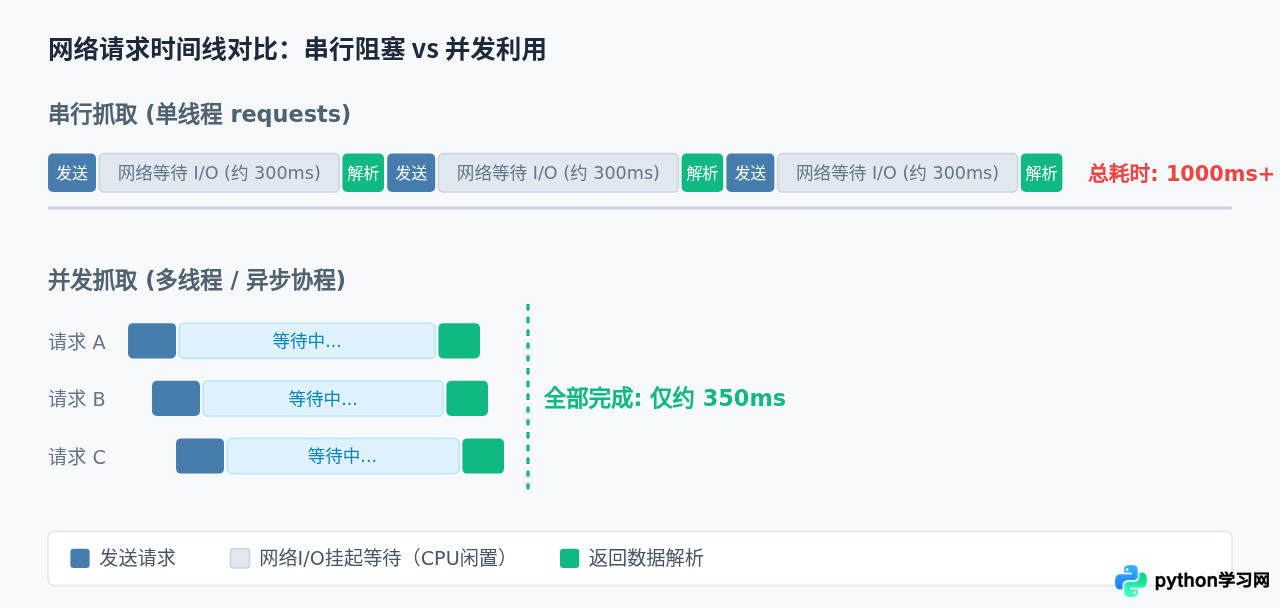
假设单个页面的往返网络延迟为 300 毫秒,抓取 1000 个页面:
- 串行方式:耗时 = 1000 × 0.3s ≈ 300 秒(5 分钟以上)。
- 并发方式(以 20 并发为例):多个等待重叠进行,耗时 = 300s / 20 ≈ 15 秒左右。
只要在等待网络响应的时间窗口内,让程序继续发送下一个请求,抓取速度就能获得成倍乃至数十倍的提升。
二、方案一:使用 ThreadPoolExecutor 快速实现多线程并发
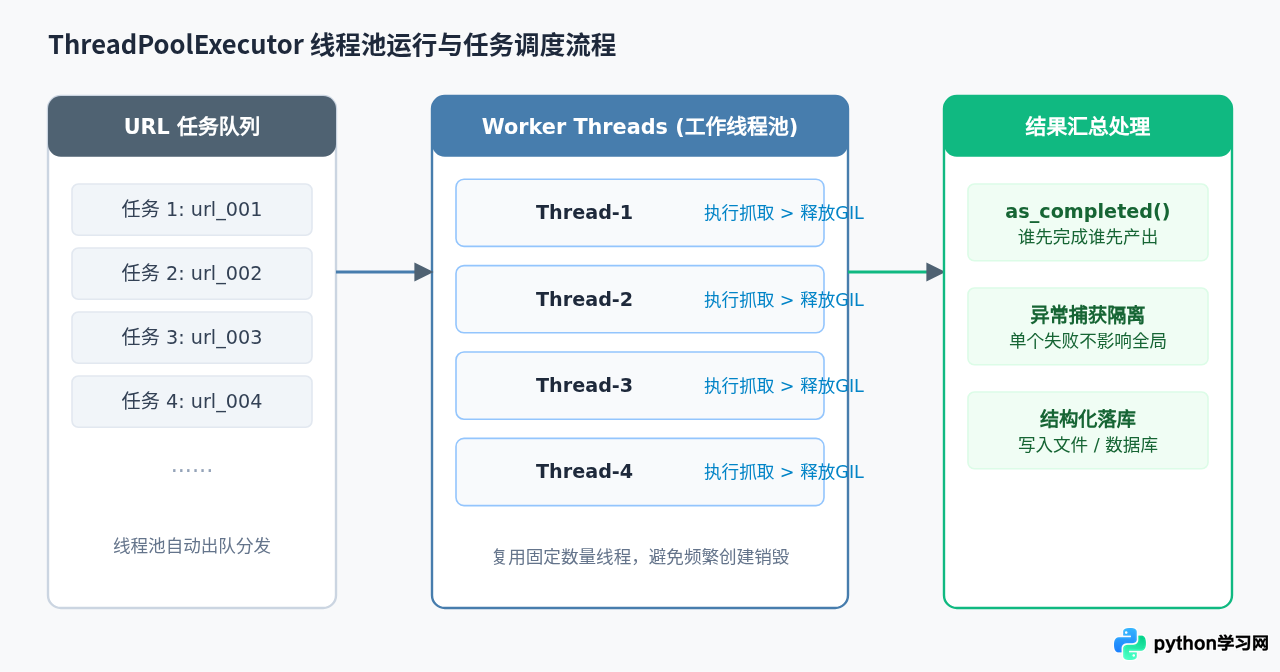
对于已有现成单线程爬虫代码的工程,多线程是改造成本最低、兼容性最好的加速方案。Python 标准库自带的 concurrent.futures.ThreadPoolExecutor 提供了高级线程池接口,省去了手动管理线程创建与销毁的繁琐操作。
1. 为什么 Python 的 GIL 不会阻碍爬虫多线程加速?
很多开发者听说过 Python 有全局解释器锁(GIL,Global Interpreter Lock),误以为 Python 的多线程毫无性能优势。这其实是对 GIL 适用场景的误解:
- CPU 密集型计算(如矩阵乘法、图像渲染):同一时刻只有一个线程能在 CPU 核心上运行字节码,多线程确实无法利用多核。
- I/O 密集型操作(如爬虫网络请求、磁盘读写):当线程执行到底层系统调用(如 socket 发送或接收数据)时,底层 C 代码会主动释放 GIL。在当前线程阻塞等待网络应答时,其他线程能够立即获得 GIL 继续执行发送任务。
因此,对于爬虫这种 95% 时间都在等网络的场景,多线程能带来非常显著的速度提升。
2. 多线程爬虫完整工程示例
下面是一个使用 ThreadPoolExecutor 并结合 requests.Session 优化 HTTP 传输的完整可用代码:
import concurrent.futures
import requests

# 1. 抓取单个目标页面的工作函数
def fetch_url(url, timeout=5):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }
    try:
        response = requests.get(url, headers=headers, timeout=timeout)
        response.raise_for_status()
        return {"url": url, "status": response.status_code, "length": len(response.text)}
    except requests.RequestException as exc:
        return {"url": url, "error": str(exc)}

# 2. 线程池并发管理器
def run_thread_crawler(urls, max_workers=10):
    results = []
    print(f"启动多线程抓取,任务数: {len(urls)}, 线程池容量: {max_workers}")

    with concurrent.futures.ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 提交所有任务至线程池,建立 future 到 url 的映射关系
        future_to_url = {executor.submit(fetch_url, url): url for url in urls}

        # as_completed 允许谁先返回就先处理谁,无需等待队首
        for future in concurrent.futures.as_completed(future_to_url):
            data = future.result()
            results.append(data)
            if "error" in data:
                print(f"[失败] {data['url']} -> 错误信息: {data['error']}")
            else:
                print(f"[成功] {data['url']} -> 抓取长度: {data['length']} 字符")

    return results

if __name__ == "__main__":
    # 构造目标测试列表(示例使用 httpbin 服务)
    target_urls = [f"https://httpbin.org/delay/1" for _ in range(10)]
    run_thread_crawler(target_urls, max_workers=5)
max_workers 并不是设得越大越好。在普通个人电脑与家庭网络环境下,推荐设置为 10 ~ 30。如果设置过大(例如 200+),操作系统线程上下文切换的开销会急剧上升,反而导致程序卡顿,且极易触发目标服务器的反爬虫封禁。
三、方案二:基于 aiohttp 与 asyncio 的高并发异步架构
如果抓取任务量达到数千甚至数万级别,多线程方案的内存消耗与操作系统开销就会显现出来。每个系统线程通常占用数兆字节内存,数千个线程将直接耗尽系统资源。
此时,异步 I/O(Asynchronous I/O)是更具扩展性的终极方案。基于 Python 官方的 asyncio 事件循环以及高性能异步网络库 aiohttp,可以在单进程单线程内轻松维护几千个处于挂起状态的并发连接。
1. 事件循环与协作式调度的核心机制
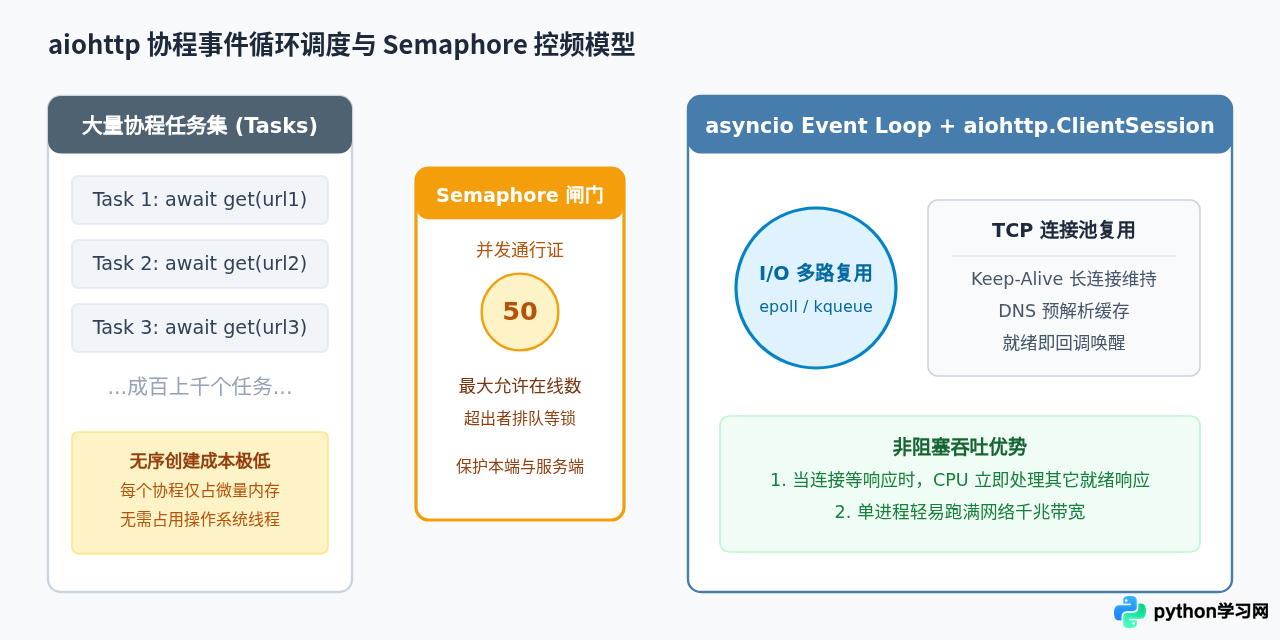
异步爬虫依靠单线程 + 事件循环(Event Loop)运行:
- 当一个请求发出后,使用
await关键字主动交出 CPU 执行权。 - 事件循环立即调度下一个准备就绪的任务去发送请求。
- 当底层操作系统通过 epoll/kqueue 通知某个套接字(Socket)有数据到达时,事件循环再唤醒对应的协程继续读取解析。
协程的创建只是一段微小的内存对象(几十字节到几百字节),几乎没有系统上下文切换的损耗。
2. aiohttp 异步并发完整工程代码
在编写 aiohttp 爬虫时,有两个极易踩坑的关键原则:
- 严禁在循环内反复创建
ClientSession:每个 Session 都包含连接池管理,必须在最外层创建并通过参数传递或全局复用。 - 必须使用
asyncio.Semaphore做并发流量截流:如果不加控制地一次性asyncio.gather(*tasks),程序会瞬间打开数千个套接字,直接导致操作系统触发Too many open files(errno 24)错误,或者被对端防火墙直接封禁。
规范的 aiohttp 高并发抓取模板如下:
import asyncio
import aiohttp

# 1. 单个抓取协程,包裹信号量与超时限制
async def fetch(session, url, semaphore):
    # 用信号量限制同时进入的网络连接数
    async with semaphore:
        timeout = aiohttp.ClientTimeout(total=8)
        try:
            async with session.get(url, timeout=timeout) as response:
                status = response.status
                text = await response.text()
                return {"url": url, "status": status, "length": len(text)}
        except asyncio.TimeoutError:
            return {"url": url, "error": "请求超时"}
        except aiohttp.ClientError as exc:
            return {"url": url, "error": f"网络错误: {exc}"}
        except Exception as exc:
            return {"url": url, "error": f"未知异常: {exc}"}

# 2. 异步批处理主控函数
async def main_crawler(urls, max_concurrent=50):
    # 限制最大同时活跃连接数为 50
    semaphore = asyncio.Semaphore(max_concurrent)

    # 优化 TCP 保持连接和连接池上限
    connector = aiohttp.TCPConnector(limit=max_concurrent + 10, keepalive_timeout=30)

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    async with aiohttp.ClientSession(connector=connector, headers=headers) as session:
        # 为每个 URL 打包协程任务
        tasks = [fetch(session, url, semaphore) for url in urls]

        # 并发执行全部任务并等待聚合结果
        print(f"正在异步并发请求 {len(urls)} 个目标,限制活跃并发: {max_concurrent}")
        results = await asyncio.gather(*tasks, return_exceptions=True)
        return results

if __name__ == "__main__":
    # 模拟构造 20 个目标抓取任务
    target_urls = [f"https://httpbin.org/get?item={i}" for i in range(20)]

    # 启动 Python 异步事件循环
    fetched_data = asyncio.run(main_crawler(target_urls, max_concurrent=10))

    # 输出结果验证
    success_count = sum(1 for item in fetched_data if isinstance(item, dict) and "length" in item)
    print(f"抓取完成!成功: {success_count}/{len(target_urls)}")
四、多线程与 aiohttp 选型对比与决策场景
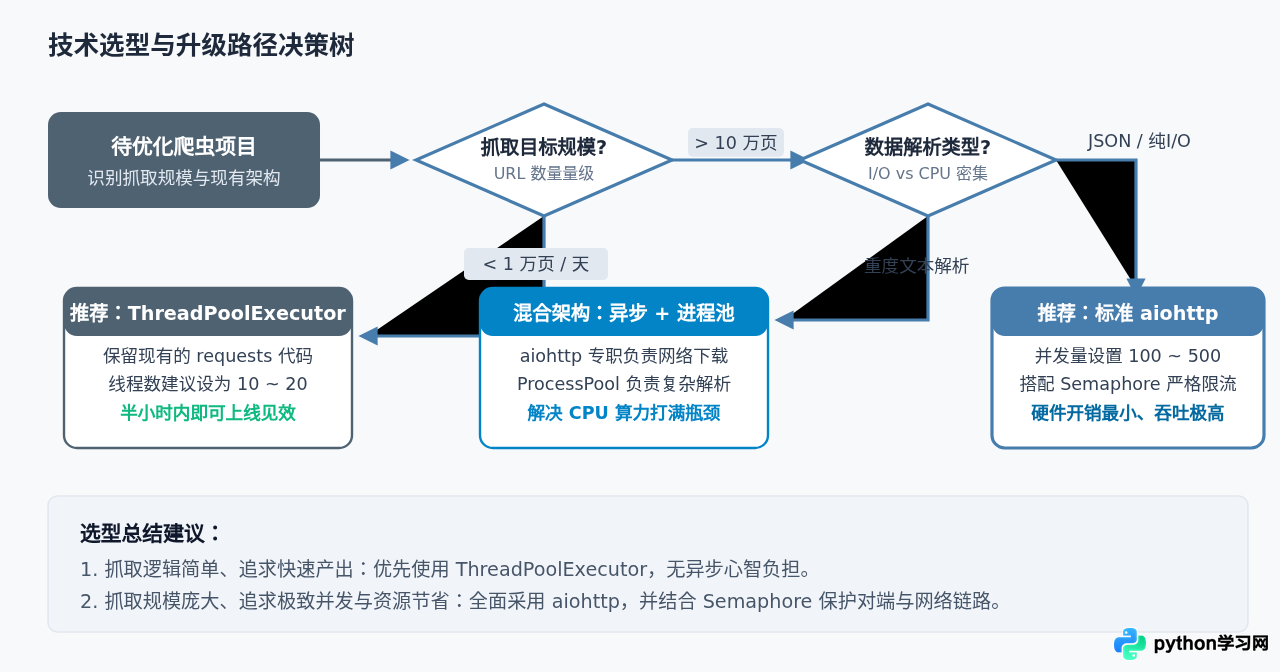
在面对具体的爬虫项目时,应当如何在这两者之间做决定?下表从开发成本、运行效率和适用场景进行了详细对比:
| 对比维度 | 多线程 (ThreadPoolExecutor) | 异步协程 (aiohttp + asyncio) |
|---|---|---|
| 改造成本 | 极低。可直接复用现有 requests 逻辑与解析函数。 |
中等。需要全流程适配 async/await 语法。 |
| 单机并发上限 | 受限于系统线程栈,通常维持在 50 ~ 100。 |
受限于网络带宽与文件描述符,可达 500 ~ 2000+。 |
| 系统资源消耗 | 每个线程约 1~8MB 栈空间,存在线程调度开销。 | 协程仅占微量内存,几乎无线程切换开销。 |
| 生态与第三方库 | 全面兼容各类通用库(如 BeautifulSoup、lxml、SQLAlchemy)。 | 解析耗时大时需放到线程池,避免阻塞事件循环。 |
| 调试排错难度 | 较低,堆栈跟踪符合直觉。 | 稍高,异步异常堆栈较长,需警惕未捕获协程。 |
| 推荐业务场景 | 中小规模(万级以内)、已有成熟业务逻辑迁移、开发周期短。 | 大规模(数万到百万级)、高吞吐实时数据监控、纯 I/O 型接口。 |
五、高并发爬虫必备的稳定性与防护设计
一旦爬虫并发度提升数倍,很多在串行爬取时不会显现的问题便会集中爆发。为了确保爬虫持续稳定运行,必须落实以下关键配置:
1. 必须配置明确的超时时间(Timeout)
在默认情况下,requests.get() 与未配置超时的 aiohttp 可能会永远等待套接字握手。如果目标网站某台反向代理故障,悬空的连接会一直占用线程或连接池,导致整个爬虫完全“假死”。务必针对 connect(建连)和 read(读数据)阶段配置 5 ~ 10 秒超时。
2. 建立错误重试机制与退避策略
网络抖动、偶发丢包在高并发下属于常态。对于偶发的 502/503/504 或超时错误,应使用带延迟的重试机制(例如重试 3 次,每次间隔 1 秒),避免直接丢弃抓取失败的 URL。
asyncio.sleep(random.uniform(0.1, 0.5)))模拟自然流量。
六、总结
提升 Python 爬虫速度的关键,在于打破网络 I/O 阻塞带来的等待空耗:
- 对于常规规模、已有现成业务代码的项目,使用标准库的
ThreadPoolExecutor是最稳妥省力的方式,通过简单的线程池分发即可获得 5~10 倍的提升。 - 对于高吞吐、大规模的任务集群,采用
aiohttp + asyncio是性能上限最高的方案,配合asyncio.Semaphore能够以极低的内存开销平稳支撑千级并发。
根据自身抓取规模合理选择并发架构,并配合严格的超时控制与频控策略,就能在大幅提升数据采集效率的同时保证系统的稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









