

高并发场景下Python数据库连接池参数调优策略
深入解析高并发场景下Python数据库连接池参数调优策略,涵盖多进程Worker连接数换算、QueuePool核心参数基线推导、超时熔断与主动探活自愈机制,并给出标准化的压测验证与故障排查方案。
假设某基于 Gunicorn 与 FastAPI/Flask 构建的 Python 订单服务突遇流量洪峰,监控大屏瞬间亮起报警:应用端日志大面积爆出 TimeoutError: QueuePool limit of size 5 overflow 10 reached, connection timed out, timeout 30.00,后续请求全部卡死超时并级联引发 Nginx 504 网关超时;而在另一种配置失误下,运维会看到相反的极端惨状——数据库实例连接数瞬间被挤爆,抛出 OperationalError: (1040, 'Too many connections'),直接导致整座数据库服务器宕机挂起。
核心解决路径:高并发下 Python 数据库连接池调优的关键,绝不是单向盲目增大连接数,而是结合 Python 多进程(Multi-Processing)部署模型与数据库硬件承载上限,遵循“紧凑常驻基线 + 适度弹性溢出 + 快速失败熔断 + 透明探活自愈”的调优原则,通过精准收敛 pool_size、max_overflow、pool_timeout、pool_recycle 与 pool_pre_ping 五大核心参数,在保障数据库安全水位的边界内获取最大吞吐性能。
一、Python多进程部署与连接池的全局资源约束模型
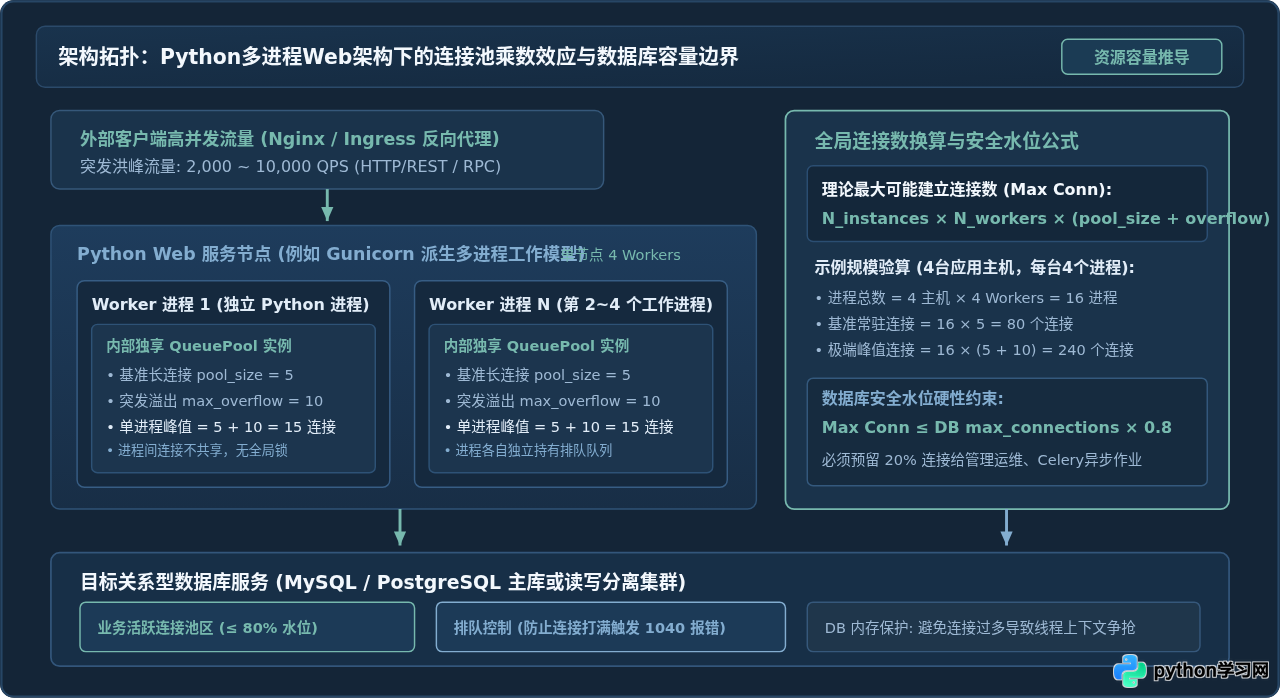
很多初次接触 Python 性能调优的工程师,常直接套用 Java Spring Boot 的连接池经验。Java 依托单 JVM 进程内的庞大线程池,单进程持有一个全局共享的 HikariCP 连接池;但在 CPython 环境中,受全局解释器锁(GIL)制约,生产服务(如 Gunicorn、uWSGI)普遍采用多独立工作进程(Multi-Worker Processes)模式,每个 Worker 都是一个物理隔离的 Python 进程。
这意味着:每个 Worker 进程都在其内部独立初始化并持有一套完整的连接池(如 SQLAlchemy 的 QueuePool)。如果一台主机启动了 8 个 Gunicorn Worker 进程,那么每个 Worker 的 pool_size=10 将意味着单台机器就可能常驻 80 个数据库连接;若是集群部署了 5 台应用实例,常驻长连接总数就会骤增至 400 个。
在设计参数前,必须严格依据上述拓扑公式进行容量反推。数据库端的 max_connections(如 MySQL 默认的 151,常见生产配置为 1000 ~ 2000)是所有客户端共享的硬性天花板。必须强制预留 20% 以上的安全余量,给后台异步离线任务(如 Celery Workers)、定时脚本、日志分析以及 DBA 的紧急管理通道(MySQL 会为 SUPER 权限保留 1 个连接,但在雪崩时往往杯水车薪)。
read_buffer_size、sort_buffer_size)。当活跃连接从几十个激增到数千个时,CPU 会将大量计算资源耗费在操作系统的线程上下文切换(Context Switching)和内存锁争用(Lock Contention)上,数据库吞吐量(QPS)反而会呈现断崖式下跌,甚至引发 OOM 崩溃。
二、核心连接池参数解析与高并发调优取舍
以 Python 社区事实标准的 SQLAlchemy QueuePool 为核心剖析对象,各关键参数在高并发环境下承担着截然不同的战略职能:
1. pool_size(常驻基线连接数)
pool_size 定义了每个 Worker 进程内部长期保持存活的长连接基准上限。连接池初始化后采用惰性建立机制,只有当请求到达时才会实际建立物理 TCP 连接。在平稳流量期间,这部分连接在借出、执行、归还后依然留在池内,避免频繁进行 TCP 三次握手和数据库身份认证握手的开销。
调优建议:在多 Worker 部署下,pool_size 建议保持相对紧凑,单 Worker 通常设置为 5 ~ 15。例如 4 核服务器启动 4 个 Worker,单机 pool_size=5 即可支撑 20 个常驻连接。过大的 pool_size 会导致服务在闲时白白占用数据库宝贵的连接句柄与内存资源。
2. max_overflow(突发弹性溢出连接数)
当并发请求量突然跃升,池内全部 pool_size 连接都处于被借出(Checked-Out)状态时,连接池允许额外新建的连接数量上限就是 max_overflow。这些溢出连接是应对秒杀或浪涌请求的“弹性安全气囊”;一旦请求处理完毕并执行归还(Checkin),超出 pool_size 的连接会被主动关闭并断开物理 Socket,池大小自动平滑收缩回归常态。
调优建议:建议配比为 max_overflow = (1 ~ 2) × pool_size。切忌将 max_overflow 设为 -1(无限制),无限制溢出等于直接拆除了熔断保险丝,一旦遇到慢查询就会在几秒内将数据库连接池彻底打穿。
3. pool_timeout(获取连接等待超时)
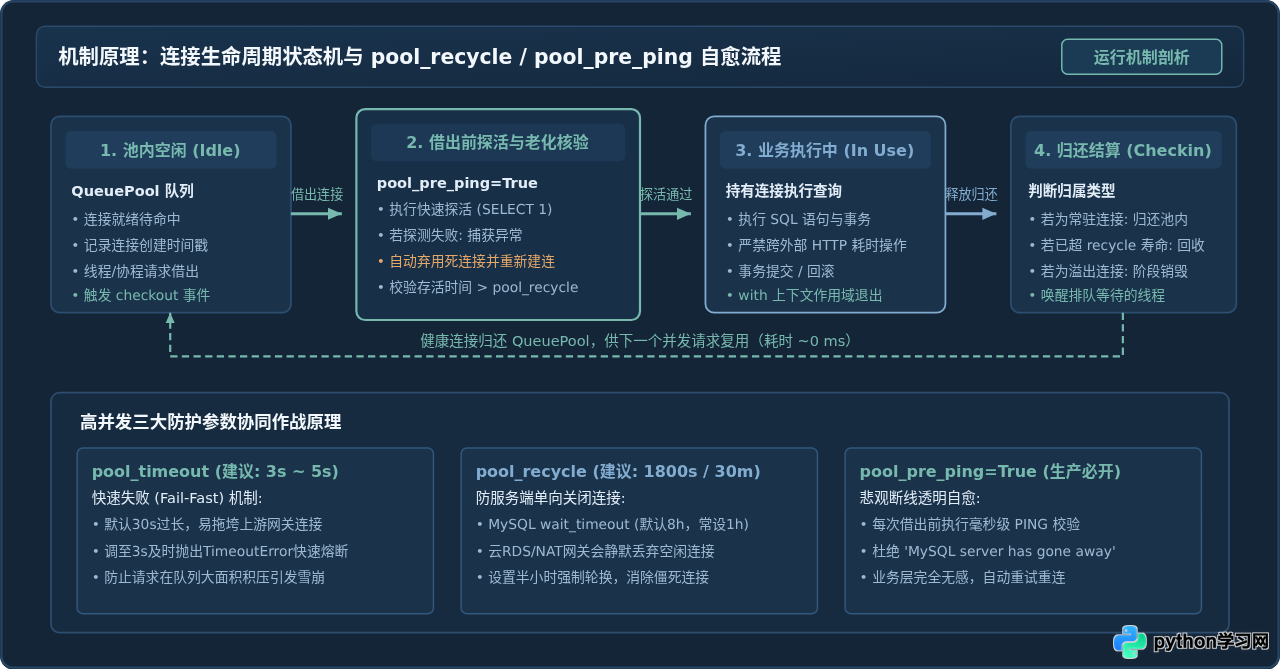
当 pool_size + max_overflow 全部耗尽时,新进来的请求只能进入队列阻塞等待其他线程归还连接。pool_timeout 指定了等待的最长秒数。SQLAlchemy 的默认值为 30 秒,但在高并发互联网服务中,默认 30 秒是极其危险的负优化。
调优建议:必须将 pool_timeout 缩短至 3 ~ 5 秒。在高并发服务中,让一个 HTTP 请求在连接池外排队 30 秒毫无意义——上游 Nginx 或网关往往早就判定超时并返回 504,而后端 Python 线程还在死等,导致整个工作进程被活活占死。通过缩短超时触发快速失败(Fail-Fast),应用层可以迅速捕获 TimeoutError,立即降级返回或熔断,保护后端架构不被拖垮。
4. pool_recycle(强制回收生命周期)
许多生产故障表现为:应用在夜间闲时无人访问,早晨第一笔请求到来时突然报出 MySQL server has gone away 或 OperationalError: (2006)。根本原因在于数据库服务端(如 MySQL 的 wait_timeout,默认 28800 秒,云厂商多设为 600~1800 秒)或中间的防火墙/云 NAT 网关会单向关闭长期空闲的 TCP 连接,而 Python 端并不知晓,持有的 Socket 成为已失效的半开连接(Half-Open Socket)。
调优建议:设置 pool_recycle=1800(30 分钟)或更短(例如 600 秒)。当一条连接从池中借出时,若其存活时间超过了该阈值,连接池会自动将旧连接关闭并建立新的底层连接,确保连接在被服务端单向斩断前完成自我更新。
5. pool_pre_ping(借出前探活机制)
即便配置了 pool_recycle,若数据库主从切换、网络短暂闪断或数据库进程重启,池中现存的所有连接都会瞬间失效。开启 pool_pre_ping=True 是现代 Python 数据库栈的最关键保活手段。
机制与代价:开启后,每次应用线程调用 engine.connect() 借出连接前,连接池会自动向数据库发送一条极其轻量的探测指令(通常是 SELECT 1 或执行 DBAPI 驱动的 ping 方法)。如果探测失败,连接池会立刻丢弃该死连接,并尝试透明重建一条新连接归还给业务代码,业务层完全感知不到底层闪断。虽然这会带来约 1 次网络往返(约 0.2~1ms)的轻微开销,但在高并发可用性面前,这笔开销是极为值得的工程交换。
三、典型生产代码配置与连接防泄漏规范
在工程落地中,调优参数不仅需要写入引擎初始化配置,还必须通过规范的上下文管理避免出现“连接泄漏”。以下提供基于 SQLAlchemy 2.0 工业级标准配置示例:
1. 同步框架生产级连接池初始化配置 (SQLAlchemy 2.0)
import os
from sqlalchemy import create_engine
from sqlalchemy.pool import QueuePool

# 读取环境变量或高可用配置中心
DATABASE_URL = os.getenv(
    "DATABASE_URL",
    "mysql+pymysql://app_user:SecurePasswd99@db-primary.internal:3306/trade_db?charset=utf8mb4"
)

# 构建高并发调优引擎
engine = create_engine(
    DATABASE_URL,
    poolclass=QueuePool,            # 明确指定排队连接池
    pool_size=10,                   # 常驻连接基线(每 Worker 10 个)
    max_overflow=20,                # 突发弹性缓冲连接(最多溢出 20 个)
    pool_timeout=3.0,               # 借出排队超时设为 3 秒,实现快速失败
    pool_recycle=1800,              # 30分钟主动回收,防止服务断开与NAT静默切断
    pool_pre_ping=True,             # 借出前悲观探活,杜绝 'MySQL server has gone away'
    pool_use_lifo=True,             # 后进先出策略,让活跃连接最大化复用,减少闲置
    echo=False                      # 生产环境务必关闭 SQL 文本调试输出,避免标准输出阻塞
)pool_use_lifo=True 的妙用SQLAlchemy 提供了
pool_use_lifo(后进先出)选项。在流量波动时,LIFO 策略让最近刚归还的连接最优先被借出,使得一部分核心连接保持高度活跃,而较少使用的冗余连接更容易达到 pool_recycle 或空闲超时被自然清理,大幅减轻数据库整体负载。
2. 异步高并发连接池配置 (FastAPI + asyncpg)
如果采用异步协程架构(如 FastAPI + asyncpg / AsyncEngine),由于协程上下文切换极轻,单 Worker 可以处理上万并发。但协程并发高并不意味着连接池就要开得巨大,因为底层瓶颈依然是数据库磁盘 I/O 和 CPU 锁:
from sqlalchemy.ext.asyncio import create_async_engine, AsyncSession
from sqlalchemy.orm import sessionmaker

async_engine = create_async_engine(
    "postgresql+asyncpg://app_user:SecurePasswd99@pg-primary.internal:5432/trade_db",
    pool_size=15,
    max_overflow=15,
    pool_timeout=3.0,
    pool_recycle=1200,
    pool_pre_ping=True,
    connect_args={
        "server_settings": {"application_name": "fastapi_order_service"},
        "command_timeout": 5.0      # 单条 SQL 执行超时熔断,防止慢查拖死连接
    }
)
3. 杜绝连接泄漏:严格执行借出即还的上下文管理
调优参数设置得再科学,若业务代码存在连接泄漏,连接池也会在短时间内枯竭。典型反模式包括:在持有数据库连接的同时去调用第三方外部 HTTP 接口,或在发生异常时未能在 finally 块中归还连接。
# 正确做法:利用 Python 上下文管理器 (Context Manager) 严格限定连接生命周期
from sqlalchemy import text

def query_user_order_status(order_id: str):
    # 仅在实际需要执行 SQL 时才进入 connect 上下文
    with engine.connect() as conn:
        stmt = text("SELECT id, status, amount FROM orders WHERE id = :oid")
        result = conn.execute(stmt, {"oid": order_id}).fetchone()
        return dict(result._mapping) if result else None
    # 退出 with 块瞬间,连接已被自动归还给 QueuePool,后续计算或网络调用不占用连接资源
四、连接池调优与压测验证标准化操作步骤
连接池调优是一门基于可观测性数据的工程实验,严禁在生产环境凭直觉随意修改参数。标准的调优实施流程应分为四个闭环阶段:
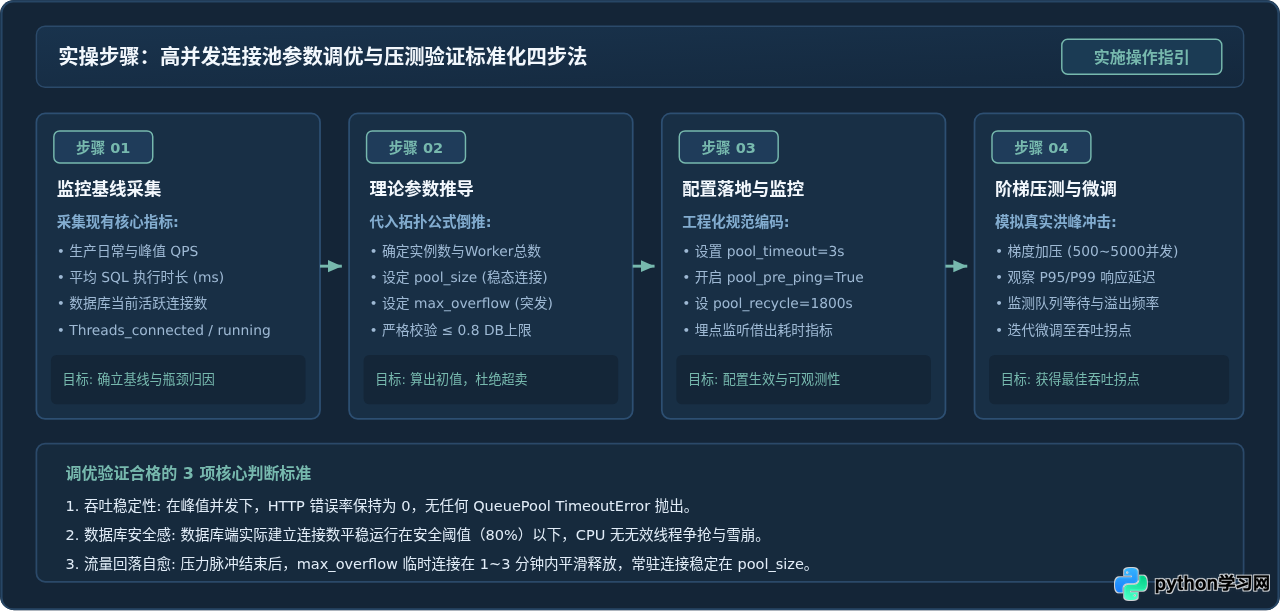
第一步:采集监控基线与性能画像
在调整任何配置前,必须通过 Prometheus、Datadog 或数据库内部性能视图采集基线数据:
- 业务指标:稳态 QPS、峰值 QPS、单次请求内部数据库查询次数、P95/P99 事务执行耗时。
- 数据库端指标:执行
SHOW GLOBAL STATUS LIKE 'Threads_connected';和SHOW GLOBAL STATUS LIKE 'Threads_running';,观察活跃执行线程数与建立连接数的比例。 - 排队指标:记录当前应用是否已经发生连接池获取超时,超时的频率与发生时间段。
第二步:代入容量拓扑公式反推初始参数
以实际集群环境为例,假设后端部署 4 个容器 Pod,每个 Pod 运行 4 个 Gunicorn Worker(总计 16 个 Worker 进程),后端数据库设定 max_connections = 600:
- 计算安全可用总连接数:
600 × 0.8 = 480个。 - 扣除后台 Celery 及运维通道占用 80 个,剩余给 Web 服务的可用最大连接数为
400个。 - 平均分配到 16 个 Worker 进程,每个 Worker 允许的最大连接上限为:
400 ÷ 16 = 25个。 - 设定参数配比:常驻连接
pool_size = 8,弹性溢出max_overflow = 16(总和8 + 16 = 24 ≤ 25),既保证了资源安全,又保留了充足的突发缓冲。
第三步:配置落地与连接池可观测性埋点
通过 SQLAlchemy 提供的 Event 监听机制,把连接池的借出(checkout)、归还(checkin)时延打入应用监控系统,以便精准捕捉连接阻塞:
from sqlalchemy import event
import time
import logging

logger = logging.getLogger("pool_monitor")

@event.listens_for(engine, "checkout")
def receive_checkout(dbapi_connection, connection_record, connection_proxy):
    connection_record.info['checkout_start'] = time.time()

@event.listens_for(engine, "checkin")
def receive_checkin(dbapi_connection, connection_record):
    start = connection_record.info.get('checkout_start')
    if start:
        duration = time.time() - start
        # 当某个业务持有连接超过 500ms 时打印慢事务告警
        if duration > 0.5:
            logger.warning(f"数据库连接持有时间过长: {duration:.3f}s,可能存在慢SQL或阻塞")
第四步:阶梯式压力测试与动态微调
使用压测工具(如 Locust、wrk 或 JMeter)模拟流量阶梯爬坡:
- 基准阶梯(500 QPS):验证
pool_size是否平稳承载,此阶段不应触发任何max_overflow溢出。 - 压力阶梯(2000 QPS):模拟大促突发流量,观察
max_overflow弹性连接是否及时创建,P99 延迟是否在可接受范围内。 - 极限破坏测试(5000+ QPS):观察
pool_timeout=3s是否能够有效阻断上游雪崩,是否有快速失败的友好降级响应,同时验证数据库端Threads_connected是否严格受控在设定的安全阈值内。
五、核心参数速查矩阵与典型故障诊断
为了帮助工程师在排障与架构评审中迅速定位问题,下表梳理了高并发核心参数的配置矩阵:
| 核心参数 | 典型推荐值 | 参数职能定位 | 过大风险 | 过小风险 |
|---|---|---|---|---|
| pool_size | 5 ~ 15 / Worker | 稳态常驻连接基准 | 闲时占用过多数据库内存与连接句柄 | 频繁创建/销毁连接,增加 TCP 握手开销 |
| max_overflow | 10 ~ 20 / Worker | 应对突发瞬时流量缓冲 | 极端并发下打满数据库 max_connections |
缓冲池容量不足,微小浪涌即引发排队超时 |
| pool_timeout | 3 ~ 5 秒 | 获取连接排队超时与熔断 | 默认30s过长,导致整条调用链请求堆积雪崩 | 网络轻微毛刺即触发报错,错误率假性升高 |
| pool_recycle | 1800 秒 (30m) | 防服务端与NAT静默断开 | 超过 MySQL wait_timeout 产生半开僵死连接 |
连接轮换过于频繁,丧失长连接复用优势 |
| pool_pre_ping | True (生产开启) | 借出前透明断线探活 | 带来约一次网络 RTT(约 0.2~1ms)微小开销 | 遇到网络闪断/主从切换直接报 2006 异常 |
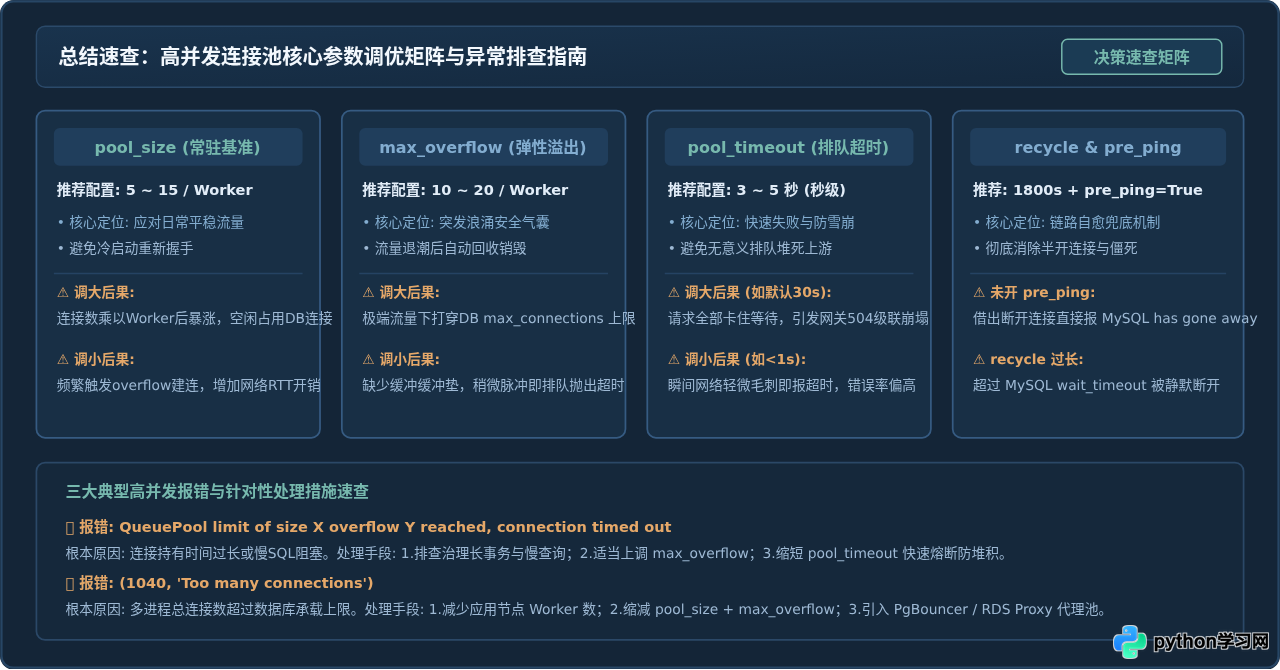
常见典型报错与排查决策树
-
报错表现:
TimeoutError: QueuePool limit of size 5 overflow 10 reached, connection timed out, timeout 3.00
根因排查:应用当前持有的连接已达到 15 个上限,新请求无法在 3 秒内拿到连接。首先检查监控是否存在慢查询或长事务未提交,其次检查是否有跨外部 HTTP 请求持有数据库连接的代码;如果慢查询已治理且数据库负载不高,可按比例上调当前服务的max_overflow。 -
报错表现:
OperationalError: (1040, 'Too many connections')
根因排查:数据库物理连接已达上限。立即核算全部实例数 × Worker数 × (pool_size + max_overflow)是否超出数据库承载;如果是分布式微服务节点过多导致的“连接数爆炸”,应当下调各服务的pool_size,或者在架构中引入数据库连接代理池中间件(如 PgBouncer 或 MySQL Router / RDS Proxy)实现连接的集中收敛复用。 -
报错表现:
OperationalError: (2006, 'MySQL server has gone away')
根因排查:应用尝试在一个已经被服务端切断的 Socket 上发送 SQL。确保开启pool_pre_ping=True,并将pool_recycle明确设置为小于 MySQLwait_timeout的安全数值(如 1800 秒)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









