

Python使用mutagen批量编辑音频文件的ID3标签备注
使用 Python 结合 mutagen 库批量修改 MP3 音频文件的 ID3 备注(COMM 帧),涵盖二进制帧结构解析、跨平台兼容性设置、递归批处理脚本与常见避坑指南。
批量修改音频文件(如 MP3)的“备注”(Comment)信息,是整理个人音乐库、广播节目、播客归档或清理抓轨广告标记的高频需求。在 Python 生态中,mutagen 凭借其原生纯 Python 实现、对多种音频格式的广泛支持以及对 ID3 标准细节的精确把控,成为了处理音频元数据的首选工具。本文将详细讲解 ID3 备注帧(COMM)的组织原理,并提供一套具备异常捕获、备份容灾和跨平台播放器兼容的高可用批量处理脚本。
一、ID3 规范与 COMM 备注帧的核心结构
MP3 文件的元数据主要存放在 ID3 容器中。早期的 ID3v1 位于文件末尾,容量仅 128 字节,其中“备注”字段被严格限制在 30 字节以内,且缺乏字符集声明,极易出现中文乱码。目前通用的 ID3v2 标签位于文件头部,采用分块帧(Frame)的设计,每个帧承载特定的元数据,例如 TIT2 表示歌曲标题、TPE1 表示主要艺术家,而 COMM 则专门用于存放备注内容。
与简单的文本帧不同,COMM 帧由多个紧密排列的字段构成:
- 编码字节(Encoding):指定文本字符集。
0为 ISO-8859-1,1为带 BOM 的 UTF-16,2为 UTF-16BE,3为 UTF-8。写入中文时必须采用3(UTF-8)或1(UTF-16)。 - 语言代码(Language):3 字节的 ISO-639-2 语言代码。通常为
'eng'(英语)或'XXX'(未指定)。许多播放器仅会读取默认语言的备注。 - 描述字符串(Description):用于区分多段注释的子标识。普通主备注的描述通常为空字符串
''。 - 正文列表(Text):实际的备注文本字符串列表,以变长字节存放。
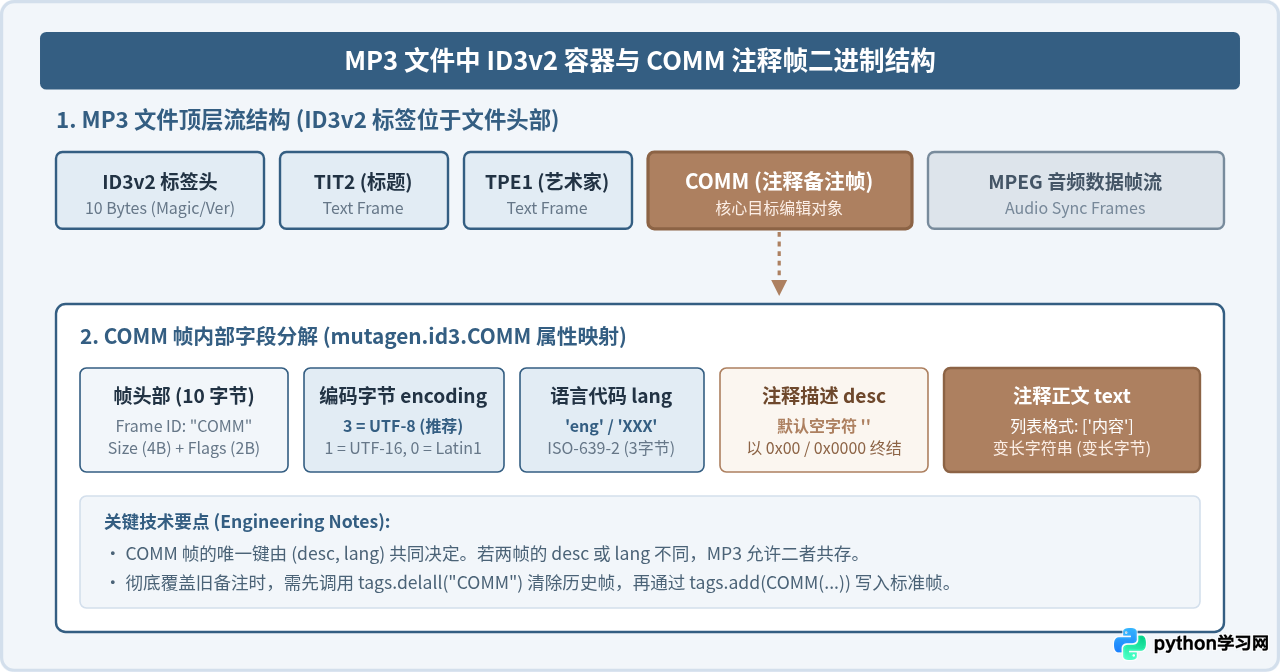
desc 或不同 lang 的 COMM 帧同时存在,直接进行字典式添加可能会导致多重备注共存。在批量修改时,应先执行清理,再显式插入目标帧。
二、环境准备与依赖安装
首先在命令行中安装最新版本的 mutagen 库:
pip install mutagen该库无额外的 C 编译依赖,支持 Python 3.8 及以上版本。可以通过以下测试命令验证安装是否成功:
python -c "import mutagen; print(mutagen.version_string)"三、核心操作:单音频文件 COMM 帧读写
在编写批量脚本之前,先看如何通过 mutagen.id3.ID3 和 mutagen.id3.COMM 针对单文件完成读写。处理单文件时,需要防范“音频文件原本不包含 ID3 头”的特殊情况(会抛出 ID3NoHeaderError 异常)。
from mutagen.id3 import ID3, COMM, ID3NoHeaderError

def read_and_update_comment(mp3_path: str, new_comment_text: str):
    """
    安全读取并更新单个 MP3 文件的备注。
    """
    try:
        tags = ID3(mp3_path)
    except ID3NoHeaderError:
        # 文件不存在 ID3 头部时,初始化全新标签对象
        tags = ID3()

    # 1. 读取并打印现有备注 (仅供调试查看)
    existing_comments = tags.getall("COMM")
    for comm in existing_comments:
        print(f"原备注 [lang={comm.lang}, desc={comm.desc}]: {comm.text}")

    # 2. 清除所有已存在的 COMM 帧,确保写入幂等且不残留历史脏数据
    tags.delall("COMM")

    # 3. 构造标准 COMM 帧
    # encoding=3 (UTF-8), lang='eng' (广泛兼容), desc='' (默认主注释), text 必须为列表
    new_frame = COMM(
        encoding=3,
        lang="eng",
        desc="",
        text=[new_comment_text]
    )
    tags.add(new_frame)

    # 4. 显式保存为 ID3v2.3 规范,防止 Windows 资源管理器读取失效
    tags.save(mp3_path, v2_version=3)
    print(f"成功更新备注: {mp3_path}")
四、批量编辑脚本实现:递归扫描与异常隔离
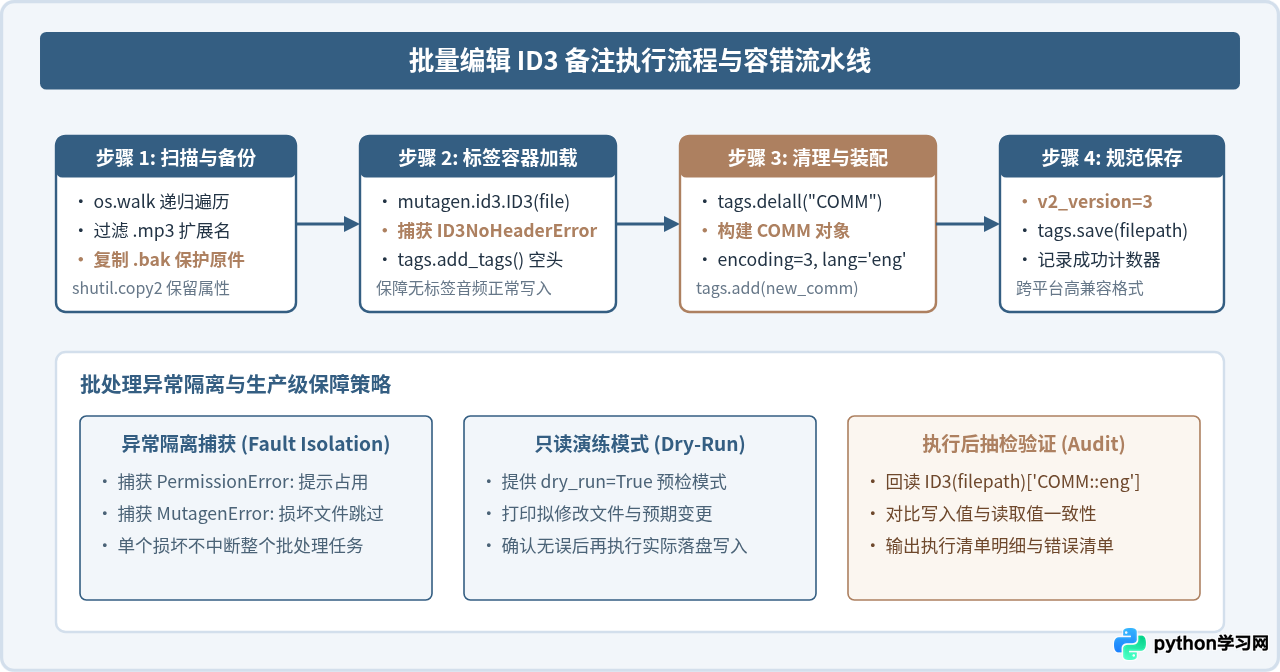
生产环境下的批量修改任务,必须满足三个关键指标:能够递归处理深层文件夹、能够在修改前对原文件提供安全备份、以及在遇到只读或损坏文件时不崩溃中断。下面给出完整的批量编辑脚本。
import os
import shutil
import logging
from typing import List, Tuple
from mutagen import MutagenError
from mutagen.id3 import ID3, COMM, ID3NoHeaderError

# 配置日志记录格式
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)
logger = logging.getLogger("AudioTagger")

def batch_update_mp3_comments(
    folder_path: str,
    target_comment: str,
    create_backup: bool = True,
    dry_run: bool = False
) -> Tuple[int, int, List[Tuple[str, str]]]:
    """
    递归批量更新指定目录下所有 MP3 文件的 ID3 备注。

    :param folder_path: 目标音频根目录
    :param target_comment: 要设置的新备注内容
    :param create_backup: 是否在写入前创建 .bak 副本
    :param dry_run: 演练模式(只打印待处理项,不真正写盘)
    :return: (成功处理数, 失败数, 错误信息列表)
    """
    if not os.path.exists(folder_path):
        raise FileNotFoundError(f"指定的目录不存在: {folder_path}")

    success_count = 0
    failure_count = 0
    error_log: List[Tuple[str, str]] = []

    logger.info("开始扫描目录: %s (DryRun=%s)", folder_path, dry_run)

    for root, _, files in os.walk(folder_path):
        for filename in files:
            # 严格过滤 MP3 扩展名,忽略大小写
            if not filename.lower().endswith(".mp3"):
                continue

            file_path = os.path.join(root, filename)

            if dry_run:
                logger.info("[演练] 发现文件: %s 将更新备注为: %s", file_path, target_comment)
                success_count += 1
                continue

            try:
                # 1. 备份机制:若开启备份,先复制原文件为 filename.bak
                if create_backup:
                    backup_path = file_path + ".bak"
                    if not os.path.exists(backup_path):
                        shutil.copy2(file_path, backup_path)

                # 2. 读取/初始化 ID3 容器
                try:
                    tags = ID3(file_path)
                except ID3NoHeaderError:
                    tags = ID3()

                # 3. 彻底清除已有 COMM 帧,确保写入洁净
                tags.delall("COMM")

                # 4. 创建规范的 COMM 帧对象
                comm_frame = COMM(
                    encoding=3,          # 3 代表 UTF-8 编码
                    lang="eng",          # 广泛兼容的语言代码
                    desc="",             # 默认主描述为空
                    text=[target_comment] # 字符串存放在列表中
                )
                tags.add(comm_frame)

                # 5. 显式保存为 ID3v2.3 规范格式
                tags.save(file_path, v2_version=3)
                success_count += 1
                logger.debug("成功写入: %s", file_path)

            except PermissionError as pe:
                failure_count += 1
                err_msg = f"文件只读或正在被播放器占用: {pe}"
                logger.error("处理失败 [%s]: %s", file_path, err_msg)
                error_log.append((file_path, err_msg))
            except MutagenError as me:
                failure_count += 1
                err_msg = f"音频数据头损坏或无法解析: {me}"
                logger.error("解析失败 [%s]: %s", file_path, err_msg)
                error_log.append((file_path, err_msg))
            except Exception as e:
                failure_count += 1
                err_msg = f"未预期异常: {e}"
                logger.error("异常终止 [%s]: %s", file_path, err_msg)
                error_log.append((file_path, err_msg))

    logger.info("批处理执行完毕!成功: %d, 失败: %d", success_count, failure_count)
    return success_count, failure_count, error_log

if __name__ == "__main__":
    # 使用示例:将目标目录下的所有 MP3 备注统一设置为专辑说明
    target_directory = "./music_collection"
    comment_content = "2026年数字母带重制版 / 归档编号: ARC-809"

    # 先进行只读演练,确认无误后再实际写入
    batch_update_mp3_comments(target_directory, comment_content, dry_run=True)
    # batch_update_mp3_comments(target_directory, comment_content, dry_run=False, create_backup=True)
五、类选型与 COMM 帧键名机制剖析
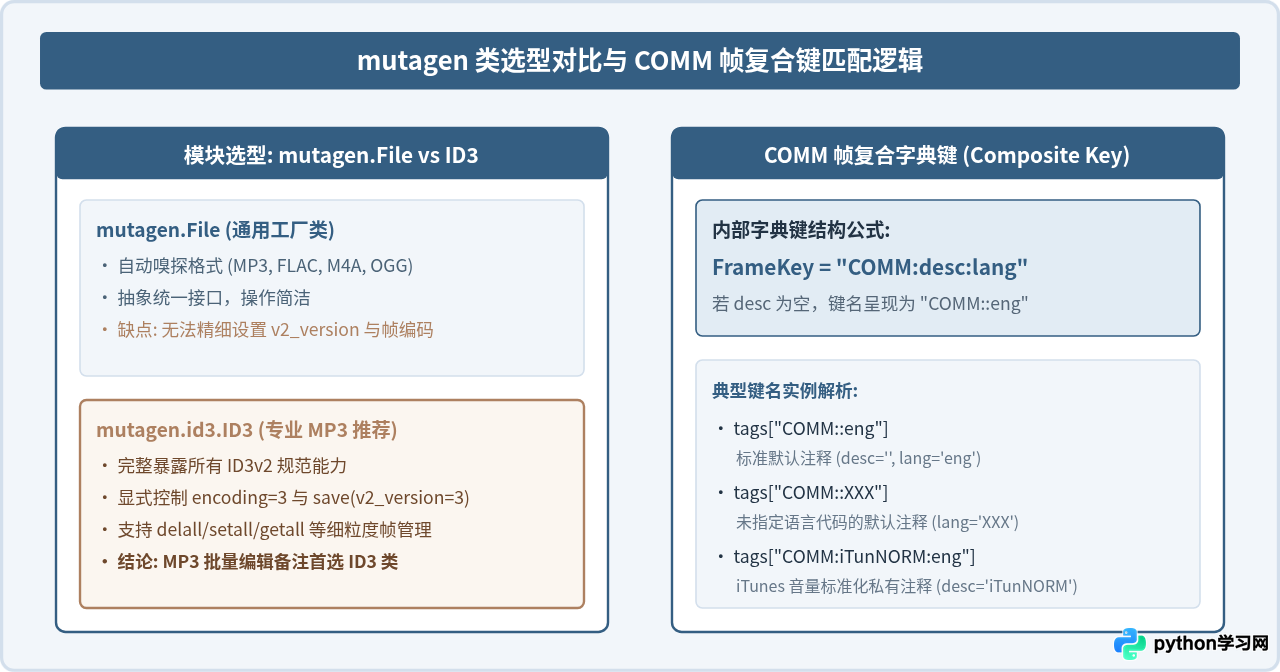
在使用 mutagen 时,初学者经常在 mutagen.File 与 mutagen.id3.ID3 之间产生困惑。理解二者的定位差异,对于编写稳定可靠的代码至关重要。
复合键名称规则与字典式访问
当通过类似字典的方式访问 ID3 对象时,例如 tags["COMM::eng"],其键名规则遵循 COMM:description:language 格式。如果 description 是空字符串,冒号之间就会留空,从而变成 COMM::eng。许多来自网络抓轨的 MP3 还会附带 COMM:iTunes_CDDB_1:eng 等第三方工具添加的私有帧。因此,若要进行完整清洗,必须使用 tags.delall("COMM") 才能将所有衍生帧一网打尽。
六、高频实战场景:动态生成与针对性清洗
场景 1:依据文件名或路径动态写入专属备注
在播客或语音课程批量归档时,往往需要将文件名、父目录名或序号注入到备注中,而不是整批设置成一模一样的固定文本:
def dynamic_comment_by_filename(mp3_path: str):
    """
    提取文件名中的章节号与标题,格式化为标准备注。
    例如文件 "01_第一讲_导论.mp3" -> "归档来源: 2026公开课 | 章节: 第一讲_导论"
    """
    base_name = os.path.splitext(os.path.basename(mp3_path))[0]
    parts = base_name.split("_", 1)
    title_part = parts[1] if len(parts) > 1 else parts[0]

    dynamic_text = f"归档来源: 2026公开课 | 章节: {title_part}"

    tags = ID3(mp3_path)
    tags.delall("COMM")
    tags.add(COMM(encoding=3, lang="eng", desc="", text=[dynamic_text]))
    tags.save(mp3_path, v2_version=3)
场景 2:针对特定商业广告水印的过滤式清洗
有些音频原本已包含有用的个人笔记,但混入了抓轨软件写入的广告网址。此时不宜粗暴清空所有内容,而应遍历现有内容进行过滤再写回:
def filter_ad_comments(mp3_path: str, block_keywords: list):
    """
    过滤掉包含广告关键词的备注,保留用户正常备注。
    """
    tags = ID3(mp3_path)
    cleaned_comments = []

    for comm in tags.getall("COMM"):
        original_text = "".join(comm.text)
        # 如果不包含任何黑名单关键词,则保留
        if not any(keyword in original_text for keyword in block_keywords):
            cleaned_comments.append(comm)

    # 先全部清除
    tags.delall("COMM")
    # 再将保留的合法帧写回
    for comm in cleaned_comments:
        tags.add(comm)

    tags.save(mp3_path, v2_version=3)
七、常见问题排查与避坑指南
在实际批量处理过程中,最常遇到的问题大多并非代码语法错误,而是由 ID3 历史版本碎片化和操作系统兼容性差异导致的:
| 异常现象 | 根本原因 | 排查与解决方案 |
|---|---|---|
| Windows 资源管理器中“备注”列显示为空白 | mutagen 默认可能写为 ID3v2.4,而 Windows 资源管理器原生仅支持 ID3v2.3 规范。 | 在保存时显式指定参数:tags.save(file_path, v2_version=3)。 |
| 中文备注在老旧车载机/MP3 播放器上显示为乱码 | 硬件仅支持 Latin1 或 UTF-16,不支持 UTF-8,或者 encoding 字节被错误设置。 |
将 COMM 帧的 encoding 改为 1(带 BOM 的 UTF-16),这是兼容性最广的多字节方案。 |
| 播放器中看到新旧两条备注并存 | 原文件包含 lang='XXX' 或有 desc 的帧,新写入的是 lang='eng',两者共存。 |
写入前调用 tags.delall("COMM") 强制清空全部历史注释帧。 |
运行时抛出 PermissionError: [Errno 13] |
音频文件为只读属性,或被 Foobar2000、Windows Media Player 独占打开。 | 关闭所有正在播放或扫描该目录的音频软件;检查文件系统权限。 |
v2_version=3 参数。ID3v2.4 规范虽然早在 2000 年就已发布,但大量桌面软件(特别是 Windows 10/11 的文件属性面板)依然仅完全支持 ID3v2.3。省略该参数将直接导致 Windows 属性面板中的备注“隐形”。
八、工程实践核对清单与总结
批量修改音频元数据属于不可逆的直接写盘操作,尤其在面对上千首歌曲的大型音乐库时,规范的工程流程是保障数据安全的底线。在正式执行生产批量脚本前,请对照以下四项原则进行自检:
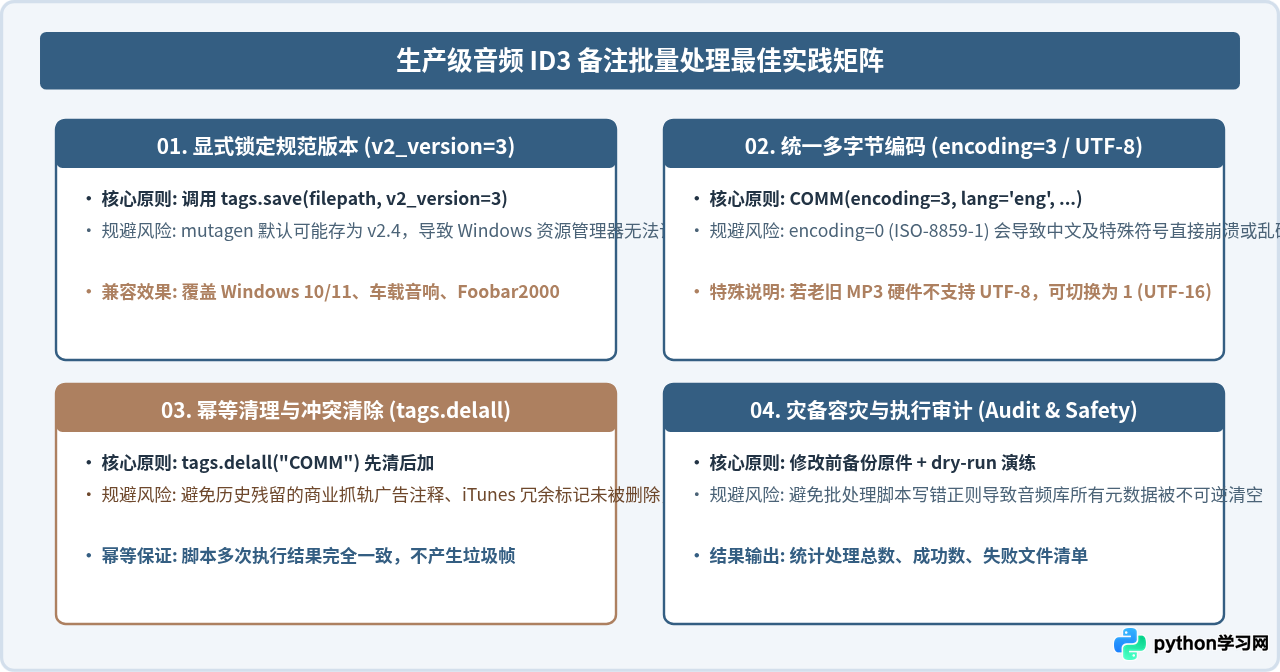
通过合理结合 mutagen.id3.ID3、COMM 帧结构以及 v2_version=3 兼容模式,配合目录递归与异常隔离,即可高效、安全地完成任意规模的音频备注批量编辑与归档整理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









