

Python函数返回值怎么定义:return语句与多值返回技巧
深入讲解Python函数返回值的定义方法、return语句执行流、多值返回的元组打包解包机制、星号解包技巧及NamedTuple等工程化返回方案。
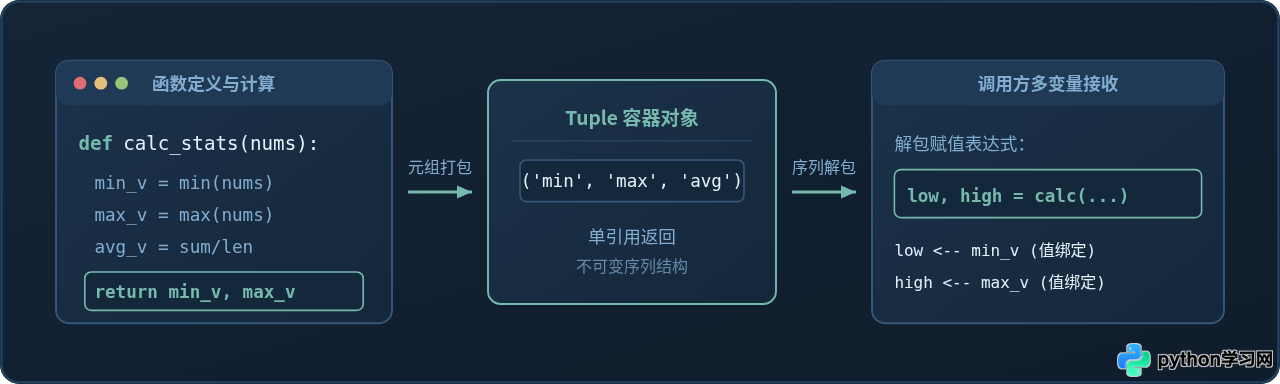
return 语句;而面对多项数据时,只需要用逗号将其隔开,Python 就会在底层自动将其打包为一个只读元组(tuple)并输出,调用端则可以通过序列解包直接分发给多个变量。
一、return 语句的基本定义与控制流机制
在 Python 中,函数通过关键字 return 将执行结果从函数局部作用域传回调用者。返回值可以是 Python 支持的任意对象类型,包括数值、字符串、列表、字典,甚至是另一个函数或类实例。
1. 显式返回与隐式返回 None
当函数执行到 return 语句时,会立即对紧随其后的表达式求值,并将该对象的引用移交给调用处;如果省略了 return 之后的表达式,或者函数体内部没有任何 return 语句一直运行到代码末尾,Python 会自动且隐式地返回 None。
def check_threshold(score, limit=60):
    if score >= limit:
        return "合格"
    # 此处若不显式处理,函数执行完毕后将隐式返回 None

result_pass = check_threshold(75)
result_fail = check_threshold(45)

print("合格测试返回值:", result_pass)
print("未达标返回值:", result_fail)2. 提前返回与卫语句(Guard Clause)
return 不仅负责“交付结果”,更是函数流程控制的强力截断器。一旦 Python 解释器在函数执行过程中遇到 return,就会立刻终结当前函数的执行并弹出对应的调用栈帧,后续位于该函数体内部的所有代码行都将被直接忽略。
利用这个特性,编写函数时应优先使用“卫语句”(Guard Clause):在函数开头先对边界条件、空数据或非法参数做判断并提前 return,从而消除多层深嵌套的 if-else 结构,大幅提升代码的可维护性。
def calculate_discount_price(price, discount_rate):
    # 卫语句:优先拦截非法输入并提前退出
    if price <= 0:
        return 0.0
    if not (0 < discount_rate <= 1.0):
        return float(price)

    # 核心计算逻辑无需包裹在冗长的主分支中
    actual_price = price * discount_rate
    return round(actual_price, 2)

print("正常计算:", calculate_discount_price(299.0, 0.85))
print("非法输入拦截:", calculate_discount_price(-50, 0.85))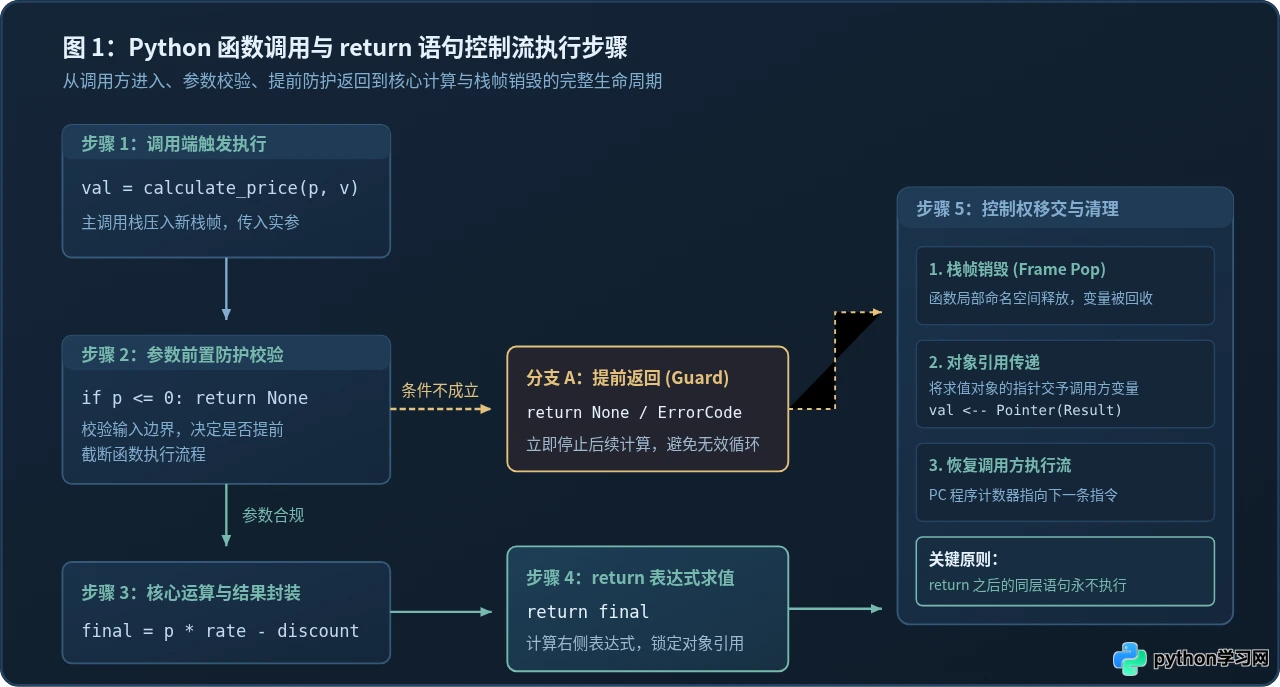
二、Python“多值返回”的底层真相:元组自动打包与解包
很多从 C/C++ 或 Java 转入 Python 的开发者常对一个特性感到惊奇:Python 的函数似乎可以直接返回好几个变量,例如 return min_val, max_val, avg_val。
但从计算机底层的严格意义上讲,Python 函数在任何时候都只返回恰好一个对象。
1. 逗号操作符触发的元组隐式打包
在 Python 语法中,构建元组(tuple)的关键符号从来都不是圆括号 (),而是逗号 ,(空元组除外)。当你在 return 之后书写多个以逗号分隔的值时,Python 解释器在编译期会生成 BUILD_TUPLE 指令,把这几个离散的对象打包封装进一个不可变的元组容器中,并把这个元组的唯一内存引用返回给主调用方。
def get_temperature_bounds():
    # 逗号分隔的多个值,在 Python 看来等价于一个元组
    return 18.5, 26.8

result = get_temperature_bounds()
print("接收到的原始对象:", result)
print("对象数据类型:", type(result))2. 调用端的序列解包机制与数量对应
既然函数返回的是一个元组,调用方就可以利用 Python 的序列解包(Sequence Unpacking)语法,在赋值号左边放置对应数量的变量,将元组中的各项按顺序一次性提取出来。
需要注意,解包时左侧的接收变量数量必须与元组中的元素数量精确一致。数量多了会引发 ValueError: not enough values to unpack,数量少了则会引发 ValueError: too many values to unpack。
def summarize_scores(scores):
    low = min(scores)
    high = max(scores)
    mean = round(sum(scores) / len(scores), 1)
    return low, high, mean

exam_scores = [82, 95, 68, 74, 91]

# 严格按顺序解包到三个局部变量
min_score, max_score, average = summarize_scores(exam_scores)
print(f"最低: {min_score}, 最高: {max_score}, 平均: {average}")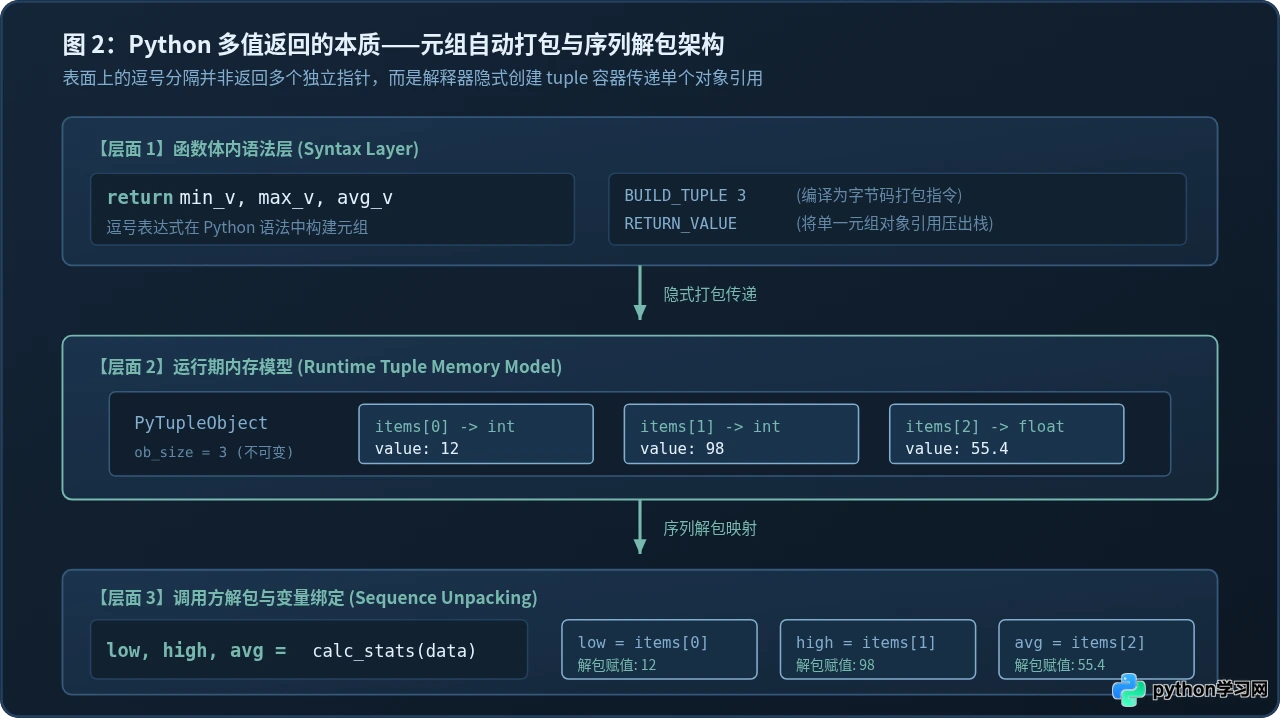
三、多值返回的实用接收与解包进阶技巧
在实际工程开发中,多值返回的使用场景极其多样。除了基础的一对一变量解包外,合理运用星号语法、忽略占位符以及结构化类型,能让代码更健壮也更具表现力。
技巧 1:使用下划线 _ 忽略无用返回值
如果某个函数返回了 3 个值,但在当前的业务场景下你只需要其中的某一个或某两个,请不要为了满足解包数量而随意声明未使用的变量,而应使用 Python 惯例中的下划线 _ 作为丢弃占位符。这不仅能明确告诉阅读代码的人“这些数据我们不需要”,也能通过代码静态扫描工具的未用变量检测。
# 仅需要平均分,忽略最低分与最高分
_, _, avg_only = summarize_scores(exam_scores)
print("提取的目标平均分:", avg_only)技巧 2:星号解包(Extended Iterable Unpacking)处理变长返回
当函数返回的序列长度较长,或者你只需要抓取两端极值、把中间所有元素合并为一个列表时,可以使用星号 * 进行收集解包。被 * 修饰的变量会自动吸收所有剩余的中间元素并构造成一个 list。
def fetch_server_metrics():
    # 模拟返回:状态码、多个周期的延迟数据、健康标记
    return 200, 14.2, 16.5, 15.1, 19.8, True

status, *latencies, is_healthy = fetch_server_metrics()

print("状态码:", status)
print("抓取到的中间延迟列表:", latencies)
print("健康状态:", is_healthy)技巧 3:返回值超过 3 个时的结构化重构方案
虽然逗号返回元组极为便捷,但在大型工程中,如果一个函数返回了 4 个甚至更多值,继续使用元组解包就会变成隐患重重的反模式。原因在于:
- 依赖位置记忆:调用者很容易记错某个变量的排列顺序,把
uid, role, status错解为uid, status, role,且不会触发任何语法报警。 - 重构脆弱性:函数一旦需要在中间插入一个新的返回值,全局所有解包调用的地方都会直接崩溃报错。
面对多字段的复合返回场景,推荐使用标准库中的 typing.NamedTuple 或 dataclasses.dataclass 将返回值封装为具名数据契约。
from typing import NamedTuple

class UserParseResult(NamedTuple):
    user_id: int
    username: str
    email: str
    is_active: bool

def parse_user_raw(raw_text: str) -> UserParseResult:
    # 模拟数据清洗逻辑
    fields = raw_text.strip().split("|")
    return UserParseResult(
        user_id=int(fields[0]),
        username=fields[1].strip(),
        email=fields[2].strip(),
        is_active=fields[3].lower() == "true"
    )

info = parse_user_raw("1042 | alex_dev | alex@corp.internal | true")

# 优势:同时支持属性点号访问(自解释且IDE智能提示)和元组解包
print("通过字段名读取:", info.username, info.email)
print("通过属性判断状态:", "启用" if info.is_active else "禁用")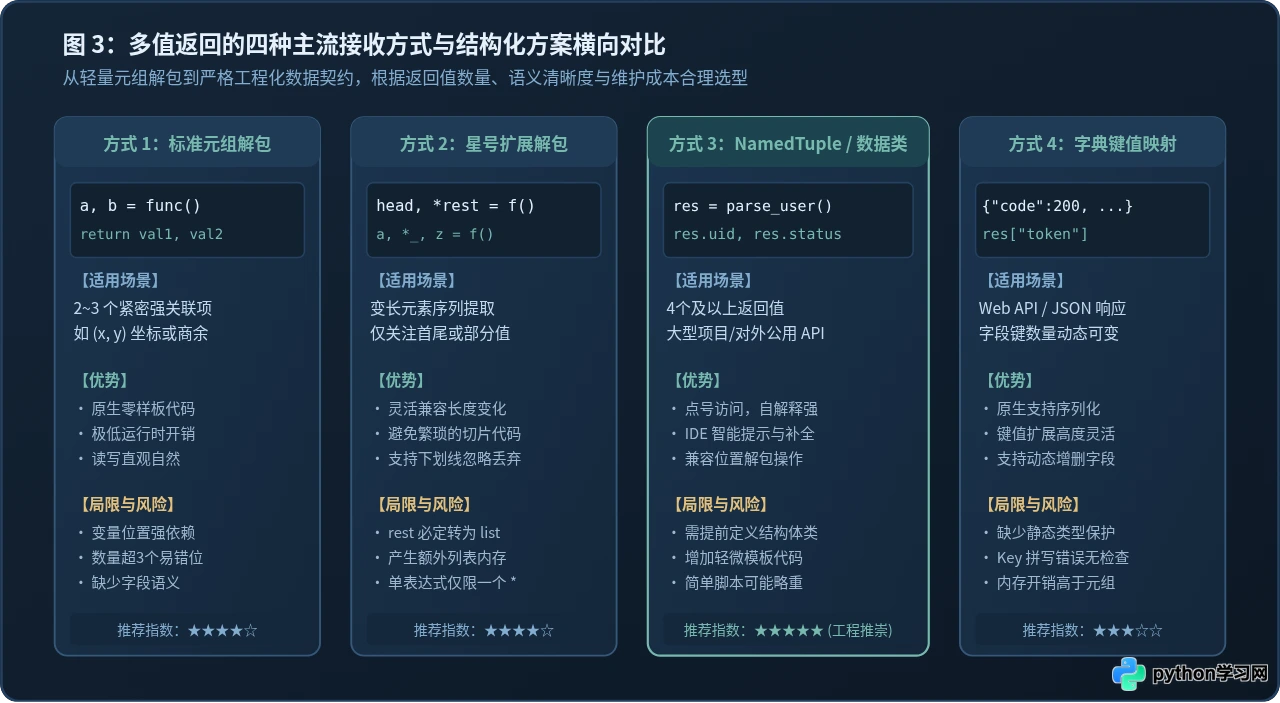
四、返回值类型注解(Type Hints)规范
现代 Python(Python 3.9+)已经完全内置了对泛型类型注解的支持。为函数的返回值添加精确的类型标注,不仅可以极大减少团队协作中的认知摩擦,还能让 PyCharm、VS Code 和 Mypy 等工具在编写代码的瞬间拦截类型不匹配的潜在 Bug。
- 无返回值或纯副作用函数:标注为
-> None。 - 单个常规对象返回:直接标注具体类型,如
-> int、-> list[str]。 - 可能失败或缺失的返回:在 Python 3.10+ 中推荐使用联合类型
-> int | None;在早期版本中可引入Optional[int]。 - 元组多值返回:使用
tuple[...]精确列举每一个位置的类型,例如-> tuple[int, str, bool]。
def find_user_profile(user_id: int) -> tuple[str, int] | None:
    registry = {101: ("Alice", 28), 102: ("Bob", 34)}
    if user_id not in registry:
        return None
    return registry[user_id]

profile = find_user_profile(101)
if profile is not None:
    name, age = profile
    print(f"查询成功: 姓名={name}, 年龄={age}")
else:
print("目标用户不存在")五、函数返回值设计决策与常见误区防范
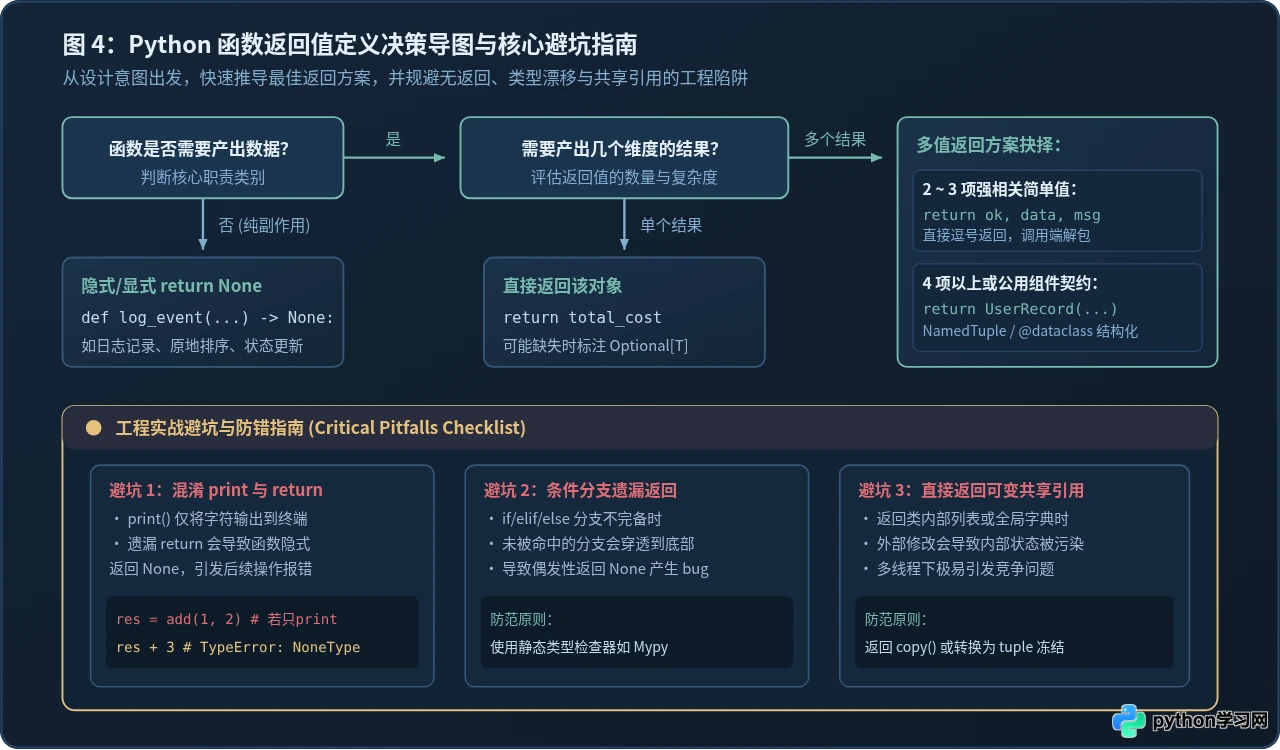
在编写函数返回值时,新手开发者最常踩的几类坑往往不是语法错误,而是逻辑概念上的混淆或对可变对象生命周期的误判。
print() 与 returnprint() 的职责只是把文字呈现在控制台终端上,供人类观察,它不会将任何数据交付给调用者;return 才是真正把数据对象返回给程序后续逻辑的载体。如果在函数中只 print(data) 而没有写 return data,调用处的变量接收到的永远是 None。
如果一个函数包含了多分支逻辑(如
if-elif),且只在部分分支中写了 return,那么当外部输入触发未覆盖的分支时,Python 不会抛出任何警告,而是直接结束函数并返回 None。如果调用端直接用多变量进行元组解包,此时会立刻抛出 TypeError: cannot unpack non-iterable NoneType object。因此,任何包含提前退出的函数,都要确保所有分支都有确切的返回契约或异常抛出。
如果一个函数负责管理一个内部列表或字典,直接将其
return self._cache 返回给外部,调用方对该对象执行的 .append() 或 .clear() 将直接摧毁模块内部的原始状态。需要保护内部数据时,应返回其浅拷贝 return self._cache.copy() 或冻结为只读元组 return tuple(self._cache)。
六、全文核心总结
掌握 Python 函数的返回值定义,核心在于理清以下四层逻辑:
- 控制流层面:
return是函数的出口终点线,不仅传递结果,更具备立即截断执行流程的作用,善用卫语句可以大幅平铺代码结构。 - 语言机制层面:Python 没有真正的“多重独立返回值”,多值返回本质上是逗号表达式对多个对象进行
tuple自动打包,随后在调用端利用序列解包一一对应。 - 工程选型层面:2 到 3 个强关联字段使用逗号元组返回最为简洁;超过 3 个字段或作为公共模块 API 时,果断采用
NamedTuple或dataclass,以显式字段名取代脆弱的位置索引。 - 防御性编码层面:始终使用 Type Hints 明确标注返回契约,警惕分支漏写导致的意外
None穿透,避免对外暴露内部可变对象的直接引用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









