

Python namedtuple怎么用:提升代码可读性的命名元组
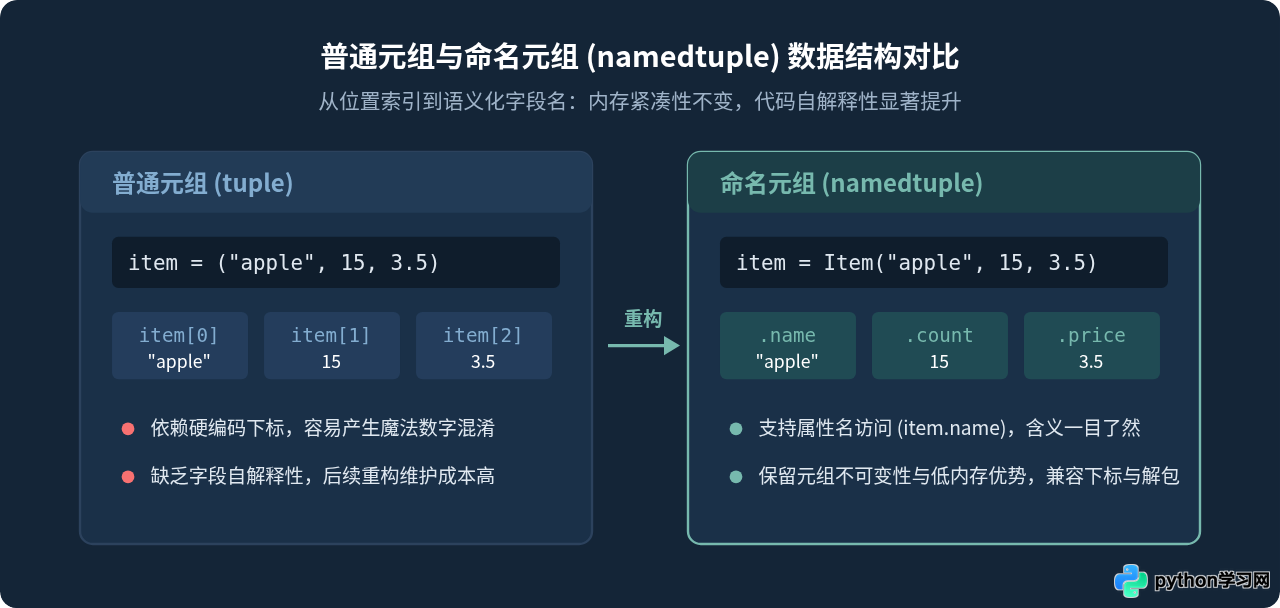
在编写 Python 数据处理或接口对接程序时,很多开发者习惯使用标准元组(tuple)来打包临时数据,例如用 user = ("Alice", 28, "engineer@example.com") 记录一位用户的信息。然而,当后续逻辑中充斥着 user[0]、user[1] 和 user[2] 时,代码的可读性就会迅速下降:读者很难立刻看出 user[1] 究竟代表年龄、工龄还是状态码;一旦未来在元组前部新增字段,所有基于硬编码下标的代码都将面临被改崩的风险。为了解决这一痛点,Python 标准库 collections 模块提供了 namedtuple(命名元组)。本文将系统讲解 namedtuple 的产生背景、核心语法、常用操作方法以及生产实践中的选型权衡。
一、什么是 namedtuple:工作原理与核心优势
简单来说,namedtuple 是一个工厂函数。它位于 Python 标准库的 collections 模块中,用来生成一个继承自内置 tuple 的定制子类。这个子类不仅具有普通元组所拥有的全部特性(如不可变性、序列切片、迭代解包以及紧凑高效的内存分布),还为其每个元素位置绑定了具名属性。
与常见的数据容器相比,namedtuple 具备以下三大核心优势:
- 极佳的代码可读性:可以使用
obj.field_name语义化地访问数据,消除代码中含义模糊的数字下标。 - 与普通元组完全兼容:凡是支持普通元组的地方都可以无缝替换为命名元组,依然支持
x, y = point解包操作以及len()、for遍历。 - 极低的内存与运行开销:普通自定义类因为包含实例字典(
__dict__)会占用较大内存,而namedtuple实例底层直接使用 C 语言层级的元组数组结构,内存开销与原生元组基本持平,远低于常规类与字典。
二、从零开始:namedtuple 的定义与实例化步骤
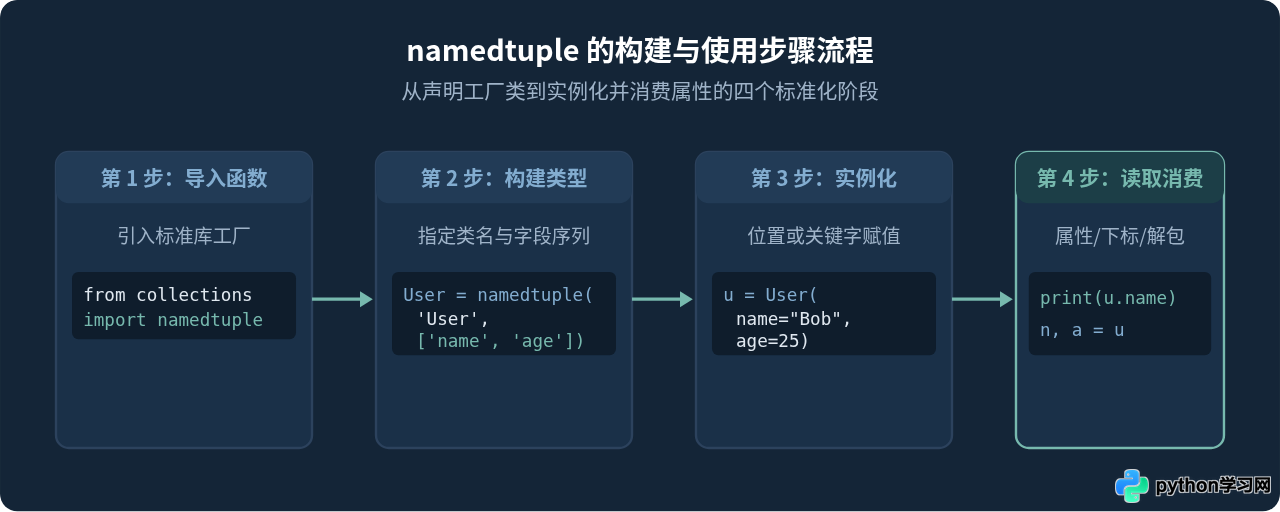
使用 namedtuple 的流程非常清晰,通常分为“导入模块”、“定义子类”、“创建实例”和“消费数据”四个步骤。
1. 声明字段的三种等效方式
工厂函数 namedtuple(typename, field_names) 接收两个主要参数:第一个是生成的类名(字符串),第二个是字段名序列。字段名可以通过以下三种方式指定:
from collections import namedtuple

# 方式一:字符串列表(推荐,最直观)
Point = namedtuple('Point', ['x', 'y'])

# 方式二:以空格隔开的单一字符串(最简洁)
Point = namedtuple('Point', 'x y')

# 方式三:以逗号隔开的单一字符串
Point = namedtuple('Point', 'x, y')
2. 创建对象与访问数据
生成类型后,其实例化体验与普通类完全一致:
# 通过位置参数创建
p1 = Point(10, 20)

# 通过关键字参数创建
p2 = Point(x=30, y=40)

# 1. 属性名访问(核心优势)
print(p1.x, p1.y)  # 输出示例:10 20

# 2. 依然支持索引下标访问
print(p1[0], p1[1])  # 输出示例:10 20

# 3. 完美支持序列解包
x_val, y_val = p2
print(f"x={x_val}, y={y_val}")  # 输出示例:x=30, y=40

# 4. 自带友好的 __repr__ 字符串表示
print(p1)  # 输出示例:Point(x=10, y=20)
三、核心内置属性与特色方法详解
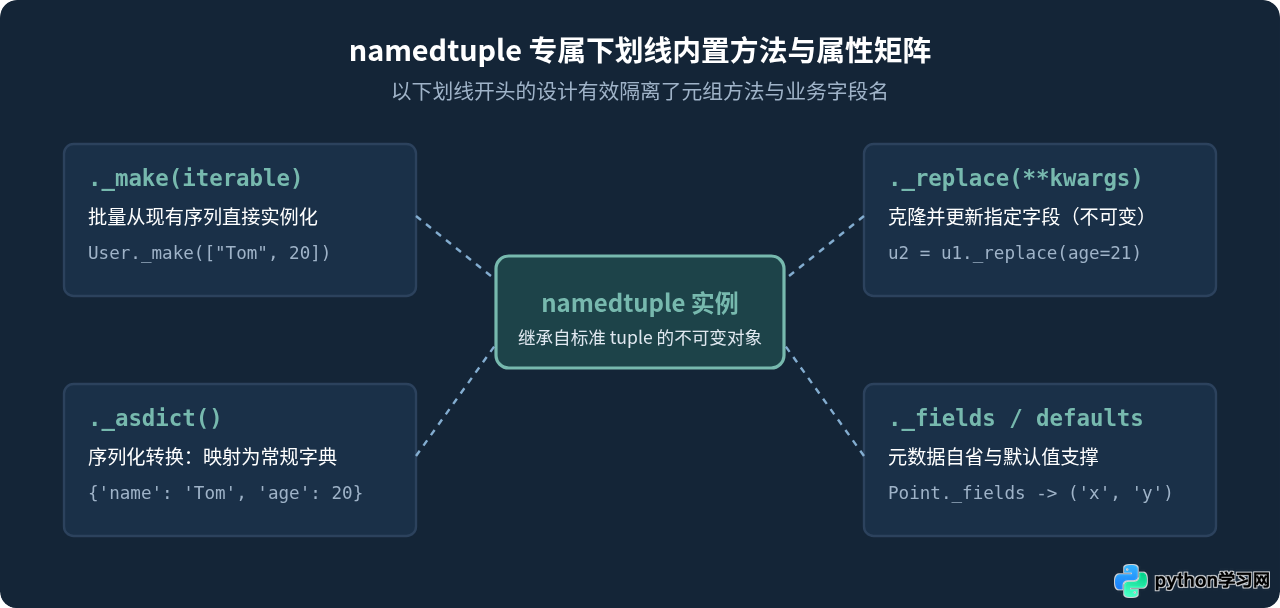
为了防止方法名与用户自定义的属性字段发生冲突,namedtuple 提供的内置专属方法和属性均以单下划线(_)开头。这些方法在日常工程实践中极为实用。
1. `_make(iterable)`:批量快速构建
当手头已有列表或元组数据(例如数据库查询结果 cursor.fetchall() 返回的单行列表)时,无需手动展开参数,使用类方法 _make 即可直接构建实例:
row_data = ["Alice", 28, "Engineer"]
Person = namedtuple('Person', ['name', 'age', 'job'])

# 传统解包传参
p1 = Person(*row_data)

# 使用 _make 传参(更简洁明确)
p2 = Person._make(row_data)
print(p2)  # 输出示例:Person(name='Alice', age=28, job='Engineer')
2. `_asdict()`:快速导出为字典
在需要将数据通过 JSON 输出或存入 Redis 时,调用 _asdict() 能直接将命名元组转换为普通的 Python dict:
import json

user = Person("Bob", 30, "Designer")
user_dict = user._asdict()

print(user_dict)
# 输出示例:{'name': 'Bob', 'age': 30, 'job': 'Designer'}

json_str = json.dumps(user_dict)
print(json_str)
# 输出示例:{"name": "Bob", "age": 30, "job": "Designer"}
3. `_replace(**kwargs)`:不可变条件下的局部更新
因为元组是不可变类型,直接给实例属性赋值会触发 AttributeError。如果需要修改某几个字段的值,应该使用 _replace() 方法,它会生成并返回一个拥有新属性值的全新实例:
p_old = Person("Charlie", 22, "Intern")

# 直接修改会报错:AttributeError: can't set attribute
# p_old.age = 23

# 正确做法:使用 _replace 生成新实例
p_new = p_old._replace(age=23, job="Developer")
print(p_old)  # 输出示例:Person(name='Charlie', age=22, job='Intern')
print(p_new)  # 输出示例:Person(name='Charlie', age=23, job='Developer')
4. `_fields` 与 `defaults` 参数
_fields 属性以元组形式保存了该命名元组声明的所有字段名,非常适合用于动态反省、日志打印或表头匹配:
print(Person._fields)
# 输出示例:('name', 'age', 'job')
从 Python 3.7 开始,namedtuple 支持传入 defaults 参数设置默认值。默认值将自右向左匹配各个字段:
# 为后两个字段设置默认值
Account = namedtuple('Account', ['username', 'role', 'active'], defaults=['guest', True])

acc1 = Account('visitor1')
print(acc1)  # 输出示例:Account(username='visitor1', role='guest', active=True)
四、避坑指南:必须掌握的细节与限制
namedtuple 非常轻巧好用,但它本质上仍然是不可变序列,且字段名需遵循 Python 标识符命名规范。
- 字段命名规则:字段名不能是 Python 关键字(如
class、def、return),也不能以数字开头或包含破折号等非法字符。若从外部动态数据(如 CSV 第一行)读取字段名,可开启rename=True:# 自动将非法字段名重命名为带下划线和序号的形式(如 _0, _2) SafeTuple = namedtuple('SafeTuple', ['name', 'class', '2024_rev'], rename=True) print(SafeTuple._fields) # 输出示例:('name', '_1', '_2') - 浅层不可变性:如果
namedtuple中存储的某个字段本身是可变对象(例如普通列表list),则该列表内部的数据依然可以被修改。Team = namedtuple('Team', ['team_name', 'members']) t = Team("Alpha", ["Alice", "Bob"]) t.members.append("Charlie") # 列表内容可变,但不可替换 t.members 的引用本身 - hash 与字典键:只要
namedtuple包含的所有字段都是可哈希的(如数字、字符串、普通元组),整个namedtuple实例就是可哈希的,可以安全地作为dict的键或存入set集合中进行去重。
五、选型对比:何时使用 namedtuple?
在 Python 生态中,用于表达结构化数据的常见方案包括:原生 tuple、namedtuple、普通字典 dict 以及 Python 3.7 引入的 dataclass。在实际业务中如何选择,可以参考下方的全景对比图:
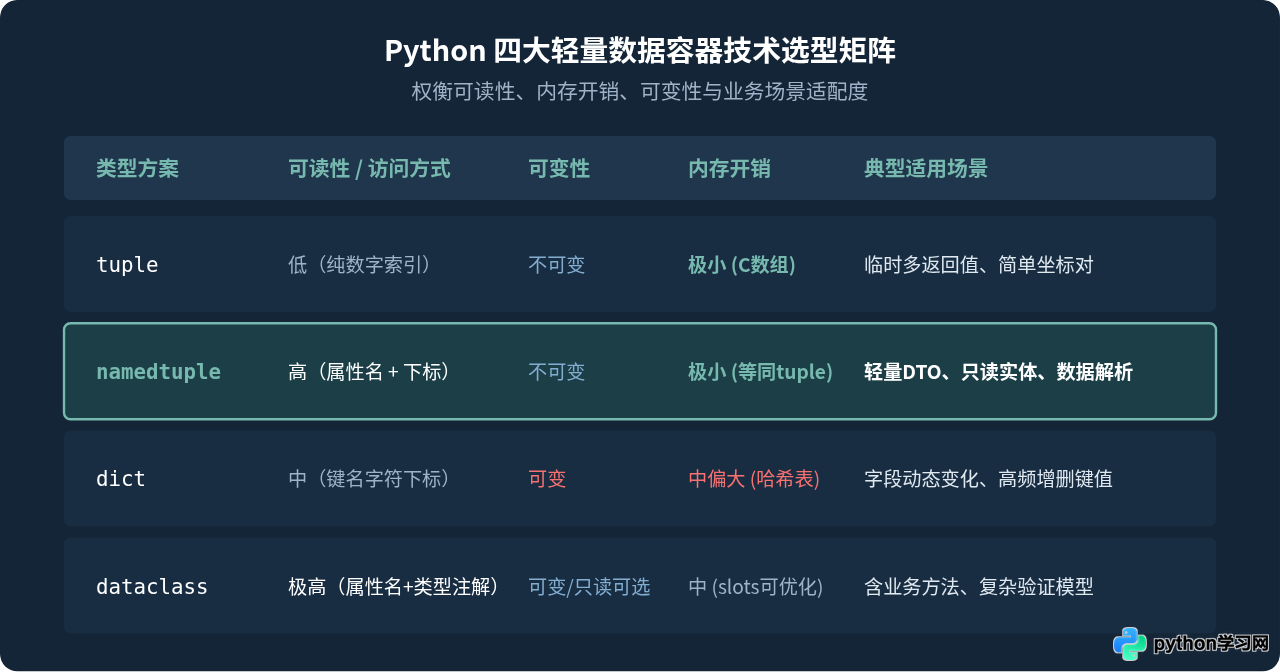
选型建议总结:
- 优先选用
namedtuple的场景:数据结构固定、只读防篡改,需要承载数十万条轻量记录(如解析 CSV、批量加载日志条目、数据库 ORM 查询映射),且希望提供类似对象属性的自然访问体验。 - 选用
dict的场景:键名经常动态变化、需要就地修改属性,或者与前端通过灵活的 JSON 格式交互。 - 选用
dataclass的场景:需要为数据类编写复杂的业务方法、需要静态类型类型检查支持,或者字段属性具有严格的继承与生命周期钩子(__post_init__)。
六、全文总结
namedtuple 是 Python 标准库中兼具“优雅”与“性能”的工具典范。它以极其低廉的学习成本,解决了传统元组在长链路传递中“魔法索引导致可读性崩塌”的核心痛点,同时又保留了原生元组内存紧凑、执行迅速和不可变的安全特性。在日常编码中,只要遇到包含多个固定属性但无需复杂业务逻辑的数据包,就可以主动引入 namedtuple,让代码更清晰、更易读、更健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









