

Python爬虫常用库介绍:Requests、BeautifulSoup与Scrapy的区别
详细解析Python网络爬虫三大常用库Requests、BeautifulSoup与Scrapy的核心定位、协同模式、架构差异与选型依据,助你理清爬虫技术栈分工并准确落地数据采集项目。
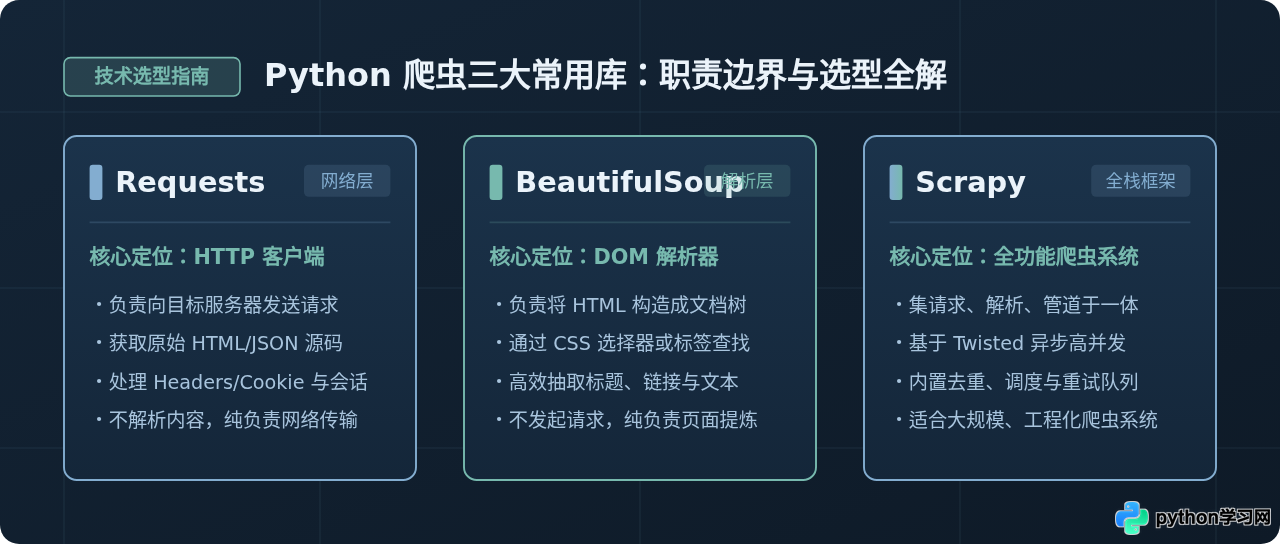
如果你准备写一段代码,抓取某个技术博客的新文章列表或特定电商页面的图书价格,查阅教程时往往会看到三种被频繁提及的工具:Requests、BeautifulSoup 和 Scrapy。许多刚接触爬虫的开发者容易把它们当成同类产品直接横向比较,困惑于“究竟该学哪一个”。实际上,它们并不是平行的替代品,而是处于网络爬虫开发链条的不同层级:Requests 是负责网络通信的 HTTP 客户端,BeautifulSoup 是解析 HTML 源码的文档分析库,而 Scrapy 则是一个包含了下载、调度、解析和入库全流程的工业级异步爬虫框架。
一、核心定位差异:它们根本不是同一种工具
要彻底理清它们之间的区别,最有效的方式是看它们在一次完整的“网页数据提取任务”中到底负责哪一段工作。一次标准的数据爬取过程主要包含两步:第一步是通过网络向目标服务器发起请求并把网页源代码下载下来;第二步是在这堆由 HTML 标签组成的混乱文本中,精准提取出标题、时间、作者和正文。这两步所需要的核心能力完全不同。
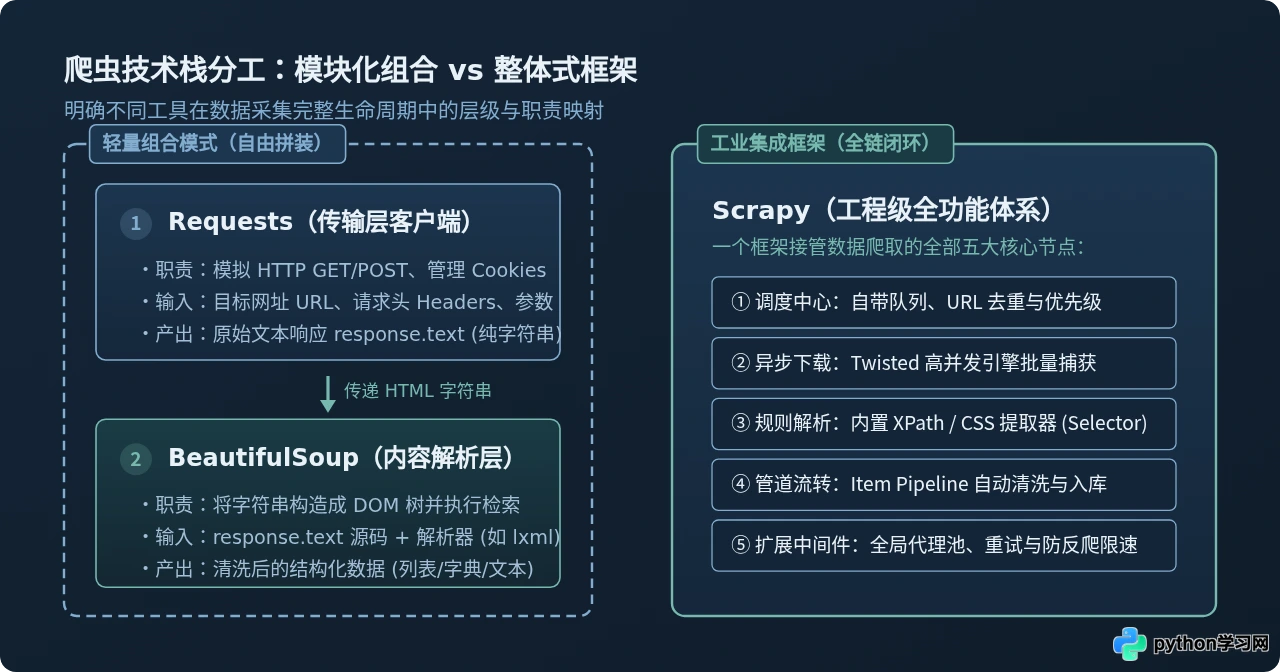
Requests 专攻“网络搬运”。它的唯一目标是让网络通信变得极度简洁直观。你给它一个网址 URL,它帮你处理底层 TCP 握手、HTTP/HTTPS 请求头构造、Cookie 维持、POST 参数序列化以及状态码校验,并把服务器响应的原始字符串(HTML/JSON/二进制)带回你的 Python 程序中。但 Requests 对网页的内容结构一无所知,它不能也不负责解析页面标签。
BeautifulSoup 专攻“内容提炼”。它是一个纯粹的文档解析库,本身没有任何联网请求能力。你必须把已经下载好的 HTML 字符串喂给它,它会在内存中把这些标签解析成一棵树状结构的 DOM 节点树。随后,你可以使用它提供的 find_all()、find() 或标准 CSS 选择器(select()),轻松在成千上万行 HTML 中把特定的标签及其属性抽离出来。
Scrapy 则是“一体化工业流水线”。它不是一个单独的库,而是一套完整的工程框架。它基于 Twisted 异步事件驱动架构,不仅内置了高并发的请求下载器和基于 XPath/CSS 的解析提取器,还自带请求排队去重(Scheduler)、数据清洗持久化管道(Item Pipeline)以及针对防反爬的中间件扩展(Middlewares)。如果把 Requests 和 BeautifulSoup 比作可以自由组装的螺丝刀和扳手,那么 Scrapy 就是一条自动化组装流水线。
二、Requests 与 BeautifulSoup 的“轻骑兵”协作模式
在日常开发中,Requests 和 BeautifulSoup 通常作为黄金搭档成对出现。对于单页测试、小规模抓取或一次性数据分析任务,这个组合具有启动快、无项目结构包袱、即写即跑的独特优势。
完整协作代码示例
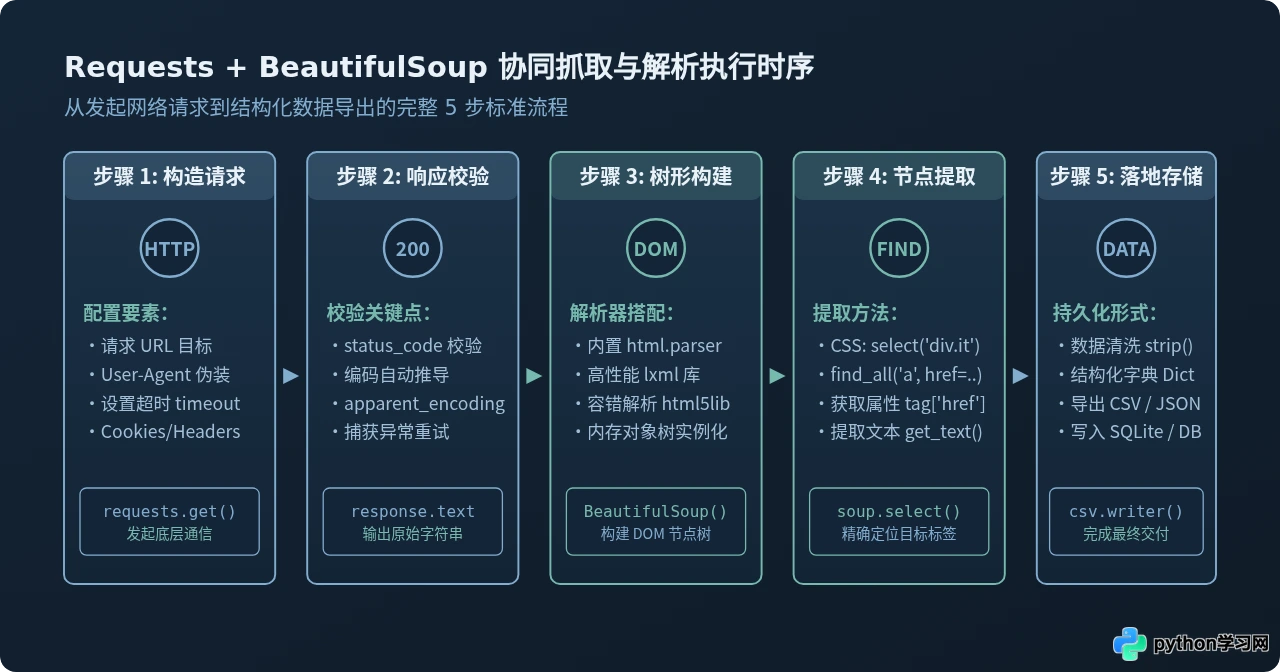
下面的代码演示了如何使用 Requests 获取网页源码,并通过 BeautifulSoup 提取文章列表中的标题与链接:
import requests
from bs4 import BeautifulSoup

def fetch_articles():
    # 目标页面与请求头伪装
    url = "https://example.com/blog/articles"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        # 1. 使用 Requests 发起 HTTP GET 请求
        response = requests.get(url, headers=headers, timeout=10)

        # 校验 HTTP 状态码
        if response.status_code != 200:
            print(f"请求失败,状态码: {response.status_code}")
            return []

        # 自动纠正编码,避免中文乱码
        response.encoding = response.apparent_encoding
        html_content = response.text

        # 2. 使用 BeautifulSoup 构建文档解析树
        soup = BeautifulSoup(html_content, "html.parser")

        results = []
        # 3. 使用 CSS 选择器定位目标节点
        article_items = soup.select("article.post-item")

        for item in article_items:
            title_node = item.select_one("h2.title a")
            date_node = item.select_one("time.pub-date")

            if title_node:
                title = title_node.get_text(strip=True)
                link = title_node.get("href", "")
                pub_date = date_node.get_text(strip=True) if date_node else "未知日期"

                results.append({
                    "title": title,
                    "link": link,
                    "date": pub_date
                })

        return results

    except requests.exceptions.Timeout:
        print("网络请求超时,请检查网络或目标网站连通性")
    except requests.exceptions.RequestException as e:
        print(f"发生网络异常: {e}")
    return []

if __name__ == "__main__":
    articles = fetch_articles()
    print(f"成功提取 {len(articles)} 篇有效文章:")
    for art in articles[:3]:
        print(f"- [{art['date']}] {art['title']} -> {art['link']}")
- 必须配置 User-Agent:Requests 发出请求时的默认请求头包含
python-requests/x.x.x,绝大多数带有初级防爬机制的网站都会直接拒绝这类请求并返回 403 Forbidden。 - 务必设置 timeout 超时参数:如果不设置
timeout,当目标站点响应挂起时,程序会陷入无限期阻塞等待。 - 解析器选择差异:
html.parser是 Python 自带的内置解析器,无需额外依赖;如果对解析速度有更高要求,或者面对非常混乱的非标准 HTML,建议安装lxml库并在实例化时指定BeautifulSoup(html, "lxml")。
三、Scrapy 的“工业级航母”特性与架构解析
当抓取需求从“抓几十个页面”升级到“持续抓取数十万到数百万级页面”时,Requests + BeautifulSoup 的简易脚本就会显露瓶颈。例如:单线程按顺序下载耗时极长;若手动写 threading 或 multiprocessing 线程池,又需要自行处理繁琐的锁机制、线程安全队列和资源竞争;此外,遇到网络波动时的自动重试机制、已抓取链接的高效去重,以及数据自动存储到数据库的管道逻辑,都需要写大量样板代码。Scrapy 正是为解决这些工程化痛点而生的。
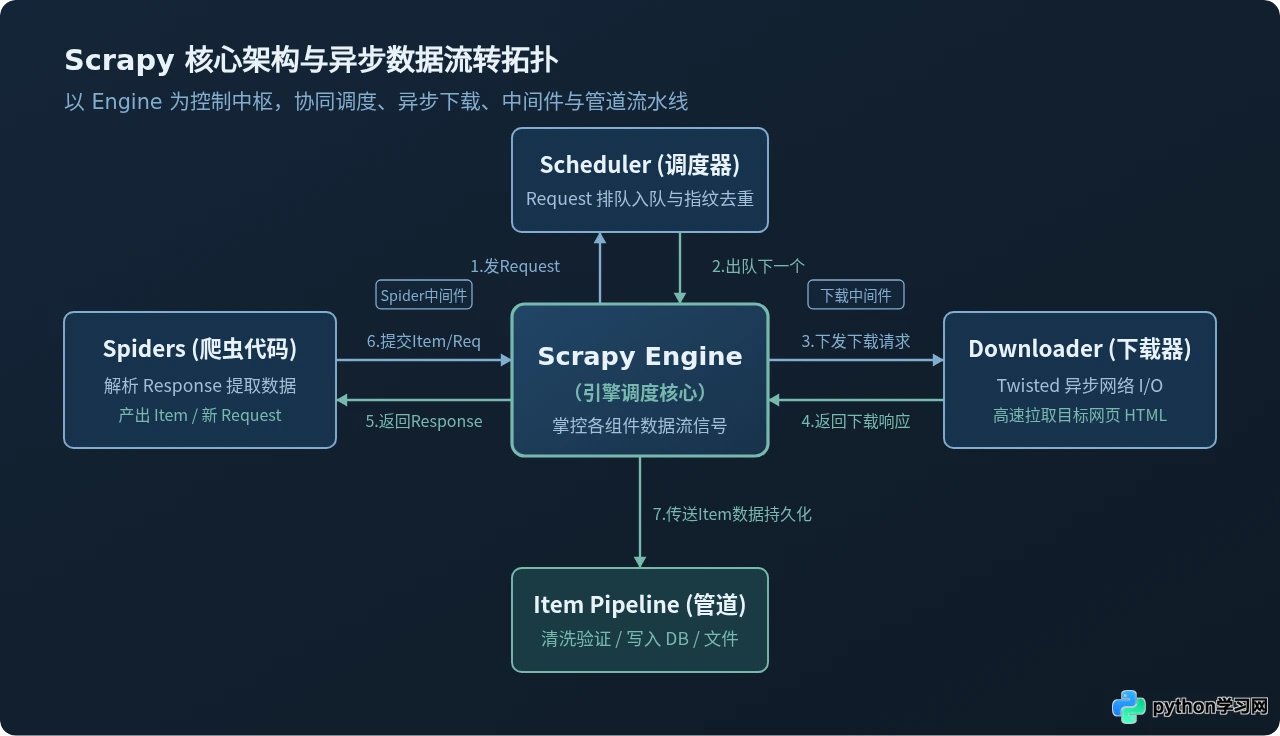
Scrapy 的六大核心组件与数据流转
- Scrapy Engine(引擎):框架的大脑,负责统一协调并驱动所有组件之间的数据流动。
- Scheduler(调度器):负责接收引擎发来的所有网络请求,并将其存入待抓取队列。它内置了基于指纹哈希(Fingerprint)的高效去重机制,防止同一个 URL 被重复下载。
- Downloader(下载器):基于 Twisted 异步事件网络引擎。它可以以极高的并发度同时处理成百上千个网络请求,而不需要为每个请求分配一个系统级线程,整体吞吐效率极高。
- Spiders(爬虫逻辑类):开发者编写核心采集规则的地方。在这里定义初始抓取链接(
start_urls),并实现parse()回调函数,解析下载器送达的 Response。你可以直接产出结构化字段(Item),或者提取下一页的 URL 继续派生新的Request。 - Item Pipeline(数据处理管道):当 Spider 解析出数据(Item)后,数据会被自动投递到 Pipeline 中。在这里可以集中编写数据清洗、去重验证以及写入 MongoDB、MySQL 或本地 CSV 的业务逻辑,与爬取逻辑完全解耦。
- Middlewares(中间件机制):分为下载中间件(Downloader Middlewares)和爬虫中间件(Spider Middlewares)。开发者可以在中间件中透明地注入代理 IP 轮换、随机 User-Agent、Cookie 池维护以及自动重试等反爬防御逻辑。
四、核心维度全面对比
为了让不同场景下的工具差异更加直观,下表将 Requests、BeautifulSoup 与 Scrapy 从八个核心工程维度进行了横向对照:
| 对比维度 | Requests | BeautifulSoup | Scrapy 框架 |
|---|---|---|---|
| 工具定位 | HTTP 通信客户端 | HTML / XML 文档解析器 | 全流程异步网络爬虫框架 |
| 网络请求能力 | 原生强项(同步阻塞) | 无(必须依赖外部输入) | 原生强项(基于 Twisted 异步高并发) |
| 数据提取能力 | 无(仅返回字符串文本) | 原生强项(支持 CSS/DOM 查找) | 原生强项(内置 Parsel,支持 XPath/CSS) |
| 并发处理 | 需外接多线程或 aiohttp | 不涉及网络并发 | 内置事件循环,开箱即用高并发 |
| URL 队列与去重 | 需手动使用 Set / Redis 维护 | 不涉及 | 内置内存/磁盘调度器与指纹去重 |
| 管道与持久化 | 需手动编写文件读写函数 | 不涉及 | 内置标准化 Item Pipeline 流水线 |
| 学习与使用门槛 | 极低,5 分钟即可写出请求 | 极低,掌握选择器即可上手 | 中等,需熟悉目录规范与异步事件机制 |
| 典型适用规模 | 万页以下轻量脚本、单次分析 | 配合 Requests 提取任意文档 | 大型分布式爬虫、多站点深度抓取 |
五、爬虫技术选型决策:什么时候用组合,什么时候上框架?
在了解了三者的本质差异后,在实际项目中该如何选择?你可以根据任务的规模、结构与时间预算,参考以下明确的判定路径:
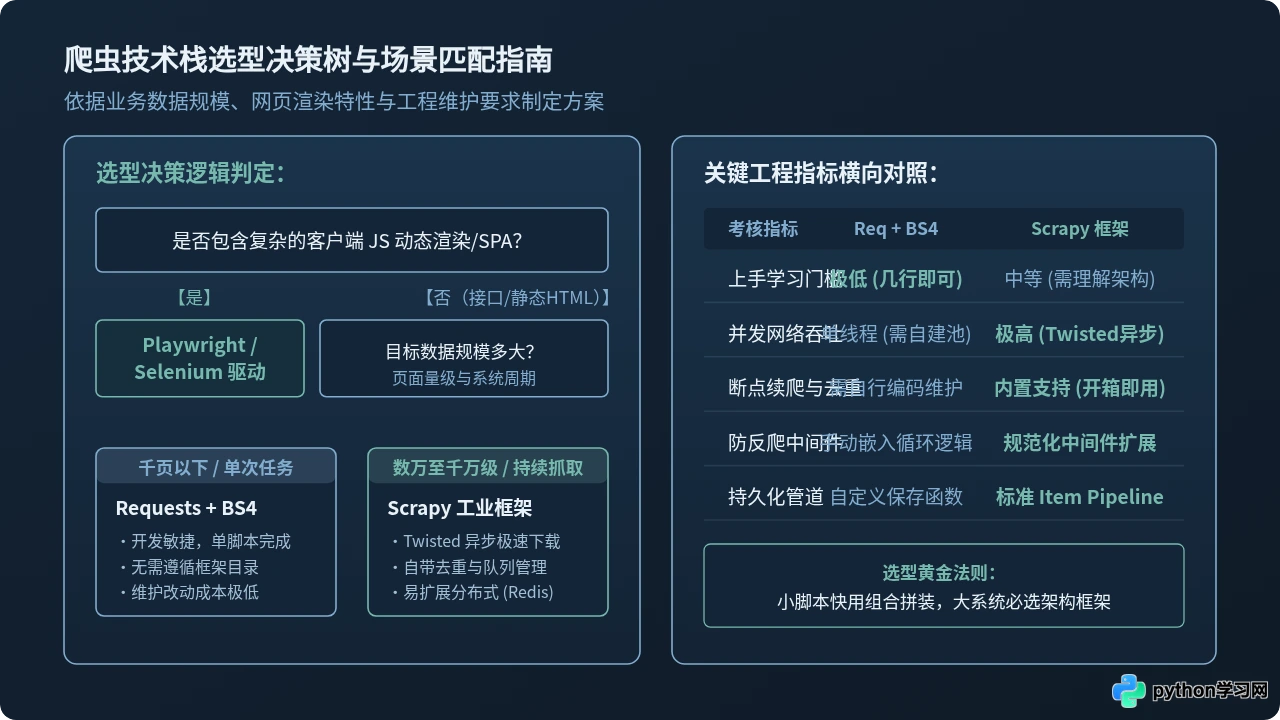
场景一:优先选用 Requests + BeautifulSoup 组合
- 单次分析与原型验证:例如临时抓取某个榜单写一份行业分析报告、验证某个接口是否返回所需字段。
- 数据量级较小:抓取总页面在数百到数千页以内,即使按顺序抓取也能在数分钟内跑完。
- 不希望引入复杂的项目脚手架:单个
.py脚本就能包含全部逻辑,代码修改所见即所得,部署与执行没有任何额外环境负担。
场景二:果断选用 Scrapy 框架
- 中大型与持续化采集任务:目标站点包含几十万到数千万级 URL,需要多进程或配合 Redis 构建分布式爬虫集群(如 Scrapy-Redis)。
- 多站点长期维护:团队需要统一的代码结构、标准的日志记录、规范的配置项以及通用的数据入库管道。
- 深度联动防反爬机制:需要集中接入商业代理 IP 隧道、自动限速(AutoThrottle)、Cookie 会话维护与自动失败重试。
无论 Requests 还是 Scrapy 的原生下载器,都只抓取服务器直接返回的初始 HTTP 响应。如果目标网站是高度依赖前端渲染的单页应用(SPA,如使用 React、Vue 动态加载数据),仅靠上述工具可能只能拿到一个包含
<div id="root"></div> 的空壳页面。此时应当优先通过浏览器开发者工具网络面板(F12 Network)寻找其后端的真实 JSON API 接口;如果接口存在高难度加密签名,再考虑引入 Playwright 或 Selenium 驱动真实无头浏览器渲染,或者使用 scrapy-playwright 中间件进行无缝集成。
六、总结
简而言之:Requests 负责把网页“拉过来”,BeautifulSoup 负责在网页里“找出来”,而 Scrapy 则是把拉取、查找、排队与存储全部打包好的“自动化工厂”。刚入门爬虫时,通过 Requests + BeautifulSoup 配合编写单个脚本,能够最快理解 HTTP 请求细节与 HTML 树形结构;而在进入生产级数据抓取、面对海量数据和复杂调度时,迁移到 Scrapy 框架则是保障吞吐率与工程可维护性的标准路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









