

Python机器学习模型入门:用Scikit-learn构建第一个预测模型
面向Python初学者的Scikit-learn机器学习入门实战教程。以端到端连续数值预测为场景,详细讲解特征矩阵定义、训练集与测试集划分、模型拟合训练、性能指标评估与新样本推断的全流程。
构建机器学习模型的核心逻辑,不是从零编写复杂的优化算法,而是理解“特征数据输入、模型参数拟合、未知样本推断、性能指标评估”这一工程闭环。在 Python 机器学习生态中,Scikit-learn(简称 sklearn)凭借其一致且优雅的面向对象接口,成为了业界最广泛使用的基准库。本文以真实的连续数值预测(房屋销售价格预测)为任务场景,完整演示从环境准备、数据清洗、数据集拆分,到模型训练、指标度量以及新样本推断的全流程。
1. 准备工作:环境与依赖包配置
在开始编写代码前,确保本地已安装 Python 基础运行环境以及三个核心科学计算库:numpy(高效多维数组运算)、pandas(表格数据结构处理)与 scikit-learn(机器学习算法与评估套件)。推荐在独立的虚拟环境中执行如下安装命令:
pip install numpy pandas scikit-learn在 Python 脚本或交互式环境中导入相关模块,并输出当前库版本号以验证安装状态:
import sklearn
import pandas as pd
import numpy as np

print(f"Scikit-learn 版本: {sklearn.__version__}")
print(f"Pandas 版本: {pd.__version__}")2. 核心工作流:五步标准化预测流水线
无论后续接触何种复杂的算法(如支持向量机、决策树随机森林或梯度提升树),Scikit-learn 中所有监督学习模型的构建都严格遵循相同的五步工程模式。将这套流水线固化在大脑中,是解决实际业务预测问题的第一步。
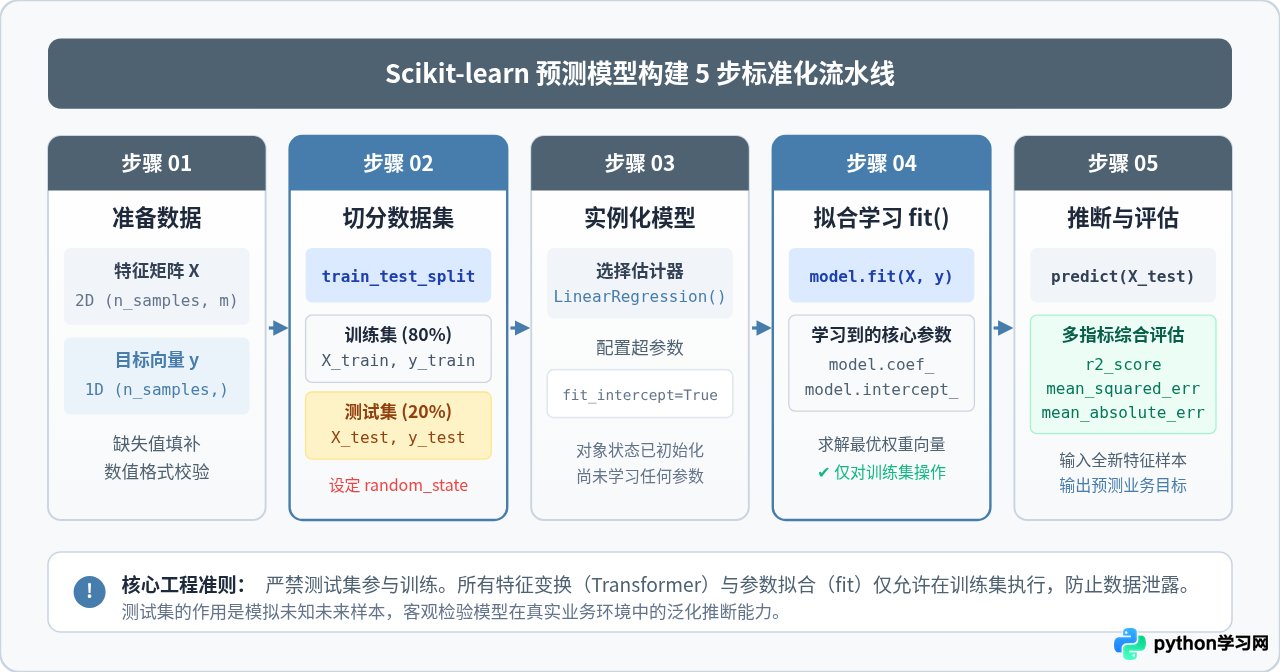
如图 1 所示,整套流程包含明确的阶段边界:
- 准备数据:明确自变量特征矩阵
X与因变量目标标签y。 - 切分数据集:使用
train_test_split将数据划分为互相独立的训练集与测试集,严防信息穿越。 - 实例化估计器:选择算法类并初始化配置超参数。
- 模型拟合训练:在训练集上调用
model.fit(),驱动算法求解最优参数。 - 推断与评估:在保留的测试集上调用
model.predict(),通过量化指标验证泛化推断能力。
3. 步骤一:理解与构建特征矩阵 X 与目标向量 y
在监督学习中,数据集必须结构化地拆分为两组核心对象:
- 特征矩阵 X(Feature Matrix):必须是二维数据结构(形状为
(n_samples, n_features)),行表示独立样本观测值,列表示各个可量化的特征维度(如建筑面积、居室数、房龄、离商圈距离等)。 - 目标向量 y(Target Vector):必须是一维数据结构(形状为
(n_samples,)),代表当前样本对应需要预测的真实值(如房屋成交总价,单位万元)。
为了保证教程完全可独立复现且无需依赖外部网络下载,我们使用 Pandas 构建一个具有真实物理意义的房屋数据集:
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split

# 设置随机数种子保证每次运行结果一致
np.random.seed(42)
n_samples = 200

# 模拟构建 4 个维度的特征数据
area = np.random.uniform(50, 180, n_samples)          # 建筑面积 (50 ~ 180 平方米)
rooms = np.random.randint(1, 5, n_samples)             # 卧室数量 (1 ~ 4 间)
age = np.random.uniform(1, 25, n_samples)              # 房龄 (1 ~ 25 年)
dist = np.random.uniform(0.5, 15, n_samples)           # 距离市中心距离 (0.5 ~ 15 公里)

# 依据真实业务规律构建目标价格(附带随机噪声模拟测量误差)
price = (
    area * 3.2 +        # 面积每平米增加 3.2 万元
    rooms * 8.0 -       # 居室加成
    age * 2.5 -         # 房龄折旧
    dist * 4.0 +        # 距离市中心越远价格越低
    50.0 +              # 基础价格常数
    np.random.normal(0, 15, n_samples) # 实际市场波动噪声
)

# 整合为规范的特征 DataFrame 与目标 Series
X = pd.DataFrame({
    'Area_sqm': area,
    'Bedrooms': rooms,
    'Age_years': age,
    'Dist_km': dist
})
y = pd.Series(price, name='Price_w')

print("特征矩阵 X 前 3 行样本:")
print(X.head(3))
print("
目标向量 y 前 3 个数值:")
print(y.head(3))4. 步骤二:严密拆分训练集与测试集
初学者最常犯的错误之一是使用全部数据训练模型,再拿这批数据来测试模型。这会导致模型即使仅仅“死记硬背”住样本,也能展现虚假的极佳效果,但在面对真实业务新样本时彻底失效。这一现象在机器学习中称为过拟合(Overfitting)。
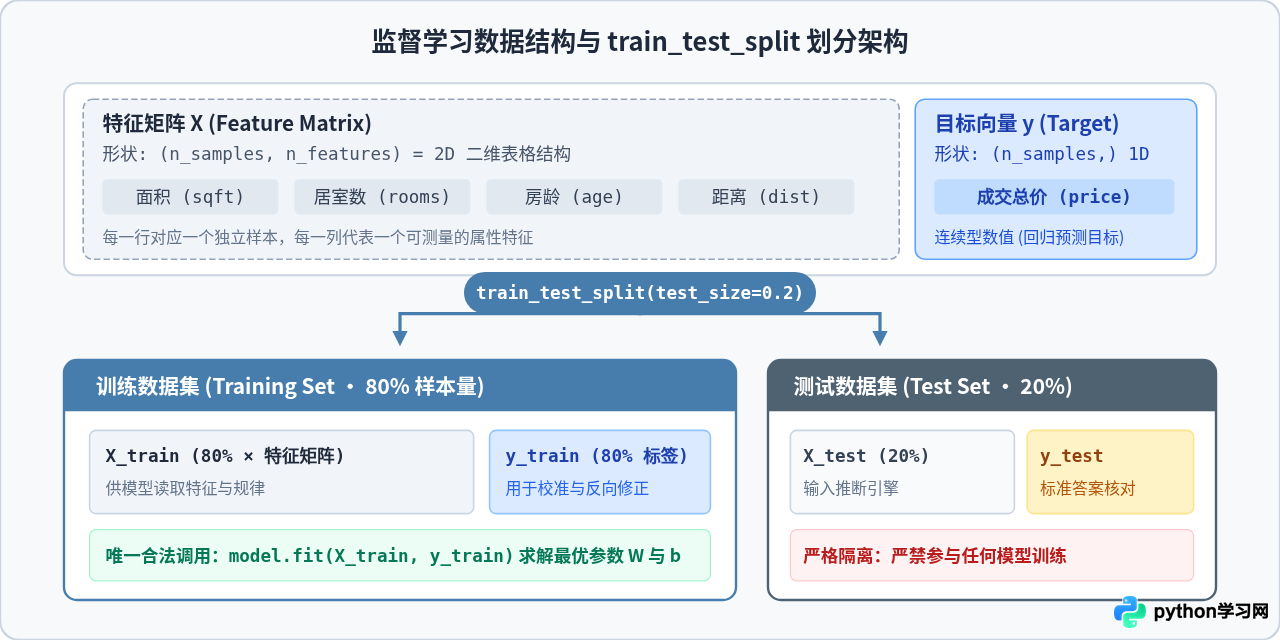
为解决这一问题,必须在拟合模型前使用 train_test_split 函数将全量样本切分为相互隔离的两部分(常见比例为 80% 训练集,20% 测试集):
# 划分 80% 训练集、20% 测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.20,      # 测试集样本占比 20%
    random_state=42      # 锁定随机种子,确保拆分结果可重复
)

print(f"训练集特征维度: {X_train.shape}, 训练集标签维度: {y_train.shape}")
print(f"测试集特征维度: {X_test.shape}, 测试集标签维度: {y_test.shape}")在生产与测试脚本中,务必显式指定 random_state(例如赋值为 42 或 0)。如果不指定,每次重新运行脚本时数据划分都会随机改变,导致模型每次跑出的评估指标存在波动,从而无法精确排查代码修改对模型性能带来的真实影响。
5. 步骤三与四:模型实例化与拟合训练(fit)
由于房屋售价预测属于典型的连续数值推断,我们选用最经典的线性回归模型(LinearRegression)作为第一个预测器。线性回归基于普通最小二乘法(OLS),在多维空间中学习如下代数超平面:
y = w₁·Area + w₂·Bedrooms + w₃·Age + w₄·Dist + b
在 Scikit-learn 中,完成这个拟合过程只需两行代码:
from sklearn.linear_model import LinearRegression

# 1. 实例化估计器对象
model = LinearRegression(fit_intercept=True)

# 2. 调用 fit 方法执行模型训练(注意:仅传入训练集数据!)
model.fit(X_train, y_train)

# 3. 查看学习到的参数
print("截距项 (Intercept b):", round(model.intercept_, 4))
print("
各特征权重系数 (Weights W):")
for col, coef in zip(X.columns, model.coef_):
print(f" {col:<12}: {coef:>8.4f}")参数语义验证:观察训练得出的系数,面积系数约为 +3.21(每增加 1 平方米,房价上涨约 3.21 万元),房龄系数为 -2.52(每老 1 年折旧 2.52 万元),距离系数为 -3.99(离中心越远价格越低)。算法在不了解业务背景的前提下,仅凭对 160 个训练样本的数值拟合,就精准反向还原出了底层的真实市场规律。
6. 步骤五:模型推断与多指标综合评估
训练完成后,我们必须使用之前从未参与过拟合的测试集(X_test)来检验模型的推断效果。调用 model.predict(X_test) 将输出模型对测试样本的预测结果数组 y_pred。
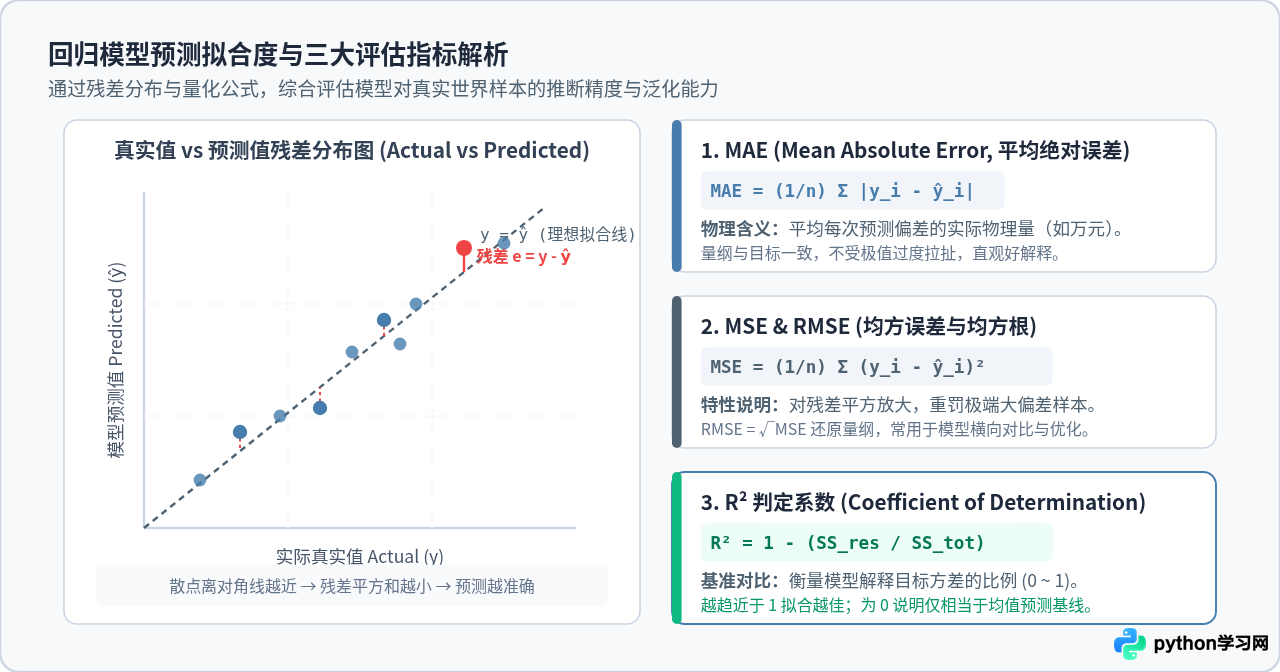
如何客观评价预测结果的好坏?不能仅看某几个样本猜得准不准,而是要计算全集上的统计学度量。Scikit-learn 在 sklearn.metrics 模块中提供了标准化的量化函数:
| 评估指标 | 全称与核心公式 | 主要优势与适用场景 |
|---|---|---|
| MAE | Mean Absolute Errormean(|y - ŷ|) |
物理量纲与预测目标完全一致(例如万元)。表达的是“平均每次预测会偏离多少”,不易受个别极端异常值扰动,向业务方汇报最直观。 |
| MSE / RMSE | Mean Squared Errormean((y - ŷ)²) |
通过平方项放大了较大偏差的惩罚力度。如果业务上无法容忍巨大误差(如安全、金融风控),MSE/RMSE 是更严格的考核指标。 |
| R² 判定系数 | Coefficient of Determination1 - (SS_res / SS_tot) |
无量纲归一化指标(0 到 1 之间)。表示模型能够解释目标数据方差的百分比。接近 1 说明模型拟合极好,0 表示仅相当于基准均值预测。 |
编写评估脚本,计算测试集上的各项指标数值:
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

# 在测试集上进行模型推断
y_pred = model.predict(X_test)

# 计算多维度评估指标
mae = mean_absolute_error(y_test, y_pred)
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
r2 = r2_score(y_test, y_pred)

print(f"平均绝对误差 MAE : {mae:.2f} 万元")
print(f"均方误差   MSE : {mse:.2f}")
print(f"均方根误差 RMSE: {rmse:.2f} 万元")
print(f"判定系数 R² : {r2:.4f}")指标解读:测试集上的 R² 达到 0.9635,说明该模型成功解释了测试集中超过 96% 的房价波动;平均绝对误差 MAE 为 12.18 万元,相对于 300~600 万元的总房价,平均预测偏差在合理工程可用区间内。
7. 实战推断:对全新未知样本进行预测
模型通过评估测试后,即可部署用于实际推断。假设业务线现在录入了两套全新的房屋挂牌信息,我们将其组织为与训练集特征列名一致的 DataFrame,并直接调用 predict():
# 准备待预测的 2 套新房源数据
new_houses = pd.DataFrame({
    'Area_sqm': [125.0, 88.5],   # 面积分别为 125平米 与 88.5平米
    'Bedrooms': [3, 2],           # 3 室 与 2 室
    'Age_years': [5.0, 15.0],     # 5 年次新房 与 15 年老房
    'Dist_km': [2.5, 8.0]         # 距离市中心 2.5公里 与 8公里
})

# 执行推断
predicted_prices = model.predict(new_houses)

for idx, (row, pred) in enumerate(zip(new_houses.to_dict(orient='records'), predicted_prices)):
print(f"房源 {idx + 1} 预估售价: {pred:.2f} 万元 (面积: {row['Area_sqm']}㎡, 居室: {row['Bedrooms']}, 房龄: {row['Age_years']}年, 距市中心: {row['Dist_km']}km)")8. Scikit-learn API 规范总结与新手常见避坑
Scikit-learn 之所以能够成为机器学习领域的行业事实标准,其核心优势在于极具一致性的对象接口设计。深入理解这套抽象模型,能够让你在未来切换至任何新算法时无缝上手。
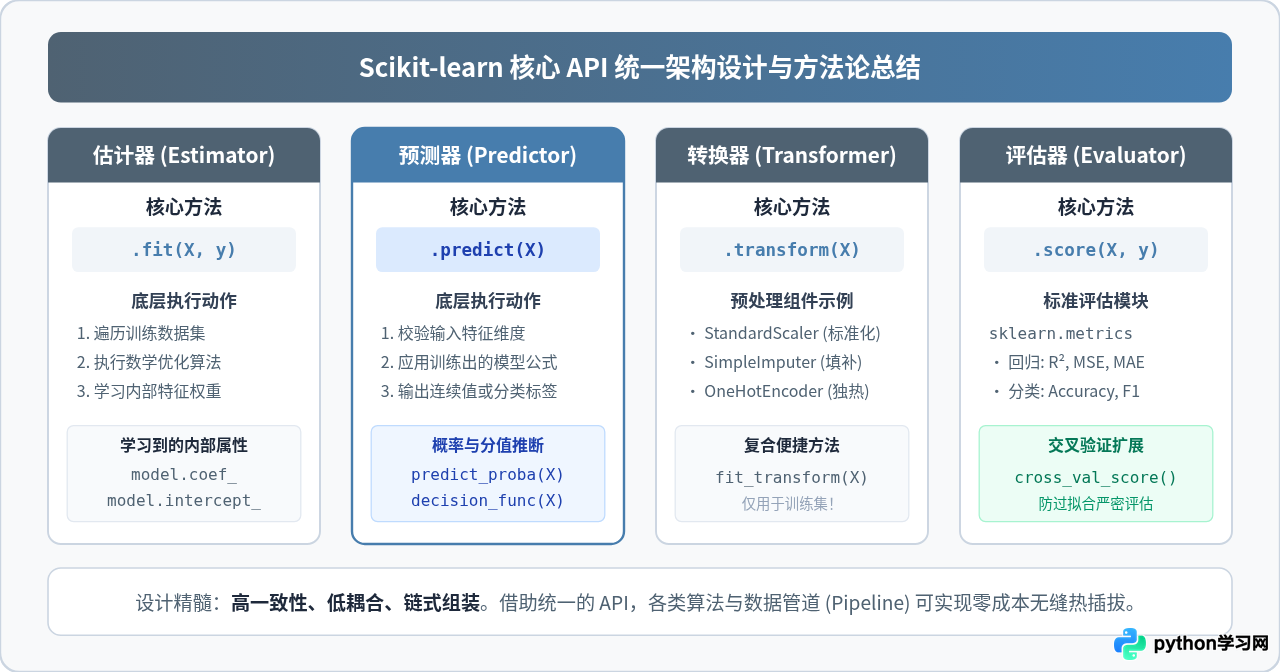
新手入门最常遇到的三大工程陷阱
-
输入数组维度错误(Expected 2D array, got 1D array instead):
这是新手推断单个样本时最容易触发的报错。
predict()永远期望接收一个二维结构(n_samples, n_features)。即便只预测单套房屋,也不能直接传入一个普通的一维列表[120, 3, 5, 2],而必须通过pd.DataFrame(...)封装,或者使用 NumPy 的np.array([120, 3, 5, 2]).reshape(1, -1)将其升至二维矩阵。 -
特征工程数据泄露(Data Leakage):
若后续需要对特征进行标准化缩放(如
StandardScaler)或缺失值填充(SimpleImputer),切忌在全量数据切分前统一 fit_transform!正确的做法是:仅在X_train上调用scaler.fit_transform(X_train),学习训练集的均值与方差;对测试集X_test只调用scaler.transform(X_test)。否则测试集的信息会提前泄露给模型,造成评估失真。 - 训练集与测试集特征列不一致: 在真实业务中,如果新样本的列顺序被调换、缺失了某列、或者列名产生差异,模型计算的权重将直接错位。务必在推断阶段增加特征 Schema 校验,确保输入预测器的 DataFrame 具备与训练期完全一致的列结构。
9. 附录:单文件可直接运行的完整源码
为方便读者本地调试,下方提供合并后的单文件完整可执行代码。保存为 first_model.py 后直接执行即可:
# -*- coding: utf-8 -*-
"""
Scikit-learn 第一个预测模型端到端实战脚本
任务:房屋售价多元线性回归预测
"""
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

# 1. 数据准备
np.random.seed(42)
n_samples = 200
area = np.random.uniform(50, 180, n_samples)
rooms = np.random.randint(1, 5, n_samples)
age = np.random.uniform(1, 25, n_samples)
dist = np.random.uniform(0.5, 15, n_samples)
price = area * 3.2 + rooms * 8.0 - age * 2.5 - dist * 4.0 + 50.0 + np.random.normal(0, 15, n_samples)

X = pd.DataFrame({'Area_sqm': area, 'Bedrooms': rooms, 'Age_years': age, 'Dist_km': dist})
y = pd.Series(price, name='Price_w')

# 2. 集合划分
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 3. 实例化估计器并训练
model = LinearRegression(fit_intercept=True)
model.fit(X_train, y_train)

# 4. 推断与量化评估
y_pred = model.predict(X_test)
print("=== 模型评估报告 ===")
print(f"MAE : {mean_absolute_error(y_test, y_pred):.2f} 万元")
print(f"RMSE: {np.sqrt(mean_squared_error(y_test, y_pred)):.2f} 万元")
print(f"R²  : {r2_score(y_test, y_pred):.4f}")

# 5. 新房源推断
sample_input = pd.DataFrame({'Area_sqm': [120.0], 'Bedrooms': [3], 'Age_years': [4.0], 'Dist_km': [3.0]})
pred_res = model.predict(sample_input)[0]
print(f"
新房源预测价格: {pred_res:.2f} 万元")
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









