

Python列表与字典操作技巧:常用数据结构基础用法

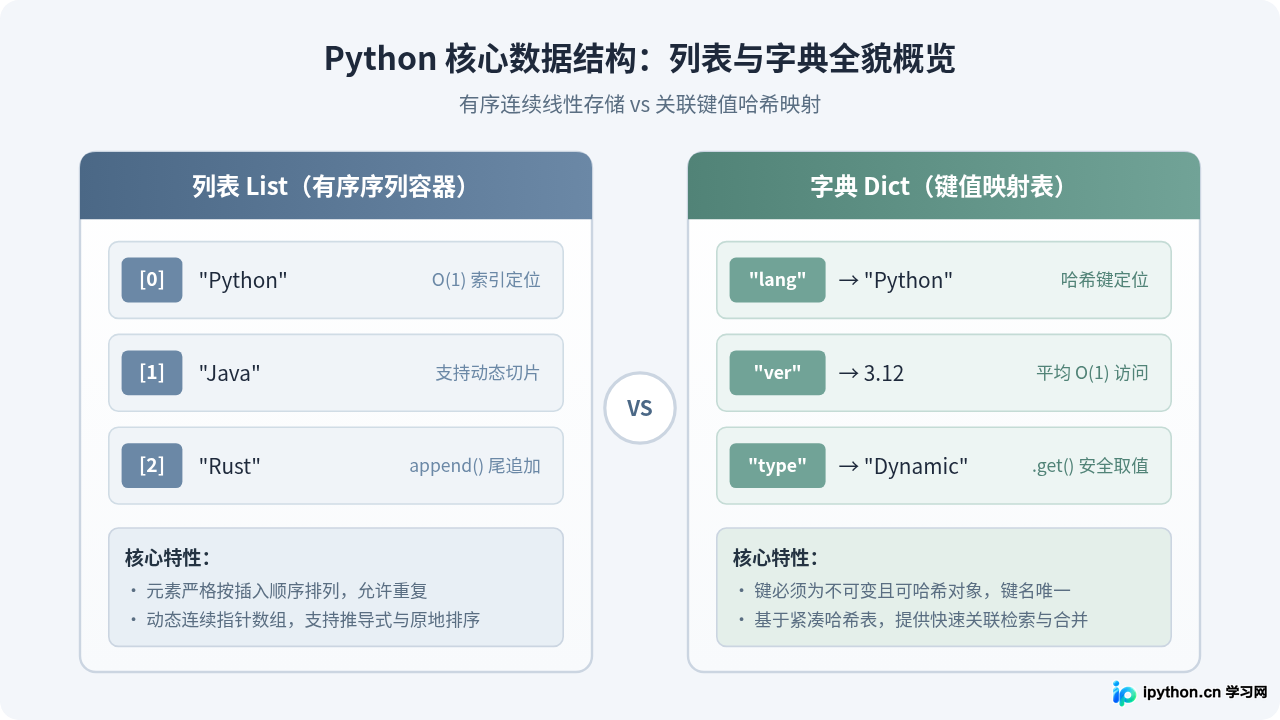
在Python日常开发中,列表(List)与字典(Dictionary)是使用频率最高的两种内置复合数据结构。列表用于管理具有确定相对次序的元素集合,擅长按数字索引访问与顺序遍历;字典用于表达键与值之间的映射关联,借助底层哈希表提供极高效率的键查找与更新。掌握这两种数据结构的内部机制、核心方法、推导式写法以及常见规避误区,是编写高效、稳健代码的关键一步。本文将从底层差异、操作技巧、实战流转和常见陷阱四个维度,系统梳理它们的基础用法与实用操作。
一、存储机制与原理对比:线性数组与哈希表
虽然列表和字典都能容纳多种类型的Python对象,但两者的底层数据组织形式完全不同,这直接决定了它们在不同操作场景下的性能表现。
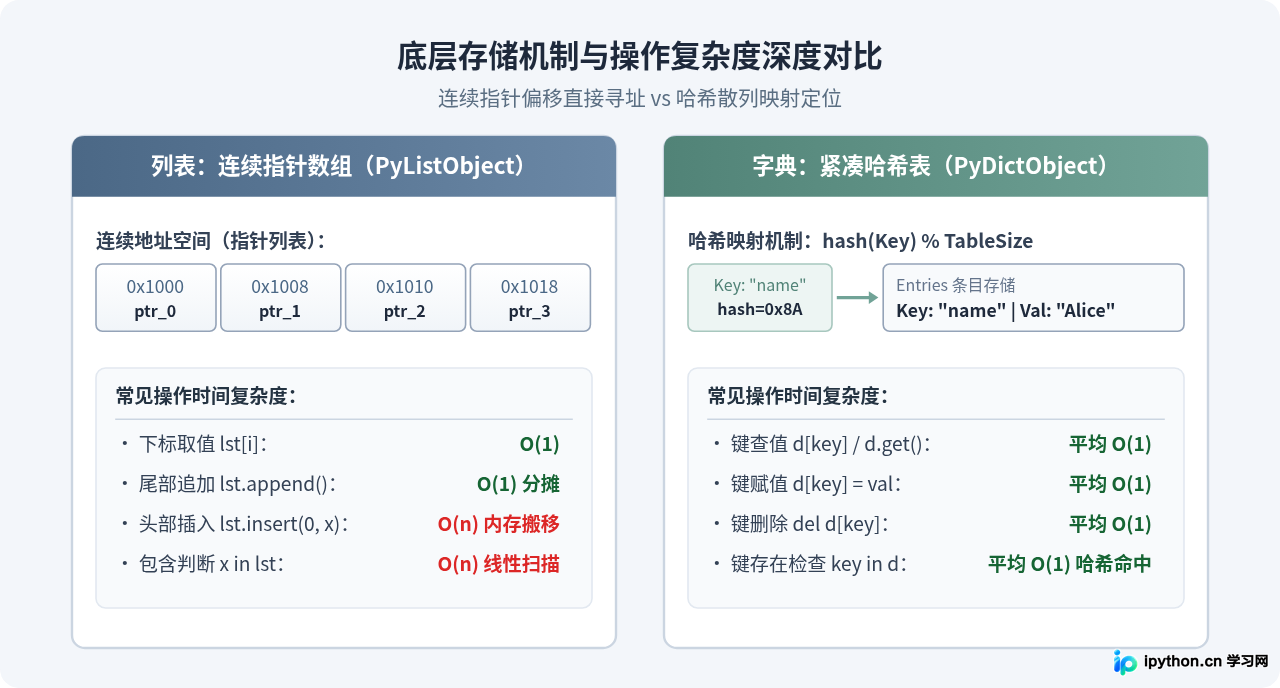
Python列表的本质是连续的动态指针数组。在CPython实现中,列表维护了一段连续的内存地址空间,其中存储的并不是元素对象本身,而是指向各个对象的指针。正因为指针在内存中连续排列,通过索引读取元素时(如 lst[2]),解释器只需执行简单的基地址加偏移量运算,便能在 $O(1)$ 时间内直达目标对象。但这种结构的短板在于插入与删除:在列表头部或中间插入元素时,为了保持连续性,后续所有指针都必须整体向后搬移,带来 $O(n)$ 的时间开销。
Python字典的本质是紧凑哈希表(Hash Table)。字典将“键”(Key)通过内置的 hash() 函数计算为整数哈希值,再映射到哈希索引表中找到具体条目位置。现代Python(3.6+)采用紧凑字典实现:将索引数组与实际存放键值对的条目数组分离,既保持了内存高效利用,又天然保留了键值对的插入顺序。在字典中按键检索、赋值或删除,平均时间复杂度均为 $O(1)$。但这一特性的前提是:字典的键必须是“可哈希”(Hashable)的不可变对象,例如字符串、整数、元组等,而列表等可变对象不能充当字典的键。
二、Python列表核心操作与实用技巧
列表的操作围绕顺序增删、按位切片与批量推导展开。在实际编写中,合理选择API能显著提升代码执行效率与可读性。
1. 元素追加与扩展:append 与 extend
向列表增加元素时,常见方法有 append() 与 extend():
append(item):将传入的参数作为单个完整对象追加到列表尾部。如果传入的是另一个列表,整个列表将作为嵌套子列表存入。extend(iterable):迭代传入的序列,将其中的每一个元素逐一取出并追加到列表尾部,实现真正的列表合并。
# 示例:追加与扩展的区别
tech_stack = ["Python", "Docker"]

# 使用 append 追加单个元素
tech_stack.append("PostgreSQL")
# 输出示例: ['Python', 'Docker', 'PostgreSQL']

# 如果错误使用 append 追加列表,会形成嵌套
# tech_stack.append(["Redis", "Nginx"]) -> ['Python', ..., ['Redis', 'Nginx']]

# 正确做法:使用 extend 批量追加
tech_stack.extend(["Redis", "Nginx"])
print("扩展后的列表:", tech_stack)
# 输出示例: ['Python', 'Docker', 'PostgreSQL', 'Redis', 'Nginx']lst.insert(0, item)。在列表头部插入会导致全量现有元素向后移动一位。如果有频繁从头部压入或弹出的需求,建议使用标准库 collections.deque(双端队列),其两端操作的时间复杂度均为 $O(1)$。
2. 切片操作(Slicing):灵活截取与反转
列表切片语法为 lst[start:stop:step],它以左闭右开区间截取子列表:
- 基本切片:
lst[1:4]提取索引为 1、2、3 的三个元素。 - 省略边界:
lst[:3]提取前3项;lst[2:]提取从索引2到末尾的所有项。 - 负数步长反转:
lst[::-1]以步长 -1 从右往左截取,能够极简地生成逆序新列表。 - 浅拷贝副本:
lst[:]生成当前列表的一份独立浅拷贝。
numbers = [10, 20, 30, 40, 50, 60]

print("截取第2到第4项:", numbers[1:4])   # 输出示例: [20, 30, 40]
print("步长为2间隔读取:", numbers[::2])    # 输出示例: [10, 30, 50]
print("快速列表逆序:", numbers[::-1])      # 输出示例: [60, 50, 40, 30, 20, 10]
3. 列表推导式(List Comprehension):过滤与转换
列表推导式是Python最具代表性的语法糖之一。相比于传统的 for 循环和 append,列表推导式直接在底层的C循环中构建列表,不仅行数更少,运行速度通常也更快。
# 传统循环写法
raw_scores = [58, 88, 72, 95, 45, 83]
passed_scores = []
for score in raw_scores:
    if score >= 60:
        passed_scores.append(score * 1.1)

# 列表推导式等价写法(过滤及映射合并)
boosted_scores = [round(s * 1.1, 1) for s in raw_scores if s >= 60]
print("合格并调分后的成绩:", boosted_scores)
# 输出示例: [96.8, 79.2, 104.5, 91.3]
4. 列表排序:sort() 原地修改与 sorted() 返回新副本
初学者容易混淆 lst.sort() 和 sorted(lst):
lst.sort()是列表专有的成员方法,它会原地修改当前列表,返回值为None。sorted(lst)是内置通用函数,它不改变原列表,而是返回排序后的新列表。- 两个方法都支持
reverse=True参数进行逆序,以及key=lambda x: ...指定排序规则。
users = [
    {"name": "Alice", "age": 28},
    {"name": "Bob", "age": 22},
    {"name": "Charlie", "age": 35}
]

# 按年龄升序排序并返回新列表,不破坏原数据
sorted_by_age = sorted(users, key=lambda u: u["age"])
print("按年龄排序结果:", [u["name"] for u in sorted_by_age])
# 输出示例: ['Bob', 'Alice', 'Charlie']
三、Python字典核心操作与安全机制
字典的日常操作聚焦于安全检索、动态合并以及键值逆序。与列表按数字索引不同,字典必须妥善处理“键不存在”时的异常分支。
1. 安全取值:规避 KeyError
直接使用下标语法 dict[key] 取值时,一旦键名不存在,程序会立即抛出 KeyError 并崩溃中断。针对非必填字段或动态数据,应优先使用以下两种安全方式:
dict.get(key, default=None):当键不存在时返回默认值(默认为None),避免报错。dict.setdefault(key, default):当键存在时直接返回原值;当键不存在时,在字典中存入该默认值并返回。该方法非常适合在分组聚合时初始化空列表或空集合。
user_profile = {"username": "py_learner", "level": 3}

# 直接取值存在风险
# bio = user_profile["bio"]  # 抛出 KeyError: 'bio'

# 方式一:使用 get() 提供默认值
bio = user_profile.get("bio", "暂未填写个人简介")
print("简介信息:", bio)  # 输出示例: 暂未填写个人简介

# 方式二:使用 setdefault() 确保键初始化
scores = user_profile.setdefault("scores", [])
scores.append(95)
print("更新后的用户画像:", user_profile)
# 输出示例: {'username': 'py_learner', 'level': 3, 'scores': [95]}
2. 字典遍历与动态合并
在遍历字典时,建议显式指明遍历范围:
for key in d:仅遍历所有键。for val in d.values():仅遍历所有值。for key, val in d.items():同时解构键与值,是业务处理中最常见的方式。
在合并两个字典时,Python 3.9 引入了更直观的合并运算符 | 与就地更新运算符 |=,相比传统的 update() 更加简洁:
base_config = {"env": "prod", "debug": False, "timeout": 30}
custom_config = {"timeout": 60, "log_level": "INFO"}

# Python 3.9+ 推荐做法:使用 | 运算符生成新合并字典
merged_config = base_config | custom_config
print("合并后的配置项:", merged_config)
# 输出示例: {'env': 'prod', 'debug': False, 'timeout': 60, 'log_level': 'INFO'}

# 原地更新:base_config |= custom_config 等价于 base_config.update(custom_config)
3. 字典推导式与键值翻转
类似于列表推导式,字典推导式使用大括号 {k: v for ...},常用于数据过滤、属性提取以及键值互换:
# 场景:将状态码字典进行键值翻转以支持通过名称反查代码
status_codes = {200: "OK", 404: "Not Found", 500: "Internal Error"}

# 键值互换推导式
name_to_code = {name: code for code, name in status_codes.items()}
print("反查字典:", name_to_code)
# 输出示例: {'OK': 200, 'Not Found': 404, 'Internal Error': 500}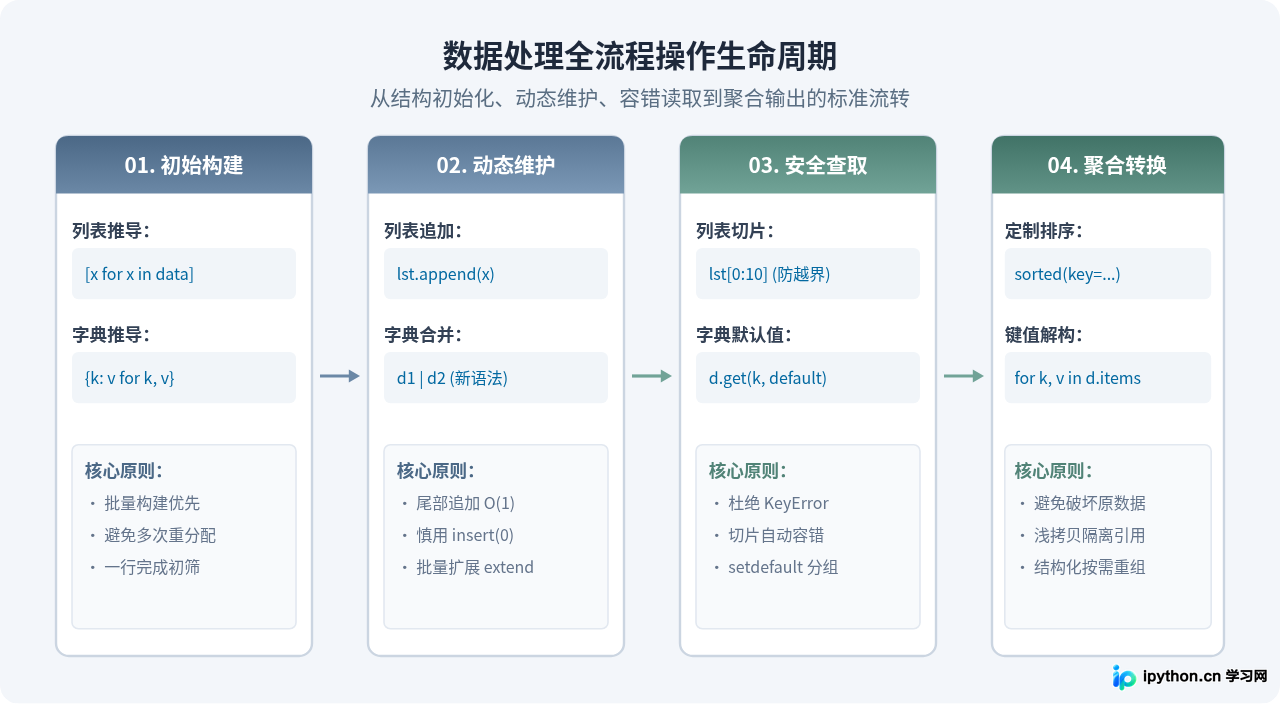
四、嵌套结构实战:列表嵌套字典的数据清洗与分组
在实际生产中,从数据库查询或第三方API获取的数据通常以“列表包含字典”的形态呈现(即形如 [{'id': 1, 'dept': 'Dev', ...}, ...] 的表格化记录)。下面的综合案例演示如何综合利用推导式、setdefault 与排序,完成从原始数据清洗到按部门聚合统计的全流程。
# 步骤 1:原始记录准备(存在无效数据与空缺)
raw_logs = [
    {"user": "Alice", "dept": "Engineering", "hours": 42},
    {"user": "Bob", "dept": "Marketing", "hours": 35},
    {"user": "Charlie", "dept": "Engineering", "hours": 38},
    {"user": "David", "dept": "Engineering", "hours": -5},  # 异常工时
    {"user": "Eve", "dept": "Marketing", "hours": 40},
    {"user": "Frank", "dept": "Design", "hours": 30}
]

# 步骤 2:使用列表推导式清洗数据(过滤工时小于0的异常记录)
valid_logs = [record for record in raw_logs if record.get("hours", 0) > 0]

# 步骤 3:使用字典 setdefault() 按部门分组聚合
dept_summary = {}
for log in valid_logs:
    dept = log["dept"]
    hours = log["hours"]
    # 若部门不存在则初始化空列表,并将工时压入
    dept_summary.setdefault(dept, []).append(hours)

# 步骤 4:使用字典推导式计算各部门总工时与平均工时
dept_stats = {
    dept: {
        "total_hours": sum(hours_list),
        "avg_hours": round(sum(hours_list) / len(hours_list), 1),
        "headcount": len(hours_list)
    }
    for dept, hours_list in dept_summary.items()
}

print("部门工时聚合统计结果:")
for dept, stats in dept_stats.items():
    print(f"[{dept}] 总工时: {stats['total_hours']}, 人均: {stats['avg_hours']}h")

# 输出示例:
# [Engineering] 总工时: 80, 人均: 40.0h
# [Marketing] 总工时: 75, 人均: 37.5h
# [Design] 总工时: 30, 人均: 30.0h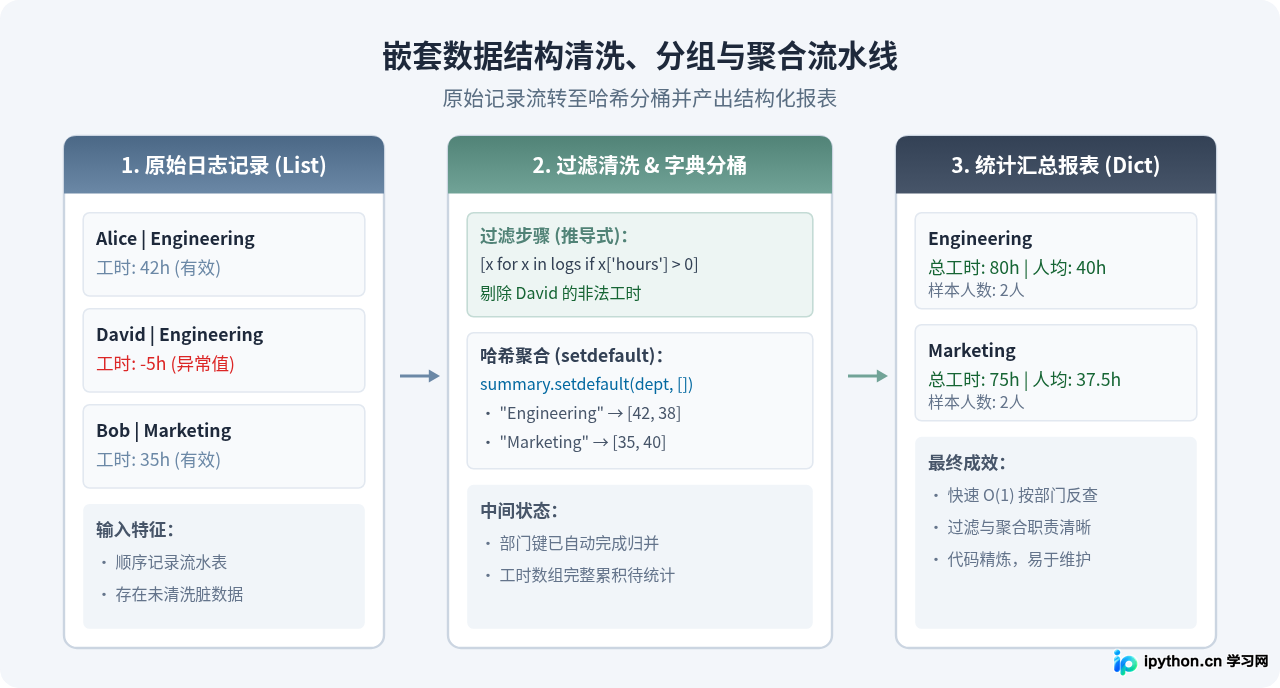
五、高频踩坑点与避坑指南
在实际编码中,由于Python动态引用的特性,列表和字典在某些场景下容易引发隐蔽的Bug。以下三点需要特别警惕:
1. 循环遍历中直接修改原容器(跳项与漏删)
初学者容易写出边遍历列表边调用 remove() 的代码。因为列表是连续存储的,一旦删除了某一位置的元素,其后所有元素会立即向前补位,而遍历内部的索引计数器仍在继续递增,从而导致紧随其后的元素被“跳过”,产生漏删。
for item in my_list: if cond: my_list.remove(item)正确规范:遍历列表的浅拷贝副本
for item in my_list[:]:,或者使用列表推导式直接生成过滤后的新列表。遍历字典时如果需要动态增删键,应使用 list(my_dict.keys()) 锁定当前的键列表再做遍历。
2. 浅拷贝与深拷贝陷阱(引用共享污染)
无论是 lst.copy()、lst[:] 还是 dict.copy(),生成的均为浅拷贝(Shallow Copy)。它们仅仅复制了外层容器本身,容器内部引用的子对象(如嵌套的子列表或子字典)依然是指向同一块内存地址的指针。
import copy

# 浅拷贝示例
nested_list = [[1, 2], [3, 4]]
shallow_clone = nested_list.copy()

# 修改子列表中的数值,原列表也会被修改!
shallow_clone[0][0] = 999
print("原列表被波及:", nested_list)  # 输出示例: [[999, 2], [3, 4]]

# 正确做法:若包含多层嵌套对象,使用 deepcopy 实现完整深拷贝
safe_clone = copy.deepcopy(nested_list)
safe_clone[0][0] = 100
print("深拷贝隔离修改:", nested_list[0][0])  # 输出示例: 999 (未受干扰)
3. 可变对象(列表/字典)作为函数默认参数
Python中函数的默认参数只在函数定义时评估一次,并在所有函数调用之间共享。如果将空列表 [] 或空字典 {} 直接作为参数默认值,后续每次就地修改都会污染下一次调用。
# 常见隐患写法
def append_item(item, container=[]):  # 危险!container 是静态共享的
    container.append(item)
    return container

# 推荐规范写法:使用 None 作为占位符并在函数内动态初始化
def append_item_safe(item, container=None):
    if container is None:
        container = []
    container.append(item)
    return container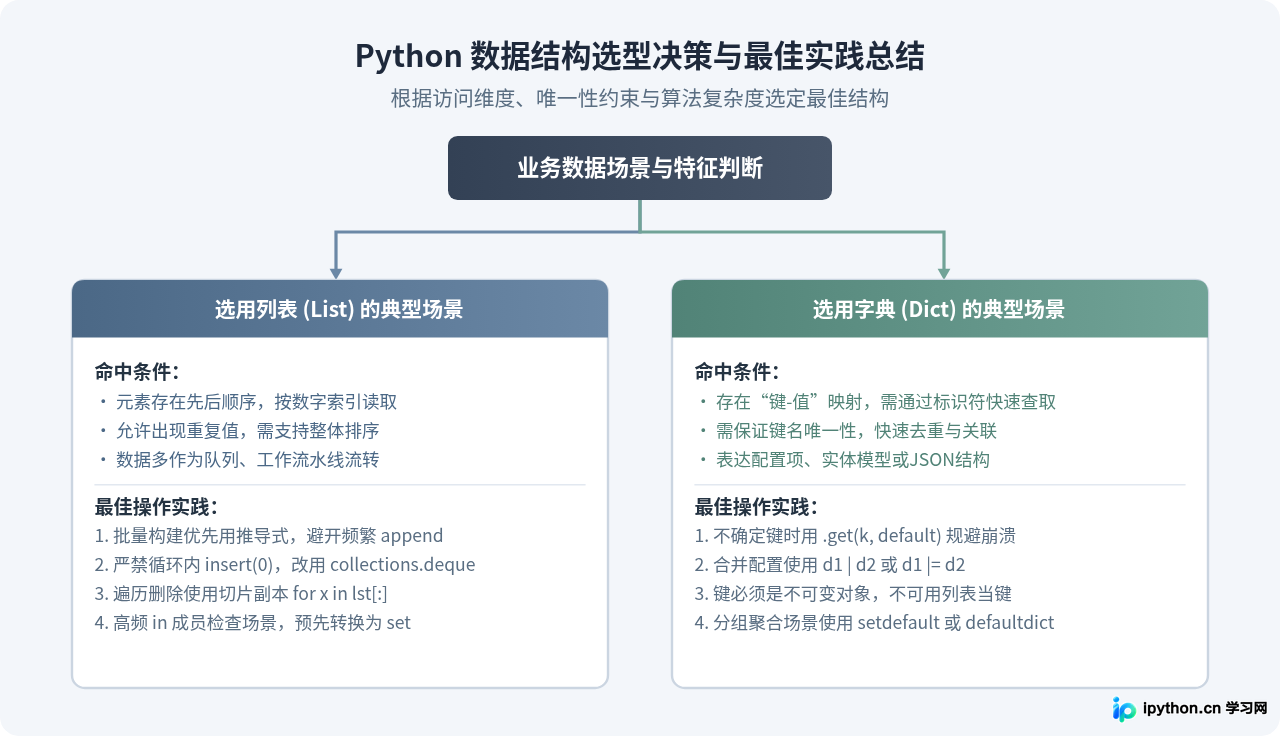
六、总结与速查清单
列表与字典各有其不可替代的优势。列表以连续紧凑的内存布局保障了序列的保序性与极低的下标访问开销;字典则通过哈希表提供了常数级别的关联检索与键名隔离能力。在日常工程中,二者往往协同使用:外部以列表作为流水线容器承载一系列结构化记录,内部以字典作为键值实体映射具体字段。
| 对比维度 | 列表(List) | 字典(Dictionary) |
|---|---|---|
| 底层存储结构 | 连续动态指针数组(顺序线性) | 紧凑哈希表(分散散列条目) |
| 元素约束 | 任意对象均可,允许元素重复 | 键必须可哈希且唯一;值可为任意对象 |
| 读取时间复杂度 | 索引读取 $O(1)$,成员检查 $O(n)$ | 键名读取平均 $O(1)$,键名检查平均 $O(1)$ |
| 追加/写入复杂度 | 尾部追加 $O(1)$,头部插入 $O(n)$ | 写入或更新键值对平均 $O(1)$ |
| 核心安全方法 | 切片防越界、副本遍历防漏删 | .get() 防 KeyError、setdefault() 防初值缺失 |
| 典型应用场景 | 日志流水、有序排队、多维排序 | 配置参数、实体属性映射、快速索引与分桶 |
熟练运用列表与字典,不仅能使代码更清晰自然地表达业务逻辑,更能从根本上避免低效的遍历开销与潜在的引用缺陷。建议在实际编码中以推导式代替繁杂的累加循环,以安全取值防范异常输入,以明确的浅深拷贝边界隔离外部副作用,让代码兼具优雅与健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









