

为什么Python元组是不可变的?尝试修改会报错吗
深入解析Python元组为什么被设计为不可变序列,尝试通过索引修改、调用变异方法或增量赋值会引发什么具体报错,剖析其底层内存结构、哈希契约与性能优化设计。
在 Python 中,尝试对元组进行任何原地赋值或增删修改,解释器都会立即终止操作并抛出确定性的异常(例如常见的 TypeError: 'tuple' object does not support item assignment)。元组之所以被设计为不可变序列(Immutable Sequence),并不是为了在语法上给开发者设限,而是出于底层哈希契约(Hashability)、确定性内存布局、小对象缓存池复用以及代码防御性语义等关键维度的深层工程考量。
一、尝试修改元组会报错吗?三种典型修改场景实测
很多初学者在编写代码时,习惯了对列表(List)进行下标重写或方法追加。如果将相同的操作应用于元组,Python 会以明确的异常类型给出反馈。以下是三种最常见的尝试修改场景及其底层报错机制。
1. 通过索引下标尝试修改元素
假设我们创建了一个包含三个整数的元组,并尝试通过索引下标将第 0 位的值替换为新的数值:
# 示例代码:索引修改尝试
nums = (10, 20, 30)
nums[0] = 99
解释器执行到赋值语句时会立即中断,抛出如下错误信息:
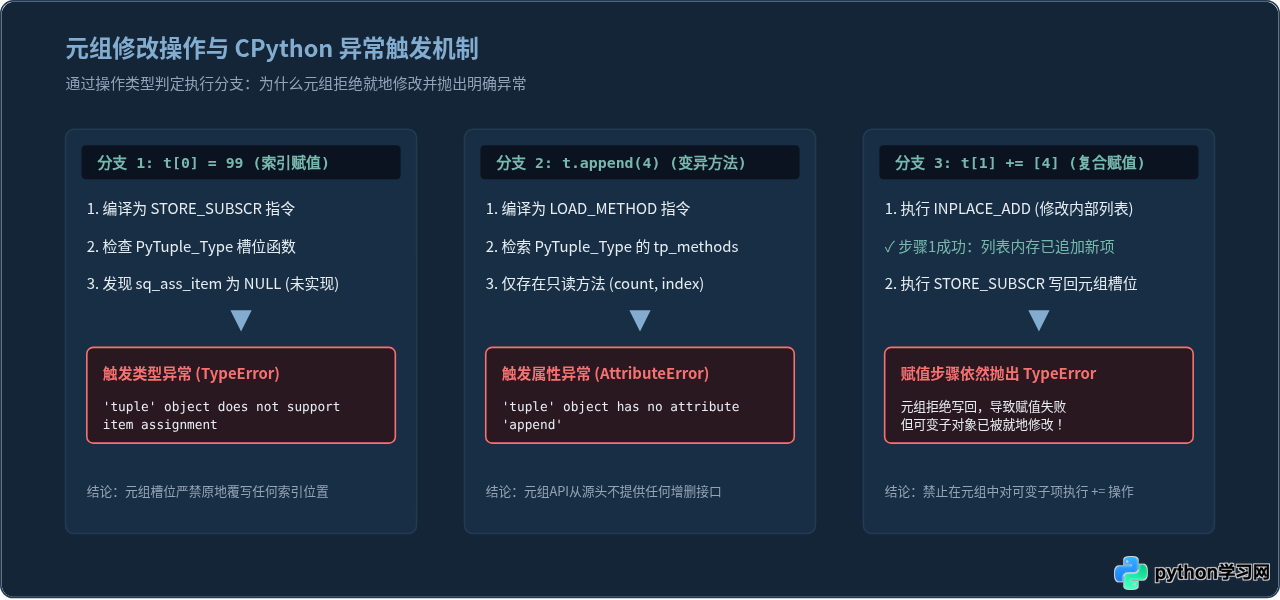
TypeError: 'tuple' object does not support item assignment报错原因:在 CPython 底层,索引赋值操作映射到字节码指令 STORE_SUBSCR。当对象类型是元组(PyTuple_Type)时,其类型结构体中的 tp_as_mapping 与 tp_as_sequence 槽位并没有实现项目赋值函数 sq_ass_item。因此解释器会直接触发 TypeError。
2. 尝试调用增删方法(append、extend、pop 等)
如果开发者试图在元组上调用列表常见的变异方法:
# 示例代码:方法调用尝试
nums = (10, 20, 30)
nums.append(40)
该操作不会走到参数校验阶段,而是在方法属性解析阶段就直接报错:
AttributeError: 'tuple' object has no attribute 'append'报错原因:元组的类型方法列表(tp_methods)仅导出了只读的 count() 和 index() 两个方法,完全没有注册任何就地改变容器尺寸与内容的操作入口。
3. 增量赋值陷阱:修改成功却依然抛出异常?
在 Python 中有一个非常著名且极具迷惑性的边界问题:如果一个元组内部包含了一个可变对象(例如列表),然后对该列表执行 += 操作,会发生什么?
# 示例代码:经典增量赋值陷阱
data = (1, [10, 20])
try:
    data[1] += [30, 40]
except TypeError as err:
    print(f"触发异常: {err}")

print(f"执行后的元组内容: {data}")
执行这段代码,输出结果如下:
触发异常: 'tuple' object does not support item assignment
执行后的元组内容: (1, [10, 20, 30, 40])在 Python 中,data[1] += [30, 40] 等同于两步操作:第一步调用列表底层的 __iadd__,就地扩展了列表内存;第二步将返回的列表对象引用再次赋回给 data[1](即执行 STORE_SUBSCR)。因为 data 是元组,第二步赋值操作被元组类型槽位拦截并抛出 TypeError。这就导致了“报错了但内容变了”的奇异现象。
二、为什么Python元组被设计为不可变?三大核心考量
Python 已经有了灵活易用的列表,为什么还要专门设计一个“不可变”的元组?这背后有三项根本性的工程需求:
1. 哈希表契约(Hashability):字典键与集合元素的基础
Python 的字典(dict)与集合(set)是基于哈希表实现的高性能容器,其平均查询与插入时间复杂度为 O(1)。哈希表正常工作的前提是:一个对象的哈希值(Hash Value)在整个生命周期内必须是绝对稳定且可计算的。
如果允许列表作为字典的键:
# 伪代码逻辑演示
d = {}
key = [1, 2]
d[key] = "value"
key.append(3)  # 如果允许发生修改!
此时如果列表内容改变,其哈希值也将改变。当再次使用 d[[1, 2, 3]] 或 d[key] 查找时,哈希桶的位置已经完全错乱,导致数据永远无法被正确检索。因此,Python 强制规定:可变对象不可哈希(Unhashable),绝对不能作为字典的 Key 或集合元素。而元组只要其内部元素全部不可变,其自身的哈希值就是固定可计算的,为多键联合索引提供了天然支持。
2. 确定性内存分配与零冗余缓冲(Memory Efficiency)
在底层数据结构上,列表是动态数组,元组是定长数组:
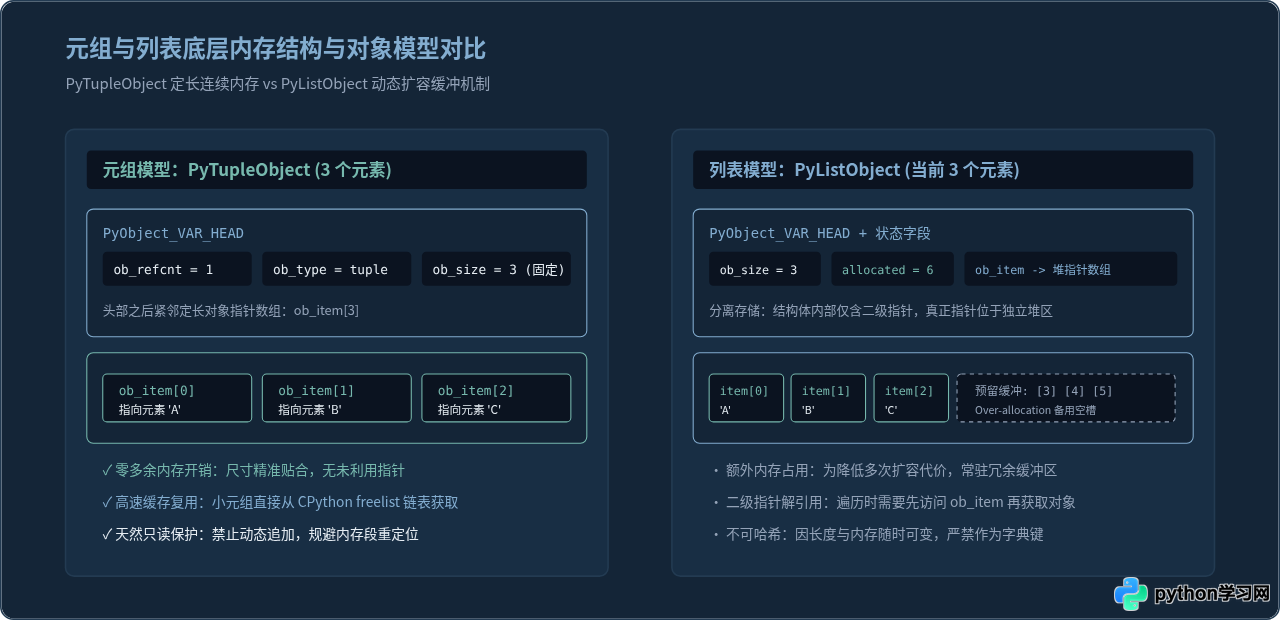
- 列表(List):为了支持频繁的
append和insert,CPython 采用了过量内存分配策略(Over-allocation buffer)。一个包含 5 个元素的列表,底层实际分配的槽位容量可能达到了 8 或更多,额外预留了空指针以避免频繁向操作系统申请系统堆内存重分配。 - 元组(Tuple):由于长度固定不可变,CPython 在实例化元组时只精准申请其所需长度的指针槽位(
ob_item[len]),完全没有额外的预留空位,使得元组的内存开销远小于列表。
3. CPython 底层的空闲链表优化(Tuple Freelists)
除了定长内存之外,CPython 内部对元组实现了极其高效的缓存池机制(free_list)。当一个长度在 1 到 20 之间的元组被垃圾回收时,其申请的连续内存块并不会立刻归还给操作系统内核,而是被直接保留在对应尺寸的静态空闲链表中。当下一次创建相同长度的新元组时,可以直接从缓存链表中复用内存,省去了昂贵的系统调用开销。
三、厘清边界:“引用不可变”不等于“内部对象不可变”
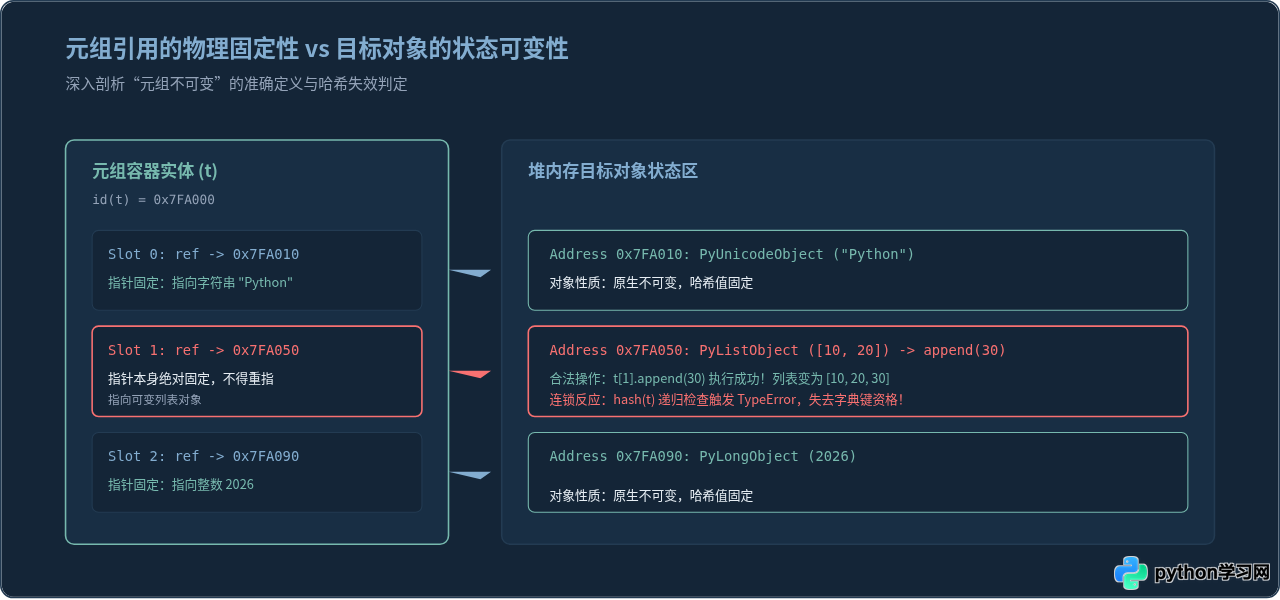
很多开发者在理解“不可变”时容易产生一个常见误区:认为元组内的所有数据都绝对无法发生任何变化。事实上,Python 元组的“不可变性”仅严格指代元组所持有的对象指针地址不可变,并不约束指针所指向对象的内部状态。
1. 顶层引用绑定固定
当我们声明 t = (1, [10, 20], "hello") 时,元组分配了三个连续槽位,分别存放:
- 槽位 0:存放整数
1的内存地址(不可变对象) - 槽位 1:存放列表
[10, 20]的内存地址(可变对象) - 槽位 2:存放字符串
"hello"的内存地址(不可变对象)
所谓的不可变,是指槽位 1 中的内存地址指针终生绑定在这个列表对象上,永远不允许被替换为其它地址。但是,列表对象本身的内部槽位依然是动态的,可以通过 t[1].append(30) 任意修改。
2. 当元组包含可变对象时,哈希性立刻丧失
如果元组包含了一个可变对象(如列表),虽然它仍然是 tuple 类型,但尝试对其调用 hash() 会触发异常:
t = (1, [10, 20])
hash(t)
# 抛出异常: TypeError: unhashable type: 'list'底层机制:在计算元组哈希值时,CPython 的 tuplehash 函数会递归遍历元组的每一个子元素并计算其子哈希。一旦遇到某个子项未实现哈希协议(抛出 TypeError),整个元组的哈希计算立刻中断失败。因此,包含可变对象的元组不能作为字典的键或集合元素。
四、工程实战:元组与列表的选型基准
在实际工程开发中,选择使用元组还是列表,应当从语义防御、数据流动特性以及内存吞吐性能三个层面进行权衡:
| 维度 | 元组 (Tuple) | 列表 (List) |
|---|---|---|
| 可变性 | 严格不可变(引用槽位固定) | 动态可变(支持追加、删除、切片覆写) |
| 哈希支持 | 支持(内部全为不可变元素时可哈希) | 完全不支持(Unhashable) |
| 典型应用场景 | 字典键、函数多返回值、配置参数、数据库行记录 | 动态队列、待处理集合、同构数据收集流 |
| 内存分配特征 | 定长精准分配,小对象享用 freelist 缓存池 | 动态过量分配缓冲,有扩容与拷贝开销 |
| API 丰富度 | 仅 count() 与 index() | append()、extend()、pop()、sort() 等丰富方法 |
1. 防御性编程(Defensive Programming)
当函数向外界返回多个结果(如 return host, port)或接收固定配置字典的坐标数据时,使用元组能向调用者传递明确的不可变信号。这能够有效防止协同开发中外部代码因误调变异方法而污染共享状态,排查 Bug 时完全无需担心元组数据在某处被隐式修改。
2. 高性能结构化替代:typing.NamedTuple 与 collections.namedtuple
如果既希望保留元组的不可变性、小内存和高速度,又希望像访问对象属性一样通过语义化名称(如 point.x, point.y)读取数据,推荐使用 NamedTuple:
from typing import NamedTuple

class ServerEndpoint(NamedTuple):
    host: str
    port: int

# 保持不可变元组特性,同时兼具可读性
node = ServerEndpoint(host="127.0.0.1", port=8080)
# node.port = 9000  # 尝试修改依然抛出 AttributeError!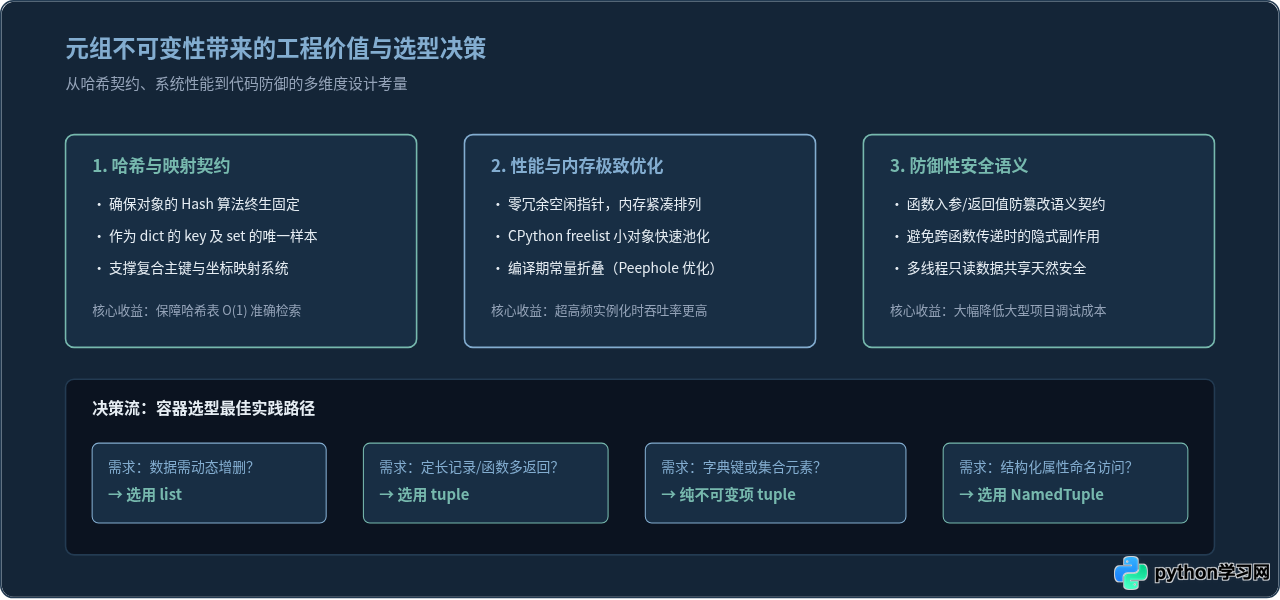
五、全文总结
回到最初的问题:为什么 Python 元组是不可变的?尝试修改会报错吗?答案可以明确归纳为:
- 尝试修改必然报错:直接通过下标赋值会抛出
TypeError: 'tuple' object does not support item assignment;调用修改方法会抛出AttributeError;对元组内的可变子项执行增量赋值(+=)会在修改内部数据的同时抛出TypeError。 - 核心设计原因:元组是作为定长只读序列而存在的。它为 Python 提供了安全可靠的哈希表键契约、零冗余的紧凑内存布局、高效的小对象复用机制以及天然的防御性编程语义。
在日常开发中,只要数据在逻辑上是固定结构的记录、配置项或映射键,就应当优先选用元组,让数据结构自带安全契约。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









