

Python字典查找为什么比列表快?解析O(1)与O(n)的性能差异

在Python开发中,若要在包含海量元素的数据集中检索指定项,使用字典(dict)进行键查找几乎在瞬间完成,而使用列表(list)查找元素却会随着数据规模扩大变得肉眼可见地缓慢。造成这种巨大性能差距的核心原因在于两者的底层数据结构与寻址机制截然不同:列表查找依赖顺序遍历(时间复杂度为 O(n)),而字典则基于哈希表实现了通过键直接计算内存位置的寻址方式(平均时间复杂度为 O(1))。
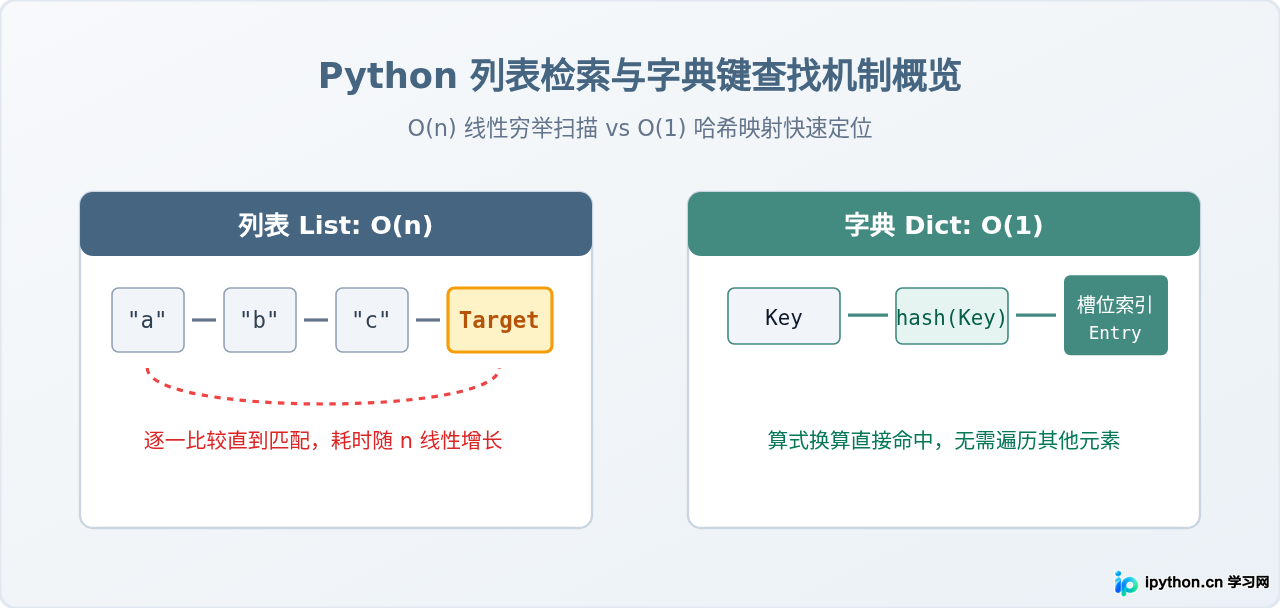
一、列表的查找机制:为什么是 O(n)?
Python的列表本质上是一个可变长度的连续引用数组。在内存中,列表存储的是指向各个对象地址的指针,这些指针在物理内存中紧密相连。
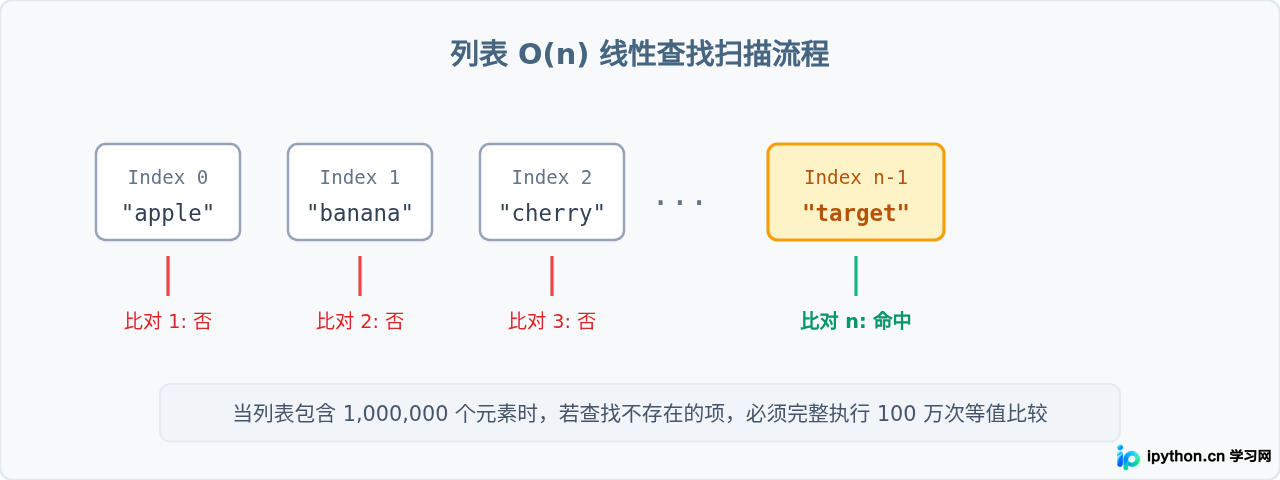
当我们执行成员判断 item in my_list 或调用 my_list.index(item) 时,Python 解释器并不知道目标元素位于列表的哪个位置。它只能采取最直接的策略:从索引 0 开始,按顺序取出元素并与目标值进行相等性比较(调用 __eq__),直到找到匹配项或扫描到列表末尾。
# 列表查找伪逻辑
def list_contains(lst, target):
    for item in lst:          # 从头到尾遍历
        if item == target:    # 逐个对象调用 __eq__
            return True
    return False              # 扫描到底未命中
这种顺序遍历的特性决定了它的性能与数据规模密切挂钩:
- 最好情况:目标刚好是第 1 个元素,只需比较 1 次,耗时 O(1)。
- 最坏情况:目标位于列表最后一个位置,或者根本不存在于列表中,必须完整扫描所有的 \(n\) 个元素,比较 \(n\) 次。
- 平均情况:若元素存在,平均需要扫描约 \(n / 2\) 次。在渐近复杂度分析中,常数系数被忽略,因此时间复杂度为 O(n)。
二、字典的查找机制:为什么是 O(1)?
字典并不采用遍历方式,而是利用散列表(Hash Table)结构。它的核心逻辑是:不靠“找”,而靠“算”。
当你向字典查询 my_dict[key] 时,Python 执行以下两步基础数学运算:
- 通过内置的哈希函数将键转化为一个固定长度的整数:
h = hash(key)。 - 利用哈希值与内部表格掩码进行位与运算,直接计算出该键应存放的槽位索引:
index = h & mask。
既然索引是由数学公式在数纳秒内直接计算出来的,Python 就能通过内存偏移量直接跳转到目标地址。无论字典中存储了 10 个键还是 10,000,000 个键,计算哈希值和内存寻址所需的时间基本恒定,这就是为什么其平均时间复杂度被称为 O(1)(常数阶)。
注意:只有可哈希对象(Hashable)才能作为字典的键。在 Python 中,数值、字符串、元组等不可变对象是可哈希的,而列表、集合、字典等可变对象不可哈希,因为它们的内容随时可能变化,会导致哈希值与存储槽位不一致。
三、深入底层:Python 3.6+ 的紧凑字典与哈希冲突解决
理解了理论上的 O(1),我们还需要看 Python 官方解释器(CPython)在底层是如何组织内存以及处理异常情况的。
1. 紧凑哈希表结构(Compact Dict)
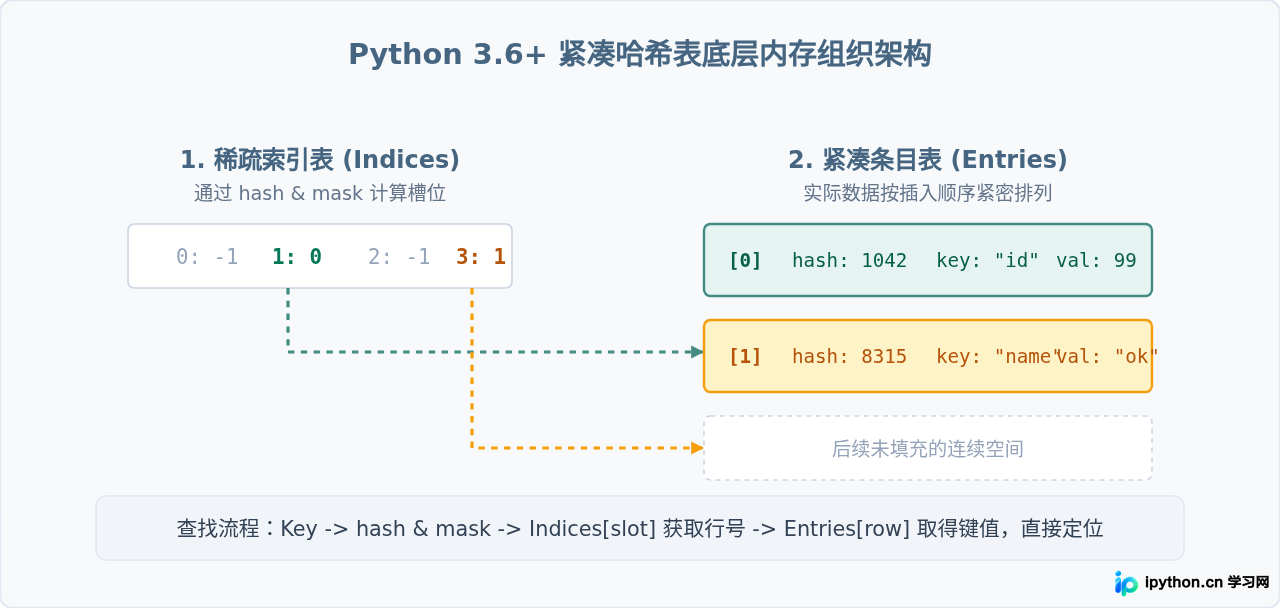
自 Python 3.6 起(并在 3.7 正式写入语言规范),CPython 采用了新的紧凑字典实现,在大幅削减内存消耗(节省 20%~25%)的同时保持了 O(1) 的查找速度,并天然保留了键值对的插入顺序。
这种结构将底层拆分为两张表:
- 稀疏索引数组(Indices Table):一个精简的整数数组,由哈希映射得到的槽位直接对应这个数组的下标。该数组中存放的是条目在数据表中的真实偏移序号。
- 紧凑条目数组(Entries Array):连续紧密存放
[hash, key, value]的数组,按插入顺序依次排列。
2. 哈希冲突与探测处理
两个不同的键在计算后可能会得出相同的槽位索引,这种现象称为哈希冲突(Hash Collision)。
CPython 使用开放寻址法(Open Addressing)与伪随机探测算法(Perturbation Probe)来化解冲突。当计算出的索引对应位置已经被其他键占用时,解释器不会发生阻塞,而是根据特定数学递推公式计算下一个探测槽位:
# 探测序列生成逻辑(CPython 源码逻辑简化)
perturb = hash_val
while True:
    slot = ((5 * slot) + 1 + perturb) & mask
    perturb >>= 5
    # 检查新槽位...
只要哈希表的装载因子(已用槽位与总容量的比值)保持在合理水平(CPython 规定装载因子达到 2/3 即自动扩容),发生冲突的概率就会被压制在极低水平,通常 1 到 2 次探测内即可命中。
四、字典键查找的完整执行步骤
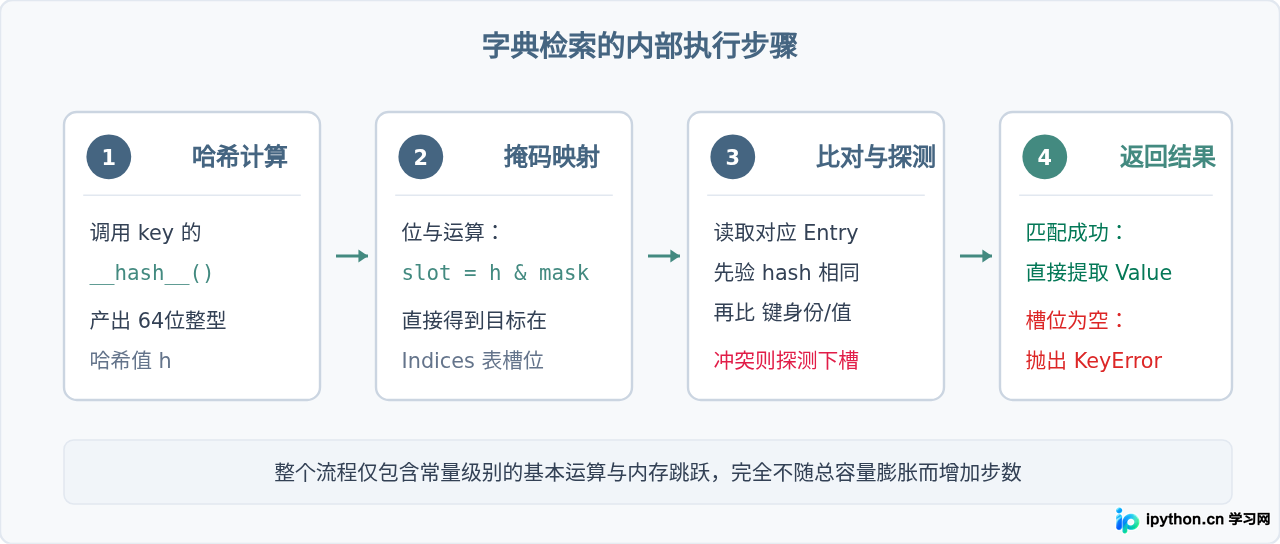
总结起来,当我们在代码中书写 val = d["user_name"] 时,Python 解释器在内部执行了严格的 4 步查找闭环:
五、性能基准与代价权衡
为了直观感受 O(1) 与 O(n) 的悬殊差异,我们可以通过 Python 内置的 timeit 模块在不同数据量级下测试查找性能(以查找末尾元素为例):
import timeit

# 在不同规模下检索不存在的键/元素(触发最坏情况)
for n in [1000, 100_000, 10_000_000]:
    data_list = list(range(n))
    data_dict = {i: None for i in range(n)}

    # 列表查找耗时测试 (查找元素 -1)
    t_list = timeit.timeit(lambda: -1 in data_list, number=100)
    # 字典键查找耗时测试 (查找键 -1)
    t_dict = timeit.timeit(lambda: -1 in data_dict, number=100)

    print(f"数据量 {n:>10}: 列表 100 次耗时 {t_list:.6f}s | 字典 100 次耗时 {t_dict:.6f}s")
在数据量达到 1,000 万时,列表的单次判断耗时通常在 0.1 秒到 0.2 秒 级别,而字典即使在千万数据下,单次判断通常仅需 50 到 80 纳秒(约相差百万倍)。
代价:空间换时间的权衡
字典之所以能实现极快的查找,是以额外的内存占用为代价的:
- 为了维持低哈希冲突率,哈希表的槽位总数必须显著大于实际存储的元素数(通常保持约 1/3 的空间裕量)。
- 除了存放真实的值,字典还必须额外记录哈希值(64位整数)和键对象指针。
因此在内存极为苛刻的嵌入式环境或极简单的有序小数据场景下,列表依然具有其不可替代的紧凑优势。
六、总结与选型对比
在日常开发中,选择列表还是字典应当以核心操作的频次与需求为依据:
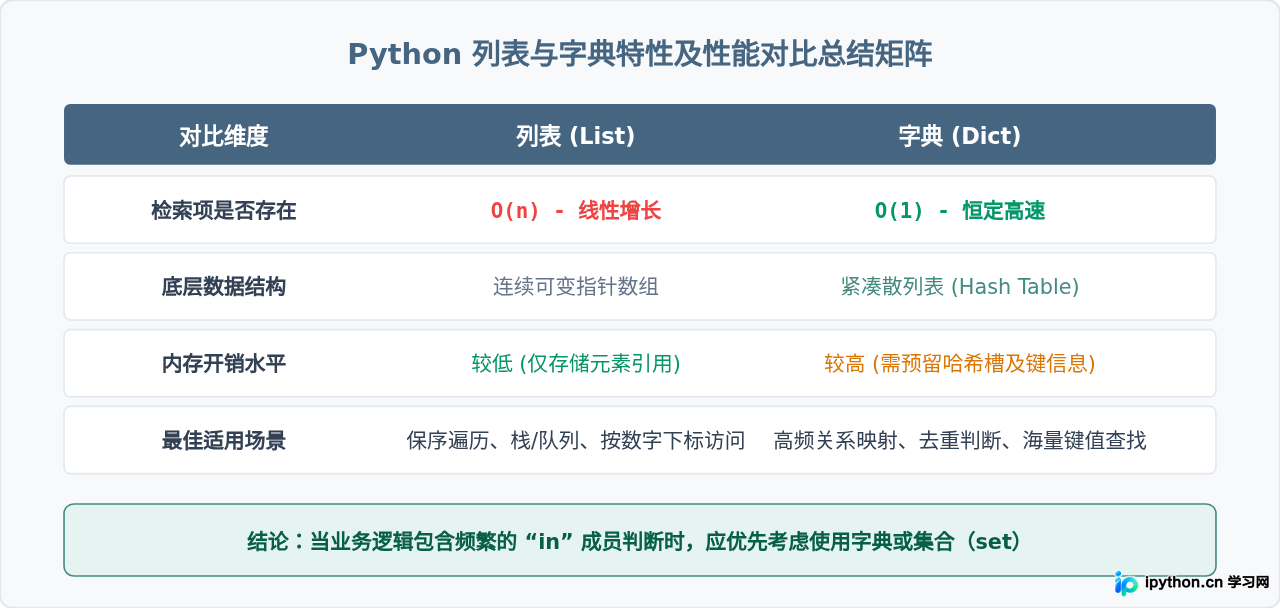
综上所述,Python 字典查找比列表快,不是微观指令执行快慢的细微差别,而是算法复杂度维度上 O(1) 对 O(n) 的降维打击。掌握哈希查找的底层逻辑,能帮助我们在日常架构设计与算法实现中做出更加高效、可靠的数据结构选型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









