

Python爬虫怎么设置随机延时避免被封:结合random模块实战
针对Python爬虫频繁请求触发反爬封禁的问题,详细讲解如何结合random模块与time.sleep设置合理的动态随机延时。包含均匀分布、正态分布及指数退避等多种策略实战代码与避坑指南。
一、为什么固定延时仍然会被风控识别
很多爬虫初学者在遇到 IP 被封或请求被限流后,第一反应是加入延时:在每次 requests.get() 之后加上 time.sleep(1) 或 time.sleep(2)。然而在实际运行中,爬取了几百页甚至上千页后,依然会收到 403 Forbidden、429 Too Many Requests 或弹出滑块验证码。这是因为现代 Web 站点的 WAF(Web Application Firewall)和风控网关不仅统计单位时间内的“请求总量”,更会审查请求在时间轴上的“时间间隔分布”。
假设一个用户在正常阅读电商列表或新闻详情,从第一页翻到第二页可能花费 2.8 秒,第二页翻到第三页耗费 1.4 秒,阅读一篇长文可能停留 8 秒。而程序脚本如果设定为 time.sleep(1),每次请求在服务器接收端记录的时间戳差值(Δt)将严格聚拢在 1.0 秒附近(误差仅有十几毫秒的底层网络抖动)。在风控统计模型中,这种高度周期性、方差趋近于 0 的离散脉冲被称为“机器周期指纹”。
通过对请求序列进行移动窗口方差分析或傅里叶自相关分析,服务器能极高置信度地判定当前客户端不是人类。随机延时的核心作用,正是用非确定性的时间抖动消除这种周期指纹,削弱请求的机械规律。
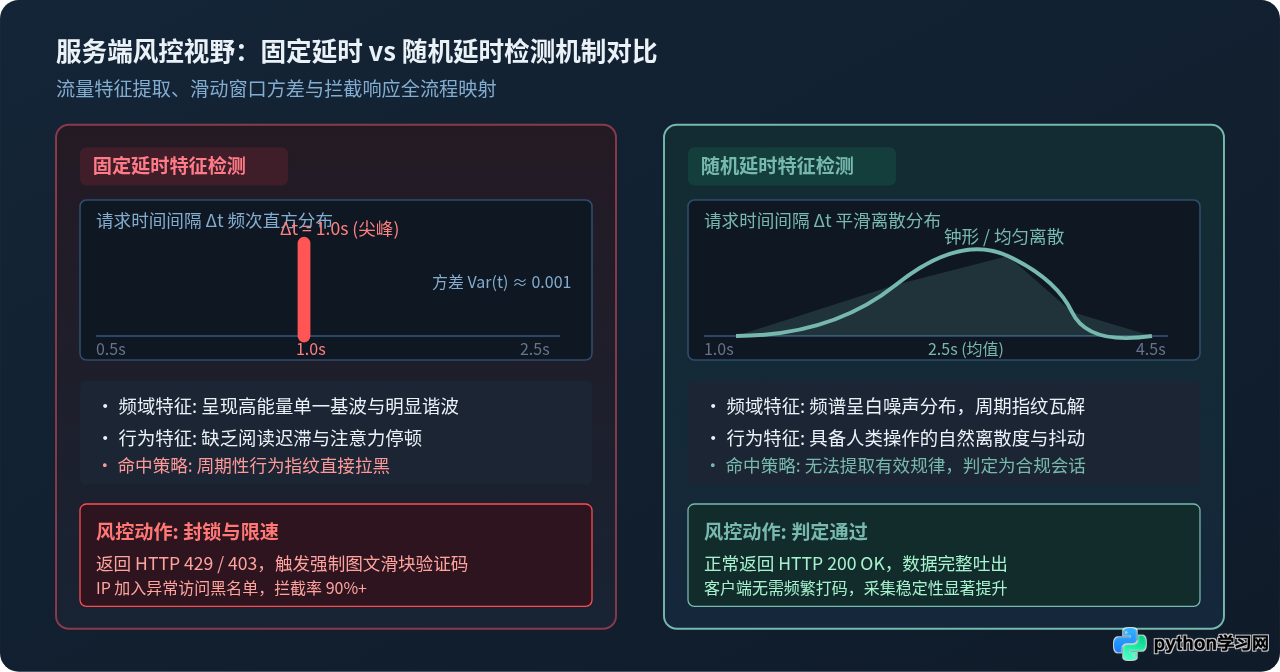 图 1:服务端风控在时间轴与统计学维度对不同延时模式的识别差异
二、Python random 模块中常用的延时生成策略
在 Python 中,结合 time.sleep(seconds) 设置延时时,参数 seconds 接受浮点数(秒)。Python 标准库内置的 random 模块提供了多种数学分布函数,能够满足不同复杂度爬虫的需求。主要有以下四种生成策略:
1. 均匀分布延时:random.uniform(a, b)
这是爬虫中最常用且最直观的延时方案。它在指定的闭区间 [a, b] 内生成连续均匀分布的浮点数:
import time
import random

# 在 1.5 秒到 3.5 秒之间随机休眠
delay = random.uniform(1.5, 3.5)
print(f"等待 {delay:.2f} 秒...")
time.sleep(delay)优点:严格限定了最小等待时间与最大等待时间,既能保证请求间隔不低于防封阈值,又不会因为极值导致爬虫无限制停顿,计算开销极低。
2. 三角分布延时:random.triangular(low, high, mode)
均匀分布在区间内的每个时间点被选中的概率是完全相等的。然而在真实人类操作中,翻页间隔往往存在一个“偏好中心”。例如读者平均 2 秒翻一次页,极少数情况 1 秒就点,偶尔停顿 4 秒。此时三角分布更符合实际规律:
# low=1.0, high=4.0, mode=2.0 (众数偏向2秒)
delay = random.triangular(1.0, 4.0, 2.0)
time.sleep(delay)
3. 正态分布(高斯分布)延时:random.gauss(mu, sigma)
自然界和人类行为的大多数特征符合正态分布。以均值 mu 为中心,标准差 sigma 决定离散程度。需要注意的是,高斯分布理论上有可能生成负数或异常大值,因此在爬虫中使用时必须进行边界截断:
# 期望延时 2.5 秒,标准差 0.8 秒,下限保护 1.0 秒,上限保护 5.0 秒
raw_delay = random.gauss(2.5, 0.8)
safe_delay = max(1.0, min(5.0, raw_delay))
time.sleep(safe_delay)
4. 离散档位加权随机:random.choices(population, weights)
在模拟复杂的业务场景(例如用户在搜索列表快速浏览,但隔几页会点进某个详情页停留更久)时,可以通过加权随机模拟不同的阅读状态:
# 80% 概率快速浏览(1~2秒),20% 概率仔细浏览(4~7秒)
delays = [random.uniform(1.0, 2.0), random.uniform(4.0, 7.0)]
delay = random.choices(delays, weights=[0.8, 0.2])[0]
time.sleep(delay)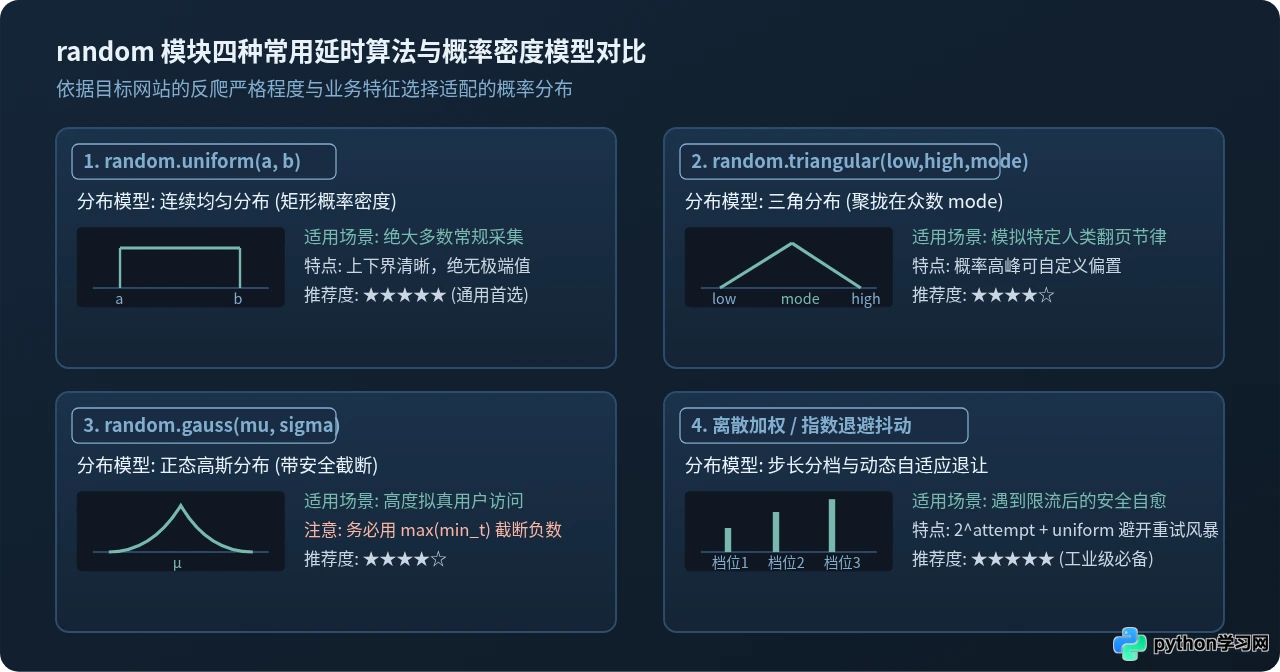 图 2:Python random 模块中不同延时算法的概率分布与适用场景
三、实战编码:构建可落地的随机延时爬虫请求器
在实际工程中,不能单纯在循环末尾随意写一行 sleep,而应该将“请求前随机延时”、“请求后状态检测”以及“遇阻退避抖动”封装为标准化的请求组件。以下给出可以直接在项目中落地的完整代码示例:
1. 基础实战:批量分页抓取的随机延时循环
在这个示例中,我们模拟爬取 5 个分页,每次请求前生成 1.5 到 3.5 秒之间的随机延时:
import time
import random
import requests

def crawl_pages(page_list):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    for page in page_list:
        url = f"https://httpbin.org/get?page={page}"

        # 1. 计算本次请求的随机延时(均匀分布)
        delay = round(random.uniform(1.5, 3.5), 2)
        print(f"[Page {page}] 准备发起请求,随机休眠 {delay} 秒...")
        time.sleep(delay)

        try:
            response = requests.get(url, headers=headers, timeout=10)
            if response.status_code == 200:
                print(f"[Page {page}] 请求成功,状态码: {response.status_code}")
            else:
                print(f"[Page {page}] 遇到非200状态: {response.status_code}")
        except requests.exceptions.RequestException as e:
            print(f"[Page {page}] 请求异常: {e}")

# 示例调用
crawl_pages([1, 2, 3, 4, 5])2. 工业级进阶:带指数退避抖动(Exponential Backoff with Jitter)的健壮请求器
在面对有严格风控的系统时,即使配置了平时的随机延时,也可能偶尔因为短时间内全站流量激增而命中 429 Too Many Requests。此时如果立即盲目重试,会瞬间将临时封禁升级为永久封禁。标准解法是指数退避结合全抖动(Full Jitter):
import time
import random
import requests
class RobustCrawlerSession:
def __init__(self, base_delay_range=(1.2, 3.0), max_retries=3):
self.base_min, self.base_max = base_delay_range
self.max_retries = max_retries
self.session = requests.Session()
self.session.headers.update({
"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
"Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
"Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
})
def request_with_delay(self, url):
# 1. 正常请求前的基础随机延时
normal_delay = random.uniform(self.base_min, self.base_max)
time.sleep(normal_delay)
# 2. 异常重试与指数退避循环
for attempt in range(self.max_retries + 1):
try:
resp = self.session.get(url, timeout=12)
# 遇到 429 (限流) 或 503 (服务端过载),执行退避
if resp.status_code in (429, 503):
if attempt == self.max_retries:
print(f"[Fail] 达到最大重试次数,放弃 URL: {url}")
return None
# 指数退避时间基数: 2^attempt * 2 秒,加上 [0.5, 2.5] 秒的随机抖动
backoff_base = (2 ** attempt) * 2.0
jitter = random.uniform(0.5, 2.5)
backoff_delay = backoff_base + jitter
print(f"[Warning] 收到状态码 {resp.status_code},触发第 {attempt+1} 次退避冷却,等待 {backoff_delay:.2f} 秒...")
time.sleep(backoff_delay)
continue
resp.raise_for_status()
return resp
except requests.exceptions.RequestException as err:
if attempt == self.max_retries:
print(f"[Error] 请求异常且重试耗尽: {err}")
return None
# 网络故障重试也加入随机延时
retry_wait = random.uniform(2.0, 5.0)
print(f"[Retry] 网络波动,等待 {retry_wait:.2f} 秒后重试...")
time.sleep(retry_wait)
return None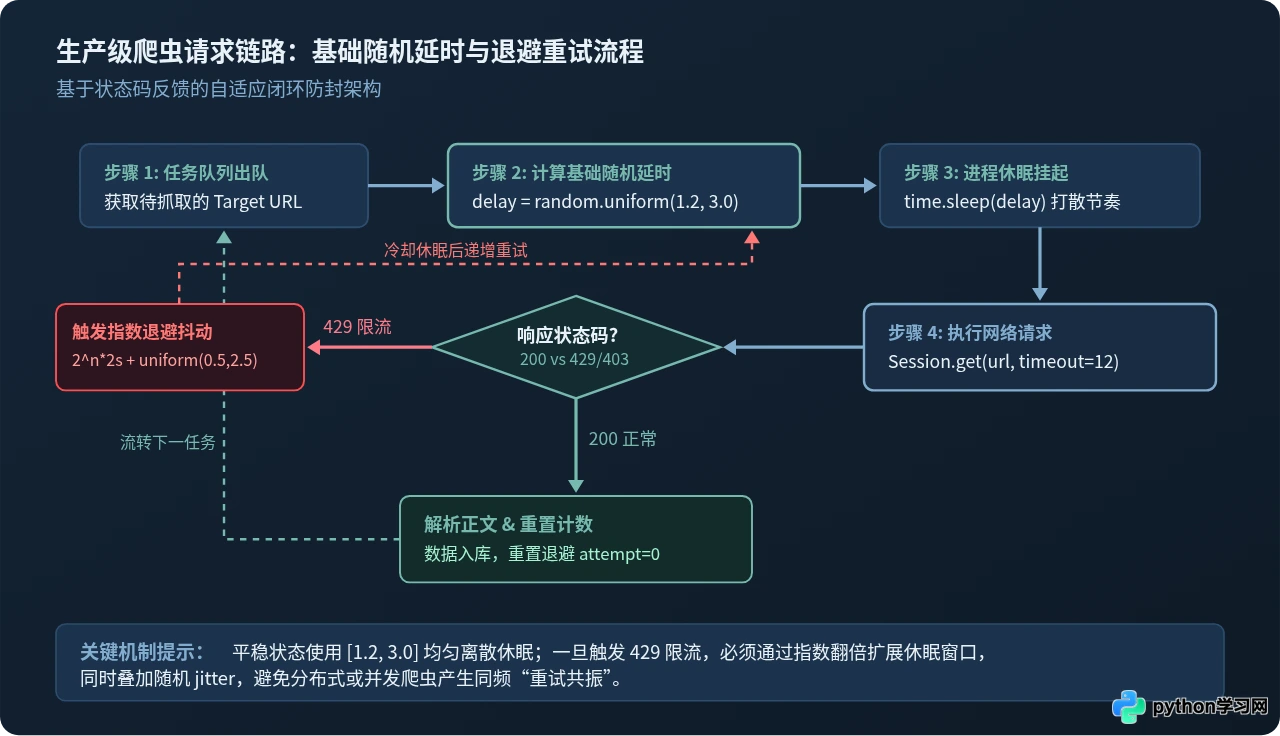 图 3:爬虫请求循环中的随机延时与自适应退避重试完整执行链路
四、进阶避坑指南与核心实战要点
在为爬虫配置随机延时时,若只做表面功夫,仍然容易踩入隐蔽的陷阱。以下是生产环境中最常见的四个避坑要点:
很多开发者虽然使用了 random.uniform(0.1, 0.5),但由于平均延时仅有 0.3 秒,折合单 IP 每秒发出 3 次以上请求。即使时间分布是随机的,但短时间内“总频次阈值”被轻易打穿,风控网关无需分析方差便能直接触发限流规则。对于常规公开页面,建议底线延时不得低于 1.0 秒。
人类用户不会连续 2 小时一秒不差地翻阅 500 页商品。如果爬虫连续跑几个小时,即便单次延时是随机的,在宏观按小时维度的请求曲线上依然是一条平直的高负载线。优化策略:引入“批次休眠机制”,例如每连续抓取 20 ~ 40 页,主动触发一次 15 ~ 30 秒的大停顿,模拟用户起身喝水或切换软件:
# 批次大延时实现范例
if page_count % random.randint(25, 35) == 0:
    batch_rest = random.uniform(15.0, 30.0)
    print(f"完成一批任务,模拟深度阅读停顿 {batch_rest:.1f} 秒...")
    time.sleep(batch_rest)
陷阱 3:在多线程或异步协程(asyncio)中误用 time.sleep
如果爬虫使用的是 asyncio 或 aiohttp,切勿在协程中调用 time.sleep(),因为这会阻塞整个 Python 事件循环,导致所有并发任务全部卡死。在异步爬虫中,必须使用 await asyncio.sleep(random.uniform(a, b))。同时要注意:如果开启了 20 个并发线程,哪怕每个线程内部都 sleep(3),在服务端视角下并发依然极高,必须配合 Semaphore 限制瞬时并发数。
陷阱 4:忽视请求指纹(Headers)的协同伪装
延时控制只是解决了“请求频率”特征,不能掩盖“请求报文”特征。如果 User-Agent 依然是 Python-requests/2.31.0,或者缺少 Accept-Language、Sec-Ch-Ua 等现代浏览器必备请求头,服务端可以在首个请求就完成识别。随机延时必须与请求头伪装配合使用。
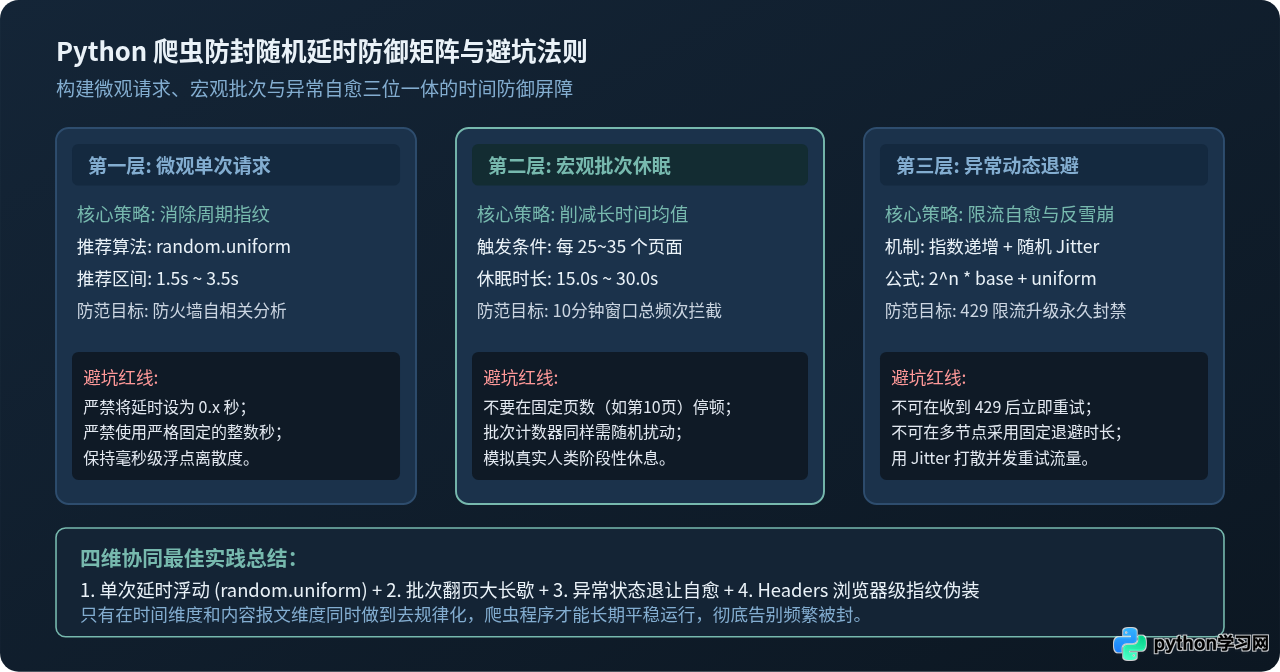 图 4:Python 爬虫防封随机延时防御矩阵与避坑法则全景总结
五、不同业务场景下的推荐延时参数对照表
不同类型和规模的网站具有不同的反爬敏感度,应根据目标接口的具体性质合理设定延时参数,平衡数据采集效率与稳定性:
| 目标场景类型 | 反爬敏感度 | 单次推荐延时 | 批次长延时设置 | 适用 random 方案 |
|---|---|---|---|---|
| 开放数据 / 政府公开公示 | 低 | 0.8s ~ 2.0s | 每 50 页休眠 8s ~ 15s | random.uniform(0.8, 2.0) |
| 常规行业资讯 / 博客论坛 | 中等 | 1.5s ~ 3.5s | 每 30 页休眠 15s ~ 25s | random.uniform(1.5, 3.5) |
| 电商商品列表 / 价格数据 | 较高 | 2.0s ~ 5.0s | 每 20 页休眠 20s ~ 40s | random.triangular(2.0, 6.0, 3.5) |
| 社交媒体 / 动态高敏接口 | 极高 | 3.5s ~ 8.0s | 每 15 页休眠 30s ~ 60s | random.gauss(5.0, 1.5) (截断保护) |
| 触发 429 后的冷却重试 | 极高 (已受限) | 2^n × 2.0s + Jitter | 视 Retry-After 头部而定 | 指数退避 + random.uniform(0.5, 2.5) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









