

Python enumerate() 内置函数详解与实战用法

发布时间:2026-10-13| 5人浏览过
本文详细解析Python内置函数enumerate()的用法。该函数用于将可迭代对象组合为索引序列,同时返回索引和对应值。文章通过代码示例演示了enumerate在for循环中的应用,包括默认从0开始索引以及通过第二个参数指定索引起始值的方法。此外,还对比了统计文件行数的传统方法与使用enumerate的高效实现,帮助开发者更优雅地处理遍历任务。
Python enumerate() 内置函数详解与实战用法
本文深入总结Python中enumerate内置函数的具体用法,通过详细的示例代码展示其核心功能,旨在为读者的学习或日常工作提供具有实际价值的参考。
- enumerate()函数概述
- enumerate()是Python语言的一个内置函数。
- 从词义上理解,enumerate意为枚举或列举。
- 针对任何可迭代对象(iterable)或可遍历对象(如列表、字符串等),enumerate()会将其组合成一个索引序列,使得用户可以同时获取元素的索引和值。
- enumerate()通常用于for循环中,以便在遍历时获取计数值。
例如,对于一个序列seq,其返回结果形式如下:
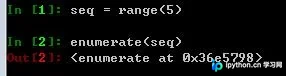
(0, seq[0]), (1, seq[1]), (2, seq[2])调用enumerate()后,返回的是一个enumerate对象,具体表现如下:
enumerate() 的实际应用场景
enumerate()的实际应用场景
当需要同时遍历列表的索引和元素时,传统的写法可能如下:
list1 = ["这", "是", "一个", "测试"]
for i in range (len(list1)):
  print i ,list1[i]
上述方法略显繁琐,使用enumerate()可以让代码更加直接且优雅:
list1 = ["这", "是", "一个", "测试"]
for index, item in enumerate(list1):
  print index, item
>>>
0 这
1 是
2 一个
3 测试
enumerate()还支持接收第二个参数,用于指定索引起始值,示例如下:
list1 = ["这", "是", "一个", "测试"]
for index, item in enumerate(list1, 1):
  print index, item
>>>
1 这
2 是
3 一个
4 测试
补充技巧:文件行数统计优化
补充技巧
若需统计文件的行数,一种常见的写法是:
count = len(open(filepath, 'r').readlines())这种方法虽然简单,但效率可能较低;当文件体积较大时,甚至可能导致程序无法正常运行。
利用enumerate()可以优化这一过程:
count = 0
for index, line in enumerate(open(filepath,'r')):
  count += 1
以上就是本文的全部内容,希望对读者的学习有所帮助,同时也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









