

Scrapy框架教程:构建高性能Python分布式爬虫系统
深入讲解基于Scrapy与Redis构建高性能Python分布式爬虫系统的完整方案,涵盖架构设计、组件改造、请求调度、指纹去重、参数压榨调优及生产高可用容灾实战。
一、单机瓶颈与分布式调度核心架构
Scrapy 原生架构是单机单进程事件驱动模型,其内部的核心组件 Engine、Scheduler 和 Downloader 均运行在同一 Python 解释器内。当单机抓取任务规模增长至数千万级时,会暴露出三个核心缺陷:
- 内存膨胀与不可共享:原生
RFPDupeFilter使用内存set保存 SHA1 请求指纹,每千万条指纹占用数百兆甚至数吉字节内存,且无法跨进程跨服务器共享; - 调度队列本地化导致无法横向扩展:单机队列位于单机内部,多台机器启动相同的代码只会造成无序的重复抓取;
- 容灾与断点续爬代价高:单机一旦断电或异常崩溃,内存队列状态难以完整恢复,极易引发大面积漏采或重采。
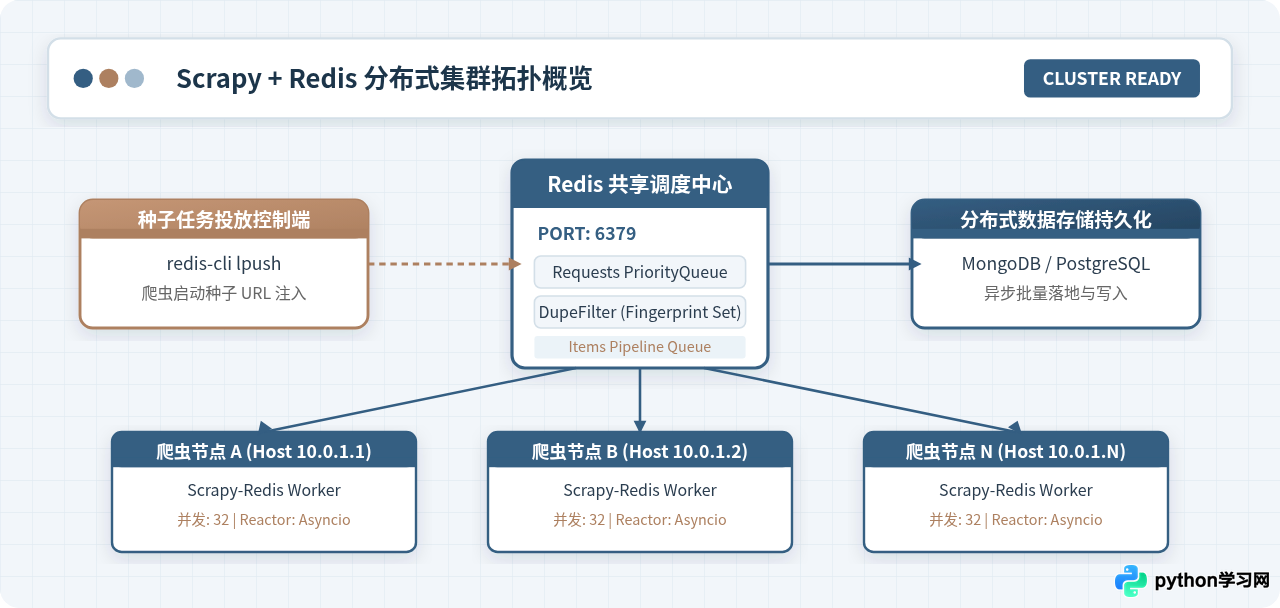
为了实现真正的分布式横向扩容,业界最成熟的标准方案是结合 Scrapy-Redis 扩展库。其核心思想是将原本运行在本地的调度队列与去重集合下沉到高性能 Redis 键值数据库中,各个 Scrapy 爬虫实例蜕变为纯粹的无状态“Worker 采集器”。
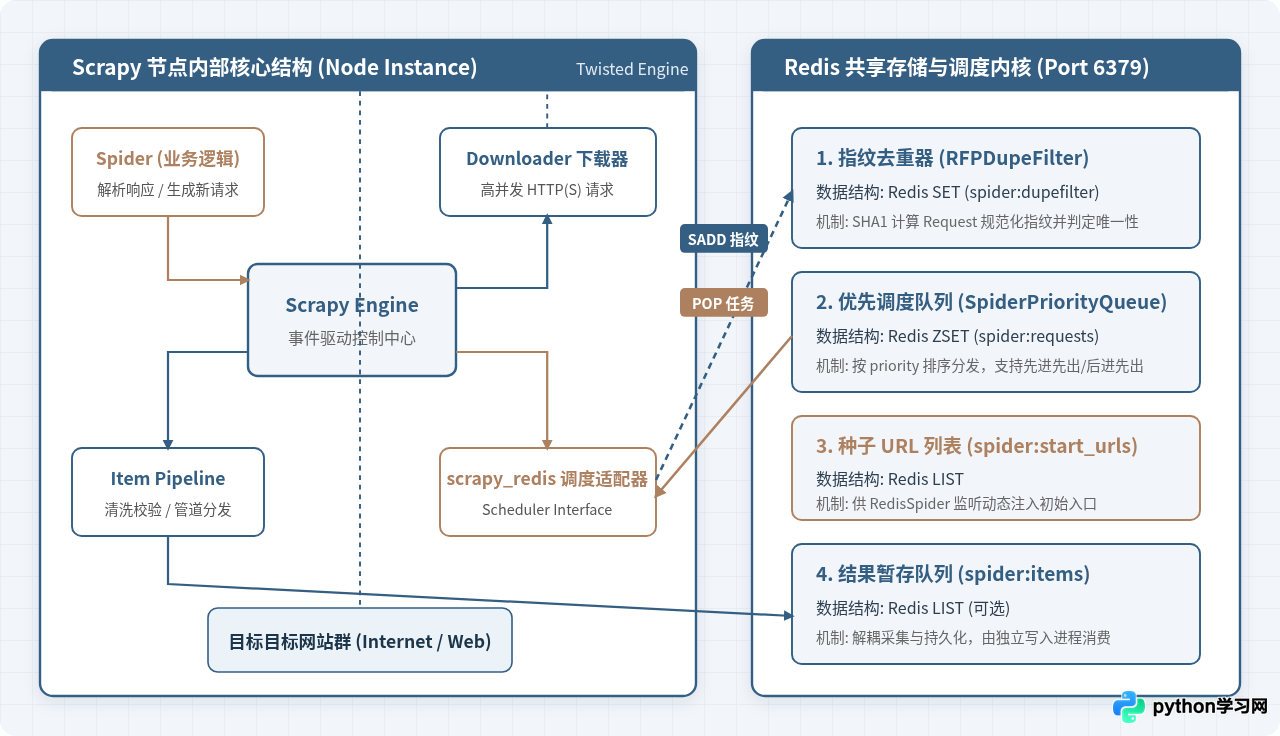
在如图 1 所示的拓扑结构中,各组件形成了紧密的分工协同:
- Redis 调度中心(Central Redis):通过
Sorted Set(有序集合)维护带优先级的待抓取请求队列,通过Set存储所有历史请求的 SHA1 指纹,充当全局唯一的真理数据源; - Scrapy-Redis 适配器(Scheduler):替换原生调度器,不再把请求压入本地内存,而是向 Redis 提交指纹校验并压入共享队列;在需要下载新任务时,原子性地从 Redis 中弹出(POP)请求;
- 爬虫工作节点(Worker Nodes):每个节点只需执行标准的页面解析、子链接提取与管道流转,随时可以动态上线或下线,具备良好的弹性伸缩能力。
二、请求生命周期与分布式指纹去重原理
理解分布式抓取的关键在于厘清一个 Request 对象在整个集群中的生命周期,特别是“去重”与“调度”发生的确切时机。
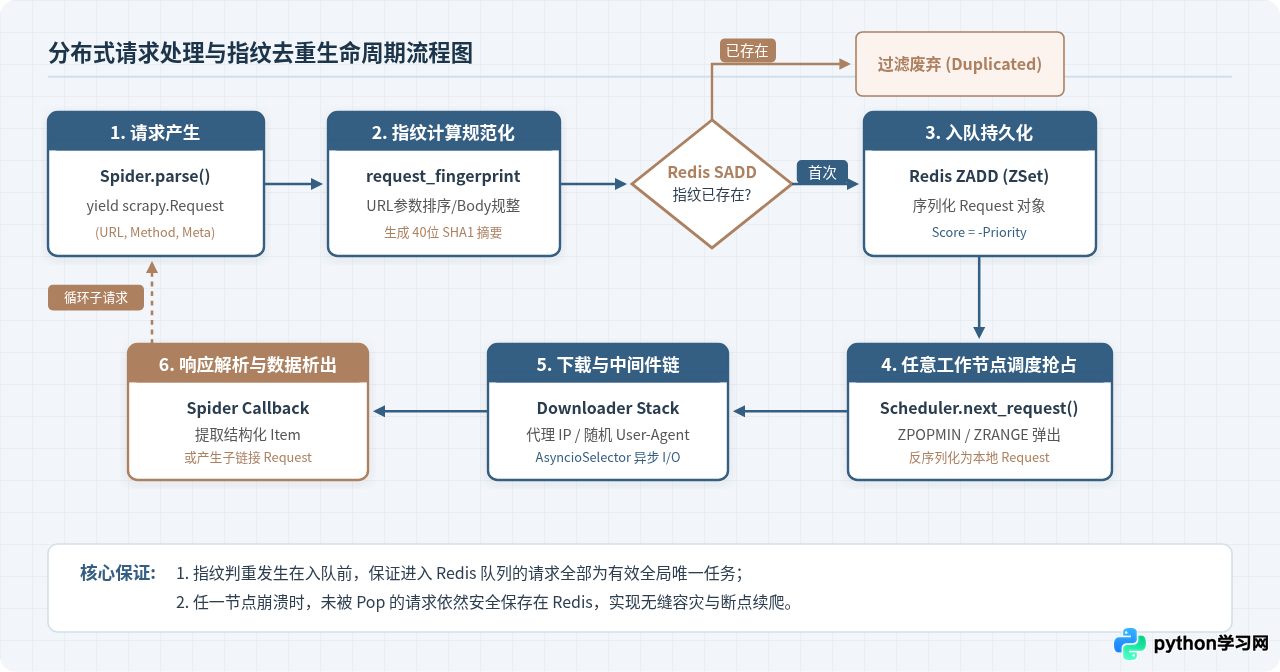
整个请求处理链路包含以下几个严格的步骤:
-
请求规范化与指纹生成:
当爬虫解析方法产出新的
Request时,Scrapy 首先调用request_fingerprint()算法。该算法会对 URL 进行规范化(如大小写规整、查询参数字典序排序)、拼接 HTTP 方法、排序并哈希请求体(Body),最终生成一段唯一的 40 位 SHA1 十六进制字符串。这确保了http://example.com?a=1&b=2与http://example.com?b=2&a=1拥有完全一致的指纹。 -
原子去重判断(SADD):
Scrapy-Redis 调用 Redis 命令
SADD <spider>:dupefilter <fingerprint>。若返回值为 1,说明该指纹之前未曾出现,属于新任务;若返回值为 0,则表明该 URL 已被处理或已在队列中,直接静默丢弃该请求(除非设置了dont_filter=True)。 -
序列化与优先级入队(ZADD):
通过去重鉴别的请求被序列化为二进制 JSON 字符串,以
-priority作为分值,通过ZADD <spider>:requests <score> <serialized_request>存入 Redis 有序集合中。分值越小越靠前,保证高优先级任务优先出队。 -
多节点竞态出队执行:
各工作节点的引擎循环调用
Scheduler.next_request(),利用原子操作从 Redis 集合头部弹出待处理请求,交由本地 Downloader 执行异步网络 I/O。
三、系统构建与代码改造实战
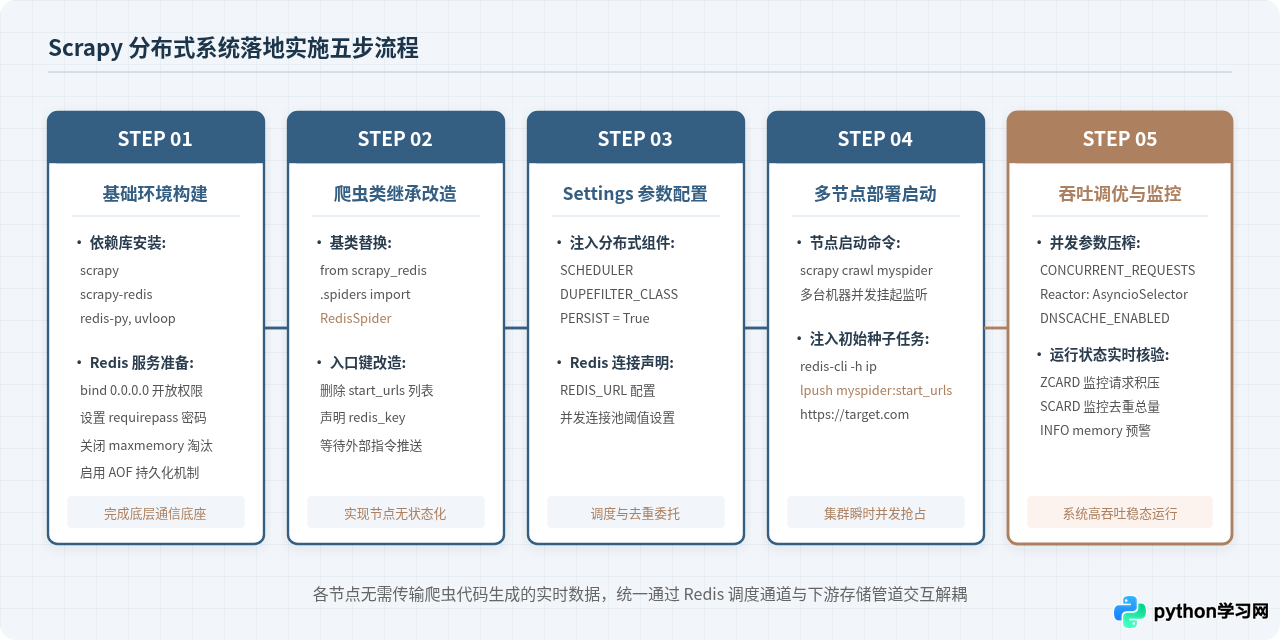
构建一套可运行的分布式爬虫,需要经过环境依赖安装、Redis 基础服务配置、爬虫基类改造与核心 settings.py 调度适配四个步骤。
1. 基础环境与依赖安装
在所有计划运行爬虫的工作节点上,执行以下命令安装核心依赖库:
# 安装 Scrapy 核心框架与 Scrapy-Redis 分布式中间件
pip install scrapy==2.11.0 scrapy-redis==0.7.3 redis==5.0.1 uvloop==0.19.0
2. Redis 服务端配置建议
在中央服务器部署 Redis 时,需要修改 redis.conf,避免生产环境常见的安全漏洞与内存意外爆仓:
# 允许跨机器访问(生产环境建议配置具体内网网段)
bind 0.0.0.0
protected-mode yes
port 6379

# 设置连接鉴权密码
requirepass YourStrongRedisPassWord!

# 严禁将内存策略设为 volatile-lru 或 allkeys-lru,避免待爬队列被静默剔除
maxmemory-policy noeviction

# 开启 AOF 持久化,确保异常掉电任务不丢失
appendonly yes
appendfsync everysec
3. 改造爬虫类(继承 RedisSpider)
在单机爬虫中,我们通常继承 scrapy.Spider 并指定静态的 start_urls。在分布式改造中,需继承 scrapy_redis.spiders.RedisSpider,并使用 redis_key 属性替换原有入口:
# spiders/distributed_product_spider.py
import json
import scrapy
from scrapy_redis.spiders import RedisSpider

class DistributedProductSpider(RedisSpider):
    name = "distributed_products"

    # 核心改造点:声明监听的 Redis 列表键名,不再硬编码 start_urls
    redis_key = "distributed_products:start_urls"

    # 可选:限制允许抓取的域名
    allowed_domains = ["quotes.toscrape.com"]

    def parse(self, response):
        """解析列表页或商品页"""
        self.logger.info(f"成功抓取来自节点响应: {response.url}")

        # 1. 抽取当前页面的数据项
        for quote in response.css("div.quote"):
            item = {
                "text": quote.css("span.text::text").get(),
                "author": quote.css("small.author::text").get(),
                "tags": quote.css("div.tags a.tag::text").getall(),
                "source_url": response.url
            }
            yield item

        # 2. 抽取下一页链接并生成新 Request
        next_page = response.css("li.next a::attr(href)").get()
        if next_page is not None:
            yield response.follow(next_page, callback=self.parse)
4. settings.py 关键参数适配
在项目的 settings.py 中,必须将 Scrapy 的调度器、去重类与管道替换为 Scrapy-Redis 提供的实现,同时配置 Redis 连接凭证:
# settings.py

# 1. 启用 Scrapy-Redis 自定义的去重组件
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

# 2. 启用 Scrapy-Redis 自定义调度器
SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 3. 开启持久化存储:设置为 True 时,爬虫关闭后 Redis 中的请求队列与指纹不会被清空
SCHEDULER_PERSIST = True

# 4. 指定调度队列类型(默认使用优先队列 PriorityQueue,基于 Redis ZSet)
SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.PriorityQueue"

# 5. 配置中央 Redis 连接串(支持密码认证)
REDIS_URL = "redis://:YourStrongRedisPassWord!@10.0.1.100:6379/0"

# 6. 配置 Item 管道(可选:将抓取到的 Item 统一推入 Redis 队列以供下游消费)
ITEM_PIPELINES = {
    "scrapy_redis.pipelines.RedisPipeline": 300,
}

# 7. 序列化格式与编码
REDIS_ENCODING = "utf-8"
SCHEDULER_FLUSH_ON_START = False  # 启动时是否清空旧队列,生产环境务必保持 False
四、高性能吞吐与并发调优策略
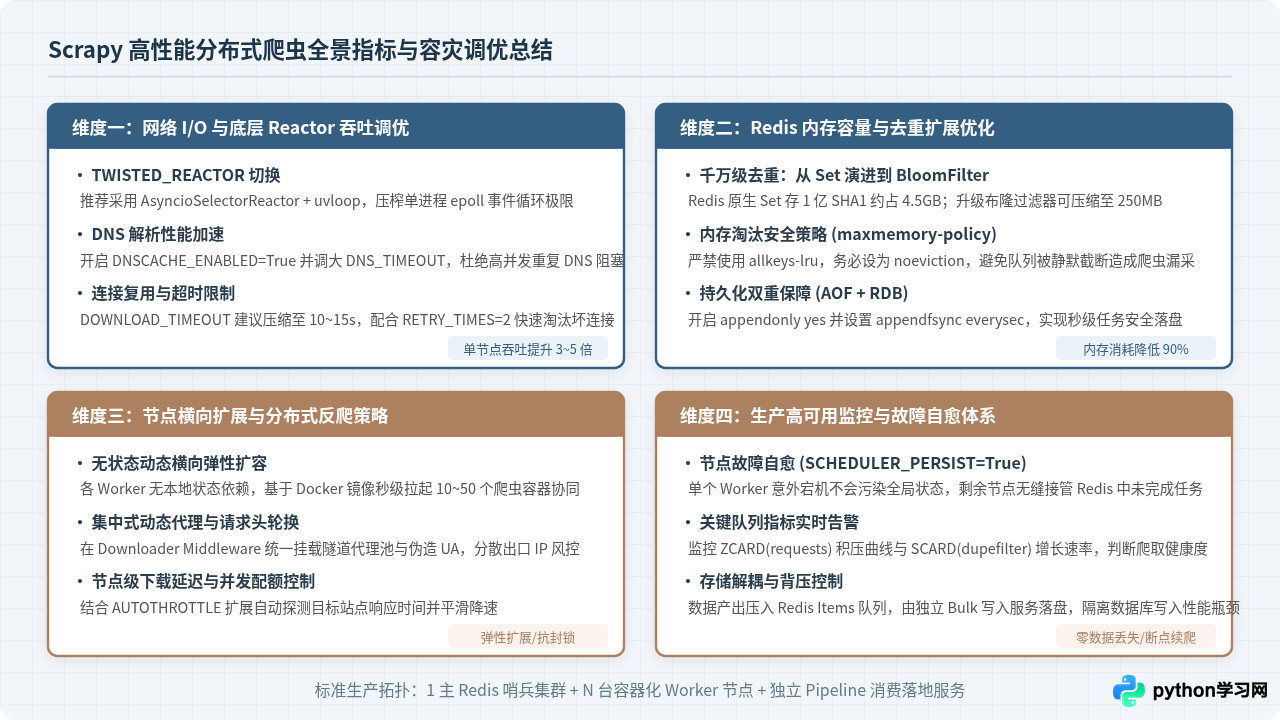
完成分布式组件接入后,若仅仅使用默认参数,系统的并发性能往往只能发挥两到三成。要使单节点和集群达到极高的吞吐效率,必须从底层事件驱动反应器(Reactor)、DNS 查询、连接池及内存开销四个维度进行精细调优。
1. 底层事件循环切换为 uvloop + AsyncioSelector
Scrapy 默认基于 Twisted 的 select 或 poll 反应器。对于高并发网络 I/O 密集型任务,推荐在 settings.py 显式指定基于标准库 asyncio 的反应器,并挂载 C 语言级别实现的 uvloop,单进程的并发事件处理能力可提升数倍:
# settings.py
TWISTED_REACTOR = "twisted.internet.asyncioreactor.AsyncioSelectorReactor"

# 在爬虫入口安装 uvloop (例如项目 __init__.py 或启动脚本中)
# import uvloop
# uvloop.install()
2. 消除高并发下的 DNS 解析阻塞
在抓取海量目标网页时,频繁向系统底层发起同步或异步 DNS 解析会造成严重的线程池挂起和延迟毛刺。Scrapy 内置了内存级 DNS 缓存系统,应在 settings.py 中予以启用并调整缓存窗口:
# settings.py
# 开启 DNS 缓存
DNSCACHE_ENABLED = True
# 延长 DNS 缓存有效时间(单位:秒)
DNSCACHE_SIZE = 10000
DNS_TIMEOUT = 5
3. 并发参数与连接超时压榨
根据目标网站的承载能力及出口网络带宽,合理配置并发度与连接超时,避免单个假死连接霸占并发槽位:
# 全局最大并发请求数(根据机器 CPU 与带宽建议设为 32 ~ 128)
CONCURRENT_REQUESTS = 64

# 单域名并发上限
CONCURRENT_REQUESTS_PER_DOMAIN = 32

# 下载超时时间大幅压缩(默认 180s 极易造成槽位堆死,建议缩短为 10~15s)
DOWNLOAD_TIMEOUT = 12

# 重试次数限制
RETRY_TIMES = 2
RETRY_HTTP_CODES = [500, 502, 503, 504, 408]

# 禁用默认 Cookie 处理(如果不需要维持用户会话,可显著降低内存占用与解析消耗)
COOKIES_ENABLED = False

# 禁用重定向(按需关闭,避免被恶意见底重定向循环消耗)
REDIRECT_ENABLED = True
REDIRECT_MAX_TIMES = 3
4. 千万级 URL 去重下的 Redis 内存优化(Bloom Filter)
Scrapy-Redis 默认采用 Redis SET 存储完整的 40 位 SHA1 字符串。当抓取规模达到 1 亿条 URL 时,仅去重集合就要占用约 4.5 GB 的 Redis 内存。
在超大规模场景下,建议将去重器替换为基于 Redis 布隆过滤器(Bloom Filter)的扩展实现。布隆过滤器通过多个哈希函数对比特位进行标记,以微小且可接受的误判率(如 0.01%)为代价,可将 1 亿条数据的内存占用从 4.5 GB 骤降至 240 MB 左右,节省超过 90% 的昂贵物理内存。
五、集群部署、动态任务投放与监控验证
分布式爬虫系统部署完成后,其日常操作遵循“节点先行待命、集中动态注水、多维状态巡检”的标准模式。
1. 启动节点集群
在各个 Worker 物理机或 Docker 容器内,拉取相同的代码镜像并执行启动命令:
# 在 Node 1, Node 2, ... Node N 上分别启动爬虫
scrapy crawl distributed_products
启动后,控制台会输出提示信息:
[scrapy_redis.spiders] INFO: Reading start URLs from redis key 'distributed_products:start_urls' (batch size: 16)
[scrapy_redis.scheduler] INFO: Resuming to crawl 0 requests from redis...
[scrapy.core.engine] INFO: Spider opened
此时,所有节点因尚未收到种子 URL 而处于休眠监听状态,无任何无效网络请求产生。
2. 动态投放初始种子 URL
运维人员或调度调度平台只需向中央 Redis 的 redis_key 列表中推送一条或多条目标 URL:
# 登录中央 Redis 主机执行
redis-cli -h 10.0.1.100 -p 6379 -a "YourStrongRedisPassWord!" lpush distributed_products:start_urls "http://quotes.toscrape.com/page/1/"
指令执行后,其中一个空闲 Worker 节点会在瞬间通过 LPOP 提取该种子任务并解析出后续分页,生成的大量子请求进入 Redis requests 优先队列,其余 Worker 节点立即被唤醒,集群开始满载并发运转。
3. 核心运行指标验证与排查指令
在集群运行期间,可以通过以下关键 Redis 指令直观评估系统运行水位:
| 监控维度 | Redis 查询命令 | 工程含义与正常判断依据 |
|---|---|---|
| 待爬请求积压 | ZCARD distributed_products:requests |
当前队列中排队的待抓取任务数。若持续攀升表明下游抓取节点吞吐不足,需扩容 Worker。 |
| 去重总量累计 | SCARD distributed_products:dupefilter |
历史已判重的总 URL 数量,该数值平稳增长反映系统正在健康去重。 |
| 种子输入积压 | LLEN distributed_products:start_urls |
等待分发的外部入口数量,通常应迅速降为 0,若积压需排查爬虫节点是否存活。 |
| 内存占用水位 | INFO memory |
观察 used_memory_human,确保内存消耗远离服务器物理上限与 maxmemory。 |
六、生产环境常见故障排查指南
在实际生产环境中,分布式爬虫经常面临复杂的网络和资源环境,以下是四类最高频的故障原因及排查方案:
-
故障表现 1:启动后爬虫立刻退出(Spider closed finished)
排查与解决:检查爬虫类是否错误继承了scrapy.Spider而非RedisSpider;若继承无误,检查settings.py中的SCHEDULER是否配置正确。原生调度器检测到start_urls为空时会默认立即关闭爬虫。 -
故障表现 2:推送种子后节点无任何反应
排查与解决:核对lpush的键名与代码中的redis_key是否完全一致(区分大小写);检查 Redis 防火墙、网络策略及密码是否正确;检查REDIS_URL中的数据库编号(如/0)是否与推送时使用的库一致。 -
故障表现 3:Redis 报 OOM 错误(OOM command not allowed when used memory > 'maxmemory')
排查与解决:指纹集合或待爬队列将 Redis 内存耗尽。切勿将策略修改为allkeys-lru,否则会导致请求丢失;应立即增加 Redis 物理内存,或将RFPDupeFilter改造成布隆过滤器(BloomFilter)。 -
故障表现 4:部分节点卡死或吞吐急剧跌零
排查与解决:通常是由于目标站点启用了防爬验证码、封锁了部分节点 IP,或者是DOWNLOAD_TIMEOUT未设置导致连接挂起。应检查下载中间件中的代理 IP 轮换逻辑,并通过日志捕获 HTTP 403/429 状态码。
七、总结
构建高性能 Python 分布式爬虫系统,本质上是一套“状态外置、组件解耦、异步压榨”的工程体系。通过引入 Redis 承载调度队列与请求去重,Scrapy 各节点摆脱了单机内存与状态绑定的束缚;再辅以 Asyncio 事件循环替换、DNS 缓存优化与布隆过滤器内存压缩,能够让普通服务器集群在千万级数据采集任务中保持极高的吞吐率与容灾稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









