

Python序列的通用特征:有序性、索引与切片操作
深入解析Python序列核心特征:有序性、正负索引寻址逻辑与切片操作(start:stop:step)的规范步骤、边界截断机制与高级用法。
Python 中的序列(Sequence)是一类基础而强大的内置数据结构,包含字符串(str)、列表(list)、元组(tuple)、字节串(bytes)以及 range 对象等。虽然它们在可变性、存储内容与底层实现上各有不同,但都严格遵循序列协议,具备统一的操作接口:元素按严格顺序存放(有序性)、通过整数下标快速定位单个元素(索引操作),以及通过区间步长规则批量提取子序列(切片操作)。掌握这些通用特征与运作规则,是编写规范、高效 Python 代码的核心基本功。
一、序列的核心基石:有序性与存储模型
所谓有序性(Order),是指序列中的每个元素在内存或逻辑视图中都拥有固定的相对位置与编号。当把元素加入序列时,它的存放次序被严格保留,不会像集合(set)或早期字典那样由散列算法决定无序存放。同时,序列允许存放重复元素,且同一个值在不同下标处被视为两个独立的槽位。
Python 常见内置序列根据可变性与内部存储方式可以划分为以下几类:
- 可变序列(Mutable Sequences):以
list、bytearray为代表,支持原地修改、追加、替换和就地切片赋值。 - 不可变序列(Immutable Sequences):以
str、tuple、bytes、range为代表,创建后内部状态固定,切片或拼接操作均返回新的序列实例。 - 扁平序列(Flat Sequences):如
str、bytes,在连续内存中直接存放字符编码或二进制字节值。 - 容器序列(Container Sequences):如
list、tuple,存储的是指向任意 Python 对象的引用(指针),可以容纳异构数据。
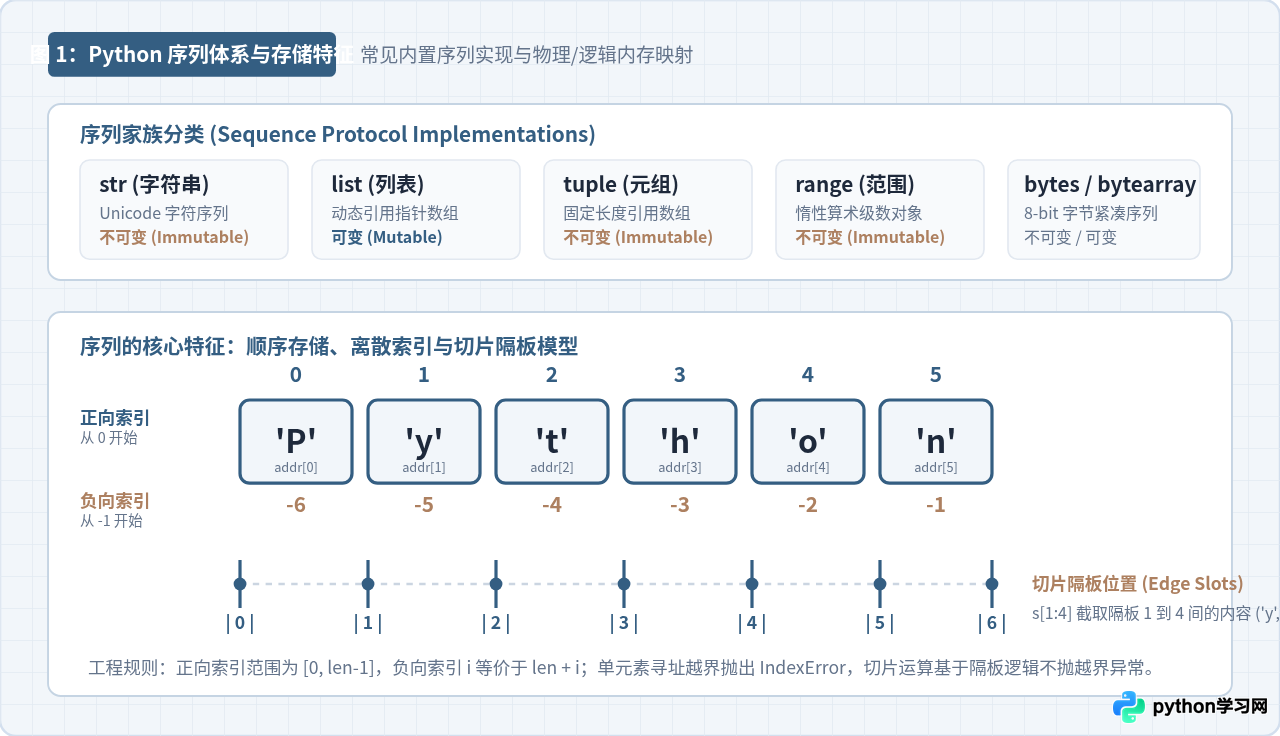
如上图所示,为了统一寻址,Python 赋予了序列双向离散索引体系:从左向右以 0 为起点的正向索引,以及从右向左以 -1 为起点的负向索引。此外,在切片视角下,Python 还可以抽象为“隔板边界模型”,即切割点位于元素之间,这从机制上解释了左闭右开区间为何能自然衔接。
二、正向与负向索引:元素精确寻址与越界防范
单元素索引访问是序列最直接的操作方式,语法为 sequence[index]。Python 在底层统一将传入的下标映射为相对于序列首地址的有效偏移量。
1. 双向索引映射机制
正向索引从 0 递增到 len(s) - 1,用于表示从序列开头数的第几个位置;负向索引从 -1 递减到 -len(s),用于快速从末尾反向回溯。在 Python 解释器执行时,如果检测到下标为负数,会自动将其转换为等价的非负坐标:
# 负索引等价转换公式
real_index = len(s) + negative_index
例如对于长度为 6 的序列 s = "PYTHON",访问 s[-1] 等价于 s[6 + (-1)] = s[5],即最后一个字符 'N';访问 s[-6] 等价于 s[6 + (-6)] = s[0],即首字符 'P'。
2. 完整代码示例:索引寻址验证
# 序列索引操作完整示例
languages = ["Python", "Go", "Rust", "TypeScript"]

# 正向索引访问
first_item = languages[0]
second_item = languages[1]

# 负向索引访问
last_item = languages[-1]
second_to_last = languages[-2]

print("正向索引[0]:", first_item)
print("正向索引[1]:", second_item)
print("负向索引[-1]:", last_item)
print("负向索引[-2]:", second_to_last)正向索引[1]: Go
负向索引[-1]: TypeScript
负向索引[-2]: Rust
单元素索引有着严格的有效区间边界约束:-len(s) <= index <= len(s) - 1。一旦传入超出该范围的数值(例如空列表访问 [][0],或 6 元素序列访问 s[6]、s[-7]),Python 会立即抛出 IndexError: list index out of range。因此在访问未知长度序列时,必须确保先校验长度或结合异常捕获。
三、切片操作规范:执行流水线与边界截断机制
如果说单元素索引是“定点提取”,那么切片(Slicing)就是“范围萃取”。切片语法的完整格式为 sequence[start:stop:step],它通过三个可选参数提取出一个由原始元素构成的新子序列。
1. 切片执行的四个规范步骤
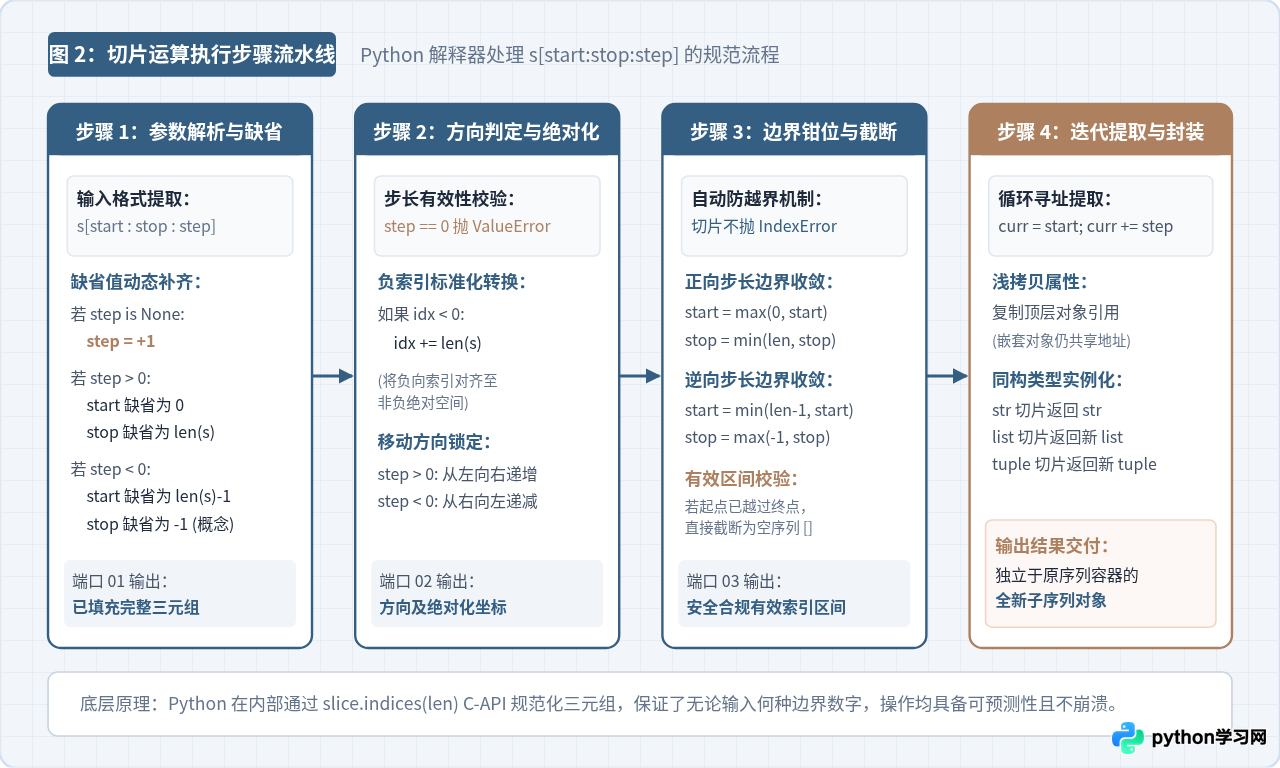
Python 解释器在接收到切片请求时,会在底层调用 C-API 规范化参数,主要执行以下四个步骤:
- 参数解析与缺省补全:检查
start、stop、step。如果step被省略(如s[1:4]),默认置为1。若step > 0,start缺省为0,stop缺省为len(s);若step < 0,start缺省为len(s)-1,stop缺省为序列头部之前的位置。 - 步长有效性校验与方向锁定:
step绝对不能为0,否则直接抛出ValueError: slice step cannot be zero。当step > 0时锁定向右正向迭代;当step < 0时锁定向左反向迭代。若存在负数坐标,按照idx += len(s)转换。 - 边界自动钳位(Clamping):这是切片与单元素索引最根本的区别。切片永远不会因为 start 或 stop 超界而报 IndexError。超出右边界的值会被自动钳制为
len(s),超出左边界的值会被自动钳制为0。如果经过钳制后起点已经越过终点,解释器安全返回空序列。 - 元素迭代与新容器封装:按计算好的步长与边界依次提取引用,并打包封装为与原序列相同类型的全新对象返回。
2. 代码示例:基础切片与边界容错
# 字符串与列表切片操作
text = "Antigravity"
print("截取前4个字符 text[:4]:", text[:4])
print("从第4个截取到第8个 text[4:8]:", text[4:8])
print("从第6个截取到末尾 text[6:]:", text[6:])

# 边界自动容错特性验证
print("远超长度的切片 text[2:100]:", text[2:100])
print("起点大于终点 text[5:2]:", text[5:2])从第4个截取到第8个 text[4:8]: grav
从第6个截取到末尾 text[6:]: avity
远超长度的切片 text[2:100]: tigravity
起点大于终点 text[5:2]:
四、步长与方向:正向切片与逆向提取的对比
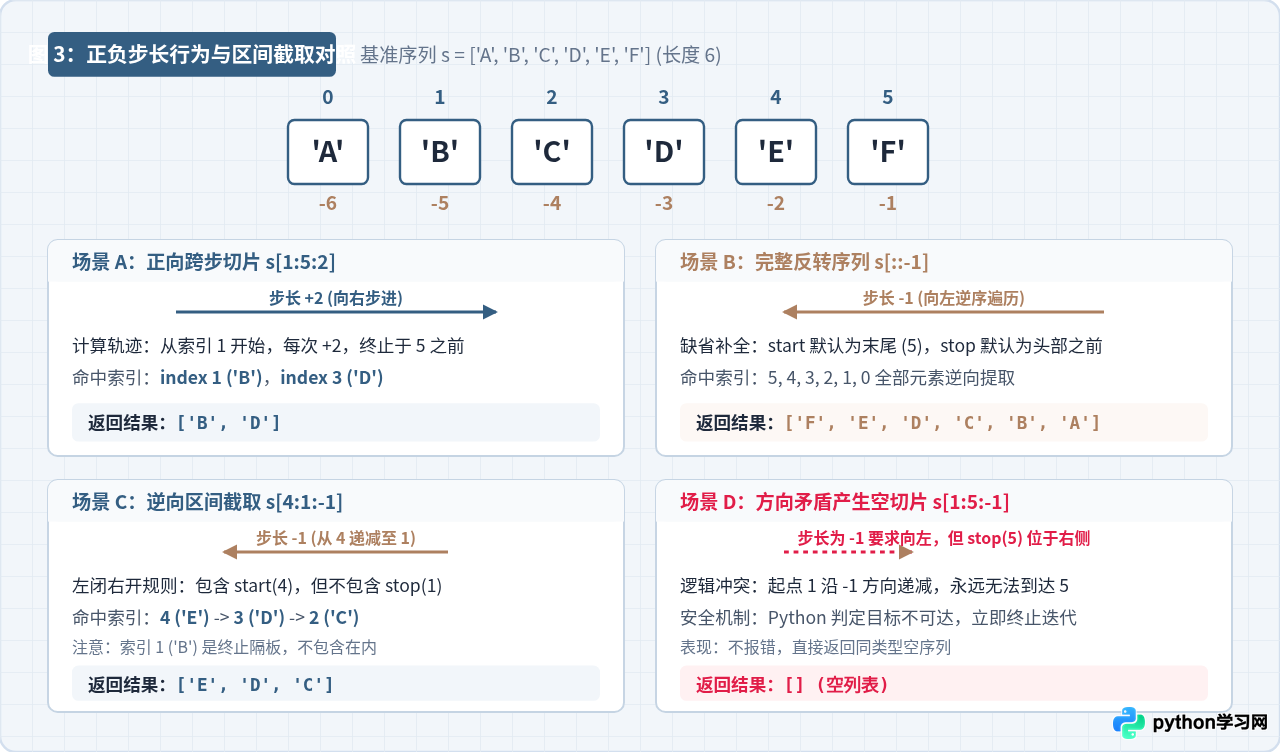
在 s[start:stop:step] 中,step 的符号具有支配性地位:它不仅决定了提取元素时的跨度,还直接决定了整个切片的行进方向。
1. 正负步长的核心计算对比
| 切片模式 | 代码示例 | 行进方向 | 闭开区间数学定义 | 典型返回值 |
|---|---|---|---|---|
| 正向等距步进 | s[1:5:2] |
从左向右 (>0) | index ∈ [1, 5),步长 2 |
['B', 'D'] |
| 整体逆序反转 | s[::-1] |
从右向左 (<0) | 从 len-1 递减到 0 |
['F', 'E', 'D', 'C', 'B', 'A'] |
| 逆向局部截取 | s[4:1:-1] |
从右向左 (<0) | index ∈ (1, 4],递减 1 |
['E', 'D', 'C'] |
| 方向矛盾切片 | s[1:5:-1] |
矛盾不可达 | 起点 1 向左递减无法到达 5 | [] (安全空列表) |
2. 典型场景代码示例
# 步长与方向操作完整演练
data = [10, 20, 30, 40, 50, 60, 70]

# 1. 偶数下标抽取 (跨步为 2)
even_indexed = data[::2]
print("偶数索引采样 data[::2]:", even_indexed)

# 2. 奇数下标抽取 (从 1 开始跨步为 2)
odd_indexed = data[1::2]
print("奇数索引采样 data[1::2]:", odd_indexed)

# 3. 序列完全反转
reversed_data = data[::-1]
print("倒序反转 data[::-1]:", reversed_data)

# 4. 逆向子区间截取 (从索引 5 倒序到索引 2,不含索引 2)
sub_reversed = data[5:2:-1]
print("逆向区间 data[5:2:-1]:", sub_reversed)奇数索引采样 data[1::2]: [20, 40, 60]
倒序反转 data[::-1]: [70, 60, 50, 40, 30, 20, 10]
逆向区间 data[5:2:-1]: [60, 50, 40]
五、高级复用与可变性:slice 对象与就地切片赋值
理解切片机制后,可以在工程开发中进一步使用 Python 提供的具名 slice 对象,以及掌握可变序列特有的切片赋值语法。
1. 命名切片:提升长代码的可读性
Python 内置了 slice([start,] stop[, step]) 构造函数。在解析固定宽度报文、日志行或特定协议帧时,直接在代码中散落硬编码数字难以维护,使用命名切片能够显著提升可读性:
# 固定宽度字段日志解析
log_line = "2026-11-01 INFO  TaskWorker_01 Completed successfully"

# 定义命名切片
DATE_SLICE = slice(0, 10)
LEVEL_SLICE = slice(11, 16)
WORKER_SLICE = slice(17, 30)

print("日期字段:", log_line[DATE_SLICE])
print("级别字段:", log_line[LEVEL_SLICE])
print("工作单元:", log_line[WORKER_SLICE])级别字段: INFO
工作单元: TaskWorker_01
2. 列表切片赋值与删除(可变序列独有)
对于 list 这一可变序列,切片不仅可以用于读取,还可以位于赋值号左侧,用于原地替换、插入或批量删除元素。被替换的部分与右侧可迭代对象的长度不需要相等:
# 列表切片就地修改
nums = [1, 2, 3, 4, 5]

# 原地替换中间区域 (长度不相等:用 3 个元素替换 2 个元素)
nums[1:3] = [20, 25, 30]
print("切片赋值后 nums:", nums)

# 原地清空指定区间
nums[2:5] = []
print("切片清空后 nums:", nums)

# 原地切片插入 (不覆盖任何元素,在索引 1 处插入)
nums[1:1] = [999]
print("切片插入后 nums:", nums)切片清空后 nums: [1, 20, 5]
切片插入后 nums: [1, 999, 20, 5]
执行 copy_list = original[:] 会生成原列表的一个全新浅拷贝副本。顶层容器是独立的,但若列表中包含嵌套可变对象(如嵌套列表、字典),切片创建的新容器仍然持有对原嵌套对象的相同引用。若需彻底隔离深层结构,应使用 copy.deepcopy()。
六、序列操作速查与决策总结
为了在实际开发中快速选用合适的切片与索引手段,下图梳理了常见的需求决策路径与惯用表达式:
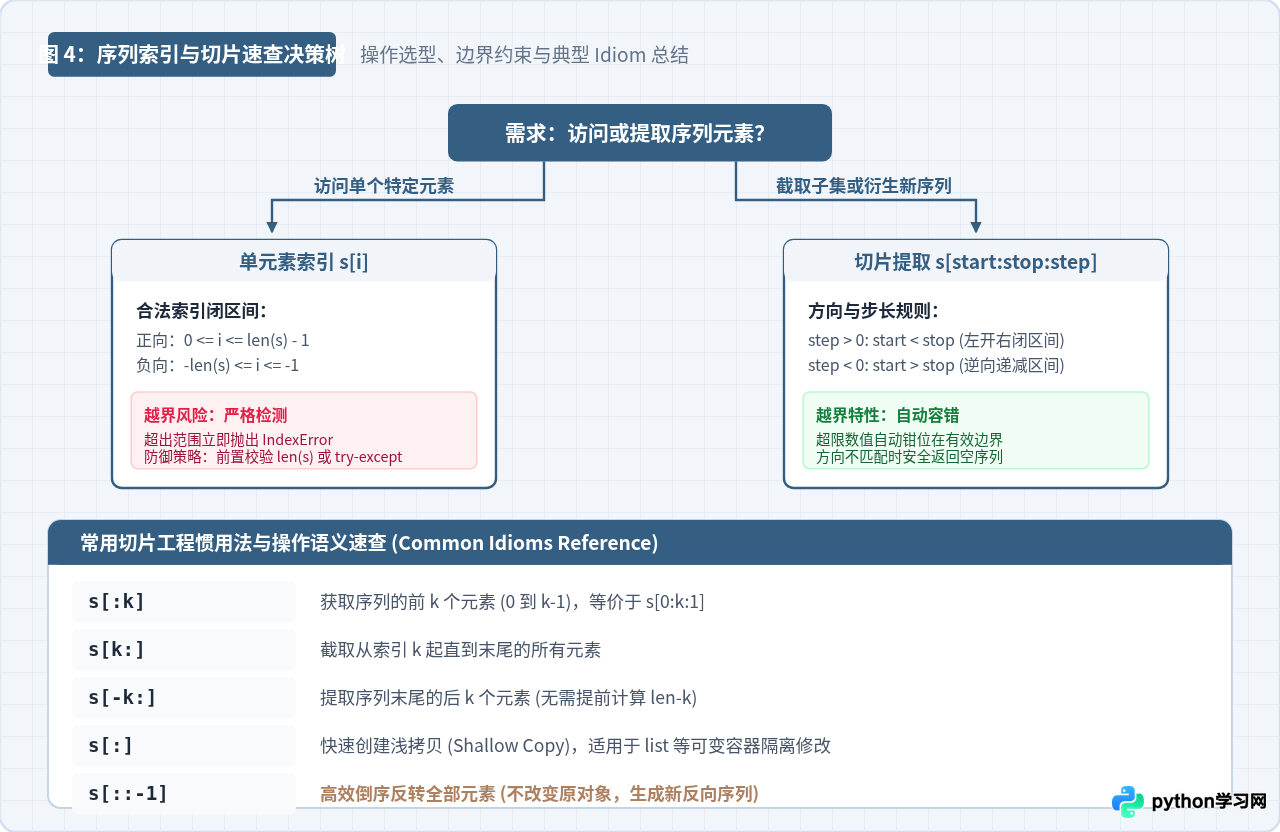
回顾全文,Python 序列之所以表现出高度的一致性与优雅性,正是建立在以下三个关键设计之上:
- 有序存储:保证每个槽位具有确定的先后顺序,构成双向整数索引的物理与逻辑基础;
- 离散与隔板双重视角:单元素访问依据离散下标,严格校验边界以避免逻辑漏洞;区间切片基于隔板切割,采用左闭右开与自动边界钳位,最大程度提升代码容错性;
- 步长支配方向:正负步长决定了数据流的行进方向与递增/递减逻辑,结合缺省补齐规则赋予了切片极其紧凑的语法表达能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









