

Python SciPy数值积分计算方法与代码实现
详细介绍Python SciPy库中数值积分的常用方法,包括一重积分quad、多重积分dblquad、离散数据积分trapezoid等函数的使用方法与完整代码示例。
在科学计算中,许多积分没有封闭的解析解,或者我们拿到的数据本身就是一组离散采样点。这时就需要用数值方法近似计算积分值。Python的SciPy库在 scipy.integrate 模块中提供了一套成熟的数值积分工具,从最常见的一重定积分到多重积分、离散数据积分,只需几行代码就能完成。本文逐一介绍这些方法的原理、调用方式和完整代码示例。
准备工作
使用前需要安装SciPy。如果尚未安装,在终端执行:
pip install scipy numpy本文所有示例基于Python 3.8+和SciPy 1.7+。在脚本开头统一导入:
import numpy as np
from scipy import integrate
一重定积分:quad函数
quad 是SciPy中最核心的积分函数,用于计算一元函数在给定区间上的定积分。它内部采用自适应Gauss-Kronrod求积法,能够自动调整采样密度以满足精度要求。
基本用法
假设要计算 ∫₀¹ x² dx,解析结果为 1/3 ≈ 0.3333。用 quad 只需这样写:
from scipy.integrate import quad

def f(x):
    return x ** 2

result, error = quad(f, 0, 1)
print(f"积分结果: {result:.10f}")
print(f"误差估计: {error:.2e}")
示例输出:
积分结果: 0.3333333333
误差估计: 3.70e-15
quad 返回两个值:第一个是积分的近似值,第二个是绝对误差的估计。可以看到误差极小,精度非常高。
处理无穷积分
积分上下限可以设为 np.inf 或 -np.inf。例如计算高斯函数在整个实数轴上的积分 ∫₋∞⁺∞ e⁻ˣ² dx = √π:
result, error = quad(lambda x: np.exp(-x**2), -np.inf, np.inf)
print(f"积分结果: {result:.10f}")
print(f"sqrt(pi) = {np.sqrt(np.pi):.10f}")
示例输出:
积分结果: 1.7724538509
sqrt(pi) = 1.7724538509
传递额外参数
被积函数常常包含参数。通过 args 关键字可以把额外参数传递进去,不需要使用全局变量或闭包。例如计算 ∫₀¹ a·sin(b·x) dx:
def g(x, a, b):
    return a * np.sin(b * x)

result, error = quad(g, 0, 1, args=(2, np.pi))
print(f"积分结果: {result:.6f}")
示例输出:
积分结果: 1.273240
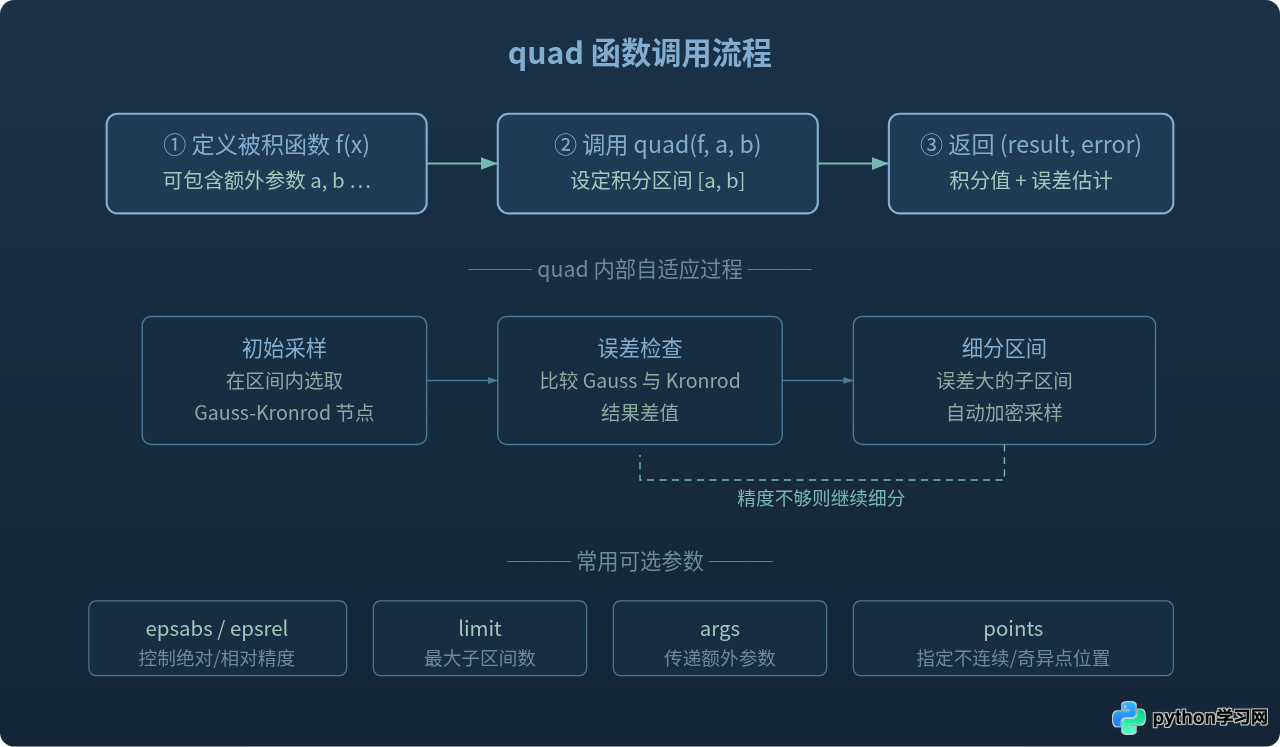
图1:quad函数的调用流程与自适应积分内部机制
多重积分:dblquad与tplquad
对于二重和三重积分,SciPy分别提供了 dblquad 和 tplquad。它们通过反复调用一维积分来完成嵌套积分。
二重积分示例
计算 ∫₀¹ ∫₀¹ (x² + y²) dx dy,解析结果为 2/3 ≈ 0.6667:
from scipy.integrate import dblquad

def integrand(y, x):
    return x**2 + y**2

result, error = dblquad(integrand, 0, 1, 0, 1)
print(f"二重积分结果: {result:.10f}")
print(f"误差估计: {error:.2e}")
示例输出:
二重积分结果: 0.6666666667
误差估计: 7.40e-15
dblquad 中被积函数的参数顺序是 f(y, x),y在前、x在后。这与数学书写顺序不同,使用时容易出错。积分上下限也可以是函数。例如在三角形区域 0 ≤ x ≤ 1,0 ≤ y ≤ x 上积分:
result, error = dblquad(
    lambda y, x: x * y,
    0, 1,            # x 的范围
    lambda x: 0,     # y 的下限(x的函数)
    lambda x: x      # y 的上限(x的函数)
)
print(f"三角区域积分: {result:.6f}")
示例输出:
三角区域积分: 0.041667
三重积分
tplquad 的使用类似,只是再增加一层嵌套。参数顺序为 f(z, y, x):
from scipy.integrate import tplquad

result, error = tplquad(
    lambda z, y, x: x + y + z,
    0, 1,                # x 范围
    lambda x: 0,         # y 下限
    lambda x: 1,         # y 上限
    lambda x, y: 0,      # z 下限
    lambda x, y: 1       # z 上限
)
print(f"三重积分结果: {result:.6f}")
示例输出:
三重积分结果: 1.500000
离散数据积分:trapezoid与simpson
很多场景下我们没有解析函数,只有实验或采集得到的一组离散数据点。SciPy提供了 trapezoid(梯形法)和 simpson(辛普森法)来处理这种情况。
梯形法
梯形法把相邻两个数据点之间的曲线近似为直线段,然后累加所有梯形面积。对于平滑函数和足够密集的采样点,效果已经很好:
from scipy.integrate import trapezoid

x = np.linspace(0, np.pi, 100)
y = np.sin(x)

result = trapezoid(y, x)
print(f"梯形法积分: {result:.8f}")
print(f"解析值:     {2.0:.8f}")
示例输出:
梯形法积分: 1.99983550
解析值: 2.00000000
辛普森法
辛普森法在每三个相邻点之间用抛物线拟合,精度通常高于梯形法。SciPy 1.11+ 中函数名为 simpson(旧版本名为 simps):
from scipy.integrate import simpson

x = np.linspace(0, np.pi, 101)  # 奇数个点
y = np.sin(x)

result = simpson(y, x=x)
print(f"辛普森法积分: {result:.10f}")
示例输出:
辛普森法积分: 2.0000000001
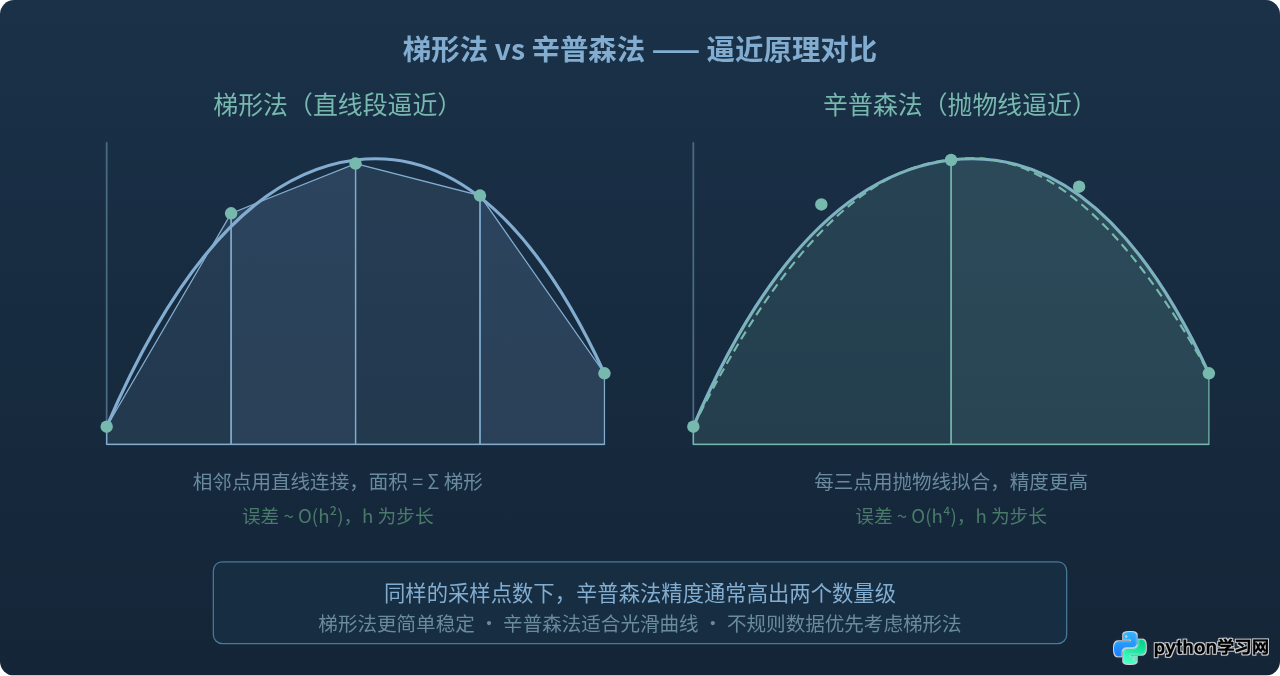
图2:梯形法与辛普森法的逼近原理对比
处理被积函数的特殊情况
被积函数有奇异点
如果被积函数在积分区间内某一点不连续或趋于无穷,quad 的 points 参数可以告诉算法在这些位置分割区间,避免采样到奇异点。例如计算 ∫₀² 1/√|x-1| dx,被积函数在 x=1 处有奇异性:
result, error = quad(
    lambda x: 1.0 / np.sqrt(abs(x - 1)),
    0, 2,
    points=[1]  # 告知 x=1 是奇异点
)
print(f"含奇异点的积分: {result:.8f}")
示例输出:
含奇异点的积分: 4.00000000
振荡积分
对于高度振荡的被积函数,quad 可能收敛较慢。可以增大 limit 参数(默认50),或使用 weight 参数指明振荡模式让算法做针对性优化:
# 高振荡函数:sin(100x) / x
result, error = quad(
    lambda x: np.sin(100 * x) / x,
    0.001, 10,
    limit=200
)
print(f"振荡积分: {result:.8f}")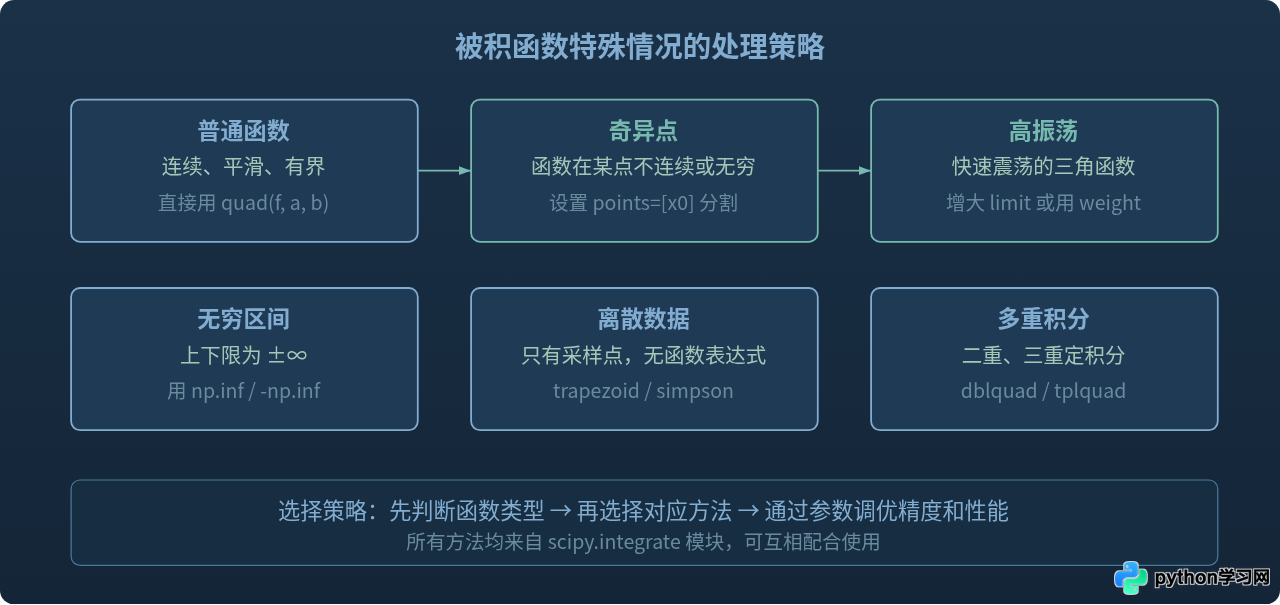
图3:不同类型被积函数的处理策略选择
实际应用:计算概率密度函数的累积分布
来看一个实际应用场景。假设某随机变量服从标准正态分布 N(0,1),我们想计算它落在某个区间内的概率,即计算概率密度函数的定积分。
from scipy.integrate import quad
import numpy as np

def normal_pdf(x, mu=0, sigma=1):
    """标准正态分布概率密度函数"""
    coeff = 1.0 / (sigma * np.sqrt(2 * np.pi))
    return coeff * np.exp(-0.5 * ((x - mu) / sigma) ** 2)

# P(-1 < X < 1),即一个标准差范围内的概率
p1, _ = quad(normal_pdf, -1, 1)
# P(-2 < X < 2)
p2, _ = quad(normal_pdf, -2, 2)
# P(-3 < X < 3)
p3, _ = quad(normal_pdf, -3, 3)

print(f"P(-1 < X < 1) = {p1:.6f}  (约 68.27%)")
print(f"P(-2 < X < 2) = {p2:.6f}  (约 95.45%)")
print(f"P(-3 < X < 3) = {p3:.6f}  (约 99.73%)")
示例输出:
P(-1 < X < 1) = 0.682689 (约 68.27%)
P(-2 < X < 2) = 0.954500 (约 95.45%)
P(-3 < X < 3) = 0.997300 (约 99.73%)
这正好验证了统计学中常用的"68-95-99.7"法则。虽然SciPy的 scipy.stats.norm 已经提供了现成的CDF函数,但用 quad 手动积分有助于理解概率密度与概率之间的关系,也适用于自定义分布。
精度控制与性能优化
quad 默认精度已经非常高(绝对容差 1.49e-8,相对容差 1.49e-8)。在某些场景下可能需要调整:
- 需要更高精度:降低
epsabs和epsrel的值,例如epsabs=1e-12 - 需要更快速度:适当放宽精度要求,例如
epsabs=1e-4,减少迭代次数 - 积分不收敛:增大
limit参数,或检查被积函数是否有未声明的奇异点
# 高精度积分
result_hp, err_hp = quad(np.sin, 0, np.pi, epsabs=1e-14, epsrel=1e-14)
print(f"高精度: {result_hp:.16f}, 误差: {err_hp:.2e}")

# 低精度快速积分
result_lp, err_lp = quad(np.sin, 0, np.pi, epsabs=1e-4, epsrel=1e-4)
print(f"低精度: {result_lp:.16f}, 误差: {err_lp:.2e}")
示例输出:
高精度: 2.0000000000000000, 误差: 1.11e-14
低精度: 2.0000000000000004, 误差: 2.22e-14
各方法对比总结
下面把本文涉及的主要积分方法做一个汇总,方便根据实际需求选择。
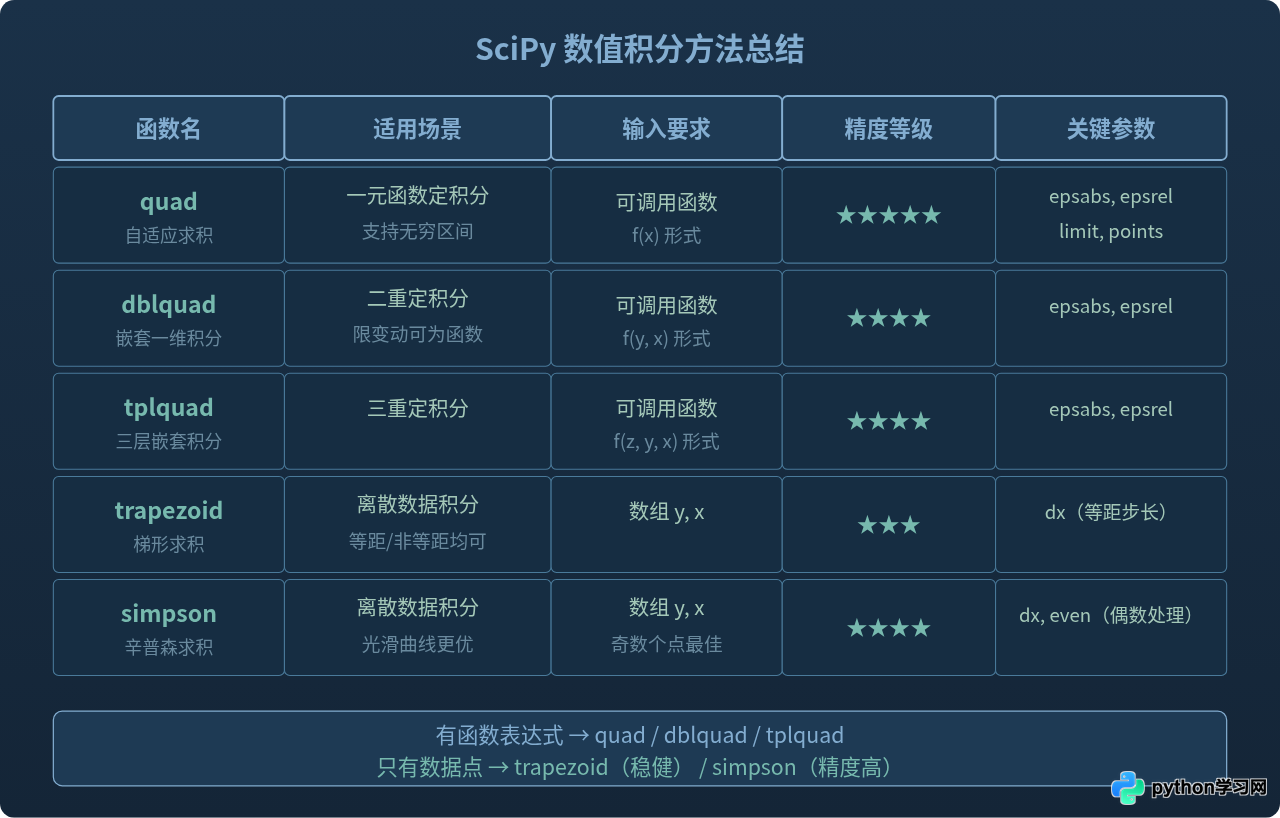
图4:SciPy数值积分方法总结对比
常见问题
quad返回了警告信息怎么办?
如果 quad 打印了类似"IntegrationWarning: The maximum number of subdivisions has been achieved"的警告,说明默认的50个子区间不够用。解决方法是增大 limit 参数,例如 limit=200。同时检查被积函数是否有奇异点需要用 points 指出。
dblquad计算太慢怎么优化?
二重和三重积分的计算量随精度要求指数增长。可以适当放宽 epsabs 和 epsrel。如果精度要求确实很高而区域是规则的矩形,也可以改用蒙特卡洛方法(比如自己写或使用第三方库)来加速。
trapezoid和simpson的精度不够怎么办?
增加采样点密度是最直接的办法。另外确认数据点之间没有缺失或异常值。如果原始信号噪声很大,可以先做平滑再积分。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









