

菜鸟教程Python 100例经典算法题解析与难点补充
深入解析菜鸟教程Python 100例经典算法题,重构过时的多层嵌套与机械平移写法,系统补充组合穷举、递推递归、数论试除与内存引用等核心难点与现代Pythonic实践。
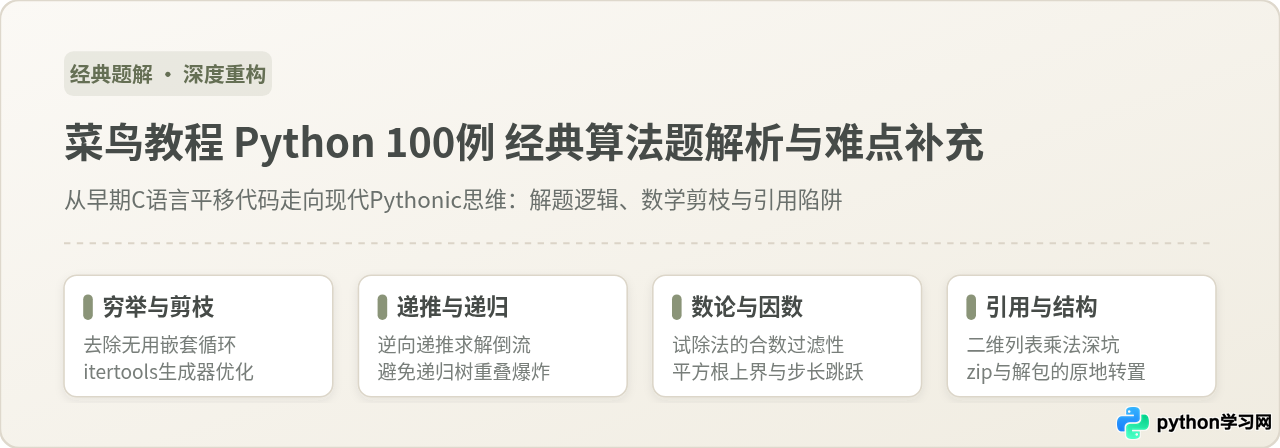
一、穷举与搜索类题目:消除无谓循环与现代化生成
在“Python 100例”的第一题中,题目要求:“有四个数字:1、2、3、4,能组成多少个互不相同且无重复数字的三位数?各是多少?”几乎所有的经典参考答案都给出了如下的三重 for 循环嵌套实现:
# 传统经典写法(例1)
total = 0
for i in range(1, 5):
    for j in range(1, 5):
        for k in range(1, 5):
            if (i != j) and (j != k) and (i != k):
                print(f"{i}{j}{k}", end=" ")
                total += 1
print(f"
总计: {total}")
传统写法的局限性分析
这种解法在直觉上容易理解,但在算法执行与工程扩展上存在明显缺陷:
- 无效迭代占比过高:整个循环空间一共迭代了
4 × 4 × 4 = 64次,但有效结果只有 24 个。多达 40 次的循环迭代在进入内层后被if条件判定直接丢弃,无效计算率高达 62.5%。 - 无法向高维扩展:如果题目将条件变为“1 到 9 选出 6 位不重复的数字”,采用嵌套循环就需要编写 6 层
for循环并维护长达数十个变量的互斥比较,代码直接失去可维护性。
现代 Pythonic 方案:itertools 迭代器
在 Python 中,无重复排列的本质是数学上的排列数 P(n, k)。标准库 itertools.permutations 采用底层 C 级状态机实现了基于字典序的高效剪枝生成,在生成过程中直接跳过重复元素分支:
import itertools

# 现代 Pythonic 解法
digits = [1, 2, 3, 4]
results = [
    int(f"{a}{b}{c}")
    for a, b, c in itertools.permutations(digits, 3)
]

print(results)
print(f"总计: {len(results)} 种")
# 示例输出: [123, 124, 132, 134, ..., 432] 总计: 24 种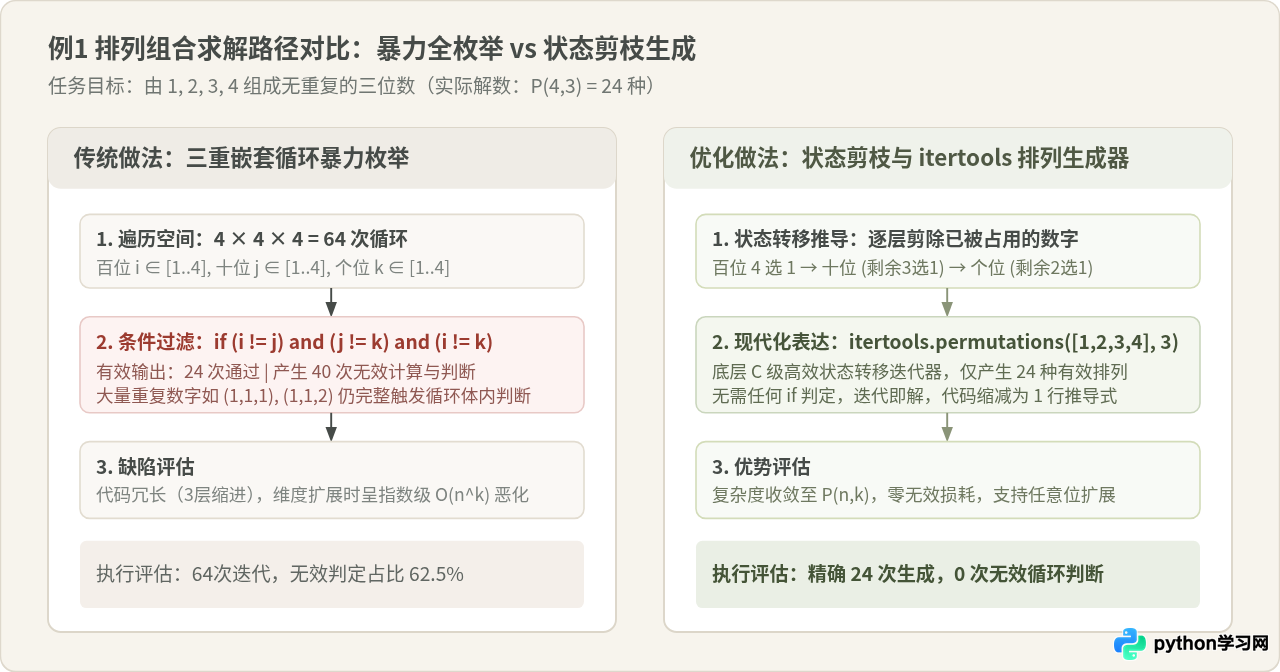
这种说法并不准确。嵌套循环由 Python 虚拟机逐条解释字节码(如 FOR_ITER、COMPARE_OP、POP_JUMP_IF_FALSE),每次循环迭代都伴随 Python 对象的属性查找与栈帧操作。而 itertools.permutations 是经过高度优化的 C 扩展,它在内部维护固定长度的索引轮转缓冲区,不仅省去了 40 次无效条件判定的开销,而且其迭代过程完全避开了 Python 解释器层面的字节码跳转,处理大规模数据时执行速度常有数倍至数十倍的提升。
二、递推与递归逻辑:逆向推导与重叠子问题优化
100 例中有大量关于“兔子生兔子”(斐波那契数列)、“猴子吃桃”以及“阶乘逆推”的题目。初学者在面对这些递推问题时,常常陷入两种极端:要么盲目使用递归导致程序崩溃,要么正向列出复杂的代数式把自己绕进死胡同。
例21 猴子吃桃问题:正向推理 vs 逆向时光倒流
题目描述:猴子第一天摘下若干个桃子,当即吃了一半,还不过瘾,又多吃了一个。第二天早上又将剩下的桃子吃掉一半,又多吃了一个。以后每天早上都吃了前一天剩下的一半零一个。到第 10 天早上想再吃时,见只剩下一个桃子了。求第一天共摘了多少个?
如果试图从第 1 天设未知数 x 正向模拟推导,第 2 天为 x/2 - 1,第 3 天为 (x/2 - 1)/2 - 1,随着天数增加,表达式会迅速形成复杂的分式嵌套。然而,从结果反推,若第 d+1 天剩余桃子数为 P[d+1],则第 d 天未吃之前的数量必为:
P[d] = (P[d+1] + 1) × 2
通过这种逆向递推模型,原本看似繁琐的代数问题缩减为一个极为直观的一重倒序循环:
# 猴子吃桃逆向递推
peaches = 1
for day in range(9, 0, -1):
    peaches = (peaches + 1) * 2
    # print(f"第 {day} 天早上原有桃子: {peaches} 个")

print(f"第一天共摘了: {peaches} 个")
# 示例输出: 第一天共摘了: 1534 个
斐波那契数列的“递归陷阱”与记忆化解法
例11(斐波那契数列)常被教材作为展示递归语法的首选范例:def fib(n): return fib(n-1) + fib(n-2) if n > 1 else n。然而,未经修饰的朴素递归会构造出一棵庞大的二叉递归树,包含海量的重复计算子问题。
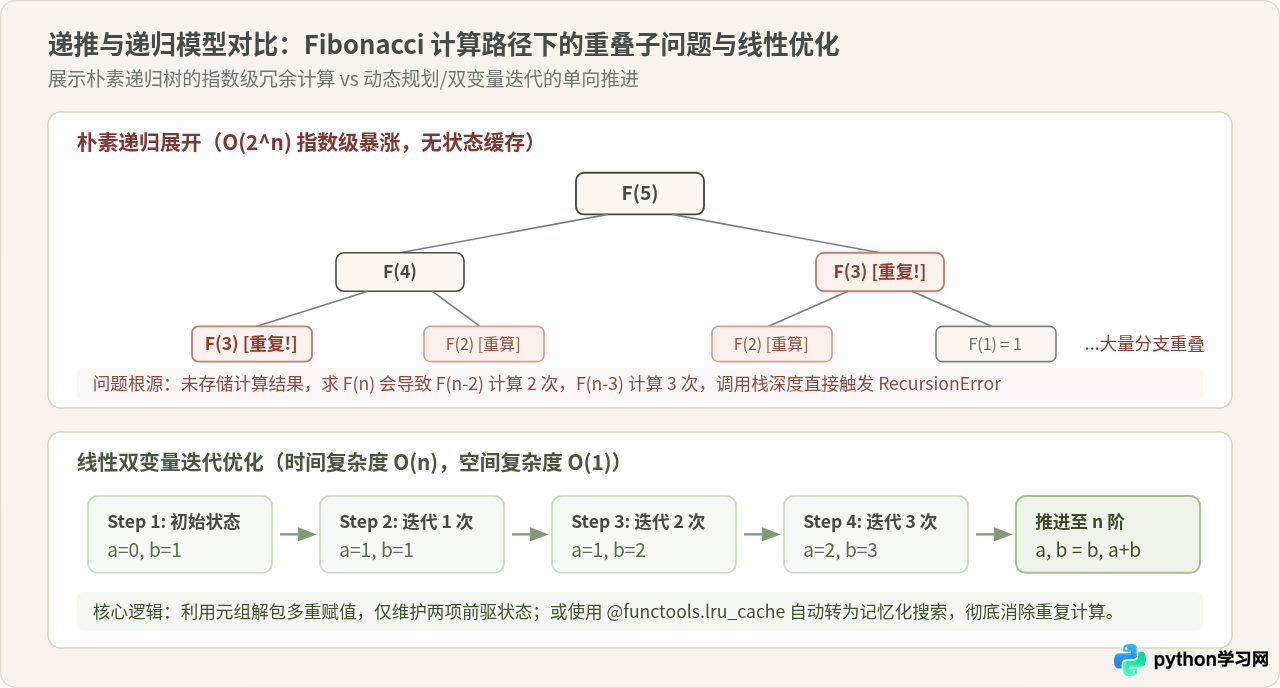
求 F(5) 时,F(3) 会被重复计算 2 次,F(2) 被重复计算 3 次。计算 F(40) 时调用次数便突破 3 亿次,计算 F(1000) 则会直接抛出 RecursionError: maximum recursion depth exceeded。
对初学者而言,掌握两种改进路径至关重要:
- 双变量滚动迭代(自底向上):只维护前两项状态,时间复杂度 O(n),空间占用 O(1)。
- 记忆化装饰器(Top-down with Memoization):保留递归代码的优雅结构,同时将已计算结果缓存至哈希表中。
import functools

# 方案 A: 经典双变量迭代(推荐工程使用)
def fib_iterative(n: int) -> int:
    a, b = 0, 1
    for _ in range(n):
        a, b = b, a + b
    return a

# 方案 B: 记忆化递归(保持递归形式,消除重复计算)
@functools.lru_cache(maxsize=None)
def fib_memo(n: int) -> int:
    if n < 2:
        return n
    return fib_memo(n - 1) + fib_memo(n - 2)

print(f"F(50) = {fib_iterative(50)}")
# 示例输出: F(50) = 12586269025
三、数论与因数类题目:试除法原理与合数过滤机制
在“Python 100例”中,例12(素数统计)、例14(质因数分解)和例19(完数求解)构成了一个完整的初等数论考察模块。其中例14是初学者提问频率极高的一道题。
例14 质因数分解:核心疑点剖析
题目要求:将一个正整数分解质因数。例如输入 90,打印出 90 = 2 * 3 * 3 * 5。经典参考代码通常是这样写的:
def prime_factors(n: int):
    print(f"{n} =", end=" ")
    k = 2
    factors = []
    while k <= n:
        if n % k == 0:
            factors.append(k)
            n //= k
        else:
            k += 1
    return factors

print(" * ".join(map(str, prime_factors(90))))
# 示例输出: 90 = 2 * 3 * 3 * 5
初学者的普遍疑问:代码中变量 k 只是单纯地执行 k += 1,也就是 k 会经历 2, 3, 4, 5, 6, 7... 其中 4 和 6 显然是合数,为什么这段代码输出的因数绝对不可能包含 4 或 6?难道不需要在前面加上一个 is_prime(k) 判断吗?
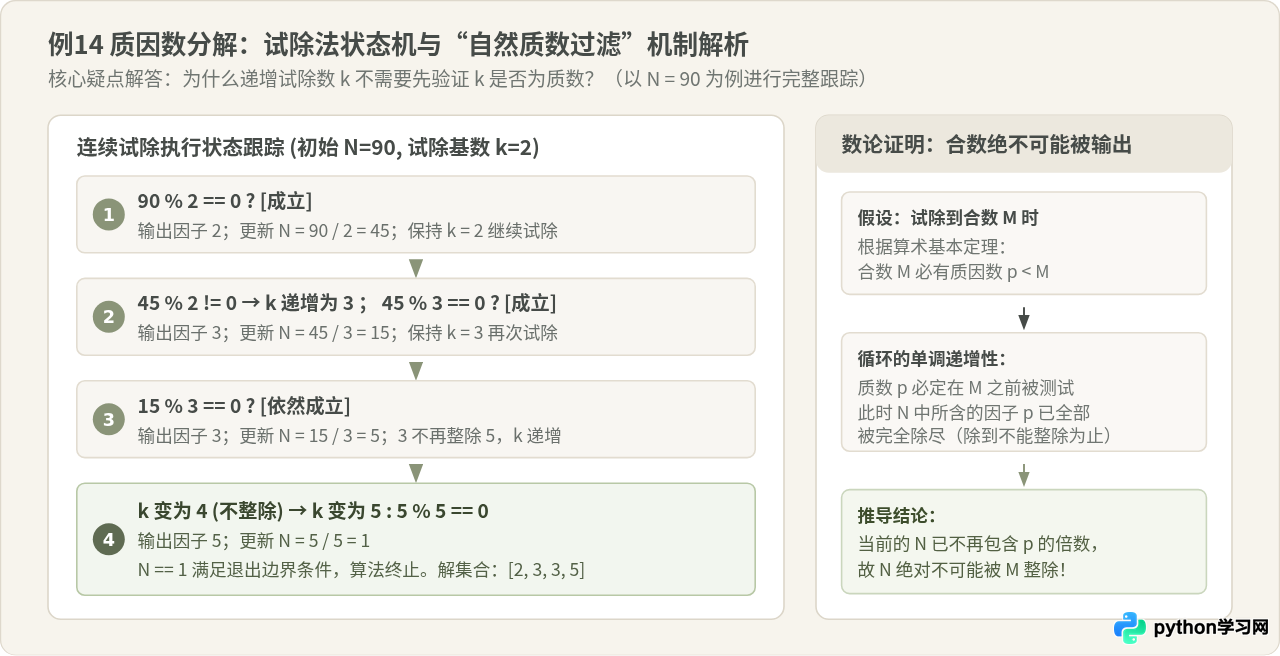
这里蕴含着算术基本定理的巧妙利用:
- 任何合数 M 都可以唯一分解为若干质数的乘积,因此 M 必定拥有一个严格小于 M 的质因数 p。
- 由于
k是从最小的质数 2 开始递增的,当n能被某个质数整除时,while循环会通过n //= k持续除尽该质数的所有重度幂次(例如 90 会连续除以 2,除到不能再整除为止)。 - 因此,当
k递增到合数(如 4)时,当前待测数字n中已经根本不包含任何 2 的因子了,自然绝不可能被 4 整除!
结论:前驱连续试除机制天然滤除了所有合数,额外增加质数判断不仅毫无必要,反而会导致算法复杂度从 O(sqrt(n)) 劣化为 O(n sqrt(n))。
例12 素数统计的判定上界补充
在判断单个数字 N 是否为素数时,初学者容易写出从 2 遍历到 N-1 的 O(N) 循环。其实如果 N 不是素数,必定存在因数分解 N = p × q,其中必有一个因数满足 p ≤ sqrt(N)。因此测试上界只需设定为 sqrt(N) 的向下取整。
import math

def is_prime(n: int) -> bool:
    if n < 2:
        return False
    if n in (2, 3):
        return True
    if n % 2 == 0 or n % 3 == 0:
        return False
    # 步长为6的跳跃试除:所有质数(除2,3外)均形如 6k ± 1
    limit = math.isqrt(n)
    for i in range(5, limit + 1, 6):
        if n % i == 0 or n % (i + 2) == 0:
            return False
    return True

primes = [x for x in range(101, 200) if is_prime(x)]
print(f"101-200之间的素数共 {len(primes)} 个")
# 示例输出: 101-200之间的素数共 21 个
四、数据容器与内存模型:避开列表浅拷贝与引用传递陷阱
100 例后半部分涉及大量多维列表、矩阵转置(例33、例44)以及元素重排操作。这是初学者在 C 语言思维向 Python 动态引用对象模型转换时最容易踩坑的领域。
致命陷阱:乘法初始化二维列表
为了初始化一个 3 × 3 的矩阵,很多初学者会写出:
# 错误示范:极具隐蔽性的浅拷贝灾难
matrix = [[0] * 3] * 3
matrix[0][0] = 99

print(matrix)
# 实际输出: [[99, 0, 0], [99, 0, 0], [99, 0, 0]]
原因解析:在 Python 中,列表内存储的并不是实际数据块,而是对象的引用指针。[0] * 3 创建了一个包含三个数字 0 的列表对象。外层的 * 3 并没有把这个子列表复制 3 份,而是把同一个子列表的引用复制了 3 次。因此,matrix[0]、matrix[1] 和 matrix[2] 指向的是内存中的同一块地址,修改其中一行,所有行都会同步变化。
正确做法是使用列表推导式,在每次外层迭代时独立构造新的子列表对象:
# 正确初始化做法
matrix_correct = [[0 for _ in range(3)] for _ in range(3)]
matrix_correct[0][0] = 99
print(matrix_correct)
# 预期输出: [[99, 0, 0], [0, 0, 0], [0, 0, 0]]
矩阵转置的现代 Pythonic 表达
在例33中,题目要求对 3 × 3 矩阵进行对角线元素交换实现转置。C 语言方式需要使用双重 for 循环并在 j > i 时临时暂存变量交换。而在 Python 中,通过 zip 配合参数解包操作符 * 可以优雅地完成任意矩形矩阵的转置:
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 经典优雅的矩阵转置
transposed = [list(row) for row in zip(*matrix)]

print(transposed)
# 示例输出: [[1, 4, 7], [2, 5, 8], [3, 6, 9]]| 对比维度 | 经典 100 例原版写法 | 现代化 Pythonic 重构写法 | 核心提升与原理 |
|---|---|---|---|
| 排列组合 | 三重嵌套 for 循环,手写多重 != 过滤 |
itertools.permutations 生成器 |
消除 62.5% 无效循环;底层 C 级高效状态转移 |
| 递推数列 | 裸递归函数,直接双分支递归展开 | 双变量迭代或 @functools.lru_cache |
将 O(2^n) 灾难优化至 O(n),避免调用栈溢出 |
| 质数与分解 | 盲目判断所有递增数,外层遍历到 N | 单调试除天然过滤合数;根号截断试除 | 严格符合算术基本定理;计算次数骤减数倍 |
| 多维容器 | 乘法浅拷贝生成列表;下标逐个手写置换 | 列表推导式隔离引用;zip(*M) 转置 |
根绝隐性引用串扰篡改;通用适配非对称矩阵 |
五、Python 100例核心算法进阶学习图谱
刷完“Python 100例”并不意味着算法能力的终点,它更应当被视为打牢程序执行感知力的跳板。下方的全景图谱归纳了从这 100 道初级练习题通向工程级算法代码的四阶认知升级模型:
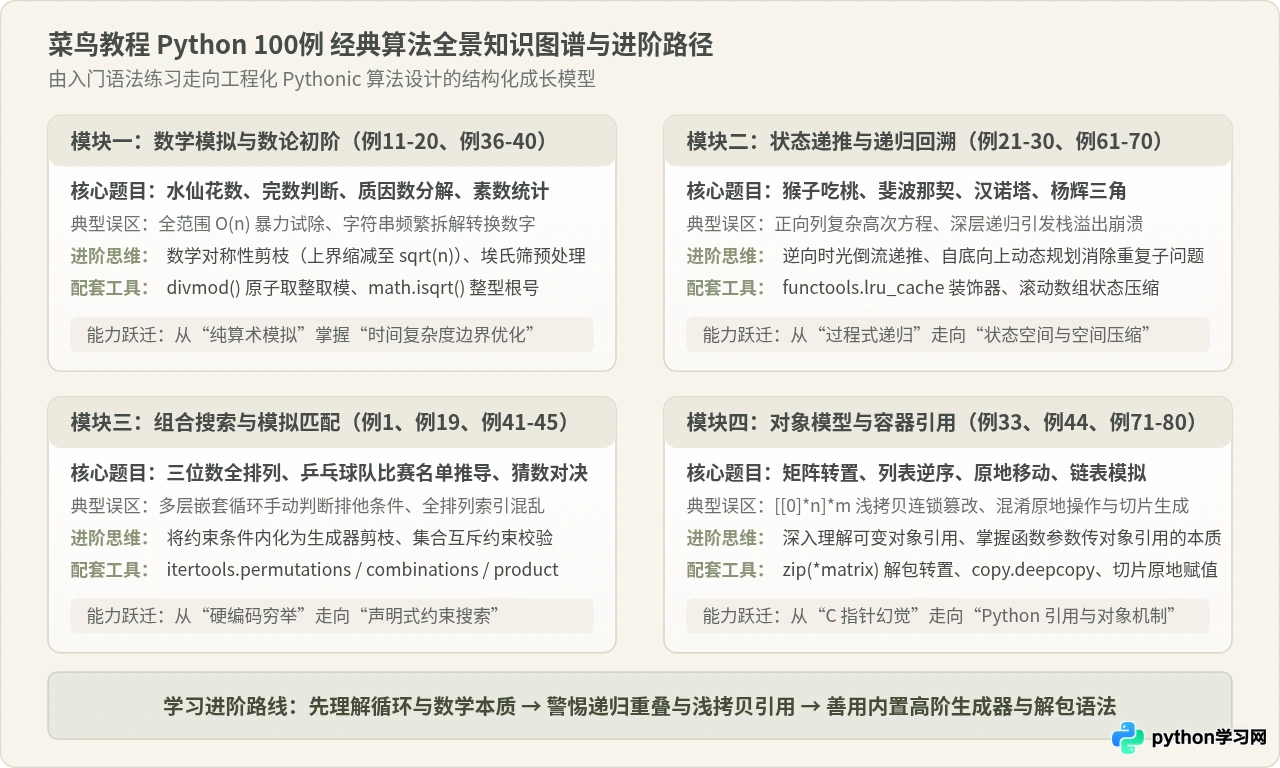
进阶自查清单
- 是否还在习惯性编写 3 层以上的嵌套循环,而忽略了
itertools的组合搜索工具? - 编写递归函数时,是否清晰界定了递归基底(Base Case),并评估了调用栈深度与重叠子问题?
- 遇到循环中的数学判定时,是否利用了对称性、奇偶性或质因数连续除尽特性来缩减检索空间?
- 在操作列表、字典等可变容器时,是否明确区分了“原地修改(In-place)”与“返回新对象(New Reference)”?
将原版“100例”中残留的面向过程平移写法,改造为充分调动 Python 语言特性的结构化代码,正是从“初学写代码”迈向“写出高效、可靠工程代码”的关键蜕变。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









