

零基础怎么快速上手Python?5个免费实战小案例边做边学
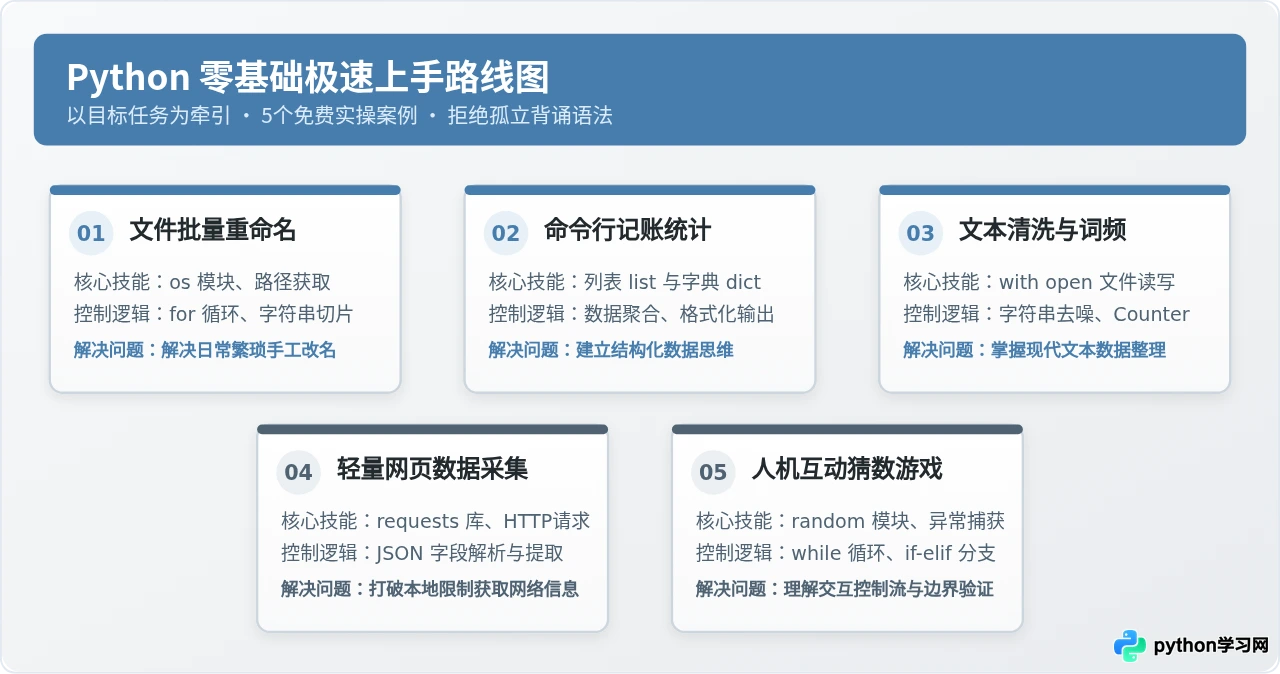
针对零基础学习者的实用Python上手路径,抛弃枯燥的语法死记硬背,通过5个完全免费、即学即用的实战小案例,带你掌握变量、循环、文件处理、第三方库调用等核心技能。
准备工作:5分钟搭建无负担开发环境
初学者最容易在环境配置环节丧失耐心。实际上,在第一阶段完全不需要安装体积庞大、配置复杂的集成开发环境。你只需要准备好 Python 官方解释器和一个轻量级文本编辑器。
- 下载与安装解释器:访问 Python 官方网站(python.org),下载对应操作系统的稳定版本。Windows 用户在安装引导界面的第一步,务必勾选底部“Add python.exe to PATH”(将 Python 添加到系统环境变量),这一步能避免后续命令行无法识别
python命令的常见问题。 - 选择编辑器:推荐使用免费的 Visual Studio Code 或系统自带的基础代码编辑器。新建一个专门存放练习代码的本地文件夹,例如
py_study。 - 验证安装成功:打开系统终端(Windows 的 CMD / PowerShell,或 macOS 的 Terminal),输入以下命令并按回车:
python --version
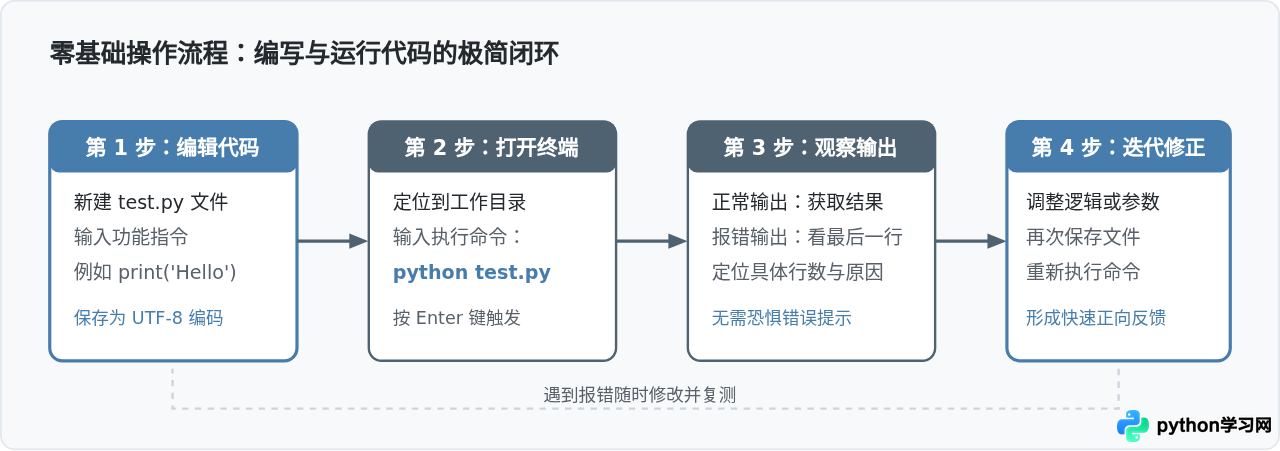
只要终端输出了具体的版本号,说明运行环境已经就绪。编写 Python 程序的核心机制十分简单:在文本编辑器中写下代码并保存为 .py 文件,随后在终端中输入 python 文件名.py 调用解释器运行。
案例一:自动化批量重命名文件(建立文件与循环概念)
应用场景:日常工作中经常会收到名称杂乱的照片、文档或发票,例如“IMG_20261101_001.jpg”,如果需要统一加上前缀“2026_财务报销_”,手动逐个修改耗时易错。通过 Python 内置的 os 模块,只需 10 行左右的代码就能瞬间处理成百上千个文件。
实战代码
import os

# 定义需要批量处理的目标文件夹路径(示例使用当前目录下的 demo_docs)
folder_path = "./demo_docs"

# 检查目标文件夹是否存在
if os.path.exists(folder_path):
    # 获取该文件夹下所有文件的名称列表
    file_list = os.listdir(folder_path)

    # 使用 for 循环逐个处理文件
    for index, filename in enumerate(file_list, start=1):
        # 仅针对常见图片与文档格式添加前缀,过滤隐藏文件
        if not filename.startswith("."):
            new_name = f"2026_归档_{index:03d}_{filename}"
            old_full_path = os.path.join(folder_path, filename)
            new_full_path = os.path.join(folder_path, new_name)

            # 执行重命名操作
            os.rename(old_full_path, new_full_path)
            print(f"已完成: {filename} -> {new_name}")
else:
print(f"提示:请先创建 {folder_path} 文件夹并在其中放入测试文件。")import os:导入 Python 内置的操作系统接口模块,无需额外安装。os.listdir(path):读取文件夹内容并返回一个包含所有文件名的列表(List)。enumerate(..., start=1):在循环遍历的同时提供自增计数器。f"..."(F-string):格式化字符串,花括号内的变量会被直接求值并拼接。{index:03d}表示数字不足 3 位时自动用 0 补齐。os.path.join():智能跨平台拼接文件路径,自动适配 Windows 的反斜杠与 macOS/Linux 的正斜杠。
os.rename() 前先加上 # 注释掉,只保留 print() 打印预期结果,确认无误后再真正执行。
案例二:命令行简易记账与分类统计(掌握列表与字典)
应用场景:学习编程最关键的跃升是学会用数据结构表示现实世界。记账程序需要记录每一笔开销的“金额”和“类别”,并在输入结束时统计总支出和各类别的占比。本案例带你一次性吃透 list(列表)和 dict(字典)这两大核心容器。
实战代码
# 使用列表存储所有流水账目,列表中的每一项都是一个字典
records = [
    {"category": "餐饮", "amount": 38.5},
    {"category": "交通", "amount": 12.0},
    {"category": "餐饮", "amount": 65.0},
    {"category": "文具", "amount": 25.0},
    {"category": "交通", "amount": 8.0}
]

total_expense = 0.0
# 使用字典按分类归集金额
category_summary = {}

for item in records:
    cat = item["category"]
    amt = item["amount"]

    # 累加总支出
    total_expense += amt

    # 如果该分类已在字典中,则累加金额;若不存在,则初始化为当前金额
    if cat in category_summary:
        category_summary[cat] += amt
    else:
        category_summary[cat] = amt

print("=" * 30)
print(f"总计支出金额: {total_expense:.2f} 元")
print("-" * 30)
print("各类别支出明细统计:")
for cat, amt in category_summary.items():
    percentage = (amt / total_expense) * 100
    print(f" - {cat:<6}: {amt:>6.2f} 元 ({percentage:5.1f}%)")
print("=" * 30)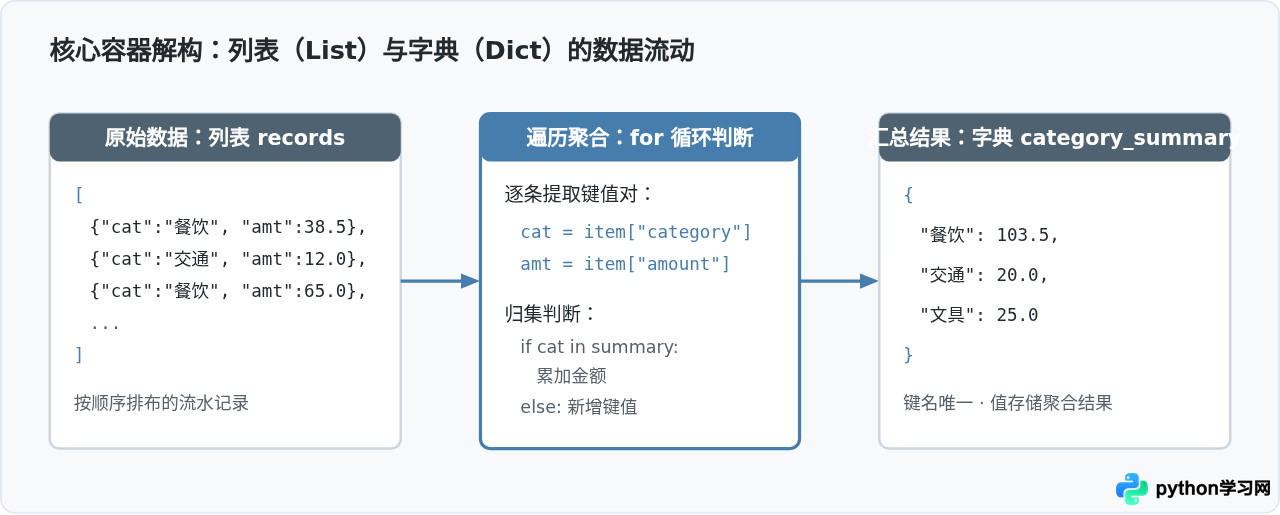
案例三:文本清洗与高频词统计(打通文件读写与标准库)
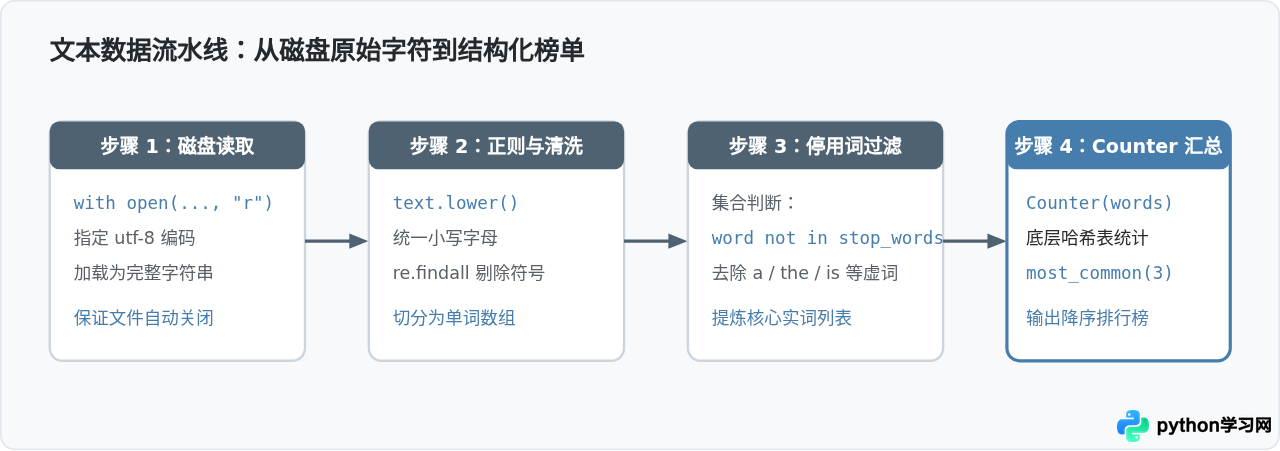
应用场景:分析客户评价、整理会议速记或统计长篇日志时,常常需要从杂乱的自然语言文本中提取出现频率最高的关键词。本案例使用 Python 推荐的上下文管理器 with open() 安全读取磁盘文本,并利用标准库 collections.Counter 实现开箱即用的词频分析。
实战代码
import re
from collections import Counter

# 准备测试文件 sample_text.txt
sample_content = """
Python is an easy to learn, powerful programming language.
Python has efficient high-level data structures and a simple but effective approach to object-oriented programming.
Python elegant syntax and dynamic typing make it an ideal language for scripting.
"""

file_path = "sample_text.txt"

# 1. 写入测试文件(若已有本地文件可直接读取)
with open(file_path, "w", encoding="utf-8") as f:
    f.write(sample_content)

# 2. 安全读取文件内容
with open(file_path, "r", encoding="utf-8") as f:
    text_data = f.read()

# 3. 文本清洗:统一转为小写,使用正则提取全部连续字母单词
words = re.findall(r"\b[a-zA-Z]+\b", text_data.lower())

# 4. 过滤常见虚词(Stop Words),保留具备实际含义的词汇
stop_words = {"an", "to", "and", "a", "but", "it", "for", "is", "has"}
meaningful_words = [word for word in words if word not in stop_words]

# 5. 统计频次并输出前 3 个最高频词
word_counts = Counter(meaningful_words)
top_3 = word_counts.most_common(3)

print("--- 词频分析排行榜 Top 3 ---")
for rank, (word, count) in enumerate(top_3, start=1):
print(f"第 {rank} 名: {word:<12} 出现 {count} 次")with open(...) as f:Python 的上下文管理器语法,不论程序在读取过程中是否遇到异常,都会在离开代码块时自动关闭文件句柄,避免资源泄漏。encoding="utf-8":明确指定编码格式,杜绝跨系统读取中英文字符时的乱码报错。re.findall(...):使用正则表达式将标点符号、空格与单词完全剥离。Counter.most_common(n):内置排序机制,一键返回出现次数最高的前 n 项。
案例四:轻量网络请求与公开接口解析(拥抱第三方生态)
应用场景:编写 Python 脚本绝不局限于操作本地电脑上的静态文件。现代软件开发大量依赖网络接口(API)交换数据。通过安装 Python 社区最流行的网络请求库 requests,你可以编写代码主动抓取天气预报、汇率数据或名言警句。
环境准备与安装
在终端中输入以下命令安装第三方库(如遇到网络波动可指定国内镜像源):
pip install requests实战代码
下面演示请求公开、免费的每日编程名言接口(该接口返回公开 JSON 格式数据):
import requests

# 目标公开免费 API 接口地址
target_url = "https://v1.hitokoto.cn/?c=d&encode=json"

try:
    # 设置 5 秒超时时间,避免网络拥堵时脚本无限卡死
    response = requests.get(target_url, timeout=5)

    # 检查 HTTP 状态码是否为 200 (成功)
    if response.status_code == 200:
        # 将返回的 JSON 字符串直接转为 Python 字典
        data = response.json()
        quote = data.get("hitokoto", "无内容")
        from_where = data.get("from", "未知出处")

        print("====== 每日一句灵感 ======")
        print(f"“{quote}”")
        print(f"       —— 摘自《{from_where}》")
        print("==========================")
    else:
        print(f"服务器返回非正常状态: {response.status_code}")
except requests.exceptions.RequestException as e:
print(f"网络连接异常: {e}")requests.get() 时,Python 充当了类似浏览器的客户端;response.json() 则直接将远端服务器返回的结构化文本反序列化为 Python 字典,免去了复杂的文本切分步骤。
案例五:人机互动猜数游戏(融会贯通逻辑控制流)
应用场景:将前述学到的所有核心知识融会贯通:控制台用户输入(input)、循环控制(while)、条件分支(if-elif-else)、随机数生成(random)以及防御性异常捕获(try-except)。这是一个具备完整游戏逻辑的自包含程序。
实战代码
import random

def guess_number_game():
    # 生成 1 到 100 之间的随机整数
    secret_number = random.randint(1, 100)
    attempts = 0
    max_attempts = 7

    print("=" * 40)
    print("欢迎来到猜数字挑战!电脑已选定一个 1~100 的整数。")
    print(f"你有 {max_attempts} 次机会猜中它。")
    print("=" * 40)

    # 循环控制:只要还有猜测次数就持续运行
    while attempts < max_attempts:
        user_input = input(f"第 {attempts + 1} 次猜测,请输入你的数字 (输入 q 退出): ").strip()

        # 允许用户随时主动退出
        if user_input.lower() == 'q':
            print("游戏已提前退出。正确数字其实是:", secret_number)
            return

        # 防御性转换:防止用户输入非数字字符导致程序崩溃
        try:
            guess = int(user_input)
        except ValueError:
            print("【输入无效】请输入一个纯整数!本次不消耗机会。")
            continue

        attempts += 1

        # 多分支逻辑判断
        if guess < secret_number:
            print(f"太小了!还剩 {max_attempts - attempts} 次机会。")
        elif guess > secret_number:
            print(f"太大了!还剩 {max_attempts - attempts} 次机会。")
        else:
            print(f"恭喜你!在第 {attempts} 次成功猜中目标数字:{secret_number}!")
            return

    print("=" * 40)
    print(f"机会已用尽,挑战失败!正确答案是: {secret_number}")
    print("=" * 40)

if __name__ == "__main__":
guess_number_game()零基础学习总结与避坑法则
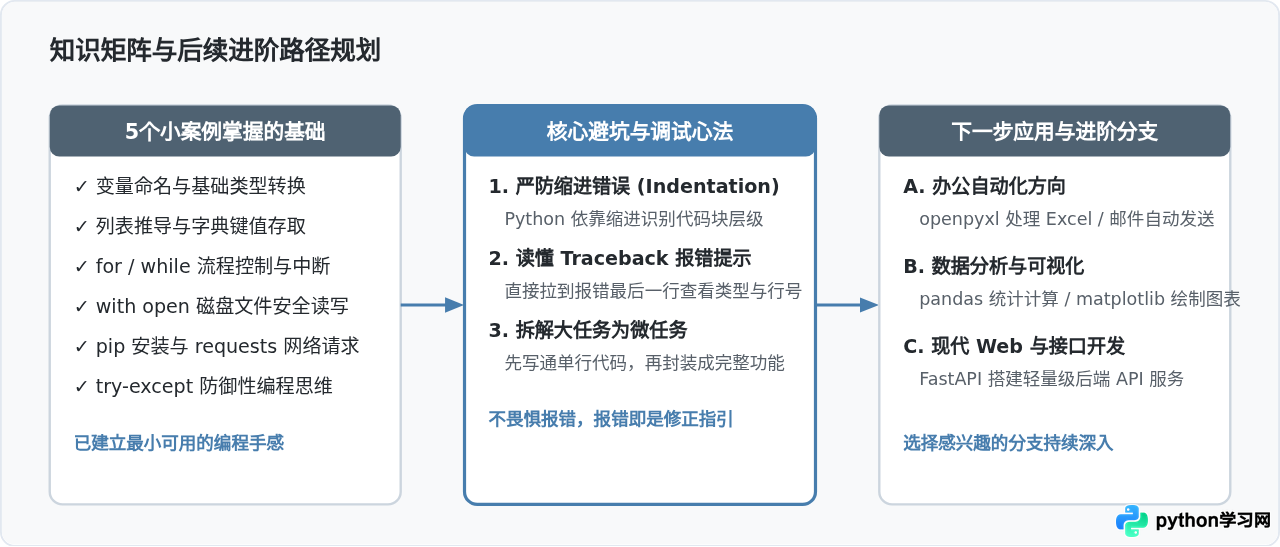
通过以上 5 个案例的循序渐进,你已经实际接触并运行了 Python 最核心的语言特性:变量绑定、列表与字典容器、for/while 循环控制、条件分支、文件 I/O、第三方库调用以及异常处理机制。
初学者常踩的三个坑
- 缩进混乱导致
IndentationError:Python 不像 C 或 Java 使用花括号,而是严格依靠缩进区分代码层级。请保持统一使用 4 个空格,切勿在一个脚本中混用 Tab 和空格键。 - 类型不匹配导致
TypeError:通过input()获取的用户输入永远是字符串类型(String)。如果要参与加减乘除计算,必须显式调用int()或float()进行类型转换。 - 变量名拼写错误导致
NameError:Python 对大小写极其敏感,total_count与Total_Count是两个完全不同的变量。遇到此类错误时仔细比对变量名拼写即可迅速解决。
只要保持“遇到实际需求 -> 查阅最小语法单元 -> 编写小脚本解决 -> 排查报错迭代”这一正向循环,你便已经跨过了初学者最艰难的起步门槛。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









