

Python海象运算符:=用法指南:简化赋值与条件判断
全面解析Python海象运算符(:=)的工作机制与核心语法,详细阐述赋值表达式与常规赋值语句的本质区别,提供while循环流式读取、if条件正则提取与列表推导式结果缓存等实战重构方案与避坑指南。
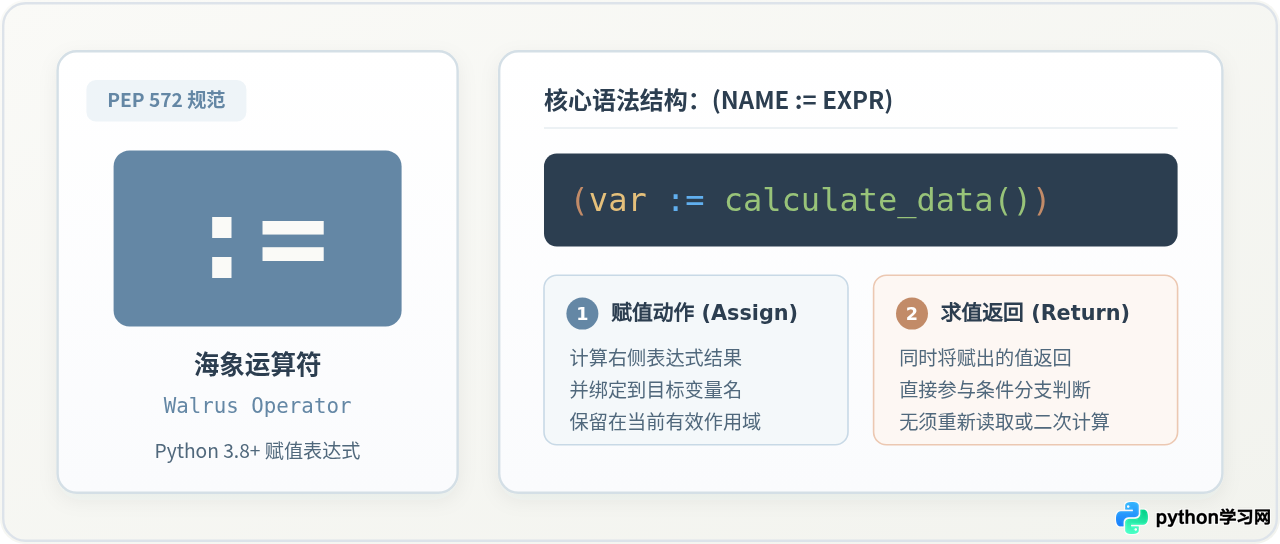
:=),核心价值在于允许开发者在表达式内部就地完成变量赋值,并同时将所赋的值作为表达式的计算结果向外返回。本文将直接拆解海象运算符的语法构成、运行机制与常规赋值的本质分界,通过循环读取、条件正则提取与列表推导式三大经典场景演示具体重构方法,并指出括号优先级、作用域逃逸等边界陷阱与使用规范。
一、核心认知:赋值语句与赋值表达式的本质差异
在 Python 中,常规的等号 = 是一个语句(Statement)。根据 Python 的语法规范,语句负责执行特定操作(例如将对象绑定到变量名),但它本身不具有返回值,因而绝对不能嵌入到需要表达式的地方(例如 if 判定条件或列表推导式内部)。如果在 if 条件中误写普通赋值,解释器会立即抛出 SyntaxError: invalid syntax。
与此相对,海象运算符 := 属于表达式(Expression)。它的执行分为两个同步动作:首先计算右侧表达式的值并将其绑定到左侧的变量名;其次,它将这个值作为整个表达式的结果继续向外传递。由于具有明确的返回值,海象赋值可以无缝嵌入到控制流条件中。
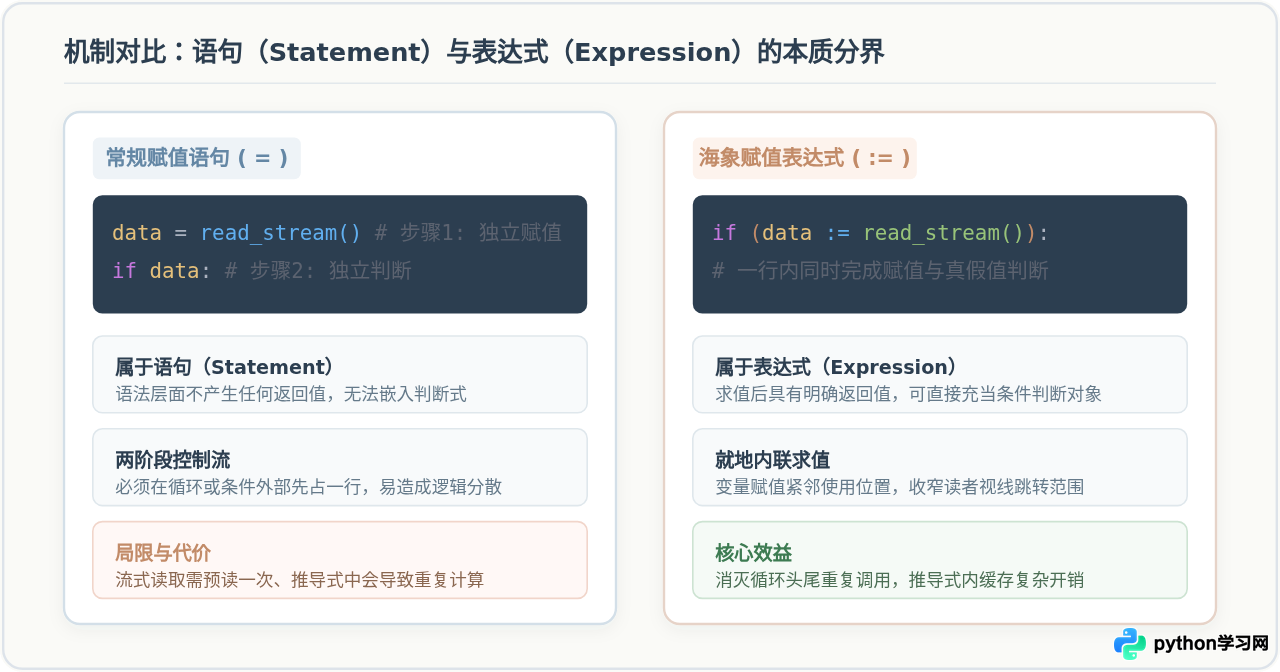
这种“就地赋值并求值”的特性,直接终结了长期困扰 Python 代码的两个痛点:一是为获取条件判断所需的中间结果,必须提前在控制流之外书写临时变量;二是在条件判断通过后,为了使用计算结果而被迫重复调用同一计算逻辑。
二、语法规则与四步安全重构推导
使用海象运算符的基础语法结构为:(target := expression)。其中 target 必须是一个纯粹的单变量名(不能是属性赋值如 obj.attr := val,也不能是切片或解包目标),而 expression 可以是任意合法的 Python 表达式。
1. 为什么外层圆括号至关重要
在绝大多数实际场景中,海象运算符都需要被显式包含在圆括号内。原因在于 Python 运算符的优先级设定:海象运算符 := 的优先级低于绝大多数比较运算符(如 >、<、==、is not)和逻辑运算符(and、or)。
# 错误示例:没有括号导致运算顺序偏离预期
if val := get_count() > 0:
    # 此时先计算 get_count() > 0(结果为布尔值 True 或 False)
    # 变量 val 最终被赋值为布尔值,而不是预期的数值!
    print(val)

# 正确做法:外层添加圆括号,锁定赋值表达式边界
if (val := get_count()) > 0:
    # 先求值并把真实计数赋给 val,随后使用该数值进行比较
    print(f"检测到数据量: {val}")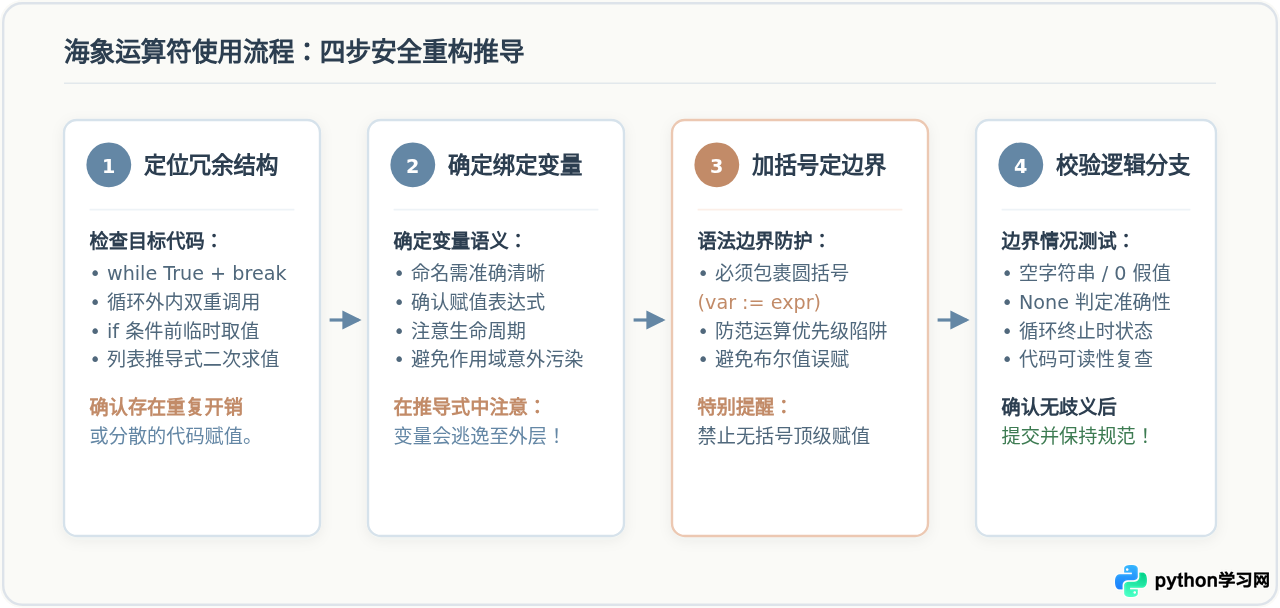
2. 安全重构的四步流程
- 定位冗余结构:检查代码中是否存在
while True加break、循环前后各调用一次read(),或在if前声明了仅供单次条件校验使用的中间变量。 - 确定绑定变量:明确需要复用结果的目标变量名,确保该变量名语义清晰,能够准确反映所存数据的业务含义。
- 加括号定边界:采用
(name := expr)形式,确保表达式的求值范围与运算符优先级不受外部比较符号的干扰。 - 校验逻辑分支:重点检查空字符串、数值
0、空列表等布尔值为False的边界情况,确认分支转向符合预期。
三、三大核心实战应用场景
掌握海象运算符的关键在于识别其最契合的典型架构。以下三个场景是海象运算符最能体现工程价值的应用范式。
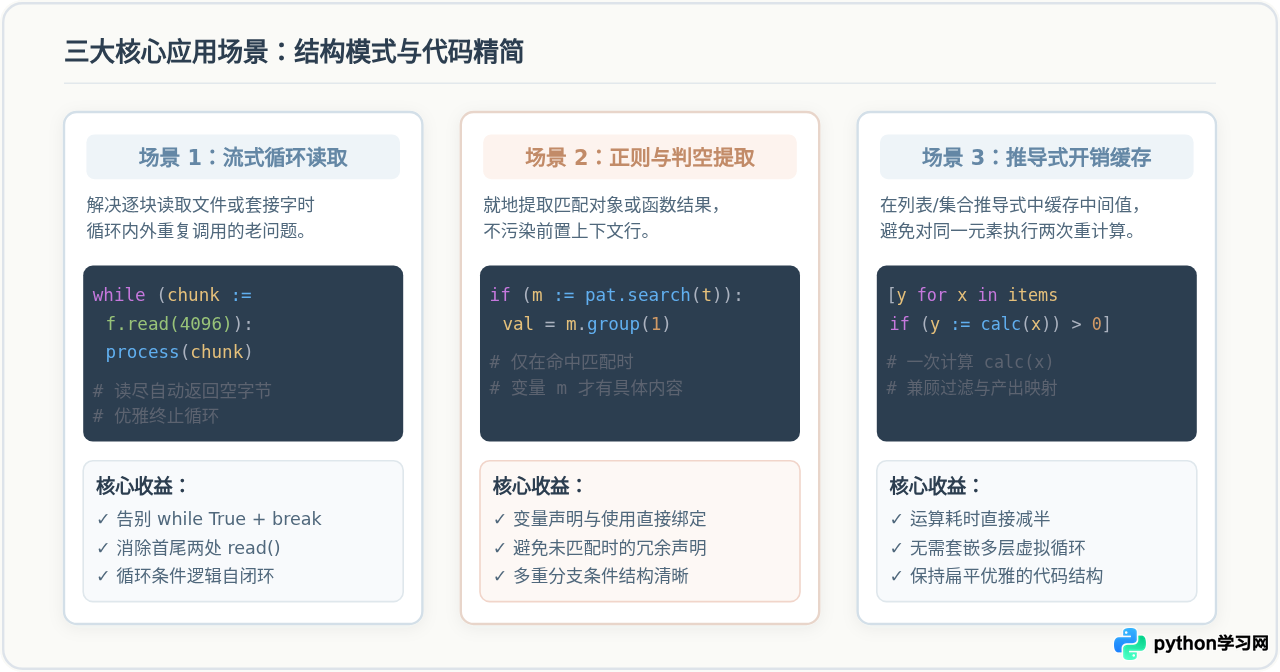
场景一:while 循环流式数据读取与轮询
在处理大文件分块读取、Socket 缓冲区接收或分页拉取 API 数据时,传统的 Python 代码往往显得拖沓。传统写法要么必须在进入循环前先读取一次、并在循环体末尾再次调用读取以驱动下一次循环;要么采用 while True 搭配内部的 if not chunk: break。
# 传统写法:首尾重复调用,或依赖 while True 中断
with open("large_dataset.bin", "rb") as fp:
    while True:
        chunk = fp.read(4096)
        if not chunk:
            break
        process_data(chunk)

# 海象运算符重构:循环条件自闭环,结构极其紧凑
with open("large_dataset.bin", "rb") as fp:
    while (chunk := fp.read(4096)):
        process_data(chunk)
重构后的代码在每次迭代前调用 fp.read(4096),将字节对象赋给 chunk,当读取至文件末尾时,返回空字节串 b''(布尔假值),while 循环自然终止。代码行数大幅减少,逻辑完全聚拢在循环头。
场景二:if 条件分支中的正则提取与防护性过滤
在文本匹配、参数解析与数据校验中,我们经常使用正则表达式 re.search 或执行开销较大的查询函数。传统写法需要在 if 语句上方提前执行匹配并保存变量;如果后续有多级分支判断,会留下大量松散的未命中变量。
import re

log_line = "2026-11-01 [ERROR] Database connection timed out after 30s"

# 传统写法:提取逻辑与分支判断分离
match = re.search(r"\[(ERROR|WARNING)\]\s+(.*)", log_line)
if match:
    level, message = match.group(1), match.group(2)
    notify_ops(level, message)

# 海象运算符重构:变量就地绑定,仅在匹配成功时进入分支
if (match := re.search(r"\[(ERROR|WARNING)\]\s+(.*)", log_line)):
    notify_ops(match.group(1), match.group(2))
elif (match := re.search(r"\[INFO\]\s+(.*)", log_line)):
    record_audit(match.group(1))
在多分支 elif 结构中,海象运算符的优势尤为突出:每一个分支只在进入该判断时就地求值,避免了在外部预先执行所有匹配的性能浪费。
场景三:列表推导式中消灭二次计算
列表推导式(List Comprehension)兼具执行效率与简洁性,但在需要先基于计算结果过滤、再将该结果存入列表时,开发者往往陷入两难:要么在过滤条件与映射部分各调用一次耗时函数;要么多套一层虚拟循环 for y in [calc(x)],严重影响代码可读性。
# 假设 parse_metrics 是一个涉及复杂解析的耗时函数
raw_records = ["temp:24", "invalid", "temp:45", "temp:-5"]

# 传统方案一:parse_metrics(x) 被重复执行两次,耗时成倍增加
results = [parse_metrics(x) for x in raw_records if parse_metrics(x) > 0]

# 传统方案二:增加辅助层遍历单元素列表,代码晦涩难懂
results = [val for x in raw_records for val in [parse_metrics(x)] if val > 0]

# 海象运算符重构:仅计算一次,过滤同时完成缓存
results = [val for x in raw_records if (val := parse_metrics(x)) > 0]
在重构后的推导式中,val := parse_metrics(x) 在 if 子句中执行并绑定到 val,如果校验大于 0,前面的输出表达式直接复用 val,从而彻底免除二次计算开销。
四、作用域行为与避坑指南
海象运算符并非放之四海皆准的灵丹妙药。理解其在作用域上的特殊机制以及语法限制,是写出高品质代码的基础。
在 Python 3 中,列表推导式的迭代变量具有局部作用域,推导式执行完毕后会被销毁。然而,PEP 572 明确规定:在列表、集合或字典推导式中通过海象运算符
:= 赋值的变量,会被绑定到包围该推导式的函数作用域(或全局作用域)中!
def analyze_data():
    numbers = [1, 2, 3, 4]

    # 在推导式内通过海象运算符赋值 last
    squared = [last for n in numbers if (last := n * n) > 5]

    # 注意:last 并没有随推导式结束而销毁,它逃逸到了当前函数作用域中!
    print(last)  # 输出: 16

analyze_data()
这种设计本身是为了方便在推导式执行后获取关键状态,但如果当前函数后续代码中也存在同名变量 last,极易引发意外的数据覆盖。因此,在推导式中使用海象运算符时,必须注意变量命名的唯一性。
不可使用的语法禁区
- 顶层裸用抛出语法错误:
x := 100作为一条独立语句是不合法的,解释器会报SyntaxError。Python 语言设计者明确禁止以此代替常规等号x = 100,防止语法风格产生无意义的分裂。 - 不能用于属性或字典索引赋值:
(data['count'] := 1)或(self.total := 10)均是非法语法。海象运算符左侧只接受单一的裸标识符(Simple Name)。 - 不可在类体顶级直接赋值并逃逸:在类作用域内部使用推导式时,海象运算符被显式禁止向类作用域注入名称。
五、技术决策指南与全篇总结
代码的第一要务始终是清晰与可维护。如果在条件判断中将多个海象赋值与复杂的 and / or 运算符深度串联,会使阅读代码变成一场烧脑的谜题。编写代码时,可以参考如下决策流程:
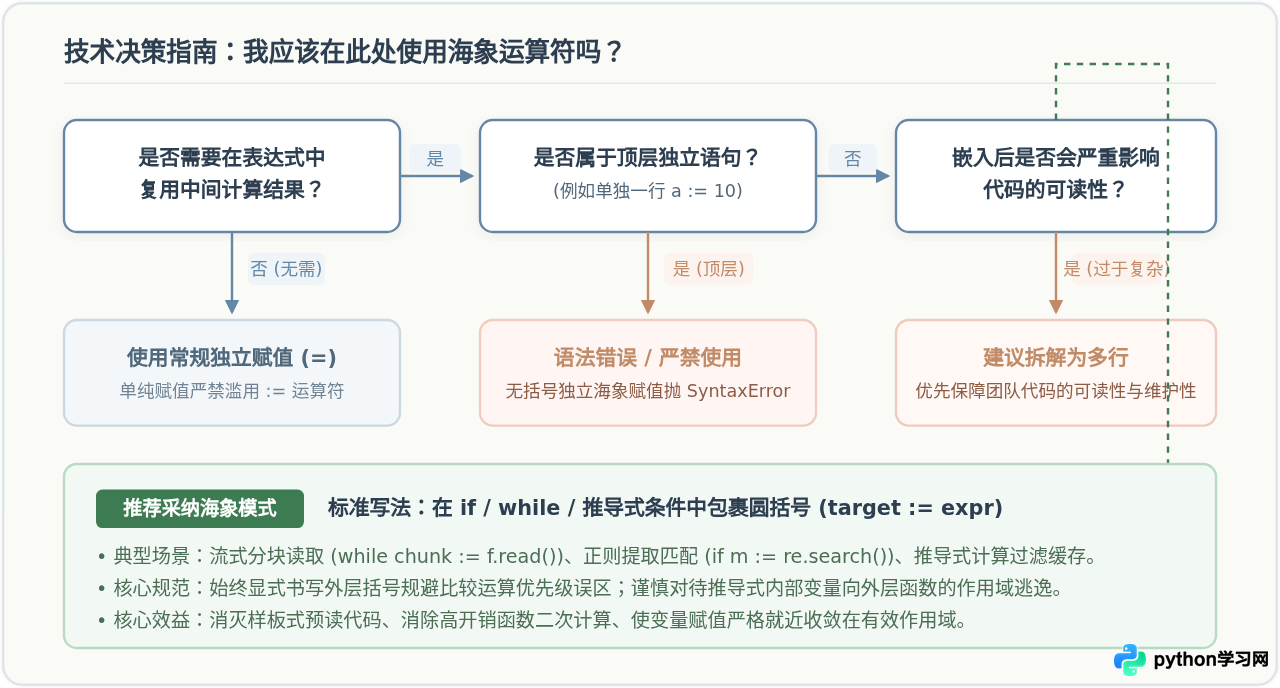
| 场景类别 | 传统典型写法 | 海象运算符重构写法 | 主要工程收益 |
|---|---|---|---|
| 流式读取 | 循环首尾双重 read() 或 while True + break |
while (chunk := fp.read(size)): |
消除重复调用代码,循环控制流逻辑自闭环 |
| 条件提取 | if 前提前调用并赋值外部变量 |
if (match := re.search(...)): |
收敛变量声明范围,避免未匹配时的上下文污染 |
| 推导式缓存 | [f(x) for x in L if f(x) > 0](双重调用) |
[y for x in L if (y := f(x)) > 0] |
杜绝高开销函数二次计算,执行速度翻倍 |
| 独立赋值 | x = 10 |
x = 10(严禁写作 (x := 10)) |
维护 Python 规范语法,杜绝无意义的炫技滥用 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









