

Python元组拼接与重复:+号和*号运算规则
深入讲解Python元组的拼接与重复运算规则。全面剖析+号与*号的类型约束、不可变底层机制、单元素逗号语法陷阱、浅拷贝引用风险以及+=复合赋值的特殊行为与工程最佳实践。
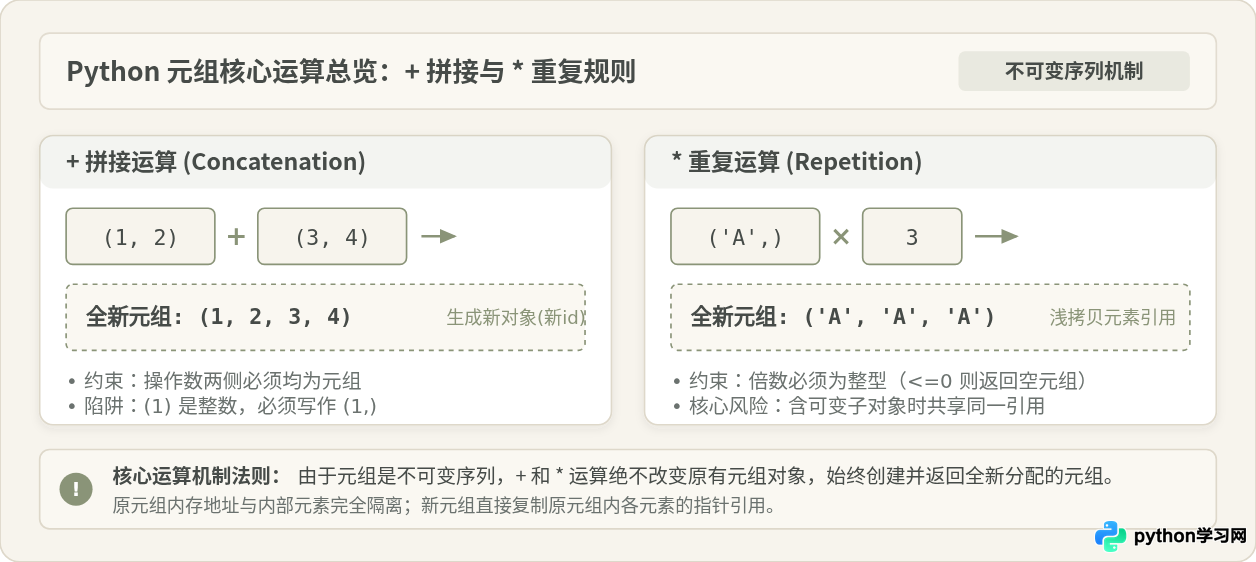
+ 号执行拼接或使用 * 号执行重复时,解释器绝不会在原元组上做就地改动,而是通过读取参与运算的原元组元素引用,在内存中重新申请空间并构造一个全新的元组对象返回。掌握这两个运算符的语法边界、单元素逗号约束、以及嵌套可变对象时的浅拷贝机制,是编写稳健且高效 Python 程序的必备基本功。
一、元组拼接(+ 号)的运算规则与类型边界
+ 运算符用于将两个或多个元组的元素按前后顺序连接为一个新的元组。在执行拼接操作时,Python 的类型系统有着严格的约束:加号两边的操作数必须同为元组类型。如果尝试将元组与列表、集合或数值直接相加,解释器会立即中断并抛出 TypeError。
1. 基础拼接语法与代码示例
当两端均为标准元组时,拼接过程直观自然:
# 示例代码:两个或多个元组的标准拼接
tuple_a = (10, 20)
tuple_b = ("apple", "banana")
tuple_c = (True, None)

result = tuple_a + tuple_b + tuple_c
print(result)
# 示例输出:
# (10, 20, 'apple', 'banana', True, None)

# 验证不可变性:原元组保持原样且内存地址各不相同
print("tuple_a id:", id(tuple_a))
print("tuple_b id:", id(tuple_b))
print("result id:", id(result))
# 示例输出(地址均不相同):
# tuple_a id: 140382901235456
# tuple_b id: 140382901236160
# result id: 140382901308800
2. 最容易踩中的语法坑:单元素元组的逗号约束
很多刚接触 Python 的开发者在向现有元组拼接单个值时,习惯顺手写成 t + (1),这会立刻导致运行时异常。在 Python 语法解析中,圆括号 () 同时承担两种职责:一种是数学与逻辑表达式中的运算优先级分组,另一种才是元组的语法界定。
当圆括号内仅有一个数值或字符串且无逗号时,Python 只将其视为普通优先级括号。例如 (1) 的求值结果是整数 1,("hello") 的结果是字符串 "hello"。只有在元素末尾加上英文逗号 (1,) 时,解释器才会将其构建为长度为 1 的单元素元组。
# 错误示例:缺少逗号导致 TypeError
base_tuple = (1, 2, 3)
try:
    bad_result = base_tuple + (4)
except TypeError as e:
    print("捕获错误:", e)
    # 示例输出:
    # 捕获错误: can only concatenate tuple (not "int") to tuple

# 正确示例:补全逗号完成单元素拼接
good_result = base_tuple + (4,)
print(good_result)
# 示例输出:
# (1, 2, 3, 4)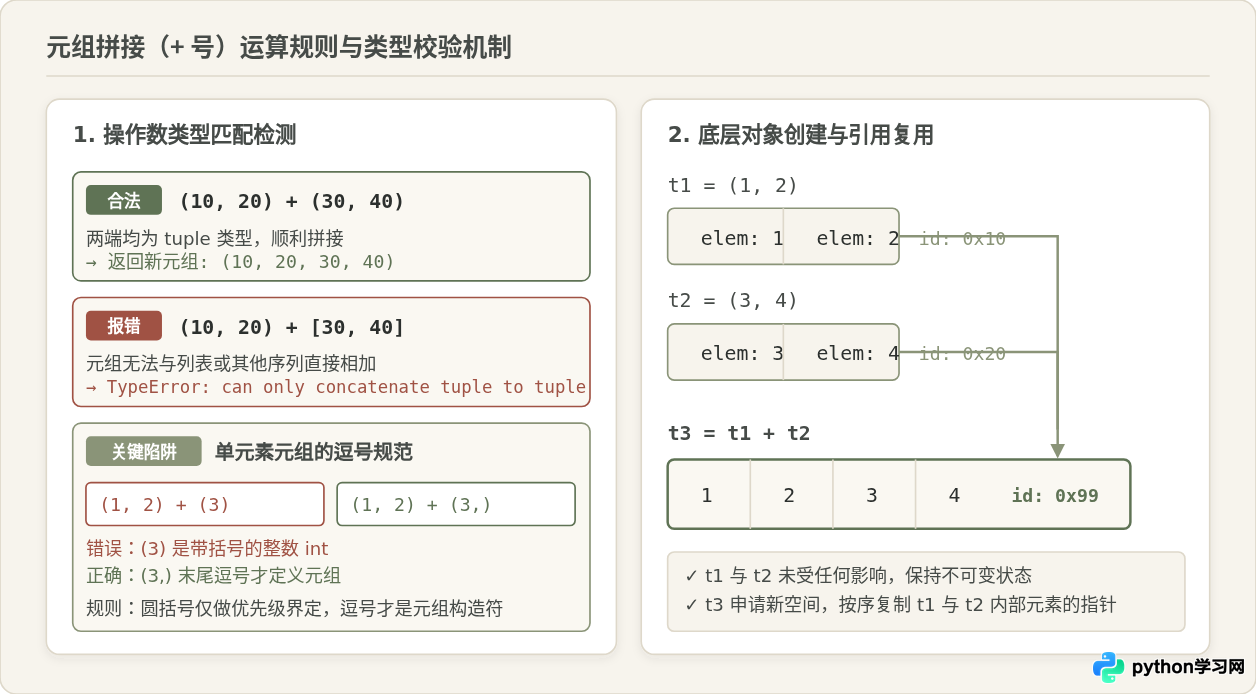
tuple() 构造器完成转换。例如:(1, 2) + tuple([3, 4])。
二、元组重复(* 号)的运算规则与乘数分支
* 运算符用于将元组中的全部元素按照指定倍数连续复制展开。与 + 运算相同,它同样生成并返回一个全新元组,且原元组不受影响。在重复运算中,操作数由一个元组和一个整数构成,两者顺序可以互换(例如 t * 3 与 3 * t 等价)。
1. 乘数取值所决定的运算结果
乘数必须是整数类型(int),其具体取值规则如下:
- 正整数(n > 0): 元组内所有元素按原有顺序重复出现 $n$ 次,新元组的长度等于原元组长度乘以 $n$。
- 零或负整数(n ≤ 0): 无论原元组包含多少元素,只要乘数小于等于 0,Python 统一返回一个空的全新元组
()。 - 浮点数或非整型: 即使是数值等价的浮点数(如
2.0),也会抛出TypeError: can't multiply sequence by non-int of type 'float'。
# 示例代码:* 号在不同乘数下的运算行为
item_tuple = ("Alpha", "Beta")

# 正整数重复
repeat_3 = item_tuple * 3
print("重复3次:", repeat_3)
# 示例输出:
# 重复3次: ('Alpha', 'Beta', 'Alpha', 'Beta', 'Alpha', 'Beta')

# 乘数为 0
repeat_0 = item_tuple * 0
print("乘数为0:", repeat_0)
# 示例输出:
# 乘数为0: ()

# 乘数为负数
repeat_neg = item_tuple * -5
print("乘数为负数:", repeat_neg)
# 示例输出:
# 乘数为负数: ()
三、深层避坑:* 号重复引发的浅拷贝与引用共享
当元组内部所包含的元素全部是不可变类型(如整数、浮点数、字符串、或者内部也全是不可变类型的纯元组)时,使用 * 号复制是绝对安全且高效的。
然而,如果元组中包含了可变对象(最常见的是列表 list 或字典 dict),* 运算符并不会递归深入为每个槽位创建全新的可变对象,而是仅仅复制了该对象的内存指针(浅拷贝)。这意味着,在新生成的元组中,多个位置上的元素实际上全部绑定到了同一个堆内存对象上。
# 陷阱示例:包含列表的元组使用 * 重复
# 构造一个含单个列表元素的元组
nested_tuple = ([100],) * 3
print("初始化后的元组:", nested_tuple)
# 示例输出:
# 初始化后的元组: ([100], [100], [100])

# 打印各元素的内存地址,确认它们指向同一个对象
print("各元素id:", [id(x) for x in nested_tuple])
# 示例输出(三个元素地址完全一致):
# 各元素id: [140382901306176, 140382901306176, 140382901306176]

# 修改其中第一个列表的内容
nested_tuple[0].append(999)

# 查看元组的变化
print("修改后的元组:", nested_tuple)
# 示例输出(牵一发而动全身):
# 修改后的元组: ([100, 999], [100, 999], [100, 999])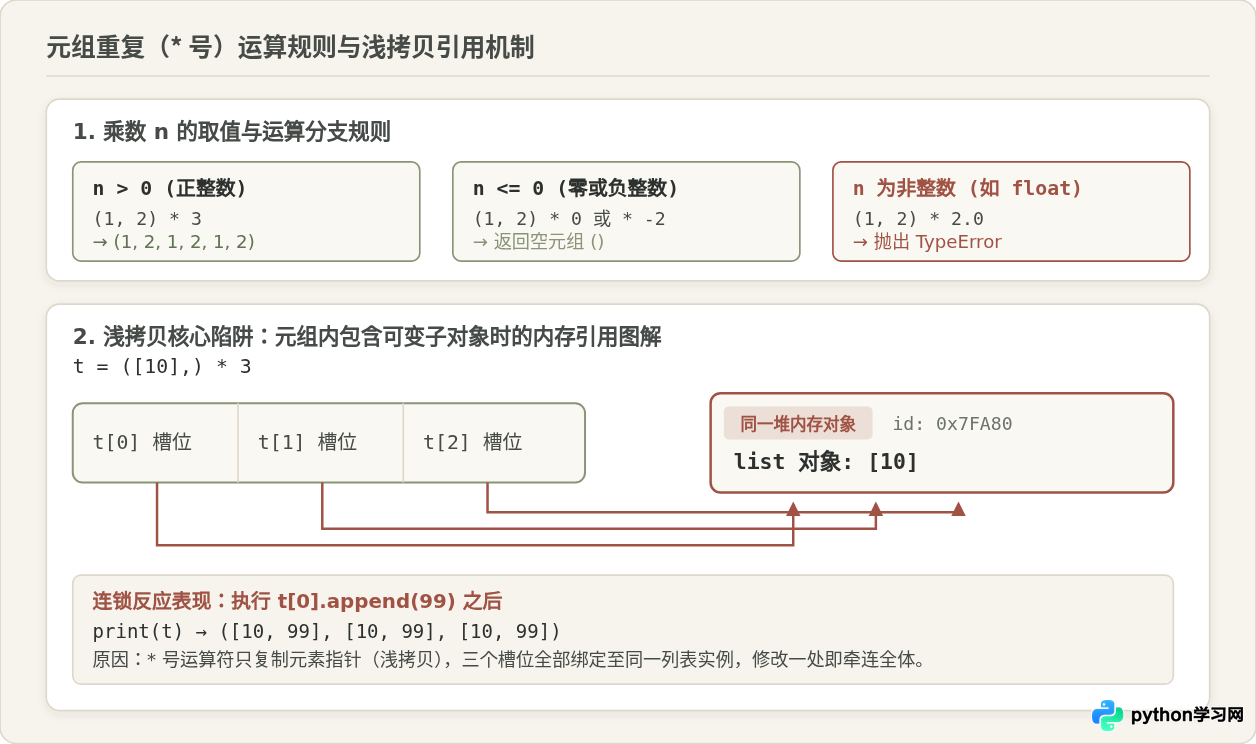
([default],) * n。正确的工程解法是使用生成器推导式,让每次迭代都显式初始化独立的列表实例:independent_tuple = tuple([] for _ in range(3))。
四、增量赋值运算符(+= 与 *=)在元组上的真实运作机制
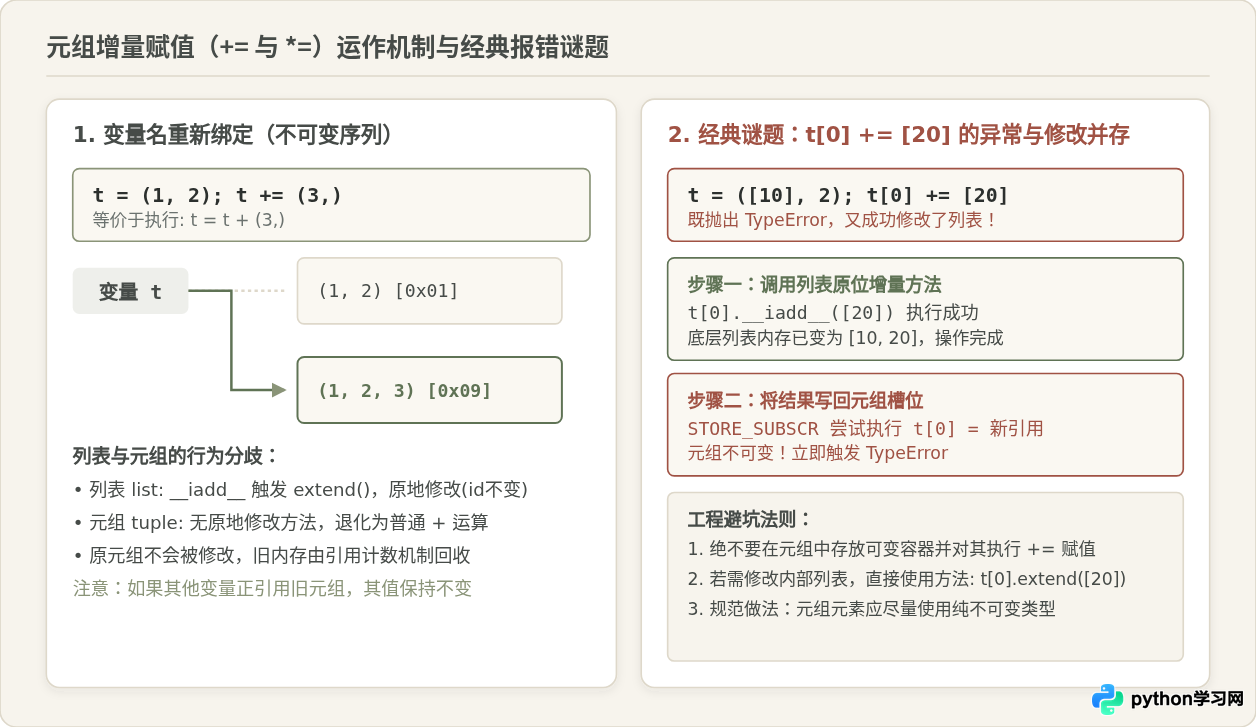
在许多编程语言或 Python 的可变序列(如列表)中,+= 意味着“就地追加”。列表的 lst += [4] 会直接调用底层 __iadd__ 方法,在原本的内存缓冲区中追加元素,对象的 id 终身不变。
然而对于元组,因为其结构具备不可变约束,元组类型内部并未实现原地增量的 __iadd__ 和 __imul__ 方法。当对元组变量执行 t += (x,) 时,Python 虚拟机会自动退化为调用常规的 __add__ 拼接方法,执行逻辑严格等价于 t = t + (x,)。
# 示例代码:+= 在元组上的变量重绑定过程
original_t = (1, 2)
alias_t = original_t  # 建立别名引用

print("初始地址:", id(original_t))

# 执行增量拼接
original_t += (3, 4)

print("运算后 original_t 的地址:", id(original_t))
print("运算后 original_t 的内容:", original_t)
print("别名 alias_t 的内容:", alias_t)
# 示例输出:
# 初始地址: 140382901235456
# 运算后 original_t 的地址: 140382901308800
# 运算后 original_t 的内容: (1, 2, 3, 4)
# 别名 alias_t 的内容: (1, 2)
深入剖析经典谜题:为何“既抛出异常,又修改成功”?
在 Python 官方教程与各类高级面试中,存在一道广为流传的代码谜题:如果一个元组的第一个元素是列表,那么执行 t[0] += [40] 会发生什么?
执行该语句时,Python 会报出 TypeError: 'tuple' object does not support item assignment。但如果紧接着打印元组 t,读者会惊讶地发现,列表内部的值居然确实被追加进去了!这一“精神分裂”般的结果经常让开发者困惑不解。其底层字节码执行路径可细分为两个离散步骤:
- 原位增量阶段: 解释器首先评估右侧运算,找到
t[0]处的列表对象,并调用该列表的__iadd__方法。列表是可变对象,因此[40]成功就地追加到原列表中,操作完全合规。 - 赋值写回阶段: 增量赋值语法要求将第一步计算后的返回值重新赋值给左侧目标(即字节码
STORE_SUBSCR操作)。此时解释器尝试对元组执行t[0] = ...。因为元组不允许对槽位重新赋值,立刻触发TypeError。
五、性能特征与工程使用决策
深入理解 + 和 * 的内部开销,有助于在编写高性能代码时做出合理的技术选型。
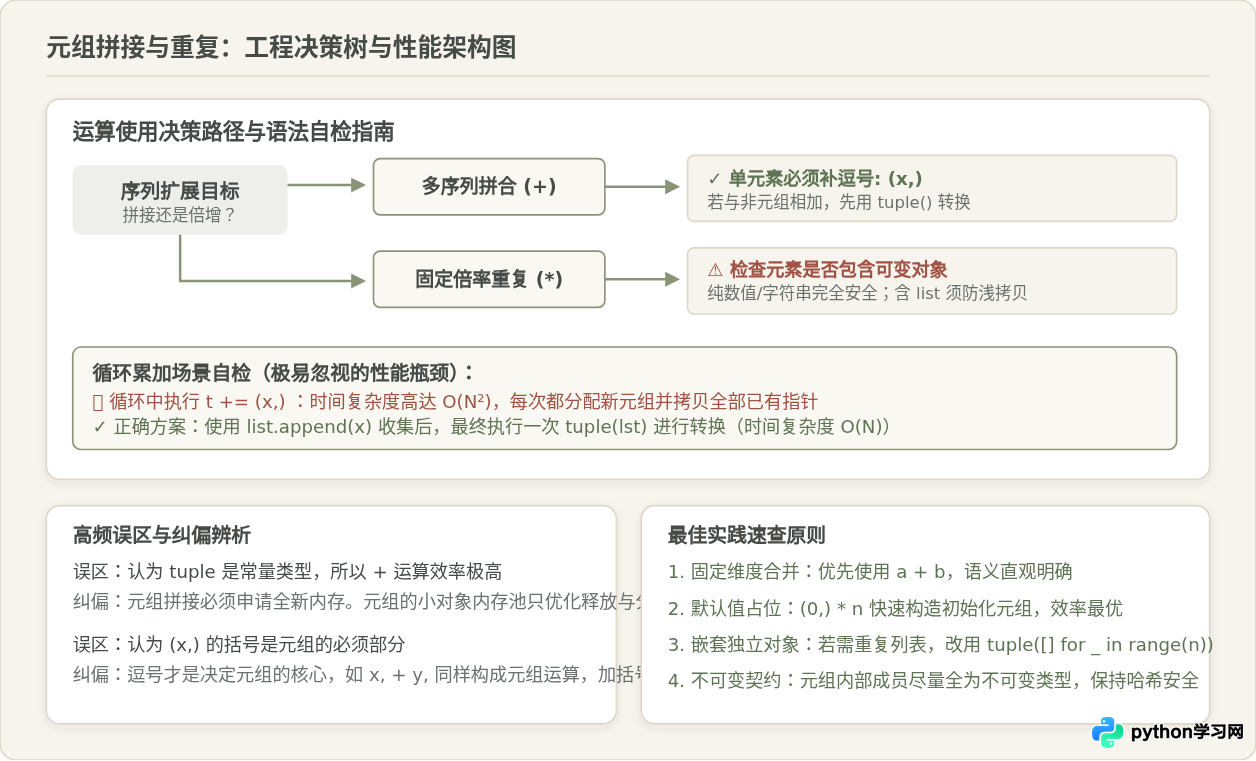
1. 警惕在循环中频繁使用 += 构建元组
由于元组是不可变的,每一次 t += (item,) 都会经历:“申请全新内存空间 → 将已有 $k$ 个元素指针拷贝到新空间 → 写入新元素指针 → 丢弃旧元组” 的完整流程。
如果在包含 $N$ 次循环的结构中采用这种拼接方式,总的时间复杂度将退化为糟糕的 $\mathcal{O}(N^2)$,并且会在 Python 堆中产生大量的临时小对象碎片。相较之下,列表内部预留了连续的动态扩容缓冲,list.append() 具备平摊 $\mathcal{O}(1)$ 的常数时间开销。
| 场景与需求 | 推荐方案 | 时间复杂度 | 原因与设计考量 |
|---|---|---|---|
| 少量固定元组拼合 | 直接使用 a + b |
$\mathcal{O}(L_a + L_b)$ | 语法简洁直观,在长度较短时执行速度极快。 |
| 大量元素动态累加 | 先 list.append(),最后 tuple() |
$\mathcal{O}(N)$ | 避免反复创建销毁中间元组,大幅减轻内存复制压力。 |
| 固定默认值填充(不可变) | (0,) * n 或 (None,) * n |
$\mathcal{O}(n)$ | C 层面直接 memcpy 展开指针,是开辟固定占位元组最高效的方式。 |
| 包含可变对象的批量初始化 | tuple([] for _ in range(n)) |
$\mathcal{O}(n)$ | 杜绝浅拷贝引起的引用污染,确保每个槽位拥有独立对象。 |
六、全文核心知识总结速查表
- 不可变本质: 元组的
+和*运算符从不修改原始对象,始终分配并返回独立的新元组。 - 类型匹配:
+运算两侧必须同为元组类型;向元组追加单个元素时,务必加上末尾逗号(val,),否则会被识别为带优先级的标量类型。 - 乘数特性:
*运算的乘数必须为整数,非整数报错;乘数小于等于 0 必定返回空元组()。 - 浅拷贝警示:
*号仅复制对象引用。若元组内存在列表、字典等可变容器,重复后各元素将共享同一内存地址。 - 复合赋值真相:
t += (x,)实际上是t = t + (x,)的语法糖,变量名将重新指向新元组;绝不可对包含在元组内部的可变对象使用+=操作。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









