

Python与Java文件读写语法对比:open()与FileInputStream代码实现差异
深入对比Python的open()函数与Java的FileInputStream在底层架构、语法实现、缓冲区机制及异常安全释放上的核心差异,提供完整的可运行代码与工程选型建议。
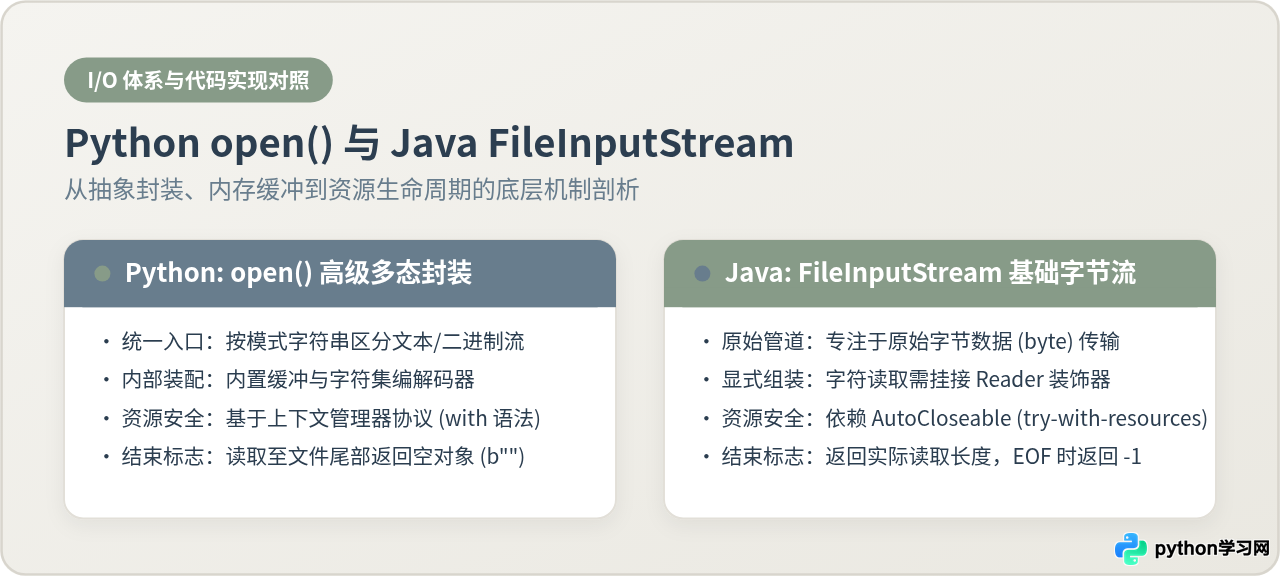
open() 函数与 Java 的 FileInputStream 表现出两种不同的系统抽象哲学:Python 偏向高层复合门面,通过单一函数配合模式字符串统一调度字符解码与缓冲流;Java 则贯彻分层流体系与静态类型,FileInputStream 严格作为原始二进制字节管道工作。理解两者在抽象层级、内存分配、EOF 判定及资源自动释放上的实现差异,有助于在双语言开发中准确写出健壮高效的文件操作代码。
一、底层抽象与设计模型差异
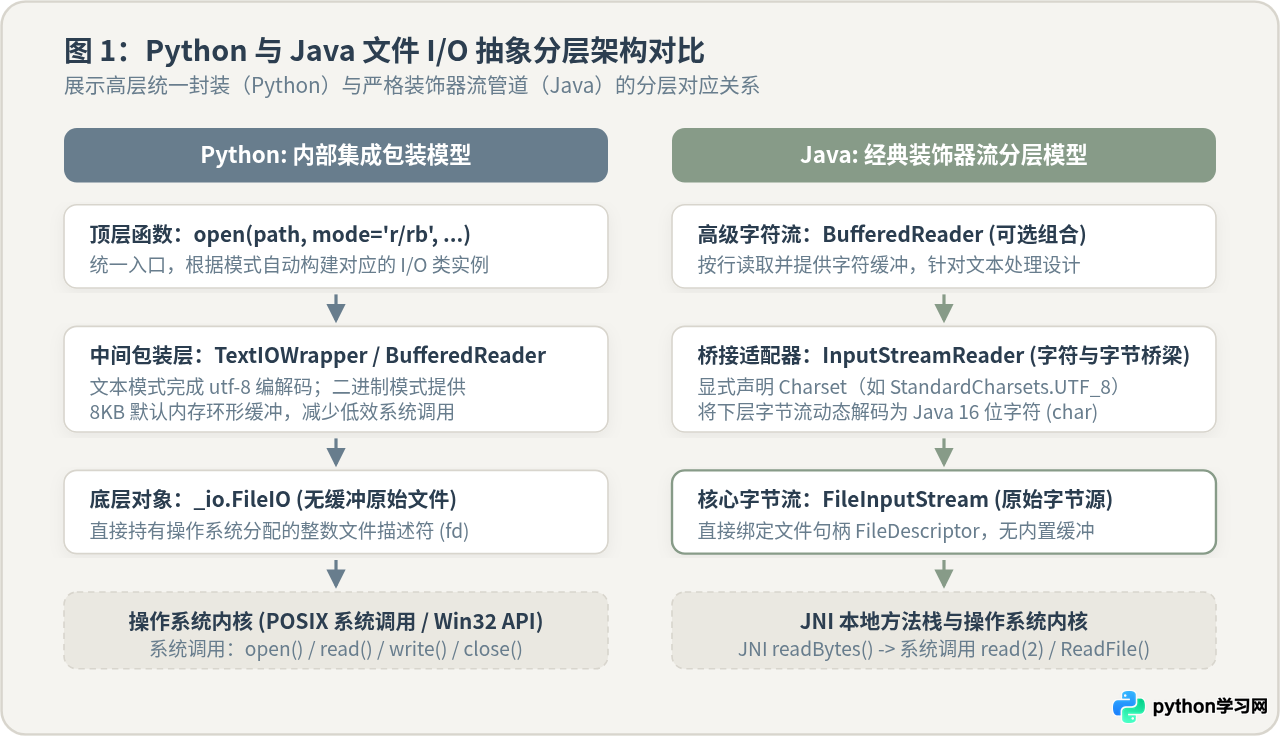
在底层模型上,Python 的 open() 是内置的通用工场函数,返回值属于 io 模块的类层次结构。当以文本模式(默认 mode='r')调用时,它返回一个 _io.TextIOWrapper 对象,该对象内部自动组合了缓冲层(_io.BufferedReader)和底层系统调用接口(_io.FileIO),并在用户读写时透明处理字符编码与换行符转换;当以二进制模式(mode='rb')调用时,它直接返回带缓冲的字节流对象。
Java 的 FileInputStream 则是 java.io.InputStream 的具体子类,定位非常专注:它只建立从文件到应用程序内存的原始字节(byte)传输通道,完全不包含字符编码识别、行分隔符解析或内置缓冲机制。如果需要读取文本内容,Java 必须使用适配器类 InputStreamReader 将字节流转接为字符流,再包裹 BufferedReader 获得行读取与缓冲能力。这种严格的装饰器模式(Decorator Pattern)虽然初始代码量较多,但各层的职责边界非常分明。
二、二进制文件读取步骤与代码实现对照
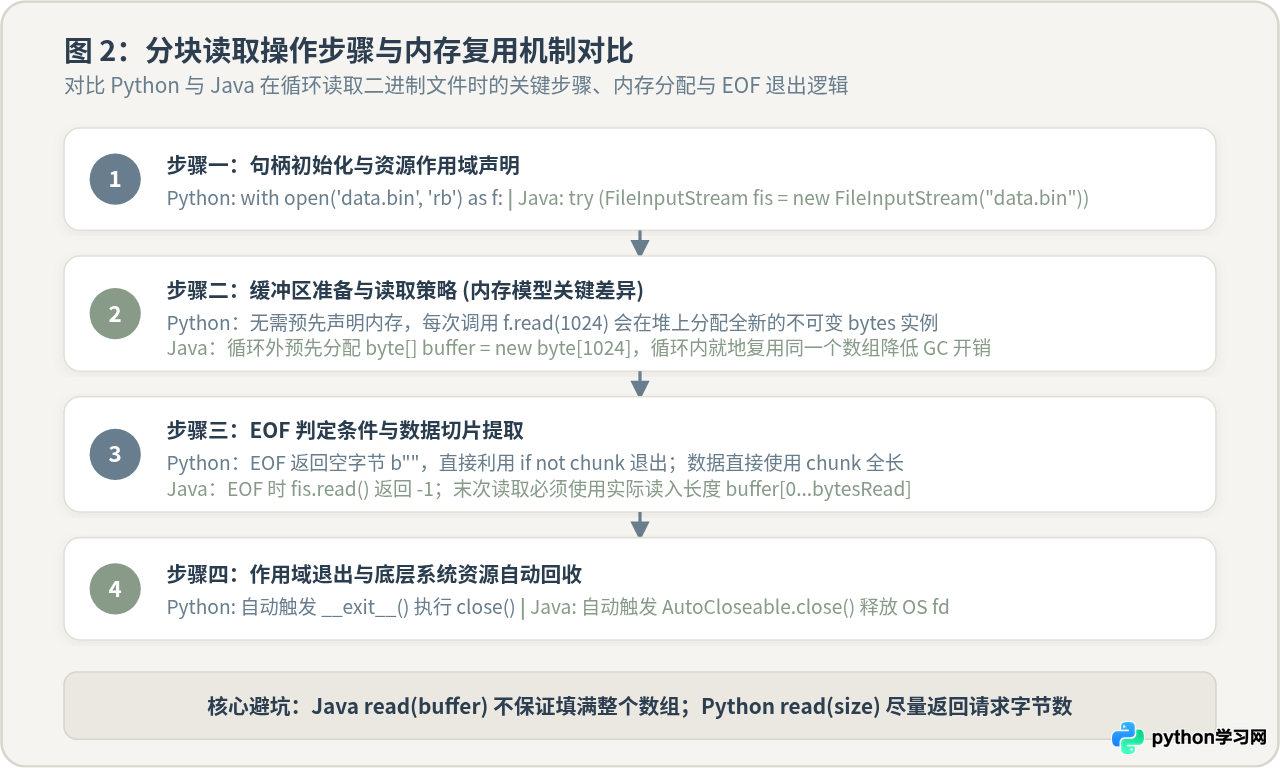
为了在相同的条件下考察两者的代码实现差异,我们以分块读取一个名为 sample.bin 的二进制文件(每次读取 1024 字节)为例进行语法对照。
# Python: 使用 with 语句与 read() 进行二进制分块读取
def read_binary_chunks(filepath: str, chunk_size: int = 1024) -> int:
    total_bytes = 0
    with open(filepath, 'rb') as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:  # 当到达文件末尾 (EOF) 时,返回空 bytes 对象 b""
                break
            total_bytes += len(chunk)
            # 处理数据块 (例如网络传输、哈希计算或写入其他流)
    return total_bytes

# 执行示例
if __name__ == '__main__':
    bytes_count = read_binary_chunks('sample.bin')
    print(f"Python 读取完成,累计读取字节数: {bytes_count}")
import java.io.FileInputStream;
import java.io.IOException;

public class BinaryReaderExample {
    // Java: 使用 try-with-resources 与 byte[] 缓冲数组分块读取
    public static long readBinaryChunks(String filepath, int chunkSize) throws IOException {
        long totalBytes = 0;
        // 显式声明 byte 数组,实现内存复用
        byte[] buffer = new byte[chunkSize];

        try (FileInputStream fis = new FileInputStream(filepath)) {
            int bytesRead;
            // read(buffer) 返回实际读入的字节数,遇到文件末尾 (EOF) 返回 -1
            while ((bytesRead = fis.read(buffer)) != -1) {
                totalBytes += bytesRead;
                // 注意:处理数据时必须仅处理有效区间 buffer[0 ... bytesRead - 1]
            }
        }
        return totalBytes;
    }

    public static void main(String[] args) {
        try {
            long count = readBinaryChunks("sample.bin", 1024);
            System.out.println("Java 读取完成,累计读取字节数: " + count);
        } catch (IOException e) {
            System.err.println("文件读取发生 I/O 错误: " + e.getMessage());
        }
    }
}
分析上述两段代码的执行逻辑,可以发现两个关键的技术细节差异:
- EOF(文件末尾)判定机制:Python 的
read()到达文件尾时返回长度为 0 的字节对象b"",在布尔上下文中直接求值为False;Java 的read(byte[] b)则返回实际读入的整型字节数,当无可用字节且到达末尾时明确返回-1。 - 内存分配与对象生命周期:Python 的
f.read(1024)每次调用都会在堆上动态分配一个全新的不可变bytes对象,由 Python 引用计数和垃圾回收机制管理;Java 则要求开发者在循环外部主动分配固定大小的byte[] buffer,循环内部不断覆写该数组内存,避免在处理大文件时触发频繁的年轻代 GC。 - 尾块有效数据范围:Java 在读取最后一个数据块时,若剩余字节不足 1024,
buffer数组中后续旧数据依然存在,必须严格依赖返回值bytesRead截取有效范围;Python 每次返回的切片长度即为实际读取长度。
三、资源管理机制:with 语句 vs try-with-resources
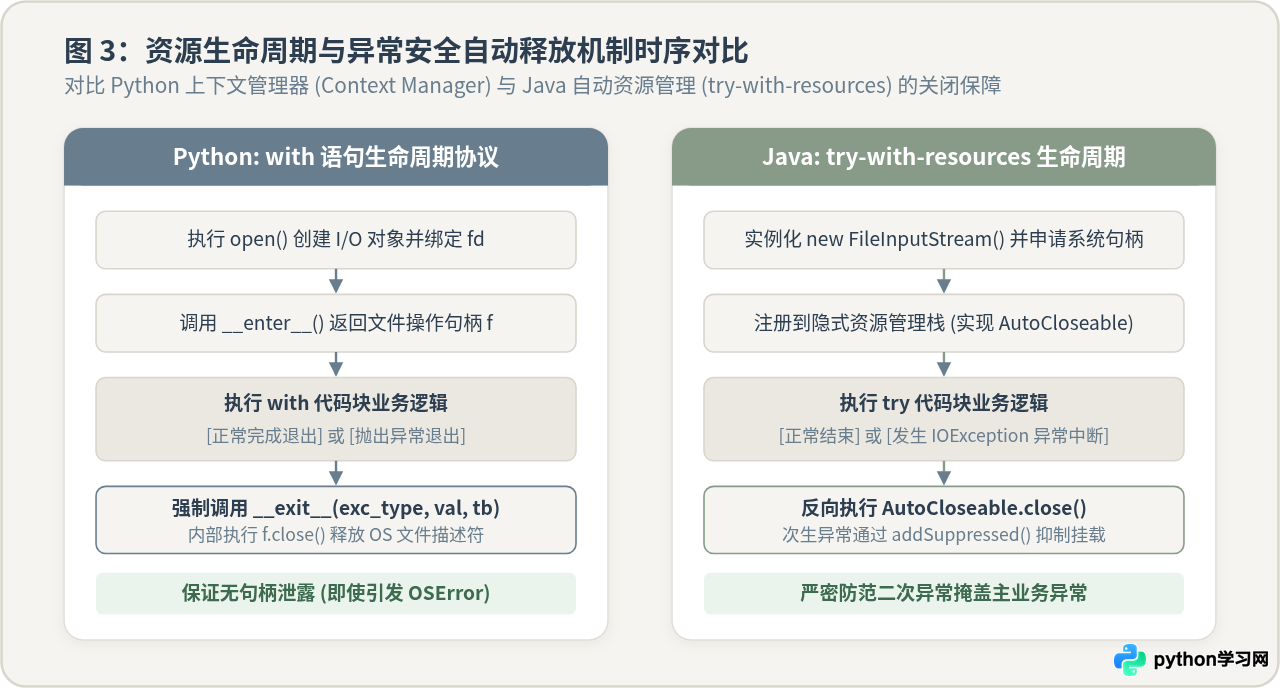
文件句柄是操作系统稀缺的有限资源。如果程序在读写过程中发生异常或未主动关闭文件,将导致操作系统的文件描述符(File Descriptor)泄漏,最终引发“Too many open files”错误。现代 Python 与 Java 均提供了确定性的资源回收语法:
1. Python 的上下文管理器(Context Manager)
Python 通过 with open(...) as f: 语法遵循上下文管理器协议。进入代码块时调用 f.__enter__() 并返回文件对象;无论内部是正常执行完毕还是因为异常(包括 KeyboardInterrupt、MemoryError 等)非正常中断,Python 解释器都会确保调用 f.__exit__(exc_type, exc_val, exc_tb),在该方法内部安全调用底层 close() 释放系统文件描述符。
2. Java 的 try-with-resources 语法
Java 7 引入的 try (FileInputStream fis = new FileInputStream(...)) 则是针对 java.lang.AutoCloseable 接口的编译期语法糖。与早期冗长且容易写错的 try-finally 相比,编译器会自动在字节码层面生成关闭逻辑,且能妥善处理“抑制异常(Suppressed Exceptions)”——若业务代码抛出主异常,随后的 close() 同样抛出次生异常时,次生异常会被挂载到主异常的抑制列表上,避免主异常被吞噬。
四、异常处理模型与类型系统约束
两门语言在错误处理上的类型系统差异也直接体现在文件读写中:
- Python 的运行时异常模型:Python 所有的 I/O 错误均继承自内置的
OSError(例如子类FileNotFoundError、PermissionError)。Python 不存在“受检异常(Checked Exception)”,调用open()或read()时无需在函数签名中声明raises,是否捕获完全由调用者自主决定。 - Java 的强制受检异常:
FileInputStream的构造方法声明了throws FileNotFoundException,其read()和close()方法声明了throws IOException。由于它们属于编译期受检异常,Java 编译器会强制要求编写try-catch块或者在当前方法签名上显式追加throws IOException,否则代码无法通过编译。这种约束虽然增加了语法冗余,但将潜在的 I/O 失败显式暴露在类型系统中。
五、写操作对应关系:open(..., 'wb') 与 FileOutputStream
在写操作方面,Python 依旧复用 open() 语法,仅需将模式参数指定为 'wb'(覆盖写入)或 'ab'(追加写入);而 Java 则提供了与 FileInputStream 严格成对的 FileOutputStream 类。
# Python 写入二进制文件
def write_binary_data(filepath: str, data: bytes) -> None:
    with open(filepath, 'wb') as f:
        f.write(data)
        # 退出 with 块时自动 flush 并 close
import java.io.FileOutputStream;
import java.io.IOException;

public class BinaryWriterExample {
    // Java 写入二进制文件 (第二个参数指定是否追加)
    public static void writeBinaryData(String filepath, byte[] data) throws IOException {
        try (FileOutputStream fos = new FileOutputStream(filepath, false)) {
            fos.write(data);
            // FileOutputStream 本身无内置缓冲,但仍建议显式调用 flush()
            fos.flush();
        }
    }
}
FileInputStream 与 FileOutputStream 均为无缓冲的裸流。如果采用单字节读取方法 read() 循环处理百万次,每一次调用都会陷入操作系统内核态,引发严重的性能瓶颈。在 Java 生产环境中,若需高性能字节处理,通常外层套接 BufferedInputStream 或改用 NIO 的 FileChannel / Files.readAllBytes()。
六、核心技术差异汇总与工程选型建议
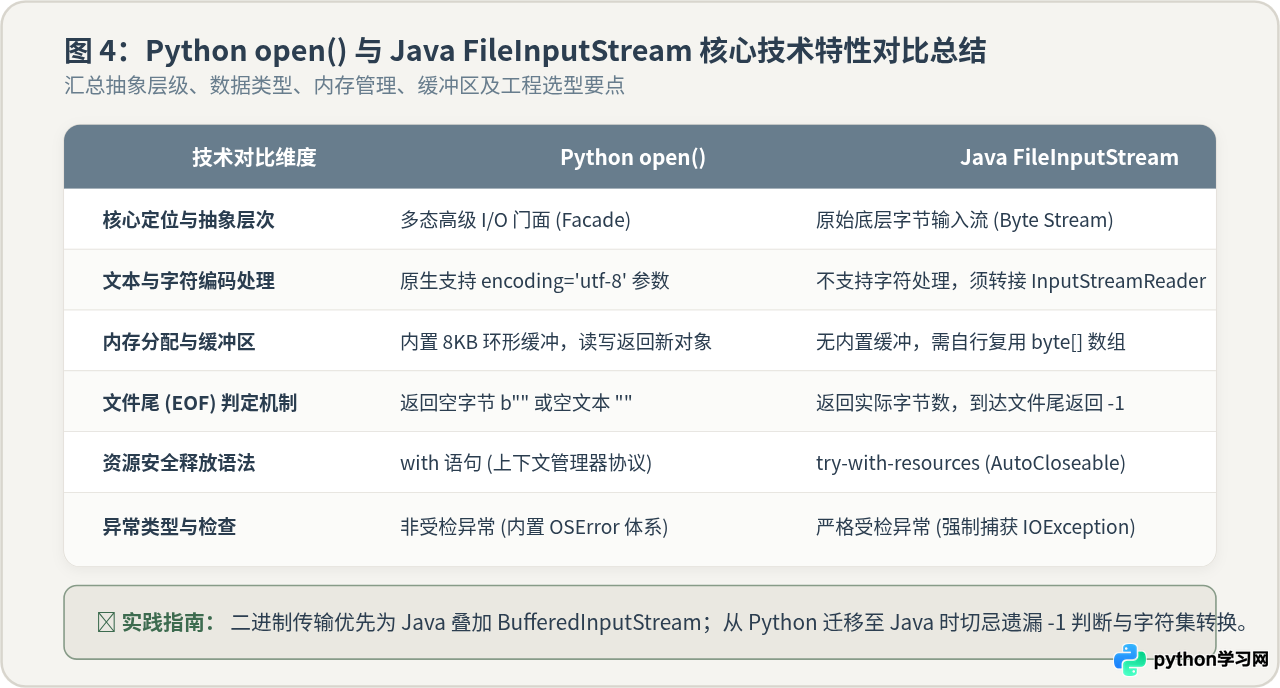
下表对 Python open() 与 Java FileInputStream 在各维度的关键技术表现进行总结对照:
| 对比维度 | Python open() | Java FileInputStream |
|---|---|---|
| 设计定位 | 多态的高级 I/O 统一接口 | 底层的原始字节单向输入管道 |
| 文本支持 | 支持 encoding='utf-8' 原生编解码 |
不支持,必须转接 InputStreamReader |
| 默认缓冲 | 默认开启系统级缓冲区(通常 8KB) | 无缓冲,建议搭配 BufferedInputStream |
| EOF 标志 | 返回空对象(b"" 或 "") |
返回整型值 -1 |
| 内存模型 | 每次读取返回新构建的堆对象 | 依赖外部预创建 byte[] 复用填充 |
| 资源管理 | with 语句(__enter__ / __exit__) |
try-with-resources(AutoCloseable) |
| 异常控制 | 非受检 OSError 层次结构 |
强制受检 IOException 声明 |
七、总结
通过对两者的对比可以看出,Python 的 open() 追求开发体验与接口通用性,通过一个函数封装了从底层描述符管理、缓冲区分配到字符编解码的完整流水线,适合需要快速、直观操作文件的场景;Java 的 FileInputStream 则是经典面向对象与 I/O 管道流思想的典型体现,它将纯粹的字节传输与缓冲、编码、行读取等高级职能彻底解耦,为底层性能微调和复杂网络/管道流适配提供了坚实的基础。
在工程迁移与跨语言实践中,最常犯的错误主要集中在两点:一是将 Python 代码逻辑直译为 Java 时遗漏对 read() == -1 的判断,导致死循环或数组越界;二是在 Java 中直接用字节流读取文本而忽略了跨平台字符集(如 UTF-8 与 GBK)的显式指定。掌握两种语法的底层实质,便能在不同语言栈中写出兼具安全性与高性能的文件 I/O 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









