

零基础学Python先学什么?变量、循环与函数学习顺序建议

一、为什么顺序不能乱?三者的内在依赖逻辑
很多零基础自学者容易陷入一个误区:同时翻开语法书的各个章节,今天看列表,明天看循环,后天看函数,导致编写代码时不知道何时该定义变量,何时该封装函数。计算机程序的运行本质可以概括为:输入数据 → 处理变换 → 产生输出。这决定了基础语法的认知链路必须遵循数据的流向与处理复杂度。
在没有掌握“变量”之前,程序没有任何状态可言。如果在没有理解内存中如何暂存数据时直接学习循环,就无法理解循环体内部“计数器累加”和“列表迭代”到底在改变什么;而如果在没有彻底掌握循环与分支之前直接学习函数,写出的函数往往只是简单的线性指令堆砌,无法体会参数传递、返回值以及局部作用域的真正价值。
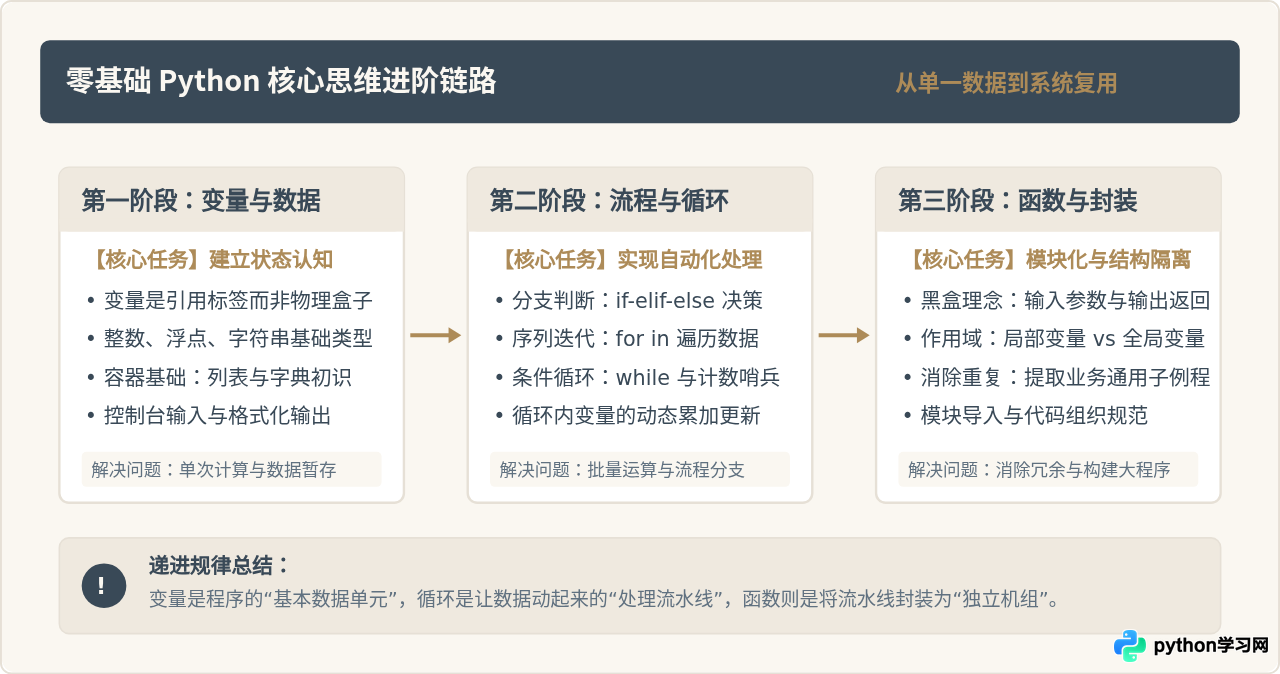
图 1:零基础 Python 核心知识递进阶梯与解决能力对照
二、第一阶段:先学变量与数据结构——建立“状态”认知
学习编程的第一步,是让计算机记住我们提供的数据。在 Python 中,“变量”的本质是给内存中的对象贴上的名字标签,而不是固定的储物抽屉。
1. 掌握变量赋值与引用的本质
在 Python 中执行 x = 10 时,解释器先在内存中创建整数对象 10,然后让名字 x 指向这个对象。当执行 x = x + 5 时,并不是把抽屉里的 10 抹掉改成 15,而是创建了新的对象 15,并将标签 x 重新贴到 15 上。
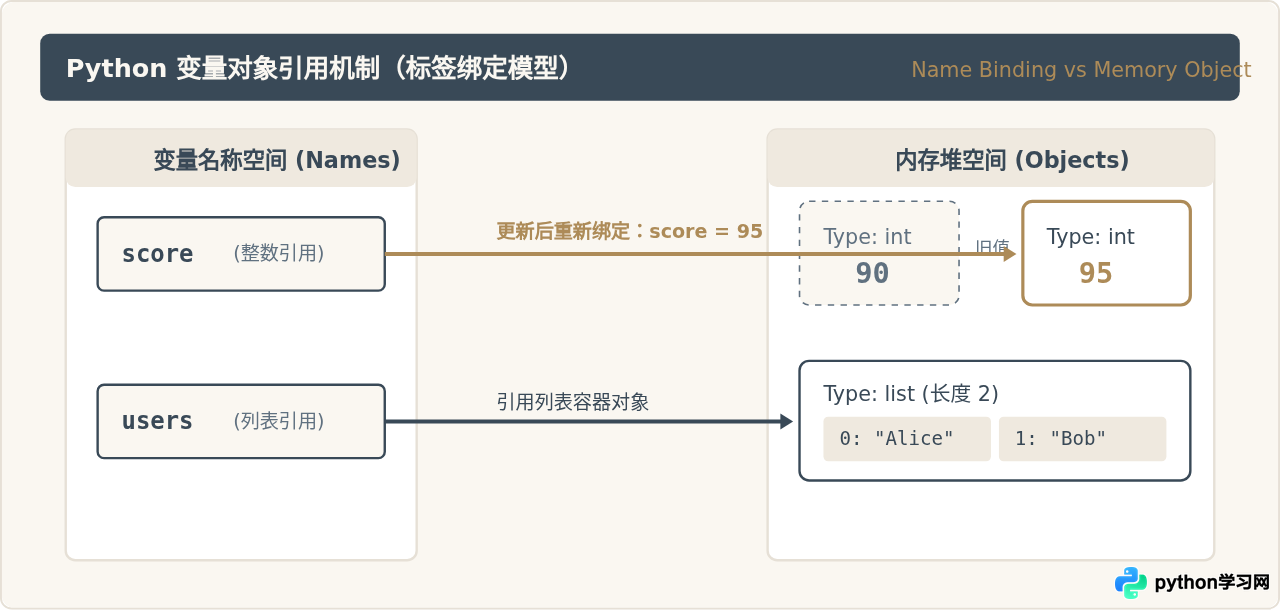
图 2:Python 变量本质是名称空间向内存对象的动态引用
2. 第一阶段必须夯实的四项基础
- 基础数据类型:掌握整数(
int)、浮点数(float)、字符串(str)和布尔值(bool)。理解为什么"10" + "20"得到的是"1020",而10 + 20是30。 - 类型转换:熟练使用
int()、str()、float()进行显式转换。这是后续处理用户键盘输入或读取外部文件必不可少的能力。 - 基础容器初识:至少掌握列表(
list)的定义与按索引访问(items[0])、向列表追加元素(append)。 - 标准输入输出:掌握
print()的 f-string 格式化输出(如f"当前成绩: {score}")与input()接收字符串输入。
# 第一阶段代码示例:变量定义、类型转换与格式化输出
base_price = 80.0          # float: 单价
quantity_str = "3"         # str: 来自输入的文本形式数字
quantity = int(quantity_str) # 显式类型转换转换为整数

total_amount = base_price * quantity
print(f"购买数量:{quantity},应付总额:{total_amount:.2f} 元")
三、第二阶段:再学分支与循环——实现从“单步执行”到“自动重复”
掌握了变量之后,程序只能从第一行按顺序执行到最后一行。现实中的需求绝大多数都是需要根据条件选择路径,或对成百上千条数据进行重复运算。此时就要进入第二阶段:分支判断(if)与循环(for / while)。
1. 循环的核心:遍历与状态累加
初学者学循环最容易犯的错误是“就循环论循环”,把 for i in range(5): print(i) 敲了十遍,依然不知道循环能在实际业务中干什么。在实际编程中,循环几乎总是与变量配合使用的。最典型的模式是“在循环前初始化一个累加变量,在循环体内根据条件更新该变量,循环结束后输出最终状态”。
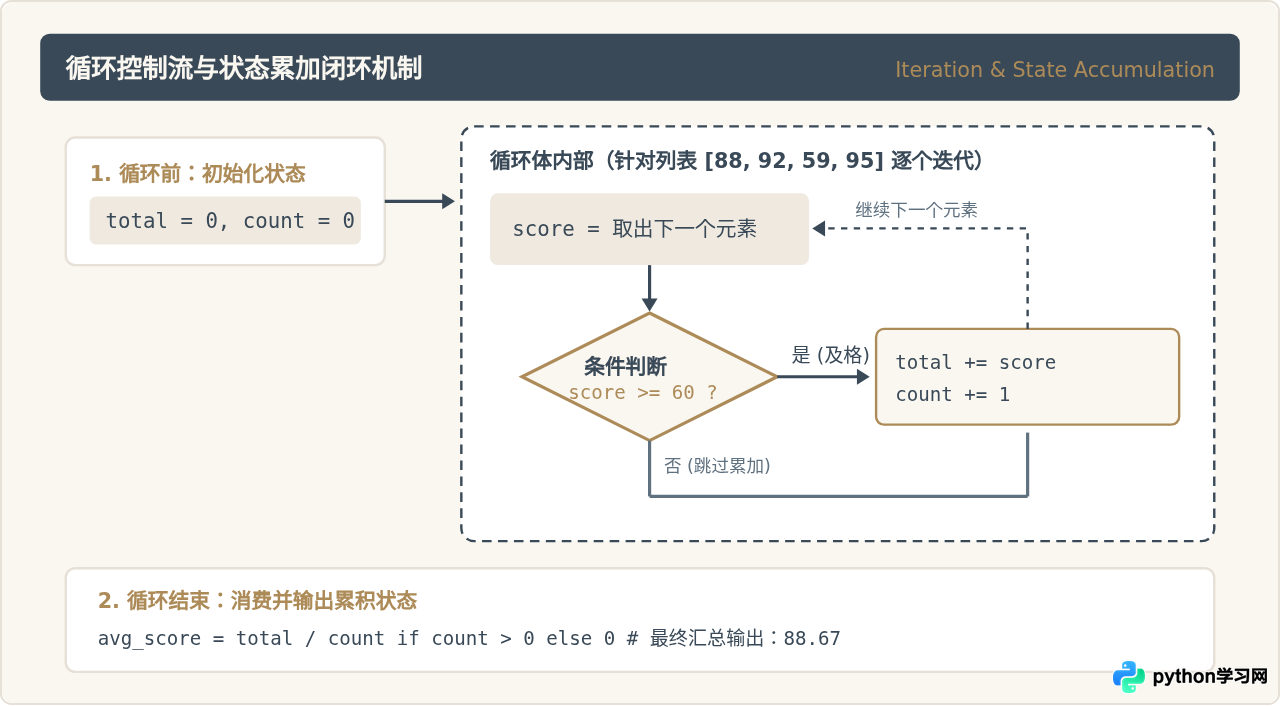
图 3:循环中数据遍历与状态变量更新的标准流程图
2. 第二阶段的学习优先级
- 先学
for ... in序列遍历:Python 的for循环本质是迭代器遍历,优先学会直接遍历列表、字符串,而不是一开始就去硬套 C 语言风格的下标下标循环。 - 掌握
range()生成数字序列:需要明确执行固定次数(如“执行 10 次”)时,使用range(10)。 - 结合
if-elif-else进行过滤与分支统计:在循环体内部嵌套条件分支,区分正常值与异常值、及格与不及格。 - 理解
break与continue:continue用于跳过当前轮次的剩余代码直接开始下一轮;break用于提前终止整个循环。 - 最后掌握
while条件循环:while用于“直到满足某种未知结束条件时才停止”(例如用户输入“quit”退出、猜数字游戏等),并切记在循环体内更新条件变量以避免死循环。
# 第二阶段代码示例:遍历列表、分支过滤与累加
raw_scores = [88, 92, 45, 78, 59, 96]
passed_total = 0
passed_count = 0

for score in raw_scores:
    if score < 60:
        continue  # 不及格跳过,不计入统计
    passed_total += score
    passed_count += 1

average = passed_total / passed_count if passed_count > 0 else 0
print(f"及格人数:{passed_count},及格者平均分:{average:.2f}")
四、第三阶段:后学函数与模块化——把“动作”打包成可复用黑盒
当你可以熟练使用变量和循环解决一个具体的计算问题时,往往会发现代码越写越长:相同的循环统计逻辑在处理不同列表时,被反复复制粘贴了好几次。这时候,引入函数(Function)的时机就成熟了。
1. 从“面条式代码”到“黑盒契约”
函数的本质是把一组语句封装起来,赋予一个明确的名字。学习函数时,最重要的是建立输入参数(Arguments)与输出返回值(Return Value)的契约意识:
- 黑盒思想:函数外部只需要知道给函数什么参数、能得到什么结果,不需要关心函数内部究竟开了几层循环。
- 避免使用全局变量:初学者容易直接在函数内部修改函数外部定义的变量。必须明确:函数应通过参数获取数据,通过
return送出结果,保持内部纯粹。 - 局部变量的作用域(Scope):在函数内部创建的变量只在函数运行期间有效,函数执行完毕后即被销毁,外部无法直接访问。
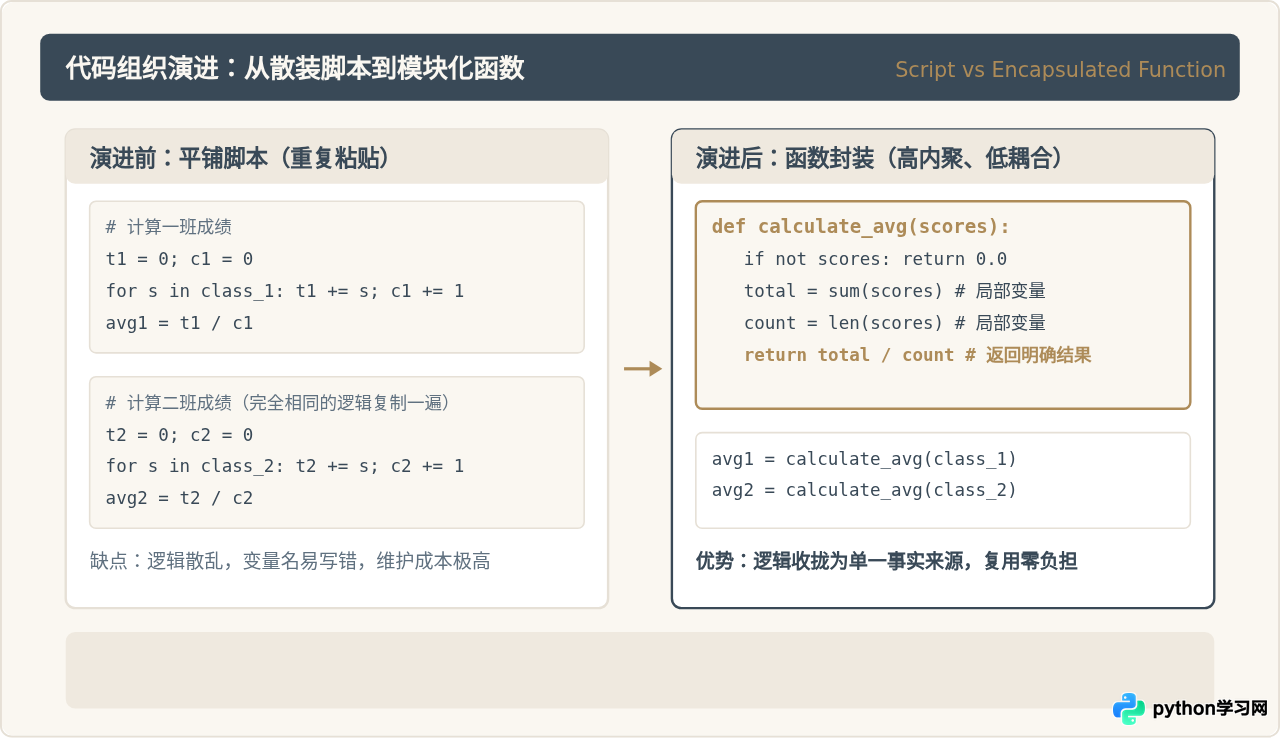
图 4:散装脚本向函数封装的结构重构示意
五、综合实战演练:串联三者的完整案例
为了直观感受三者的协同工作机制,我们通过一个实际场景进行演示:处理一批商品订单,过滤掉无效金额,计算折扣,并最终生成对账摘要。
# 综合示例:变量、循环与函数的标准协同结构

def process_orders(order_list, min_valid_amount=10.0, discount_rate=0.9):
    """
    清洗订单数据并计算折后总额与有效笔数
    :param order_list: 包含订单原始金额的列表
    :param min_valid_amount: 最小有效金额阈值
    :param discount_rate: 折扣率
    :return: 包含处理结果的字典
    """
    # 1. 局部状态变量初始化
    valid_count = 0
    total_payable = 0.0

    # 2. 循环遍历与分支判断
    for amount in order_list:
        # 异常数据过滤
        if amount < min_valid_amount:
            continue

        # 状态累加运算
        discounted = amount * discount_rate
        total_payable += discounted
        valid_count += 1

    # 3. 结果打包并返回
    return {
        "valid_count": valid_count,
        "total_payable": round(total_payable, 2)
    }

# 主程序调用入口
raw_orders = [120.0, 5.0, 250.0, -10.0, 88.0, 310.0]
summary = process_orders(raw_orders, min_valid_amount=20.0, discount_rate=0.85)

print(f"有效订单笔数:{summary['valid_count']}")
print(f"实付总金额:{summary['total_payable']} 元")
order_list、min_valid_amount、discount_rate是函数的输入变量;valid_count与total_payable是用于记录内部状态的变量;for amount in order_list:是负责自动化批量处理的循环控制线;- 整个
process_orders是一个可对任意订单批次复用的独立函数。
六、零基础自学必须避开的三个误区
- 误区一:只看不练,误以为“看懂了就是掌握了”。
语法书上的for循环看起来极其简单,但初学者一旦关上教程、面对空无一物的编辑器,连变量该放在循环外面还是里面都会纠结。每学完一个知识点,必须亲手敲出至少两个具体的微型题目。 - 误区二:过早跨入面向对象编程(Class / OOP)。
很多初学者刚搞清def函数,就急着去看类(class)、继承、多态。对于零基础学习者而言,过早接触类只会带来额外的认知负荷。在能够用“数据结构 + 循环 + 函数”熟练解决常规问题之前,不要强行写类。 - 误区三:函数过大,一个函数写上百行。
学会函数之后,切忌把所有业务流程塞进一个叫main()的巨大函数里。一个良好设计的函数应该只做一件事,让函数的输入输出一目了然。
七、总结与各阶段达标自测清单
回顾本文的核心建议,零基础学 Python 请务必按以下顺序推进,并在达到自测标准后再进入下一个环节:
- 第一阶段(变量与数据类型):能够不看参考资料,独立完成接收用户输入身高体重、进行浮点计算并用 f-string 格式化输出 BMI 数值。
- 第二阶段(分支与循环):能够独立写出一个程序,遍历包含正负整数的列表,统计出所有大于零的偶数的个数与总和。
- 第三阶段(函数与模块化):能够将第二阶段的统计逻辑封装为一个函数,接收任意列表作为入参,并以字典形式返回统计结果。
掌握了这一套扎实的底层认知链条后,无论是后续学习网络请求、数据分析还是自动化脚本,你都将具备清晰的代码组织直觉。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









