

怎么排查Python多线程死锁与资源竞争问题
详细讲解Python多线程开发中死锁与资源竞争问题的排查方法,包括死锁的识别、常见原因分析、排查工具使用、代码修复策略及预防措施。
多线程程序卡住不动,或者运行结果时对时错,多数情况下是死锁或资源竞争导致的。排查这两类问题的核心思路是:先确认程序是否真的卡死(死锁)还是结果不可预期(竞争),然后用线程转储、日志和专用工具定位到具体的锁或共享变量,最后通过调整加锁顺序、缩小临界区或更换同步原语来修复。本文按照这个流程逐步展开。
区分死锁与资源竞争
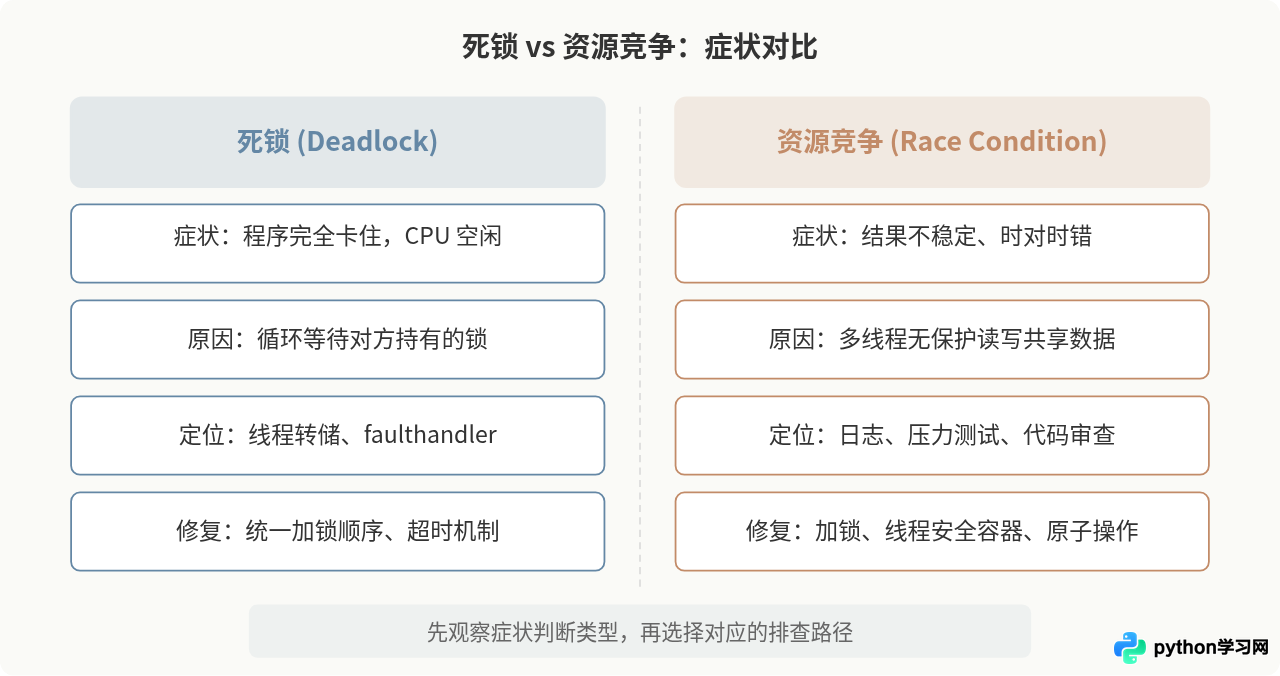
排查之前先区分症状,因为两者的表现、定位手段和修复方向完全不同。
死锁的典型表现是程序完全卡住——CPU占用极低,不输出任何内容,也不退出。至少两个线程各持有一把锁,同时等待对方持有的另一把锁,形成循环等待。程序会一直挂在那里,直到被外部强制终止。
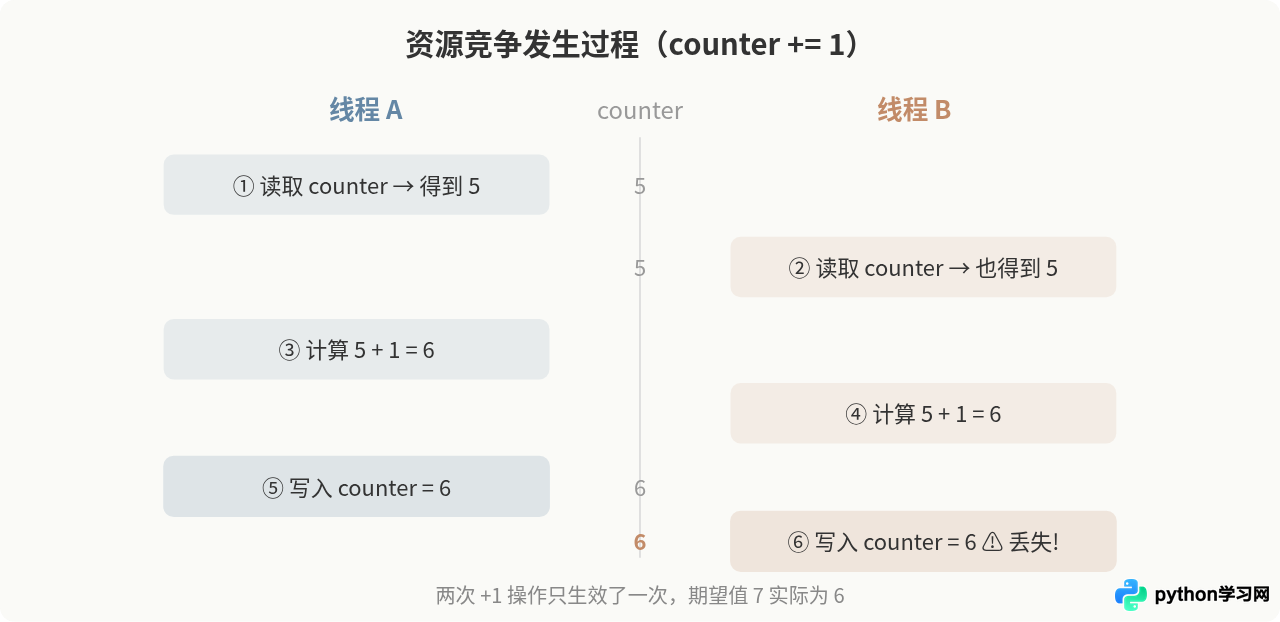
资源竞争(竞态条件)的表现则是程序能运行完,但结果不稳定:同样的输入,有时正确有时错误,或者在不同机器上行为不一致。原因是多个线程同时读写同一份数据,而没有做同步保护。由于Python的GIL只保证字节码级别的原子性,像 counter += 1 这样看似简单的操作实际上包含读取、计算、赋值三步,仍然可能被其他线程打断。
排查死锁的具体方法
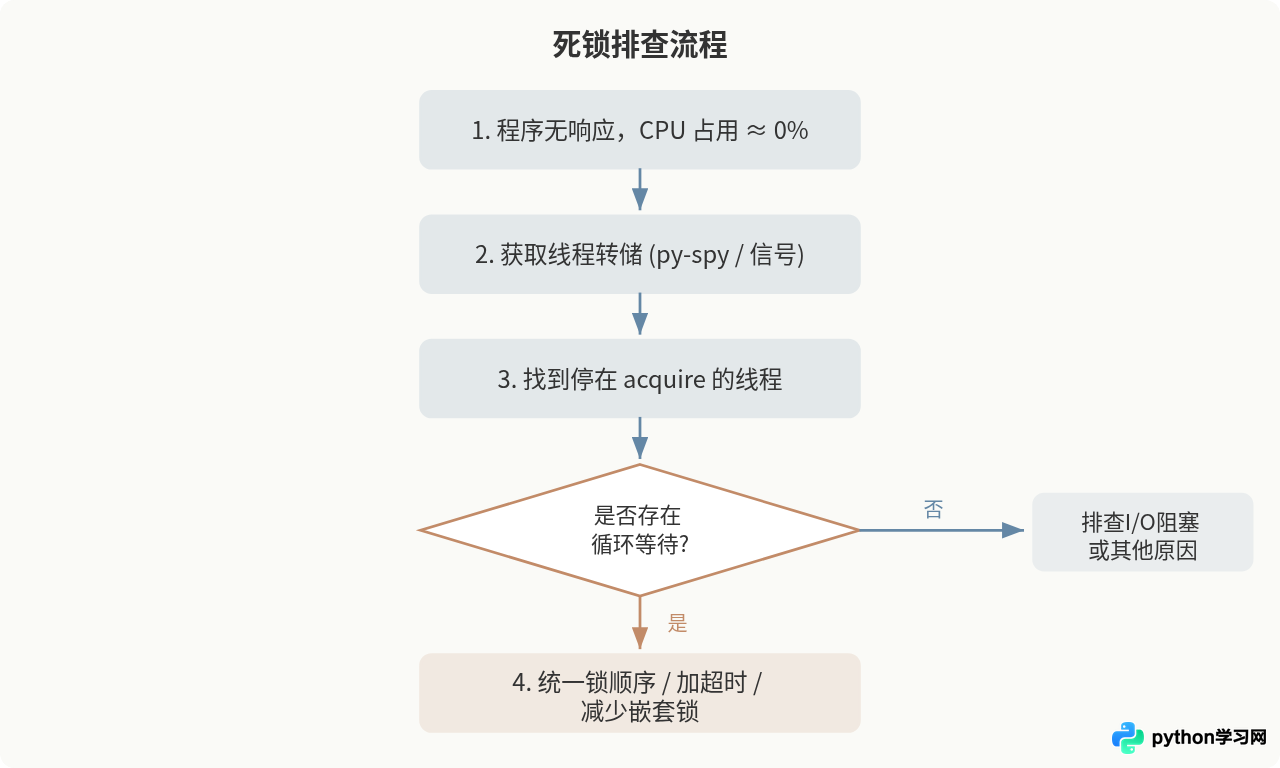
第一步:确认程序确实卡死
当程序无响应时,先排除网络阻塞、I/O等待等其他原因。在终端中用 top 或 htop 观察进程CPU占用,如果接近0%且程序不退出,死锁的可能性很高。
第二步:获取线程转储
Python提供了几种方式查看所有线程当前停在什么位置。
方法一:发送信号触发 faulthandler
在程序启动时加入 faulthandler.enable(),或者设置环境变量 PYTHONFAULTHANDLER=1。程序卡住后,在另一个终端发送信号:
# Linux / macOS
kill -SIGUSR1 <pid>
程序的标准错误输出会打印所有线程的调用栈。如果没有提前启用 faulthandler,也可以用 kill -SIGQUIT <pid>(某些环境下有效),或者使用下面的方法。
方法二:在代码中注入转储逻辑
在程序入口处注册一个信号处理函数,随时打印线程状态:
import signal
import sys
import threading
import traceback

def dump_threads(signum, frame):
    for th_id, stack in sys._current_frames().items():
        th_name = "unknown"
        for t in threading.enumerate():
            if t.ident == th_id:
                th_name = t.name
                break
        print(f"\n--- Thread {th_name} (id={th_id}) ---")
        traceback.print_stack(stack)

signal.signal(signal.SIGUSR1, dump_threads)
程序卡住后,执行 kill -SIGUSR1 <pid> 即可在终端看到每个线程的完整调用栈。
方法三:用 debugger 附加
如果程序已经卡住且没有预埋信号处理,可以用 py-spy 从外部附加:
pip install py-spy
py-spy dump --pid <pid>
它会输出所有线程的Python调用栈,不需要修改程序代码。
第三步:从转储中定位死锁点
拿到线程转储后,重点找那些停在 acquire 调用上的线程。典型的死锁转储看起来类似这样:
两个线程分别等待对方持有的锁,形成环路。记下涉及的锁对象和代码位置,就能定位到死锁根源。
一个完整的死锁复现与排查示例
下面这段代码故意制造了一个典型的锁顺序不一致死锁:
import threading
import time

lock_a = threading.Lock()
lock_b = threading.Lock()

def task1():
    with lock_a:
        print("task1 持有 lock_a,等待 lock_b ...")
        time.sleep(0.1)  # 增加死锁概率
        with lock_b:
            print("task1 获得了两把锁")

def task2():
    with lock_b:
        print("task2 持有 lock_b,等待 lock_a ...")
        time.sleep(0.1)
        with lock_a:
            print("task2 获得了两把锁")

t1 = threading.Thread(target=task1, name="Worker-1")
t2 = threading.Thread(target=task2, name="Worker-2")
t1.start()
t2.start()
t1.join(timeout=5)
t2.join(timeout=5)

if t1.is_alive() or t2.is_alive():
    print("检测到线程未退出,可能发生死锁")
运行后程序会卡住。用 py-spy dump --pid <pid> 查看,就能看到 Worker-1 停在 lock_b.acquire()、Worker-2 停在 lock_a.acquire(),确认了交叉等待。
排查资源竞争的具体方法
识别竞争的迹象
资源竞争不像死锁那样程序直接卡住,它往往藏在结果里。以下迹象值得注意:计数值比预期偏小、列表数据丢失或重复、同一段逻辑偶尔抛出 KeyError 或 IndexError、多次运行结果不一致。
用压力测试放大问题
竞争问题在低并发时很难复现,增加线程数和循环次数可以提高触发概率:
import threading

counter = 0

def increment():
    global counter
    for _ in range(100000):
        counter += 1  # 不是原子操作

threads = [threading.Thread(target=increment) for _ in range(10)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print(f"期望值: 1000000, 实际值: {counter}")实际值几乎不可能达到一百万,每次运行都不同——这就是典型的资源竞争。
通过日志定位竞争点
在怀疑有竞争的代码段前后加日志,记录线程名和关键变量的值:
import logging
import threading

logging.basicConfig(
    format="%(asctime)s [%(threadName)s] %(message)s",
    level=logging.DEBUG
)

def update_data(shared_dict, key):
    logging.debug(f"读取前: {shared_dict}")
    val = shared_dict.get(key, 0)
    val += 1
    # 如果这里另一个线程也在修改同一个 key,就会丢失更新
    shared_dict[key] = val
    logging.debug(f"写入后: {shared_dict}")
当日志中出现两个线程读到相同的旧值、然后各自写入的情况,就找到了竞争发生的位置。
使用 threading 模块辅助检测
threading.enumerate() 可以列出所有活跃线程,帮助确认是否有预期之外的线程在运行。结合 threading.Lock 的 locked() 方法,也能在日志中记录某把锁是否已被持有。
修复死锁的常用策略
统一加锁顺序
死锁最常见的成因是不同线程以不同顺序获取多把锁。修复方法很简单:为所有锁约定一个全局顺序,所有线程都按这个顺序加锁。以前面的银行转账例子为例:
def transfer(from_account, to_account, amount):
    # 按 id 排序,保证无论谁转给谁,加锁顺序一致
    first, second = sorted(
        [from_account, to_account], key=lambda a: id(a.lock)
    )
    with first.lock:
        with second.lock:
            from_account.balance -= amount
            to_account.balance += amount
使用超时避免永久等待
Lock.acquire(timeout=N) 可以设置获取锁的超时时间。如果在指定时间内拿不到锁,方法返回 False,程序可以记录日志、释放已持有的锁然后重试,而不是永远卡住:
acquired = lock_b.acquire(timeout=3)
if not acquired:
    logging.warning("获取 lock_b 超时,释放 lock_a 后重试")
    lock_a.release()
    # 执行重试逻辑
减少锁的嵌套
能不嵌套就不嵌套。如果必须持有多把锁,考虑是否能将操作合并到一把锁的保护范围内,或者使用 threading.RLock(可重入锁)来避免同一线程对同一把锁的重复获取导致的自死锁。
修复资源竞争的常用策略
给共享数据加锁
最直接的办法。把前面 counter += 1 的例子加上锁保护:
lock = threading.Lock()
counter = 0

def increment():
    global counter
    for _ in range(100000):
        with lock:
            counter += 1
加锁后结果稳定为一百万。但要注意锁的粒度——锁保护的范围太大会严重影响并发性能。
使用线程安全的数据结构
queue.Queue 是Python标准库提供的线程安全队列,适合生产者-消费者模式。collections.deque 的 append 和 popleft 在CPython下也是线程安全的(受GIL保护),但这不是语言规范保证的,跨实现时不能依赖。
考虑用 concurrent.futures 替代手动管理线程
ThreadPoolExecutor 封装了线程池和任务提交,减少了手动管理锁的场景:
from concurrent.futures import ThreadPoolExecutor, as_completed

def process_item(item):
    # 每个任务处理独立数据,不需要共享状态
    return item * 2

with ThreadPoolExecutor(max_workers=4) as pool:
    futures = [pool.submit(process_item, i) for i in range(10)]
    results = [f.result() for f in as_completed(futures)]
把共享状态的需求设计掉,比加锁更可靠。
预防措施与检查清单
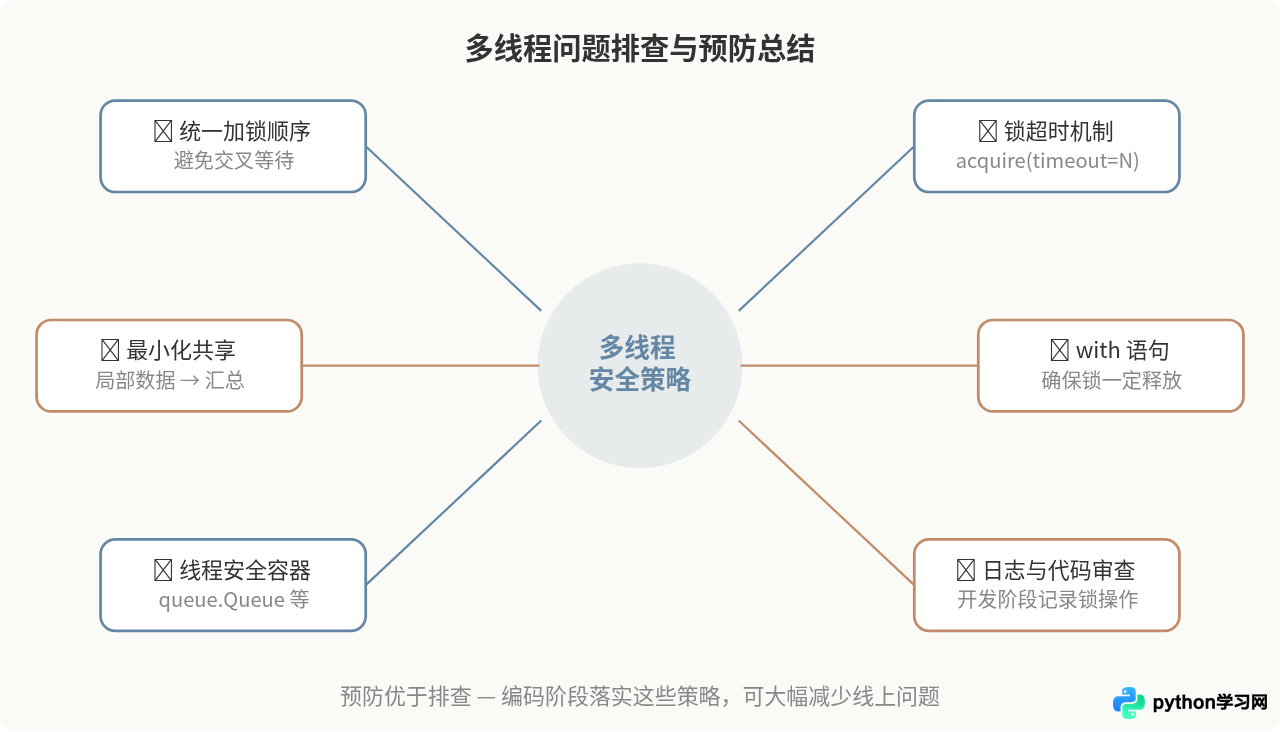
事后排查总是比事前预防花费更多时间。在编写多线程代码时,注意以下几点能大幅减少死锁和竞争的发生:
- 最小化共享状态:每个线程尽量操作自己的局部数据,最后汇总结果。
- 锁的粒度适中:太粗会丧失并发优势,太细会增加死锁风险和代码复杂度。
- 总是用 with 语句管理锁:避免因异常导致锁未释放。
- 给 join 设置超时:
thread.join(timeout=N)可以防止主线程永久等待。 - 为锁添加日志:在开发阶段记录锁的获取和释放,方便排查。
- 代码审查重点看锁:检查是否有嵌套锁、锁顺序是否一致、是否有遗漏的保护。
counter += 1 在字节码层面是多条指令(LOAD → ADD → STORE),线程切换可能发生在任意两条指令之间。GIL 只保护解释器内部状态,不保护你的业务数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









