

Python中怎么用str.join()高效拼接列表字符串
深入讲解Python中使用str.join()高效拼接列表字符串的核心语法、底层内存单次分配原理、非字符串类型转换处理方法与边界条件实践。
str.join(iterable) 方法。与在循环中使用 + 号连续累加相比,str.join() 能够一次性预估并分配所需的连续内存空间,将拼接的时间复杂度稳定在 \(O(N)\) 的线性范围。本文直接拆解该方法的基本语法、底层内存机制、非字符串元素转换以及实战边界细节。
一、核心语法与调用形式:为什么分隔符写在前面
许多初学 Python 的开发者在想要合并列表时,直觉上会写出类似 my_list.join(",") 这样的代码,但实际上 Python 的设计是 "分隔符".join(可迭代对象)。这种设计的关键原因在于解耦:在 Python 中,可被拼接的数据源不仅限于列表(list),还包括元组(tuple)、集合(set)、字典键集合、甚至生成器(generator)。如果将 join 方法挂载在各个容器类上,每个容器都需要维护一套拼接逻辑;而把方法归属于字符串分隔符自身,由分隔符负责将任意可迭代序列穿插串联,职责最为纯粹。
最基础的调用示例包括无缝拼接、逗号分隔拼接以及按换行符输出:
# 基础列表数据
words = ["Python", "Rust", "Go", "C++"]

# 1. 紧密无缝拼接(空字符串作为分隔符)
merged = "".join(words)
print(merged)
# 示例输出:PythonRustGoC++

# 2. 常用逗号与空格分隔拼接
csv_line = ", ".join(words)
print(csv_line)
# 示例输出:Python, Rust, Go, C++

# 3. 按换行符分行拼接
multiline = "\n".join(words)
print(multiline)
# 示例输出:
# Python
# Rust
# Go
# C++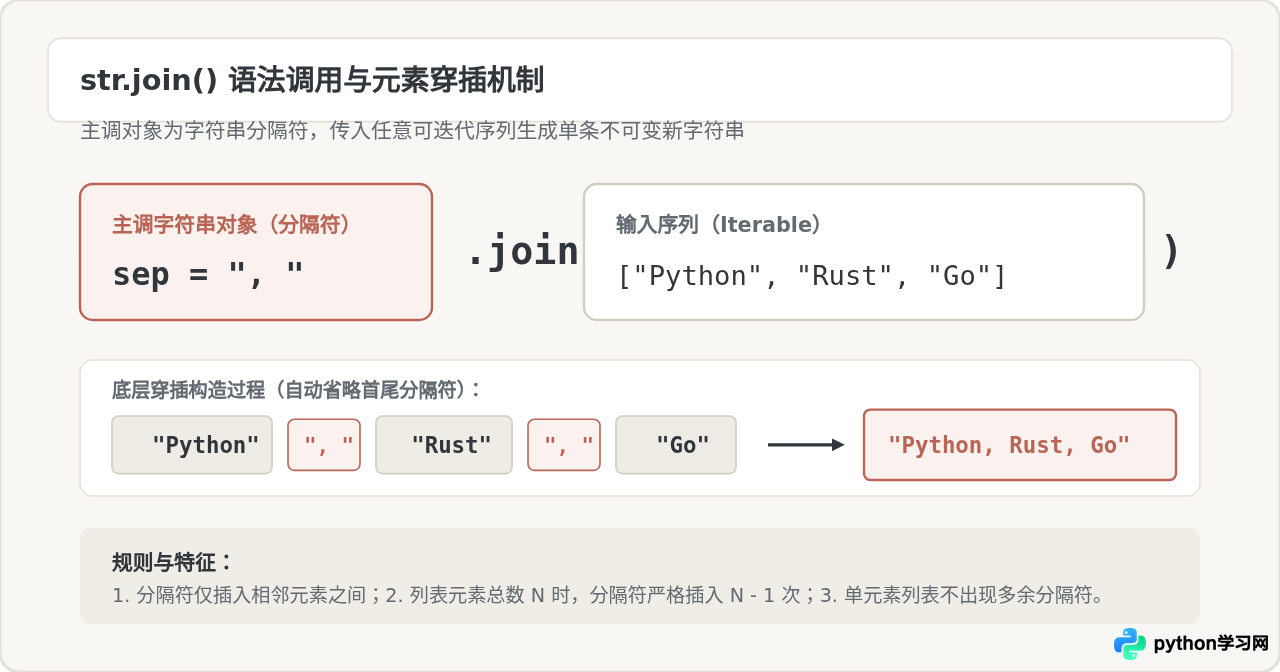
二、性能对比与底层原理:为什么 join 远胜于加号循环
要深刻理解 str.join() 的必要性,必须从 Python 字符串对象的不可变性(Immutability)说起。在 CPython 解释器中,字符串一旦分配就不能原地修改。当编写如下加号循环代码时:
# 不推荐的低效写法:使用 + 号反复累加
result = ""
for item in word_list:
    result = result + item + ","
每一次执行 result + item,Python 解释器都无法直接在原 result 内存末端追加内容。相反,它必须经过以下流程:
- 向操作系统重新申请一块更大的新内存空间;
- 将旧
result里的全部字符一个字节一个字节拷贝到新内存; - 将新元素
item拷贝到新内存; - 销毁旧的
result对象以等待垃圾回收。
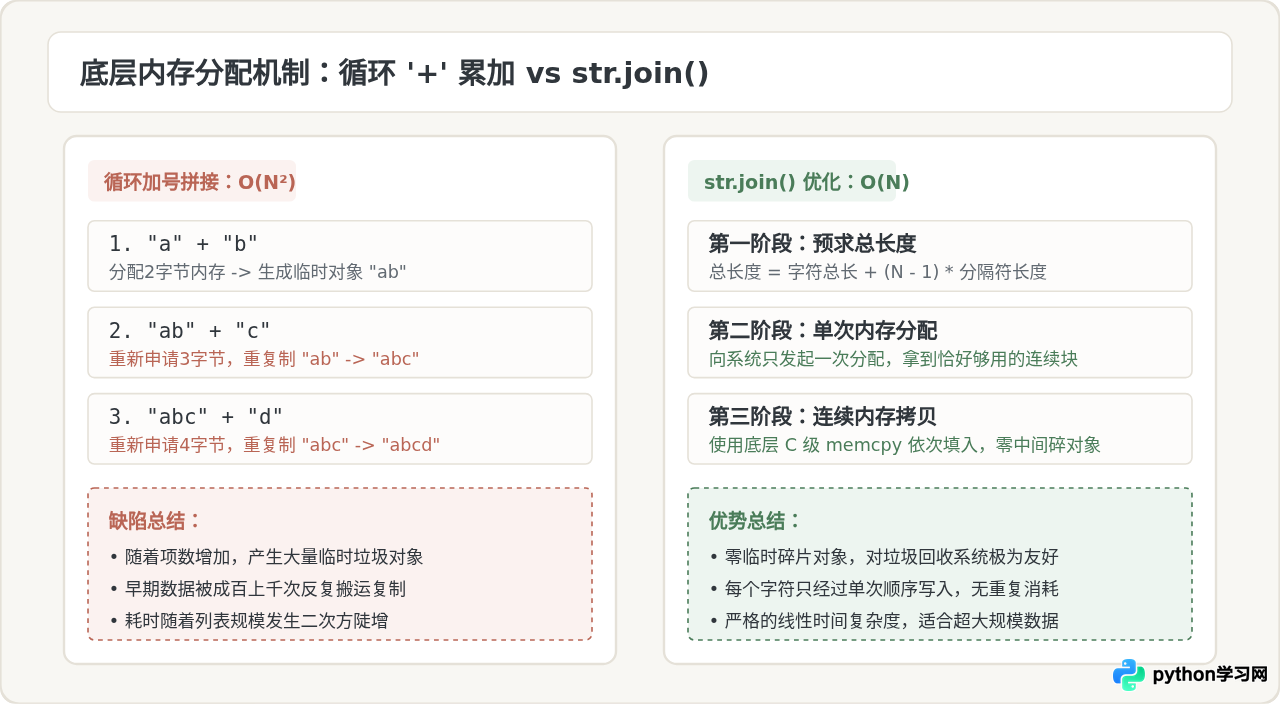
如果列表中有 \(N\) 个元素,那么前面的字符就会被重复复制 \(N\) 次。整个循环的累计字符复制量随着元素数量呈平方级增长,其整体时间复杂度恶化为 \(O(N^2)\)。当处理成千上万行文本或日志流时,程序会出现明显的卡顿。
而 str.join() 采用了高效的两遍扫描与单次内存分配机制:
- 第一阶段(预计算尺寸):快速遍历目标列表,将所有子字符串的长度累加,再加上预估的分隔符总长度:\(\text{总长度} = \sum \text{len}(item) + (N - 1) \times \text{len}(sep)\)。
- 第二阶段(单次内存写入):直接调用底层内存分配器,一次性划拨恰好够用的连续内存块,随后通过底层 C 语言的内存拷贝函数(如
memcpy)依次将数据写入该缓冲区。
因此,整个拼接过程只分配一次最终内存,所有字符仅被读取和拷贝一次,耗时被严格锁定在 \(O(N)\) 的线性级别。
三、非字符串元素的转换管道:避免 TypeError
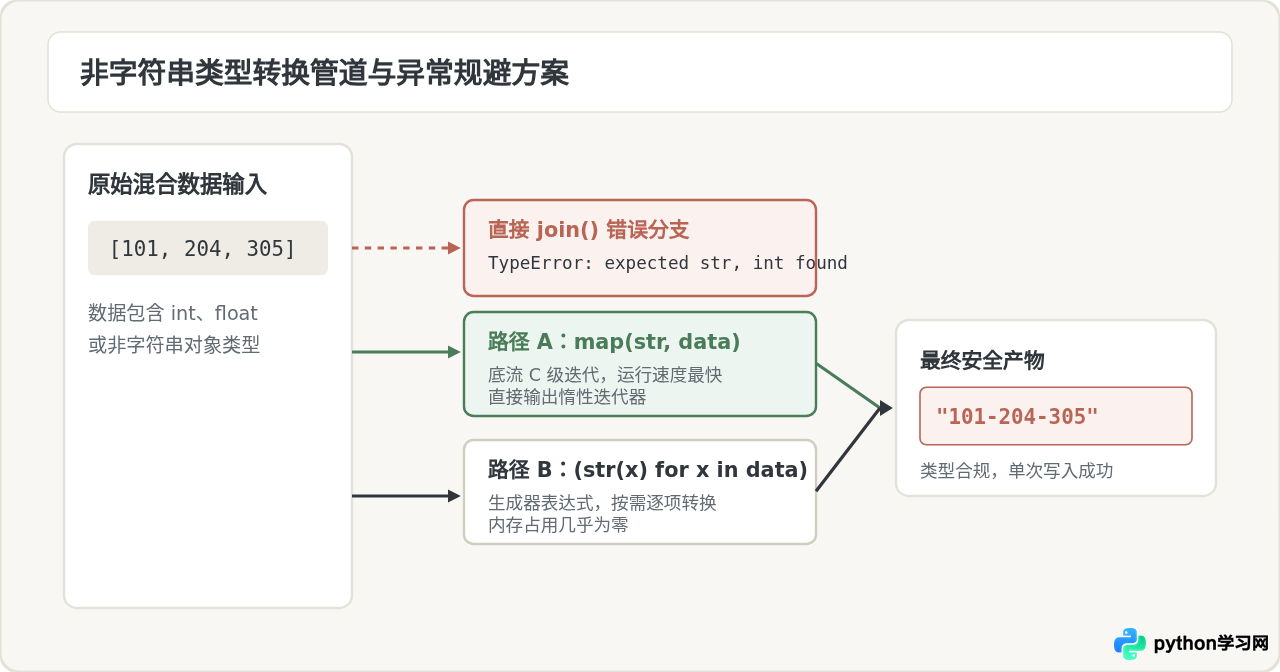
在实际开发中,列表中的数据常常来自数据库、配置文件或计算结果,往往包含数字(int、float)、布尔值(bool)甚至是对象实例。此时若直接传入 join,程序会立刻中断并抛出异常:
# 错误示例:列表包含非字符串类型
numbers = [101, 204, 305, 408]
result = "-".join(numbers)
# 抛出异常:
# TypeError: sequence item 0: expected str instance, int found
这是因为 str.join() 为了追求底层性能,严格要求传入的可迭代对象中的每一个元素都必须是 str 实例,内部不会隐式调用 str() 进行强制转换。针对这种场景,有三种常见的转换与拼接管道:
1. 使用生成器表达式(惰性求值,推荐处理大序列)
# 生成器表达式写法:括号内部不产生额外的中间列表
data = [101, 204, 305, 408]
result = "-".join(str(x) for x in data)
print(result)
# 示例输出:101-204-305-408
这种写法的优点是不会在内存中提前生成一个完整的字符串列表,而是边迭代转换边由 join 消费,对内存非常友好。
2. 使用 map() 函数(C 语言层迭代,速度最快)
# map 写法:利用底层 C 循环高效转换
data = [101, 204, 305, 408]
result = "-".join(map(str, data))
print(result)
# 示例输出:101-204-305-408
map(str, data) 返回一个迭代器,内部循环由 CPython 底层执行,省去了 Python 解释器在字节码层面对每个元素执行函数调用的部分开销,在大部分基准测试中其执行耗时最为精简。
3. 列表推导式(直观明了,适合中小数据量)
# 列表推导式写法
data = [101, 204, 305, 408]
result = "-".join([str(x) for x in data])
print(result)
# 示例输出:101-204-305-408
列表推导式可读性极高,但需要注意方括号 [] 会先在内存中构建一个全新的完整列表,若列表包含上千万个元素,可能会瞬间推高内存占用。
四、关键边界条件与常见陷阱排查
在实际工程代码中,输入的数据往往具备不确定性。理解 str.join() 对边界情况的确定性行为,可以省去大量多余的条件判断(if-else):
1. 空列表(Empty List)
当可迭代对象为空时,str.join() 会直接返回一个空字符串 "",不会产生报错,也不会返回分隔符自身:
empty_list = []
print(repr(",".join(empty_list)))
# 示例输出:''
这保证了在无数据时无需额外编写 if len(items) == 0: return "",代码更加精炼。
2. 单元素列表(Single Element)
当列表中仅有一个元素时,str.join() 直接返回该元素所对应的字符串,绝不会在末尾或开头添加多余的分隔符:
single_item = ["Python"]
print(repr(",".join(single_item)))
# 示例输出:'Python'
与手工在循环里用加号拼逗号、最后不得不使用 result.rstrip(",") 或 result[:-1] 切片抹除尾部逗号的旧做法相比,str.join() 从算法源头上彻底杜绝了尾部分隔符残留的 Bug。
3. 列表元素包含空字符串
如果列表中本身含有空字符串 "",str.join() 仍会将其作为合法项处理,在空串两侧依然会插入分隔符:
items_with_empty = ["apple", "", "banana"]
print(repr(",".join(items_with_empty)))
# 示例输出:'apple,,banana'(中间出现连续的两个逗号)

# 如果需要过滤空串,可配合 filter 或列表推导式:
filtered_result = ",".join(x for x in items_with_empty if x)
print(repr(filtered_result))
# 示例输出:'apple,banana'
五、实践总结与技术选型决策
在日常 Python 编码中,字符串拼接有多种技术路径(如 f-string、str.format()、% 格式化、+ 运算符和 str.join())。为了在代码可读性与执行效率之间取得最佳平衡,请参照如下选型决策:
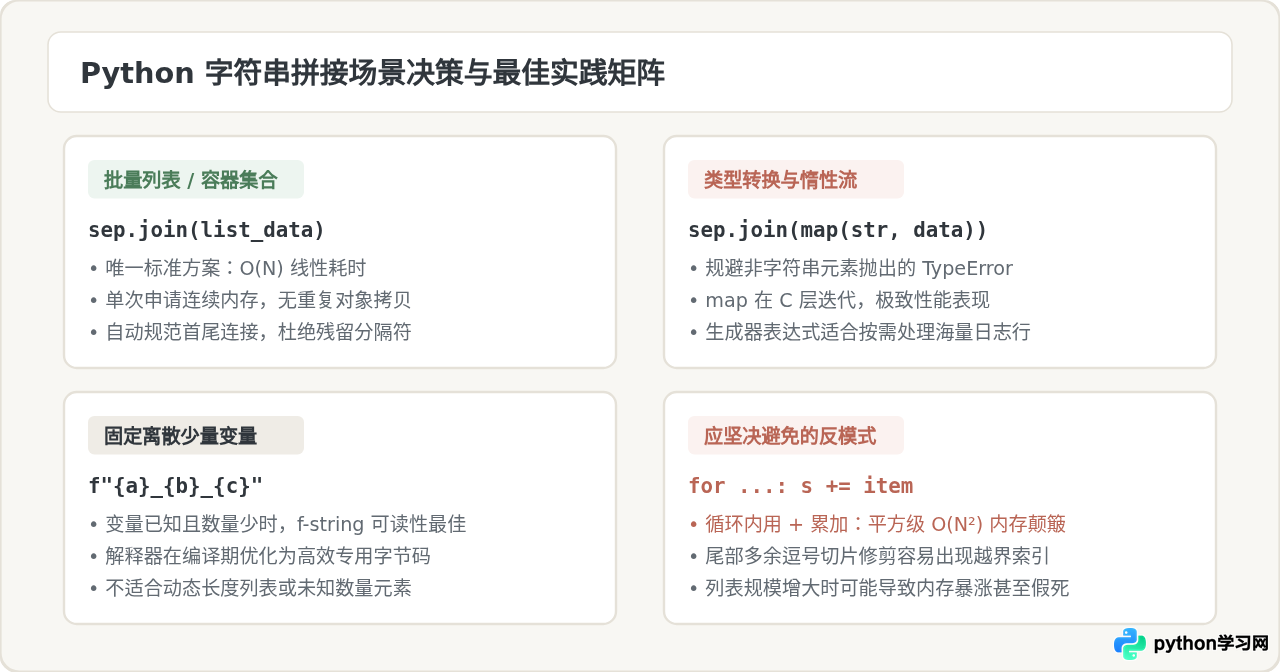
综上所述,当面临将序列容器中的多个字符串拼接为整体的任务时,separator.join(iterable) 是 Python 官方提供且在工程实践中经受住性能检验的最优解。掌握其“分隔符在前”的语法逻辑、规避非字符串类型的类型报错、利用底层单次分配的特性,能够帮助开发者写出既简洁又极具高性能的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









