

Python大模型应用开发:LangChain与RAG技术进阶路线
本文梳理 Python 大模型应用开发中从 Naive RAG 迈向生产级系统的进阶路线,系统讲解文档切块、混合检索、Cross-Encoder 重排序、LCEL 查询路由与 Agentic 纠错闭环等核心技术与实战代码。
在日常开发中,许多工程师搭建的第一个 RAG(Retrieval-Augmented Generation,检索增强生成)系统往往非常直接:调用文档加载器读取一份数十页的 PDF,用固定的字符长度切开,调一次 Embedding API 写入向量数据库,最后用一个基础的检索链拼接用户 Prompt 传给大模型。这种做法在演示 Demo 时效果显著,但只要放到多轮问答、表格报表、专业型号查询或复杂业务问答的生产环境中,系统就会暴露出致命短板——要么因为文档切碎丢失语境导致模型答非所问,要么因为向量相似度搜索忽视专有名词而彻底漏召回。
要摆脱“Demo 惊艳、上线崩溃”的困境,开发者必须清楚知道每一个技术方案到底解决了检索链路中的哪类损耗。下面我们按照从底层数据流到上层决策逻辑的递进顺序,展开这条完整的进阶路线。
一、进阶全局路线与四大技术阶梯
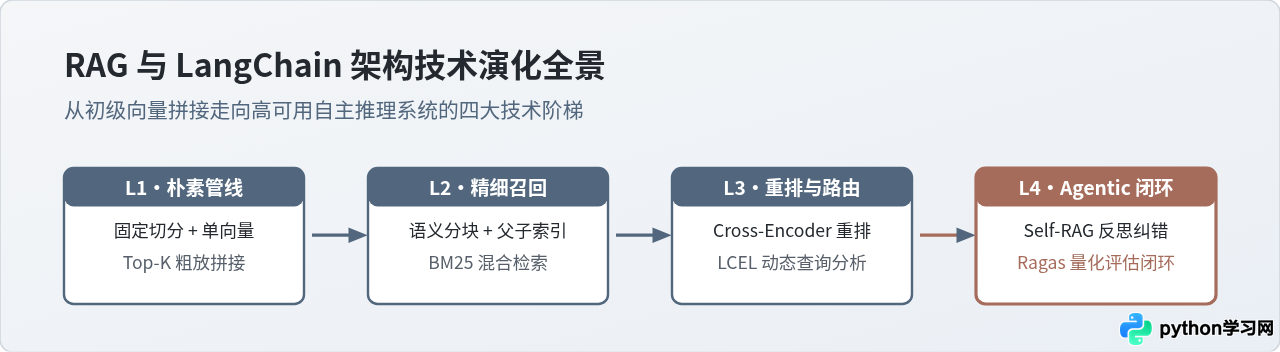
大模型应用开发中的 RAG 架构并非一蹴而就的单一模式,而是经历了从朴素单向流(Naive RAG)到高级重排(Advanced RAG),再到模块化路由(Modular RAG)以及具备自治反思能力的智能体化(Agentic RAG)四个演进阶段。
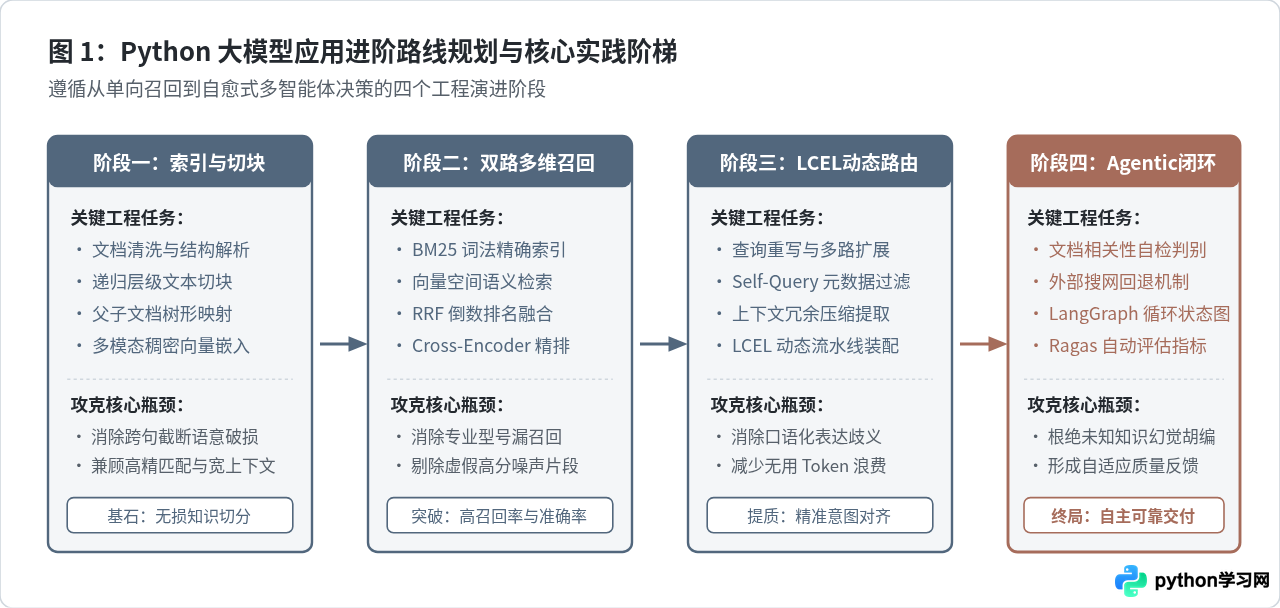
如上图所示,整条进阶路径划分出清晰的四个阶段:
- 第一阶段(索引表征优化):关注输入端的数据保真度。核心在于舍弃机械的固定长度切分,引入语义切块(Semantic Chunking)以及父子文档结构(Parent-Document Retrieval),使向量检索在极小颗粒度完成高精匹配,而喂给大模型时还原为宏观完整上下文。
- 第二阶段(多路召回与精排):解决单一稠密向量检索的盲区。将 BM25 词法精确索引与向量密集检索并联,通过倒数排名融合(RRF)与交叉编码器(Cross-Encoder)进行二次精排,直接将召回精准度提升到工业可用级别。
- 第三阶段(LCEL 与动态查询分析):进入推理前置处理层。利用 LangChain Expression Language (LCEL) 构建灵活的数据管线,实现查询扩展重写(Query Rewriting)、元数据自动过滤(Self-Querying)与上下文冗余压缩。
- 第四阶段(Agentic RAG 与评估闭环):跳出单向无反馈管线。通过 LangGraph 将检索转变为带有质量判别(Grade)、自我修正(Corrective)与回退搜索(Fallback)的状态机,并使用 Ragas 框架建立离线量化评估标准。
二、阶段一:构建高质量切分与父子文档索引管道
数据切块(Chunking)是所有 RAG 系统的真正起点。很多开发者花费大量时间微调 Prompt,却忽视了只要切块切错了,后续无论换多强大的模型都不可能挽回丢失的信息。
朴素的固定窗口切分最大的问题在于破坏句法边界。例如一个跨页表格或一个包含推导前提的段落,一旦恰好从中间截断,前后两块都会变成毫无意义的信息碎片。进阶方案首先应当采用递归字符切块(RecursiveCharacterTextSplitter),按段落、句号、换行符的优先级层层下切;对于更长篇幅的知识库,则应当使用父子文档索引(ParentDocumentRetriever)机制。
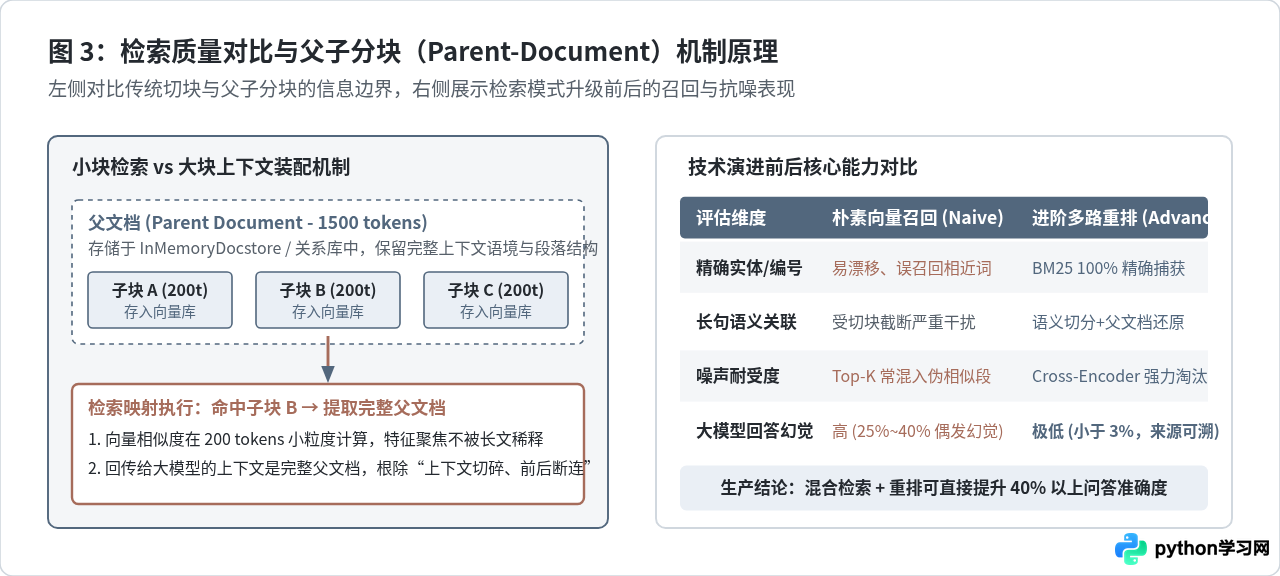
父子索引的核心逻辑是“分离检索单元与生成单元”:
- 子文档负责索引匹配:将大文档切分成极小的文本块(如 150~200 个 Token),为每个子块生成稠密向量并存入向量库。小块能高度凝聚语义特征,不会被长文本的次要话题稀释。
- 父文档负责上下文供给:同时保留 1000~2000 Token 的完整父段落(保存在文档存储 Docstore 中)。当检索器命中某个子文档时,通过唯一的
doc_id映射反查出对应的父文档,最终拼入 Prompt 送给大模型。
下面是在 LangChain 中配置父子文档切分管道的标准实现代码:
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain.retrievers import ParentDocumentRetriever
from langchain_community.vectorstores import Chroma
from langchain_community.embeddings import HuggingFaceBgeEmbeddings
from langchain.storage import InMemoryStore
from langchain_core.documents import Document

# 1. 初始化嵌入模型与底层向量存储
embedding_model = HuggingFaceBgeEmbeddings(model_name="BAAI/bge-small-zh-v1.5")
vectorstore = Chroma(collection_name="split_parents", embedding_function=embedding_model)

# 2. 内存文档存储(生产环境可无缝替换为 RedisStore 或 SQLStore)
store = InMemoryStore()

# 3. 分别定义父文档与子文档的切分器
parent_splitter = RecursiveCharacterTextSplitter(chunk_size=1500, chunk_overlap=150)
child_splitter = RecursiveCharacterTextSplitter(chunk_size=200, chunk_overlap=30)

# 4. 装配 ParentDocumentRetriever
retriever = ParentDocumentRetriever(
    vectorstore=vectorstore,
    docstore=store,
    child_splitter=child_splitter,
    parent_splitter=parent_splitter,
)

# 示例:加载并加入知识库
raw_docs = [Document(page_content="大模型应用开发进阶知识库内容...包含完整的工程架构与实现细节...", metadata={"source": "rag_manual.md"})]
retriever.add_documents(raw_docs, ids=None)

# 执行检索:即使仅命中了子块的短语,返回的依然是完整的父段落
relevant_docs = retriever.invoke("工程架构细节")
print(f"检索到父文档长度: {len(relevant_docs[0].page_content)} 字")
chunk_overlap)时,不宜设置得过大。重叠率建议控制在 10%~15% 之间。过大的重叠会导致多个几乎重复的子块同时占领向量相似度 Top-K,挤占掉其他有效文档的入选名额。
三、阶段二:突破单向量盲区,落地多路召回与重排序
向量检索基于余弦距离或点积,擅长捕捉“概念相近”的常识性语义,但它对精确字符的敏锐度非常低。假设知识库中记载着产品型号 X-9000-B,用户提问“X-9000-B 的额定功率”,纯向量模型很可能将同样讨论额定功率但型号为 X-8000-A 的片段排在更前面。为了消灭这种误导性召回,必须引入混合检索(Hybrid Search)。
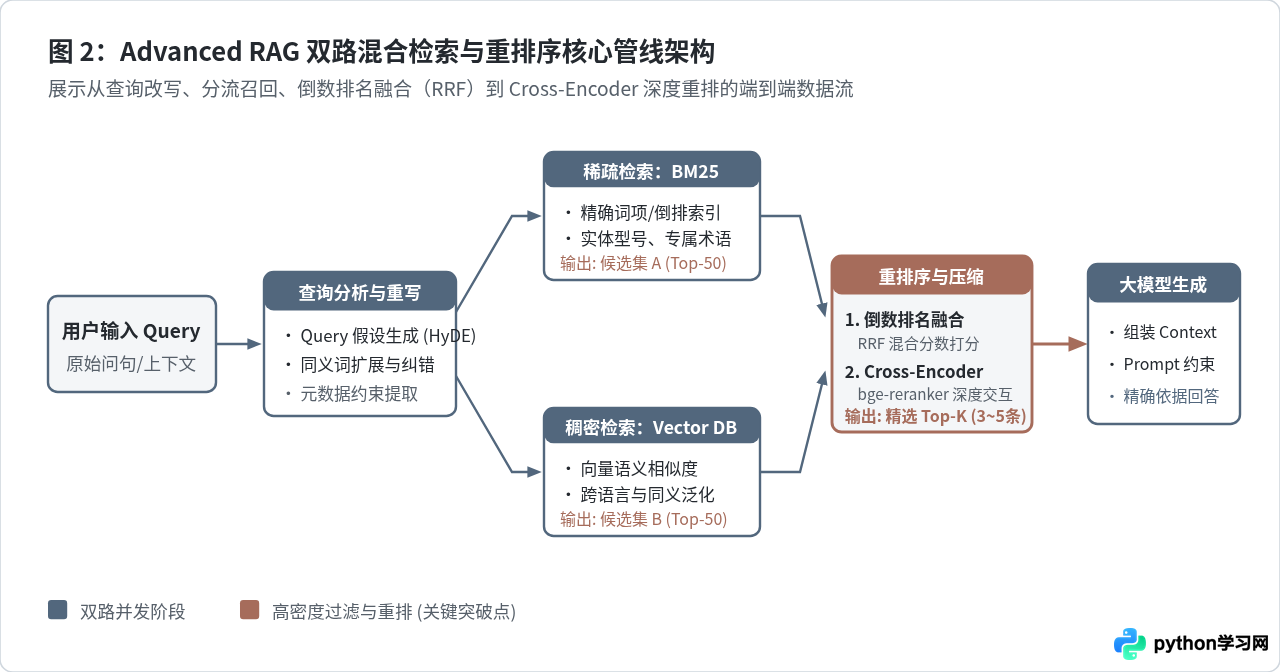
如图 2 所示,进阶召回管道由三步构成:
- 双路并行召回:利用 BM25 检索器处理关键字词法匹配,利用 Chroma/Milvus 等处理稠密向量匹配。各自取出 Top-30 或 Top-50 的候选文档。
- 倒数排名融合(Reciprocal Rank Fusion, RRF):将两路检索的排名进行无监督加权折算。RRF 的计算公式为:
Score(d) = Σ [ 1 / (k + rank_i(d)) ],通常常数k = 60。这保证了在任何一路中排名靠前的文档都能获得合理的复合基础分。 - Cross-Encoder 交叉编码重排(Rerank):双塔向量模型在编码时将 Query 和 Document 分开处理,丢失了深层交互信息;而 Cross-Encoder(如
bge-reranker-large)将(Query, Document)对拼在一起输入 Transformer 进行完整的自注意力交互,能够准确识破“表面包含词汇但核心意思无关”的噪声片段。
以下是使用 LangChain 的 EnsembleRetriever 搭配重排序模型的生产级集成示例:
from langchain_community.retrievers import BM25Retriever
from langchain.retrievers import EnsembleRetriever, ContextualCompressionRetriever
from langchain.retrievers.document_compressors import CrossEncoderReranker
from langchain_community.cross_encoders import HuggingFaceCrossEncoder
from langchain_core.documents import Document

# 准备知识库样本片段
docs = [
    Document(page_content="型号 X-9000-B 工业控制终端的额定功率为 450W,工作电压 220V。"),
    Document(page_content="型号 X-8000-A 基础型控制器的额定输入功率为 200W。"),
    Document(page_content="工业设备供电安全规范与功率管理标准介绍。")
]

# 1. 构建 BM25 稀疏检索器
bm25_retriever = BM25Retriever.from_documents(docs)
bm25_retriever.k = 5

# 2. 向量检索器(基于阶段一的 vectorstore)
dense_retriever = vectorstore.as_retriever(search_kwargs={"k": 5})

# 3. 集成混合检索器 (权重可微调,通常 BM25:向量 = 0.4:0.6)
ensemble_retriever = EnsembleRetriever(
    retrievers=[bm25_retriever, dense_retriever],
    weights=[0.4, 0.6]
)

# 4. 加载重排序模型(Cross-Encoder)
cross_encoder = HuggingFaceCrossEncoder(model_name="BAAI/bge-reranker-base")
reranker = CrossEncoderReranker(model=cross_encoder, top_n=2)

# 5. 装配带重排的最终检索管道
compression_retriever = ContextualCompressionRetriever(
    base_compressor=reranker,
    base_retriever=ensemble_retriever
)

# 执行检索测试
final_results = compression_retriever.invoke("X-9000-B 的额定功率是多少?")
for r in final_results:
    print("重排入选片段:", r.page_content)
四、阶段三:基于 LCEL 的动态查询分析与上下文流水线
传统的串联调用往往使用 LangChain 的老式类(如 RetrievalQA),难以灵活插入分支判断与数据转换。现代 LangChain 开发全面转向 LCEL(LangChain Expression Language),利用类似 Unix 管道的 | 操作符编排动态流程。
在真实场景下,用户的提问往往并不规整。为了提高命中率,我们可以在进入 Retriever 之前,通过轻量级 LLM 对用户的提问进行动态查询改写与多路展开(Multi-Query Generation):
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# 1. 动态查询重写 Prompt
rewrite_prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一名专业查询优化专家。请根据用户的模糊提问,提炼出 3 个不同角度、富含关键专业术语的等价检索句子,每行输出一个,严禁任何无关废话。"),
    ("human", "{question}")
])

# 2. 构建查询重写子链
query_rewriter = rewrite_prompt | llm | StrOutputParser() | (lambda x: [q.strip() for q in x.strip().split("\n") if q.strip()])

# 3. 格式化拼接多个检索到的文档
def format_docs(docs):
    return "\n\n".join(f"[文档序号 {i+1}]:{d.page_content}" for i, d in enumerate(docs))

# 4. 问答生成 Prompt
qa_prompt = ChatPromptTemplate.from_template('''
你是一名严谨的技术支持助手。请根据下方提供的背景资料回答用户的问题。
如果你在背景资料中找不到依据,请直接说明“资料中未提及相关信息”,切勿胡编乱造。

【背景参考资料】
{context}

【用户问题】
{question}

请给出逻辑清晰、条理分明的回答:
''')

# 5. 端到端 LCEL 组合链
rag_chain = (
    RunnablePassthrough.assign(
        context=(lambda x: x["question"]) | compression_retriever | format_docs
    )
    | qa_prompt
    | llm
    | StrOutputParser()
)

# 运行链
response = rag_chain.invoke({"question": "请告诉我 X-9000-B 适合在多少电压和功率下工作?"})
print("大模型输出回答:\n", response)
五、阶段四:走向自主推理——Agentic RAG 与 LangGraph 状态图
前述所有阶段本质上仍然是单向线性的流水线(Pipeline)。如果遇到用户提问超出知识库范围、或者检索出来的文档完全不相关的情况,单向流水线依然会强行把错误的数据塞给模型,导致幻觉生成。
为了解决这一顽疾,进阶路线的第四阶段需要引入 Agentic RAG(如 Corrective RAG / Self-RAG)。借助 LangGraph 状态图,我们可以把检索、判定、回退改写和回答组织成闭环反馈系统。
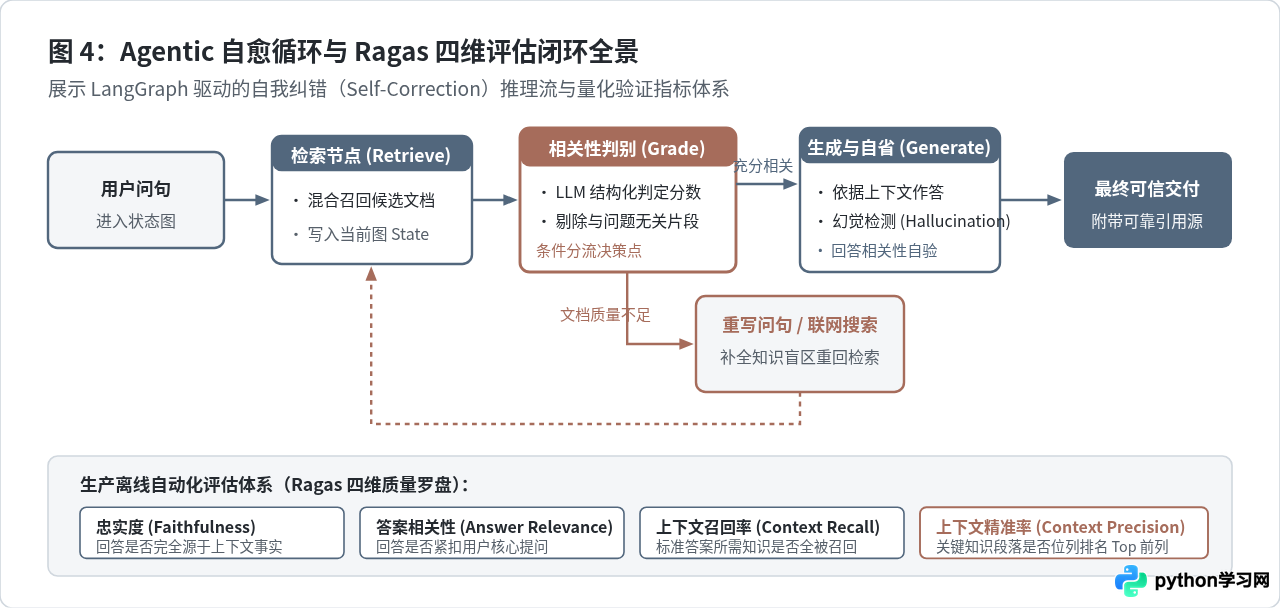
在 Agentic RAG 中,系统不再盲目信任初次检索:
- 相关性审查节点(Grade Documents):LLM 会对召回的每一个 Document 进行评分,判断其是否真正包含解答该问题所需的事实。如果得分过低,该片段直接被剔除。
- 动态分支决策(Conditional Routing):如果所有本地文档都被剔除或信息严重不足,工作流自动分支转移至“查询改写”节点,并调用外部 Web 搜索工具(如 Tavily 或 SerpAPI)抓取补充信息;若信息充足,则流转至生成节点。
- 幻觉自省节点(Hallucination Check):大模型生成答案后,系统会进行二次反思:回答中的断言是否都有对应上下文支撑?若是,才最终交付给终端用户。
这种状态循环使得大模型应用在面对模糊或刁钻问题时,具备了类似人类技术专家的自愈与核实能力。
六、阶段五:生产落地的评估体系与优化清单
在生产环境中推进 RAG 进阶路线,必须摆脱“靠人工肉眼抽查体验”的粗放模式,建立起客观可量化的离线评估体系。目前行业内广泛认可的标准是 Ragas(Retrieval Augmented Generation Assessment) 框架,它定义了四个核心指标维度:
| 评估指标 | 测量核心 | 达标参考线 | 主要低分原因与调优手段 |
|---|---|---|---|
| 忠实度 (Faithfulness) | 回答是否完全源于上下文事实,有无胡编乱造 | > 0.92 | Prompt 约束不足或上下文片段存在矛盾;需增强 System Prompt 防幻觉规则。 |
| 答案相关性 (Answer Relevance) | 回答是否完整、切中用户提问要害 | > 0.88 | 模型废话过多或答非所问;需优化 Prompt 输出格式约束。 |
| 上下文召回率 (Context Recall) | 标准参考答案所需的支撑知识是否被全部召回 | > 0.85 | 切分块过小截断了关键信息,或仅使用单一向量检索;需引入父子文档切分与混合检索。 |
| 上下文精准率 (Context Precision) | 检索到的关键支撑段落是否位列 Top 前排 | > 0.80 | 未经过重排序导致噪声片段排在前面;需引入 Cross-Encoder 深度重排。 |
- 优先做切分与重排,再考虑微调模型:90% 以上的 RAG 准确率问题可以通过“精细分块 + 混合召回 + 重排序”解决,不要过早投入昂贵且容易灾难性遗忘的模型微调。
- 关注检索延迟开销:Cross-Encoder 虽然精准,但在 CPU 上推理 Top-50 可能会带来 300ms 以上延迟。生产环境建议在初筛阶段使用 RRF 将候选集压缩至 10~15 条,再交由 Cross-Encoder 挑选 Top-3~5。
- 构建语义缓存层:对于高频常见问题,可以在检索链路前置 Redis 语义缓存(Semantic Cache),匹配相似度高于 0.95 的直接命中缓存,显著降低 API 账单与响应时间。
沿着这条进阶路线,从扎实的数据切块开始,逐步叠加混合检索、LCEL 管道控制与 Agentic 反思机制,Python 开发者能够构建出真正抗击复杂业务场景冲击、高精度、低幻觉的大模型生产级应用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









