

Python time.sleep 时间不准?操作系统调度误差与校准技巧
深入解析 Python time.sleep() 在 Windows 与 Linux 平台上的底层误差根源,拆解操作系统时钟中断与线程调度队列机制,并提供消除累积漂移的绝对时间标尺及微秒级混合自旋校准实战方案。
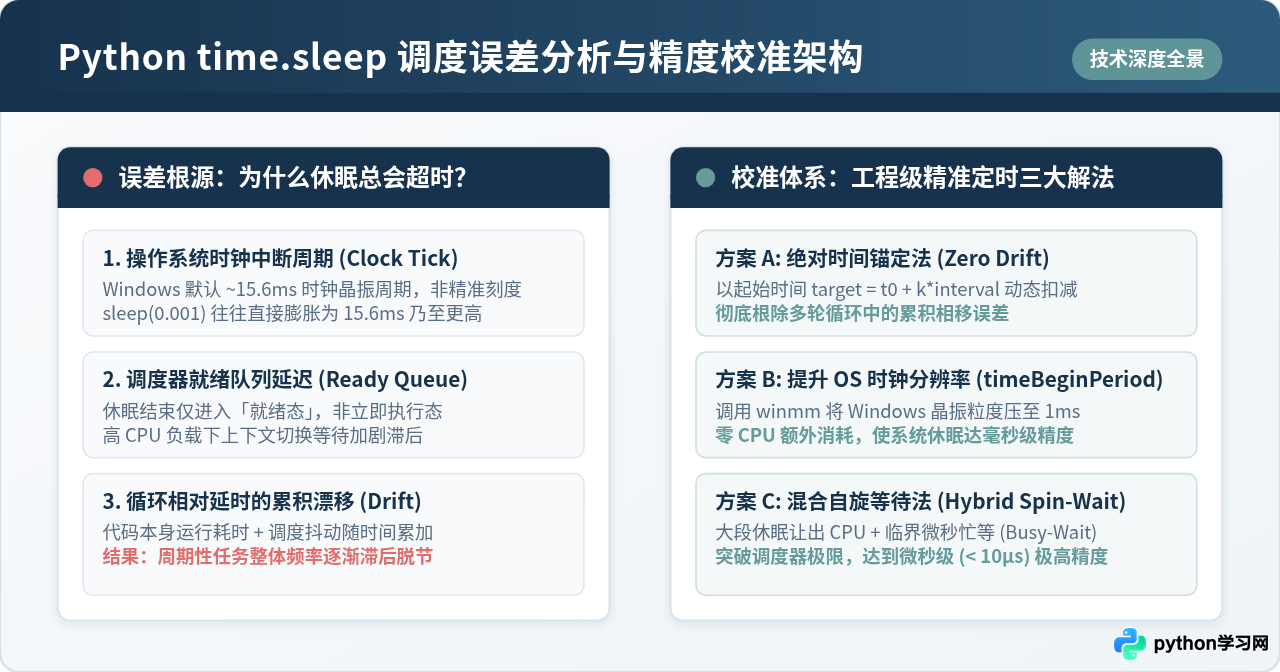
在 Python 中编写定时任务、硬件通信或动画控制代码时,很多开发者会理所当然地认为 time.sleep(0.01) 会精准暂停 10 毫秒。然而只要用高精度时钟实测就会发现,程序实际休眠往往长达 15 毫秒甚至更高,连续循环时还会产生令人头疼的累积滞后。出现这个问题的本质原因在于:time.sleep() 并非实时硬件定时器,它只承诺“休眠时长不少于设定值”,而实际唤醒时刻受制于操作系统的时钟中断频率、线程就绪队列调度延迟以及 GIL 锁竞争。本文将通过实测代码还原误差现象,剖析底层调度机制,并提供从消除累积相移到微秒级混合自旋的三套工程校准方案。
一、现象实测:time.sleep() 究竟能差多少?
想要直观感受 time.sleep() 的误差,最直接的手段是利用 Python 3.3+ 引入的单调纳秒级基准时钟 time.perf_counter() 进行测量。下面这段简短的测试代码分别请求休眠 1 毫秒(0.001 秒)和 10 毫秒(0.01 秒),并在循环中统计其实际消耗时间:
import time

def test_sleep_precision(request_ms, loops=5):
    target_sec = request_ms / 1000.0
    print(f"--- 测试请求休眠: {request_ms} ms ({target_sec} 秒) ---")
    for i in range(loops):
        t0 = time.perf_counter()
        time.sleep(target_sec)
        actual_ms = (time.perf_counter() - t0) * 1000.0
        error_ms = actual_ms - request_ms
        print(f"轮次 {i+1}: 设定={request_ms:.2f}ms | 实际={actual_ms:.2f}ms | 误差={error_ms:+.2f}ms")

if __name__ == "__main__":
    test_sleep_precision(1.0)
    test_sleep_precision(10.0)
在不同操作系统上运行上述代码,会观察到显著不同的代表性输出结果:
| 操作系统平台 | 设定值: 1.0 ms | 设定值: 10.0 ms | 主要表现与特点 |
|---|---|---|---|
| Windows 10 / 11 (默认时钟周期) | 实际 15.62 ms (误差 +14.62 ms) | 实际 15.65 ms (误差 +5.65 ms) | 严重受限默认 64Hz (15.625ms) 时钟节拍,低于 15ms 的休眠几乎全部膨胀到下一个 Tick |
| Linux (标准内核 250Hz / 1000Hz) | 实际 1.25 ms (误差 +0.25 ms) | 实际 10.30 ms (误差 +0.30 ms) | 得益于高精度定时器(hrtimer)与 tickless 机制,整体更精准,但在重负载下仍有抖动 |
| macOS (Darwin 内核) | 实际 1.15 ms (误差 +0.15 ms) | 实际 10.18 ms (误差 +0.18 ms) | 调度颗粒度较细,亚毫秒请求基本可靠,但极限微秒级调用仍无法满足 |
实测数据直接揭示了一个事实:time.sleep(t) 的返回值时刻恒满足 T_actual >= t,且在极端情况下(如 Windows 平台请求小延时),实际执行时间可能会膨胀到设定值的十几倍。
二、底层根源:操作系统调度与时钟中断机制
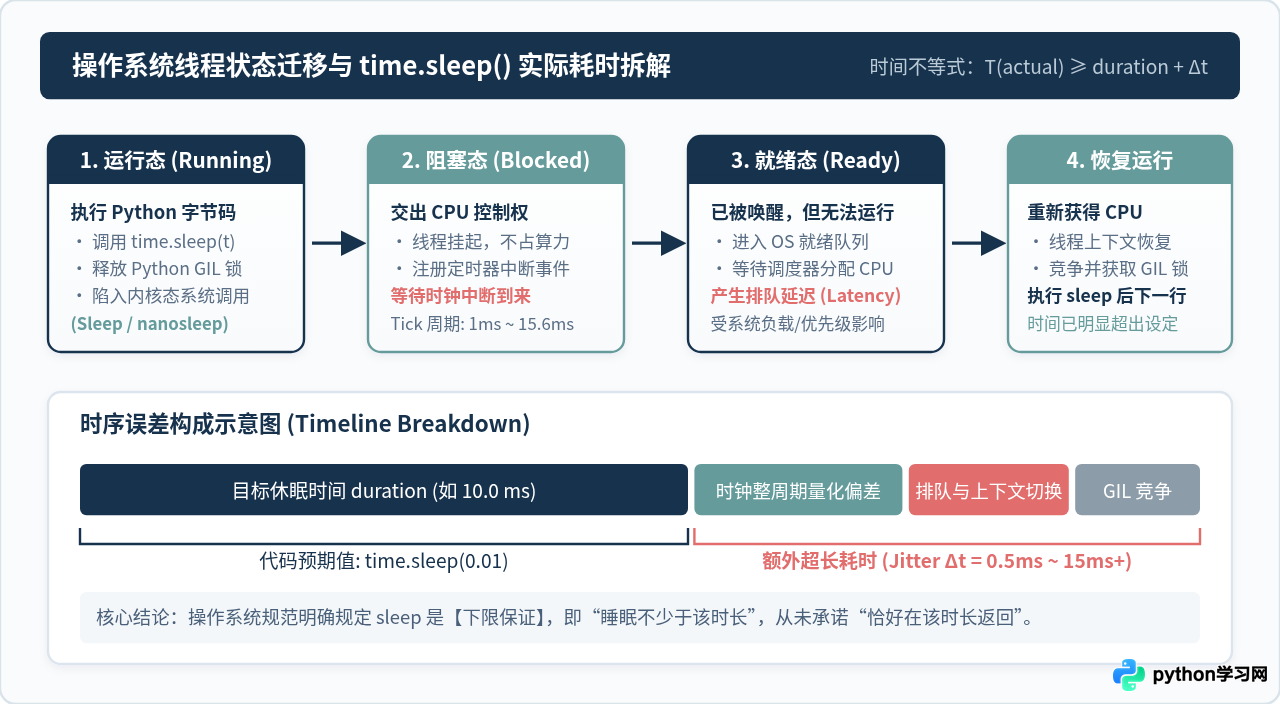
要解决误差,必须搞清楚休眠的整个生命周期中究竟发生了什么。当 Python 代码调用 time.sleep() 时,底层经历了一个跨越用户态、内核态和调度器的复杂链条。
1. 时钟中断粒度(Clock Tick Quantization)
操作系统并非随时都在检查哪些线程该唤醒,而是依赖主板硬件晶振发出的周期性时钟中断(Clock Interrupt)来驱动时间轮和任务调度。在 Windows 操作系统中,出于电源管理和电池续航考虑,历史默认的时钟中断间隔为 15.625 毫秒(即每秒 64 次 Tick)。如果一个线程在第 1.0 毫秒处进入休眠并请求暂停 1 毫秒,由于下一次时钟中断要在第 15.625 毫秒才触发,操作系统在中断到来之前根本不会去检查定时器,导致线程被迫多等待 14 毫秒以上。
2. 就绪队列排队延迟(Ready Queue Scheduling Latency)
即便硬件时钟中断准时触发并认定了定时器到期,操作系统也只能把该线程的状态从“阻塞态(Blocked)”修改为“就绪态(Ready)”,并将其推入 CPU 的可执行调度队列。此时线程并不能立刻获得 CPU。如果当前系统中存在其他优先级更高或同优先级的繁忙线程,调度器必须等待正在运行的线程用完时间片或主动让出后,才会发生上下文切换(Context Switch)。这段排队时间完全取决于当前系统的负载情况。
3. Python GIL(全局解释器锁)的竞争开销
在 CPython 解释器中,time.sleep() 在陷入操作系统内核系统调用(POSIX 上的 select / nanosleep 或 Windows 上的 Sleep / CreateWaitableTimerExW)之前,会显式调用 Py_BEGIN_ALLOW_THREADS 释放 GIL 锁,以便其他 Python 线程并发运行。但在休眠结束、线程被操作系统恢复执行的瞬间,它必须重新调用 Py_END_ALLOW_THREADS 去申请 GIL。如果此时有其他计算密集型线程正霸占 GIL,恢复运行的线程将被迫二次等待,进一步拉长了唤醒延迟。
三、致命陷阱:循环中的“累积漂移”(Cumulative Drift)
单次休眠有几毫秒的误差在很多场景下尚可容忍,但在需要恒定频率循环运行的业务中(例如每秒读取 10 次传感器数据、每 50 毫秒向前端推送一次状态帧),最致命的问题不是单次抖动,而是累积相移漂移(Cumulative Drift)。
考察下面这种最常见的朴素循环写法:
# 常见但存在严重累积漂移的写法
import time

INTERVAL = 0.01  # 期望每 10 毫秒执行一次

while True:
    do_something()   # 假设业务逻辑耗时 2 ms
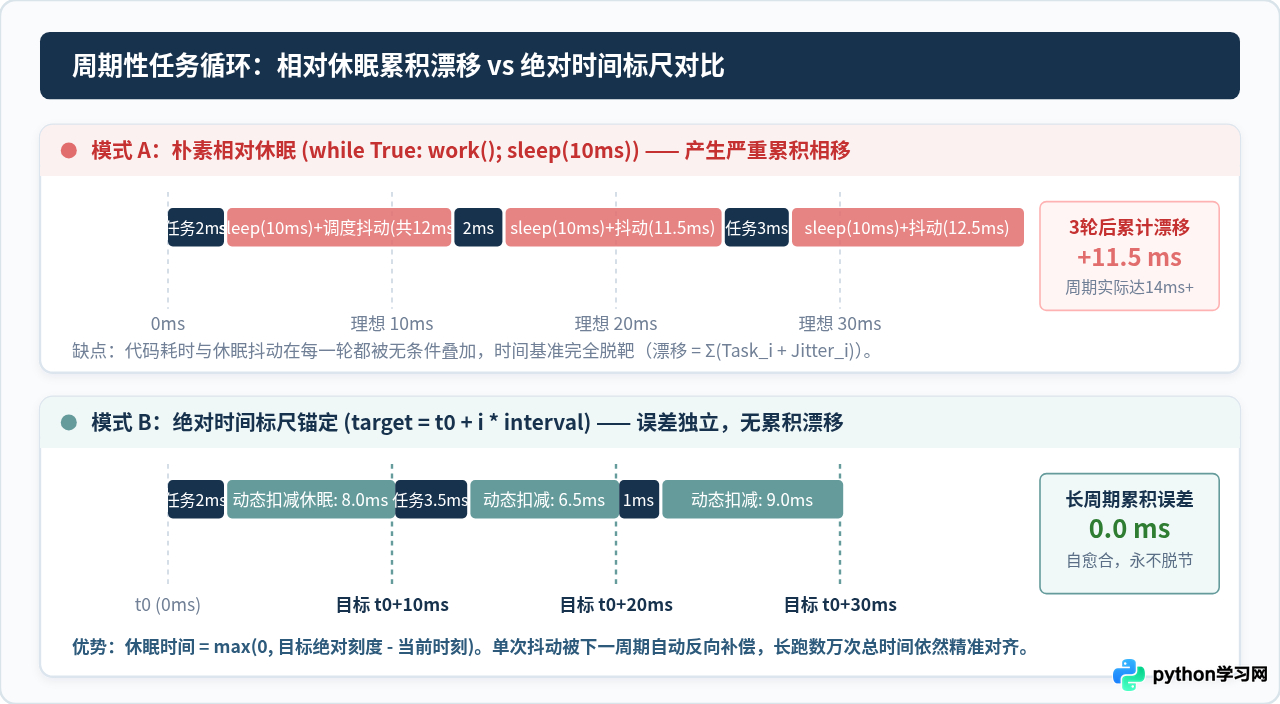
    time.sleep(INTERVAL)  # 每次相对休眠 10 ms (实际 11.5 ms)
在这种模式下,第 i 次循环的总耗时等于“业务逻辑耗时 + 单次休眠耗时 + 调度抖动”。每一轮产生的多余时间,都会成为下一轮的新起点,误差被机械式地累加到整个时间轴上。1000 轮循环下来,理论上本该在第 10 秒完成,实际可能已经滞后到了第 13 秒甚至第 15 秒,导致频率严重缩水。
四、实战校准技巧:从毫秒到微秒的三大工程解法
技巧一:绝对时间标尺锚定法(彻底消除累积漂移)
解决循环累积漂移的核心在于放弃相对等待,改用绝对时间戳作为统一标尺。我们在循环启动前记录基准时刻 t0,之后第 k 次触发的理想时刻必须严格锚定在 target_k = t0 + k * interval。每次休眠时,动态计算当前距离目标刻度还剩多少时间,并将业务代码的执行耗时自然抵扣掉:
import time

def run_periodic_task(interval_sec, total_cycles=10):
    """
    使用绝对时间标尺校准的恒定周期执行器
    :param interval_sec: 期望循环周期(秒)
    :param total_cycles: 执行总次数
    """
    start_time = time.perf_counter()
    print(f"任务启动,期望周期: {interval_sec * 1000:.1f} ms")

    for k in range(1, total_cycles + 1):
        # 1. 模拟业务处理
        t_work_start = time.perf_counter()
        # 模拟 1~3ms 的动态业务耗时
        time.sleep(0.002)

        # 2. 计算当前轮次严格对齐的绝对目标时刻
        target_time = start_time + k * interval_sec
        now = time.perf_counter()
        remaining = target_time - now

        # 3. 动态补偿:仅休眠剩余时长
        if remaining > 0:
            time.sleep(remaining)
        else:
            # 告警:业务处理已超时,无法通过休眠拉回,直接进入下一轮
            print(f"[警告] 第 {k} 轮严重超时,超出 {abs(remaining)*1000:.2f} ms")

        elapsed_total = (time.perf_counter() - start_time) * 1000
        ideal_total = k * interval_sec * 1000
        print(f"轮次 {k:2d} 结束 | 累计耗时: {elapsed_total:6.2f} ms | 理论值: {ideal_total:6.2f} ms | 累计相差: {elapsed_total - ideal_total:+.2f} ms")

if __name__ == "__main__":
run_periodic_task(interval_sec=0.01, total_cycles=5)在此算法中,即便某次调度抖动多花了 1.5 毫秒,下一次循环计算出的 remaining 就会自动缩短 1.5 毫秒,使系统在后续周期内迅速“自愈合”。长跑成千上万次,总体时钟漂移始终收敛在单次抖动范围内(误差不随轮次累加)。
技巧二:Windows 平台定时器分辨率提升(调用 timeBeginPeriod)
如果你在 Windows 平台上开发,系统默认的 ~15.6ms 时钟粒度是高频定时器的最大天花板。通过调用 Windows 底层多媒体库 winmm.dll 的 timeBeginPeriod API,可以将系统的时钟中断周期强制临时压缩至 1 毫秒:
import sys
import time
from contextlib import contextmanager

@contextmanager
def windows_high_resolution_timer(resolution_ms=1):
    """
    Windows 专用高精度时钟上下文管理器
    将系统定时器粒度提升至 1ms,并在退出时自动恢复默认值
    """
    if sys.platform != "win32":
        yield
        return

    import ctypes
    winmm = ctypes.WinDLL("winmm")
    # 请求将系统定时器分辨率提升至指定毫秒(通常为 1)
    res = winmm.timeBeginPeriod(resolution_ms)
    try:
        yield
    finally:
        # 必须显式配对调用恢复,否则会导致全局 CPU 唤醒频率升高增加整机功耗
        winmm.timeEndPeriod(resolution_ms)

# 使用示例
if __name__ == "__main__":
    print("未开启高精度时钟测试:")
    t0 = time.perf_counter()
    time.sleep(0.002) # 尝试休眠 2ms
    print(f"默认休眠 2ms 耗时: {(time.perf_counter() - t0)*1000:.2f} ms")

    print("\n开启 1ms 系统时钟分辨率后:")
    with windows_high_resolution_timer(1):
        t0 = time.perf_counter()
        time.sleep(0.002) # 再次尝试休眠 2ms
        print(f"优化后休眠 2ms 耗时: {(time.perf_counter() - t0)*1000:.2f} ms")
在 Windows 环境下启用该上下文管理器后,原本会被延长到 15.6ms 的 time.sleep(0.002) 会立刻降至 2.1ms ~ 2.5ms 左右,精确度大幅提升,且该过程完全不需要额外的 CPU 自旋负载。
技巧三:混合自旋休眠算法(微秒级 Hybrid Sleep & Busy-Wait)
在工业数据采集、高速通信报文交互或音频渲染等场景中,往往需要 0.1 毫秒(100 微秒)乃至更微秒级的控制精度。单纯靠操作系统休眠(无论 Linux 还是 Windows)都会由于线程上下文切换固有开销而无法满足需求。而完全采用死循环自旋(Busy-Wait)虽然精准,却会导致单个 CPU 核心飙满 100%,耗电且抢占其他线程资源。
混合自旋休眠算法(Hybrid Sleep & Busy-Wait)融合了两者的优势:当距离目标还远时(例如大于 2 毫秒),先调用标准 time.sleep 让出 CPU 进入睡眠;在距离目标还有 1.5 毫秒的安全窗口前提前醒来,最后利用极短的 while 自旋完成微秒级精准冲刺。
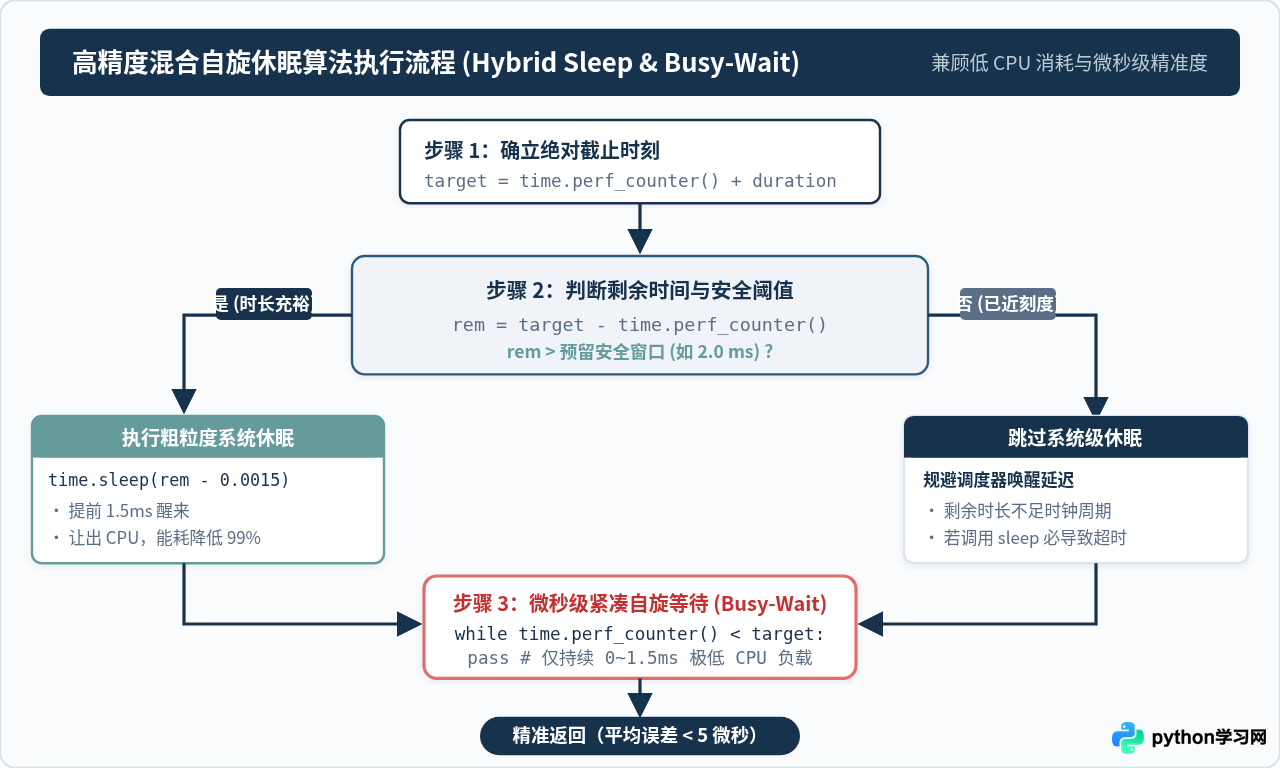
以下是具备工业级鲁棒性的混合自旋实现完整代码:
import time

def precise_sleep(duration_sec, spin_threshold=0.002, safety_margin=0.0015):
    """
    高精度混合自旋休眠函数
    :param duration_sec: 目标休眠时长(秒)
    :param spin_threshold: 触发粗粒度睡眠的时间门槛(秒,默认 2ms)
    :param safety_margin: 粗粒度睡眠预留的安全唤醒余量(秒,默认 1.5ms)
    """
    target = time.perf_counter() + duration_sec

    # 阶段 1:时长充裕时,采用粗粒度系统休眠让出 CPU
    while True:
        remaining = target - time.perf_counter()
        if remaining <= spin_threshold:
            break
        # 预留 safety_margin,防止系统休眠超调导致直接越过 target
        sleep_chunk = remaining - safety_margin
        if sleep_chunk > 0:
            time.sleep(sleep_chunk)

    # 阶段 2:最后数微秒至 1.5 毫秒内,采用纳秒级自旋忙等
    while time.perf_counter() < target:
        pass  # 纯自旋,不释放控制权,消除调度器重新分派的全部延迟

# 精度对比测试
if __name__ == "__main__":
    target_us = 500  # 测试 500 微秒(0.5 毫秒)
    target_s = target_us / 1_000_000.0

    print(f"--- 目标延时: {target_us} 微秒 ({target_s*1000:.3f} ms) ---")

    # 原生 sleep 对比
    t0 = time.perf_counter()
    time.sleep(target_s)
    native_spent = (time.perf_counter() - t0) * 1_000_000
    print(f"原生 time.sleep: 实际={native_spent:.1f} μs | 偏差={native_spent - target_us:+.1f} μs")

    # 混合自旋对比
    t0 = time.perf_counter()
    precise_sleep(target_s)
    hybrid_spent = (time.perf_counter() - t0) * 1_000_000
    print(f"混合自旋 precise_sleep: 实际={hybrid_spent:.1f} μs | 偏差={hybrid_spent - target_us:+.1f} μs")
在普通 PC 机上实测,原生 time.sleep(0.0005) 通常会延展到 1.5ms ~ 15ms(误差达到数千微秒),而 precise_sleep 则稳定控制在 500.5μs ~ 503.0μs 之间,平均误差在 5 微秒以内,同时 CPU 占用率仅在极短的 1.5 毫秒内微幅浮动,达到了精度与资源的极致平衡。
五、方案选型与技术决策指南
在实际生产架构中,没有一种方案适合所有业务。选择哪种定时策略,取决于应用场景对精度、CPU 功耗以及跨平台兼容性的综合权衡:
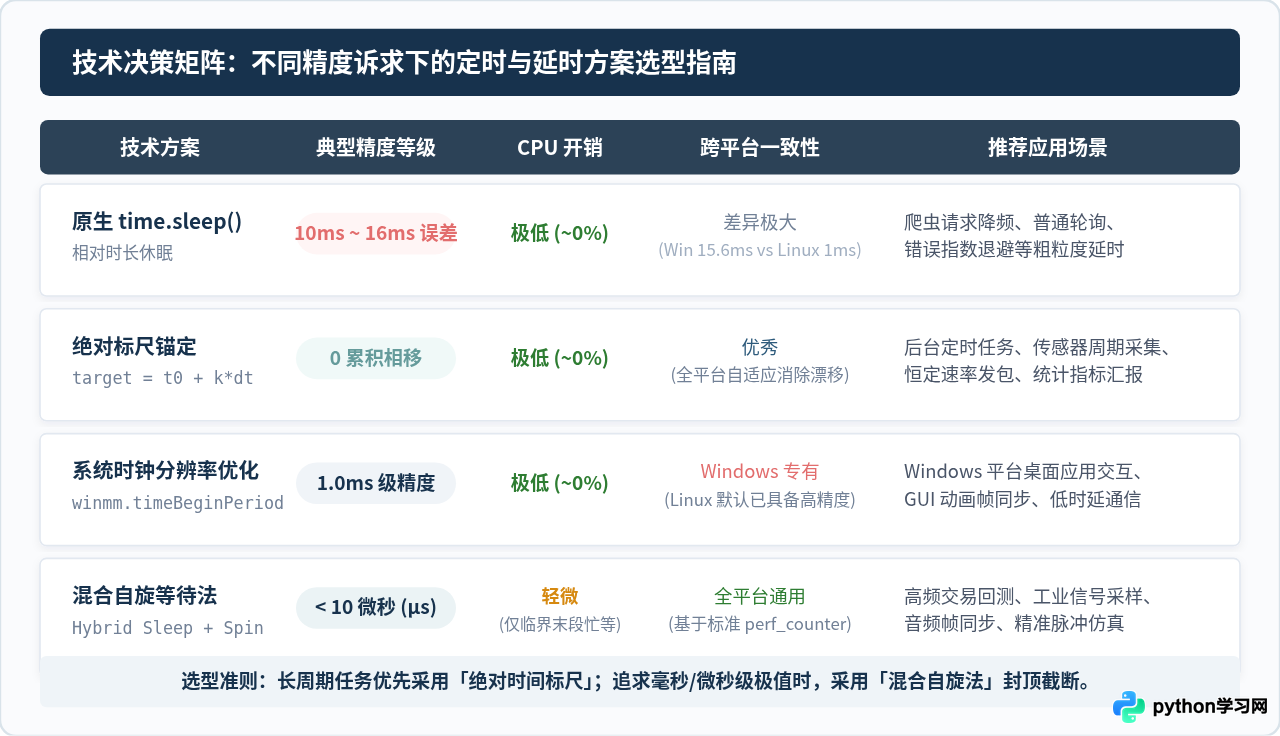
- 常规后台业务与爬虫重试:直接使用原生
time.sleep(),毫秒级抖动对业务完全无害,零 CPU 占用是首选。 - 固定频率周期任务(如 10Hz/50Hz 数据轮询):务必使用绝对时间标尺法(技巧一),彻底消灭循环多轮执行后的时间漂移。
- Windows 桌面客户端开发:如果在 Windows 上需要相对平滑的动画帧或 1ms 级网络心跳,搭配使用
timeBeginPeriod(1)(技巧二)。 - 微秒级高频或硬件交互场景:直接引入
precise_sleep()混合自旋算法(技巧三),在兼顾低 CPU 占用的前提下获取微秒级精确返回。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









